

Pandas数据清洗中怎么集成Python数据校验逻辑
本文系统解析在Pandas数据清洗流程中集成Python数据校验逻辑的方法,涵盖原生向量化布尔校验与Schema强类型契约校验两种实现路径,提供异常数据分流隔离实践与架构选型指引。
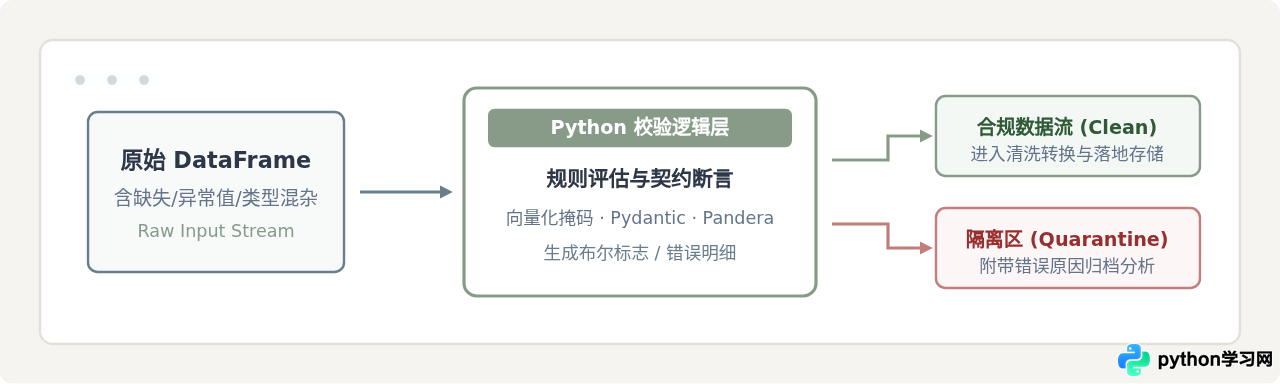
在 Pandas 数据清洗过程中,直接使用未经校验的数据极易在后续计算或入库时触发隐蔽错误。将 Python 数据校验逻辑无缝集成到清洗管道中,核心解决方案主要分为两类:一是基于 Pandas 原生操作构建高性能的向量化布尔掩码校验,二是引入基于数据契约的 Schema 模式校验引擎(如 Pydantic 或 Pandera)。通过在清洗阶段实施“断言-标记-分流”机制,既能拦截非法记录,又能保留排查线索,保证全流程的数据质量。
一、数据清洗中集成校验的核心逻辑与执行流水线
常规的数据清洗往往局限于 dropna() 去除空值、drop_duplicates() 剔除重复行或 astype() 转换类型。这种清洗方式只解决了数据格式的浅层问题,无法识别业务层面的异常,例如负数的交易金额、不符合规范的身份证号、未来发生的订单日期,以及跨字段的逻辑冲突(如“已发货”状态下发货时间却为空)。
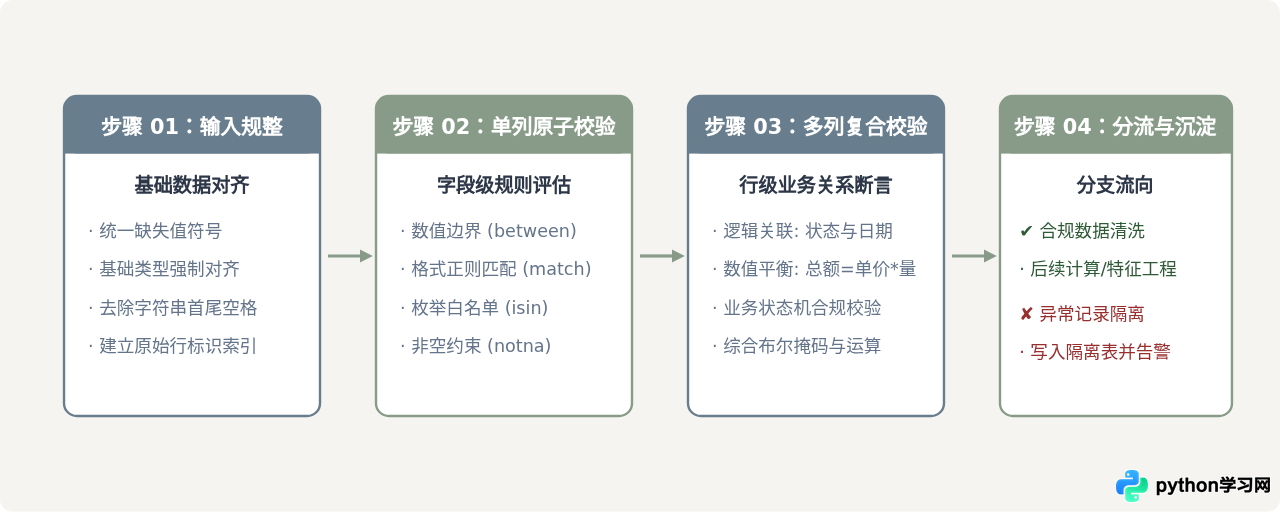
在生产级清洗脚本中集成校验逻辑,不应仅仅在遇到坏数据时抛出异常崩溃退出,而应当采用“流水线分级拦截与分流”的设计模式。通常由四个紧密相连的阶段构成:
- 原始输入规整:加载数据并对空值占位符(如
"NA"、"-"、空格)进行规范化统一。 - 字段级原子校验:验证单列取值范围、数值类型、正则格式与枚举约束。
- 行级复合业务校验:验证跨字段关联条件与多字段业务规则一致性。
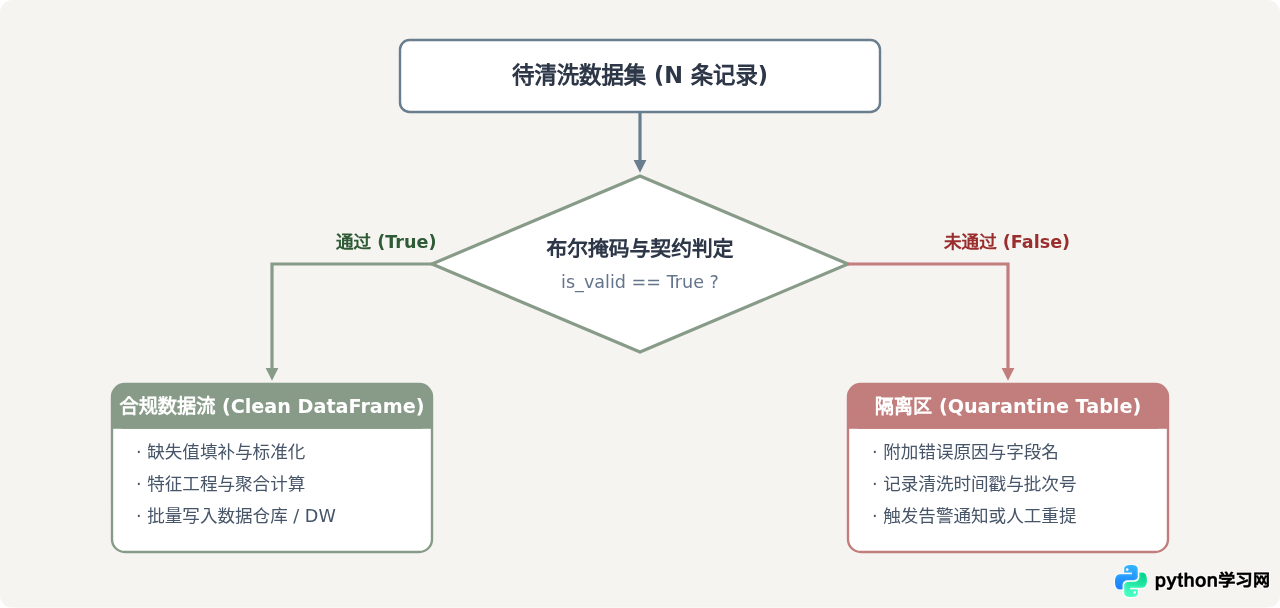
- 分流与隔离沉淀:利用布尔索引将数据集切分为“合规集”与“待检隔离集”,合规集继续执行业务清洗,隔离集附带校验失败标签单独导出。
二、基于原生 Pandas 向量化布尔掩码的轻量校验
对于数据规模较大(十万行至数千万行)的场景,最推荐的做法是利用 Pandas 底层的 C/NumPy 向量化运算,通过组合布尔掩码(Boolean Mask)来执行校验。这种方式执行速度极快,且不需要安装额外的第三方依赖。
1. 构建多维度校验规则字典
我们可以定义一个校验函数,为每个校验维度生成一个独立的布尔 Series,最后将不合规的条件归集并生成错误原因描述。
import pandas as pd
import numpy as np

def validate_sales_pipeline(df: pd.DataFrame) -> tuple[pd.DataFrame, pd.DataFrame]:
    """
    销售数据清洗校验函数
    返回: (clean_df, quarantine_df)
    """
    # 浅拷贝避免 SettingWithCopyWarning
    work_df = df.copy()

    # 初始化错误收集列表,长度与行数保持一致
    errors = pd.Series("", index=work_df.index, dtype="string")

    # 规则 1: 订单号必须为以 'ORD-' 开头的字符串
    rule_order_id = work_df["order_id"].astype(str).str.match(r"^ORD-\d{6}$")
    errors = np.where(~rule_order_id, errors + "[订单ID格式非法] ", errors)

    # 规则 2: 年龄必须在 18 到 100 之间(允许空值在此处判定为错误)
    rule_age = work_df["customer_age"].between(18, 100) & work_df["customer_age"].notna()
    errors = np.where(~rule_age, errors + "[用户年龄不在18-100范围] ", errors)

    # 规则 3: 金额必须大于 0 且小于 1000000
    rule_amount = (work_df["amount"] > 0) & (work_df["amount"] < 1_000_000)
    errors = np.where(~rule_amount, errors + "[交易金额超出正常区间] ", errors)

    # 规则 4: 跨字段业务约束:已付款订单必须有付款时间
    rule_payment = ~(
        (work_df["status"] == "PAID") & (work_df["paid_at"].isna() | (work_df["paid_at"] == ""))
    )
    errors = np.where(~rule_payment, errors + "[已支付订单缺少付款时间] ", errors)

    # 汇总有效性掩码:错误信息为空即为完全合规
    is_valid = (errors == "")

    # 分流合规集与隔离集
    clean_df = work_df[is_valid].copy()

    quarantine_df = work_df[~is_valid].copy()
    quarantine_df["validation_errors"] = errors[~is_valid]

    return clean_df, quarantine_df
2. 执行清洗与结果检验示例
以下构造一组包含典型脏数据的测试输入,验证上述校验逻辑的执行效果:
# 构造模拟输入数据(示例)
raw_data = {
    "order_id": ["ORD-100001", "INVALID_02", "ORD-100003", "ORD-100004"],
    "customer_age": [28, 15, 34, 45],
    "amount": [399.0, 120.0, -50.0, 888.0],
    "status": ["PAID", "PAID", "UNPAID", "PAID"],
    "paid_at": ["2026-03-01 10:20:00", "", None, None]  # 第4条已支付但无时间
}
raw_df = pd.DataFrame(raw_data)

# 执行校验与清洗
clean_df, quarantine_df = validate_sales_pipeline(raw_df)

print("=== 合规数据集 (可安全送入下游模型/数据库) ===")
print(clean_df[["order_id", "customer_age", "amount", "status"]])

print("\n=== 隔离数据集 (带具体错误标签) ===")
print(quarantine_df[["order_id", "validation_errors"]])
输出结果(示例说明):
=== 合规数据集 (可安全送入下游模型/数据库) ===
     order_id  customer_age  amount status
0  ORD-100001            28   399.0   PAID

=== 隔离数据集 (带具体错误标签) ===
     order_id                               validation_errors
1  INVALID_02     [订单ID格式非法] [用户年龄不在18-100范围]
2  ORD-100003                            [交易金额超出正常区间]
3  ORD-100004                      [已支付订单缺少付款时间]
这里没有使用 df.apply(..., axis=1),而是利用 np.where 配合向量化逻辑表达式。对于 100 万条记录,apply(axis=1) 通常需要耗费数十秒,而向量化布尔计算通常仅需 100~300 毫秒,性能相差两个数量级。
三、集成基于 Schema 的强类型校验引擎(Pydantic 与 Pandera)
当业务逻辑极其复杂、包含层级嵌套或需要多团队共享统一的数据契约时,手写布尔掩码容易出现规则零散、不易维护的问题。此时引入专业的 Python 数据校验库能够提供更强的类型保证与更详尽的错误溯源。
1. 集成 Pydantic 进行逐行/批次强约束校验
Pydantic 擅长处理复杂的对象级验证。为了避免在 DataFrame 上直接使用 df.apply() 造成的循环性能惩罚,推荐使用 DataFrame.to_dict(orient="records") 配合列表推导式或生成器进行校验:
from typing import Optional
from datetime import datetime
from pydantic import BaseModel, Field, field_validator, model_validator
import pandas as pd

class UserCleanRecord(BaseModel):
    user_id: int = Field(gt=0, description="用户ID必须为正整数")
    username: str = Field(min_length=3, max_length=20)
    email: str = Field(pattern=r"^[\w\.-]+@[\w\.-]+\.\w+$")
    signup_date: datetime
    invited_by: Optional[int] = None

    @field_validator("username")
    @classmethod
    def no_special_prefix(cls, v: str) -> str:
        if v.startswith("guest_"):
            raise ValueError("临时游客账号不得作为正式用户录入")
        return v

def validate_dataframe_with_pydantic(df: pd.DataFrame):
    valid_rows = []
    error_records = []

    # 转化为字典序列迭代,性能明显优于 df.apply(axis=1)
    records = df.to_dict(orient="records")

    for idx, row in enumerate(records):
        try:
            # Pydantic 校验与类型自动转换
            validated_obj = UserCleanRecord(**row)
            valid_rows.append(validated_obj.model_dump())
        except Exception as e:
            # 记录行索引与结构化错误明细
            error_records.append({
                "original_index": idx,
                "raw_data": row,
                "error_details": str(e)
            })

    clean_df = pd.DataFrame(valid_rows)
    quarantine_df = pd.DataFrame(error_records)
    return clean_df, quarantine_df
2. 集成专为 DataFrame 设计的 Pandera
相比于 Pydantic 针对单对象的校验模式,Pandera 是专门为 Pandas/Polars 设计的统计校验框架。它既具备 Schema 的声明式优点,又在底层充分利用了 Pandas 的向量化特性:
import pandera as pa
from pandera import Column, Check, DataFrameSchema

# 声明 DataFrame 校验契约
user_schema = DataFrameSchema(
    columns={
        "user_id": Column(int, Check.greater_than(0), nullable=False),
        "username": Column(str, Check.str_length(min_value=3, max_value=20)),
        "age": Column(int, Check.in_range(18, 120)),
        "status": Column(str, Check.isin(["ACTIVE", "PENDING", "INACTIVE"])),
    },
    # 允许开启惰性校验模式(收集全部错误,而非遇到第一个就中断)
    coerce=True,
    strict=False
)

def run_pandera_pipeline(df: pd.DataFrame):
    try:
        # lazy=True 将一次性返回所有不符合规则的行和列明细
        validated_df = user_schema.validate(df, lazy=True)
        return validated_df, None
    except pa.errors.SchemaErrors as err:
        # 获取失败案例的详细信息(含行索引、列名、失败检查项)
        failure_cases = err.failure_cases
        return None, failure_cases
四、两类校验方式的关键差异及其影响
在 Pandas 中集成校验逻辑时,开发者经常在“原生向量化掩码”与“Schema 校验引擎”之间摇摆。这两者并不是优劣对立的关系,而是在不同的工程约束下的权衡选择。
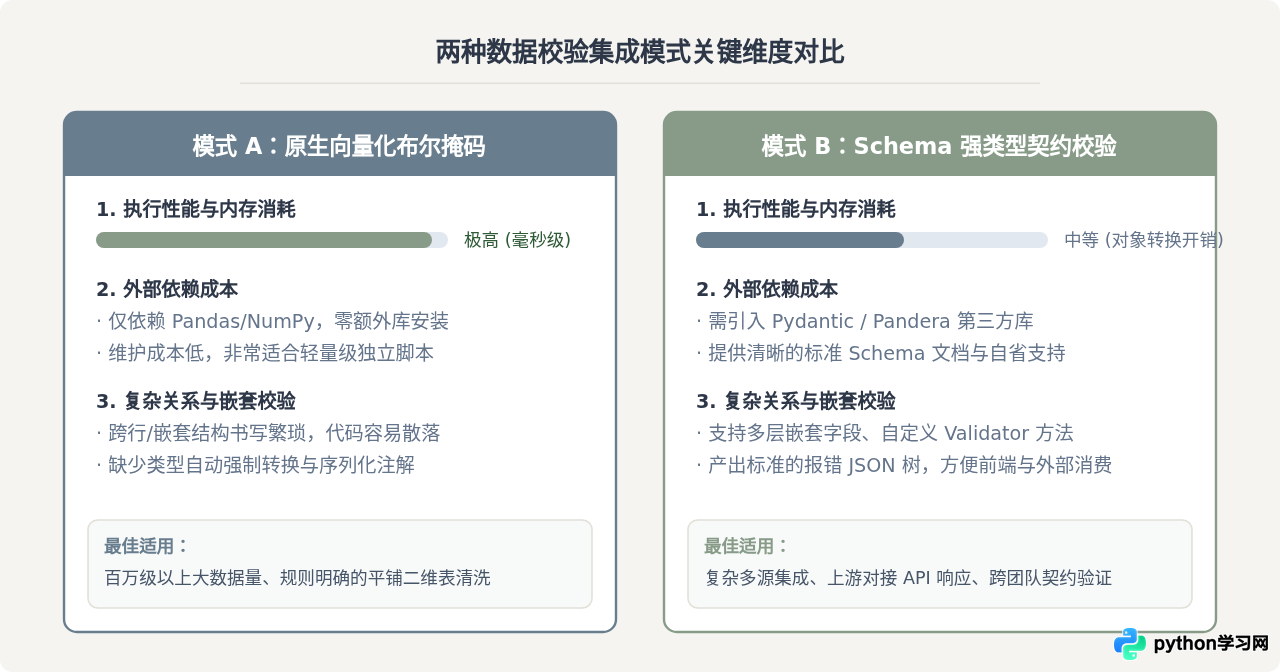
理解这两种差异对系统架构设计至关重要:
- 为什么性能差异重要: 原生向量化掩码操作直接在连续内存块(C-contiguous arrays)上完成比较,单核每秒可处理数百万条校验。而如果将每一行转化为 Pydantic 的 Python 对象实例,涉及 Python 对象的频繁创建、析构与方法分发,在十万行以上规模时运行时间会从几百毫秒飙升至几十秒。
- 为什么契约表达力重要: 当清洗管道需要向上游数据生产方出具严格的“数据接入质量报告”时,手写的掩码很难生成结构化、字段路径分明的错误信息;而 Pydantic/Pandera 可以自动生成具备行列定位、预期值与实际值的完整错误树。
五、工程化落地避坑要点
在将 Python 校验集成到清洗工程中时,常常会遇到以下三个典型陷阱,需在编码时特别防范:
1. 慎用 DataFrame.apply() 挂载复杂校验函数
初学者最容易写出类似 df.apply(lambda row: check_business_logic(row), axis=1) 的代码。在 Pandas 中,apply(axis=1) 本质上是带有一层封装的纯 Python for 循环,不仅速度慢,还会导致极高的内存波动。如果必须执行行级复合校验,应优先考虑使用 np.select 或 np.logical_and 拼接布尔数组。
2. 警惕 np.nan 与 Python 原生类型的真假值陷阱
Pandas 在数值列存在缺失值时,默认会将整列转换为 float64,缺失值表示为 np.nan。而 np.nan 在 Python 原生条件判断中被视作真值:
# 典型逻辑陷阱
import numpy as np

val = np.nan
if val:
    # 这里的代码会被执行!因为 bool(np.nan) 为 True
    print("np.nan 被判断为 True,可能导致清洗逻辑误判")
因此,在编写校验条件时,务必先显式使用 pd.isna() 或 Series.notna() 隔离空值,再进行数值或逻辑对比。
3. 隔离集与清洗集必须进行深拷贝隔离
通过切片 clean_df = df[is_valid] 获取的子数据集,内部往往保留着对原数据缓冲区的引用视图。随后如果在 clean_df 上直接进行数据转换(如 clean_df["amount"] = clean_df["amount"].round(2)),极易引发经典的 SettingWithCopyWarning 警告。正确的做法是在分流后立即调用 .copy() 显式切断引用。
六、总结
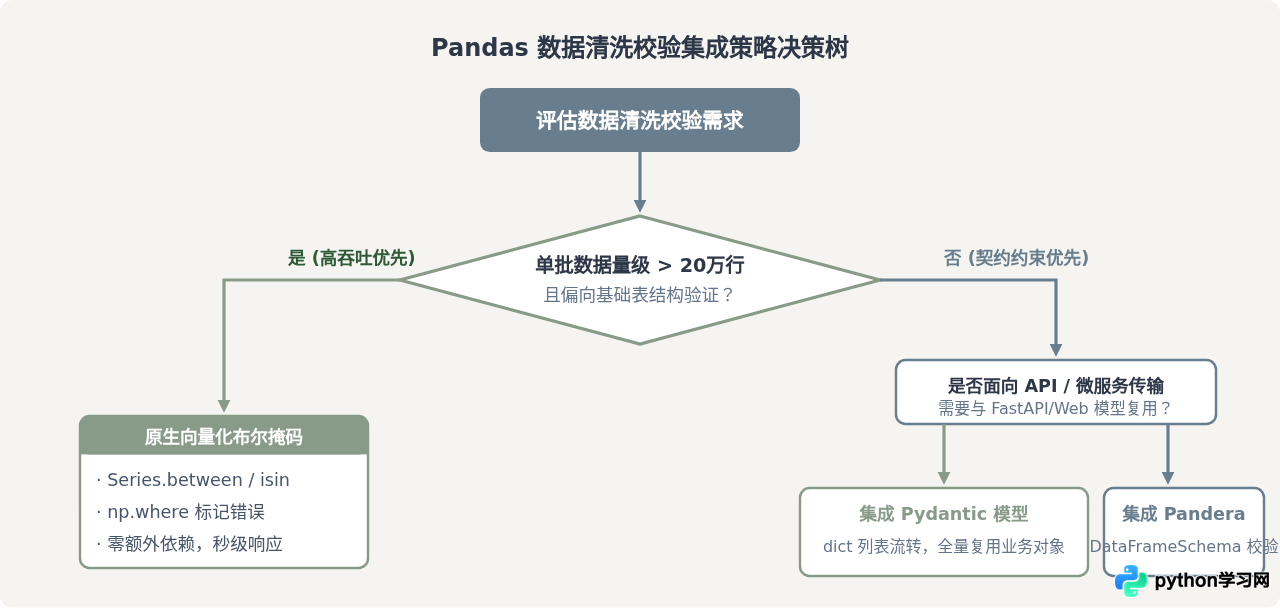
在 Pandas 数据清洗中集成 Python 数据校验逻辑,是保障数据管道韧性与业务指标可信度的关键环节。对于追求高吞吐量与低依赖的清洗任务,优先采用向量化布尔掩码结合 np.where 的方式,兼顾极致的运算性能与错误标记能力;而在涉及跨系统协同、严格契约对接的复杂业务场景下,采用 Pandera 或 Pydantic 建立显式 Schema,能提供自说明的业务契约与精确到字段级的错误追踪。结合“隔离区路由机制”,将坏数据与清洗主干流程解耦,才能打造出健壮、可维护且易排查的现代数据流水线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









