

Python矩阵运算入门:用NumPy创建与操作数组
面向Python初学者的NumPy矩阵运算实战教程,系统讲解多维数组ndarray的创建、核心属性检查、多维切片提取、形状重塑以及逐元素运算与矩阵点积的本质差异。
ndarray,在提供简洁矩阵代数语法的同进,实现了接近硬件底层的 SIMD 向量化计算速度。本文将直接从核心原理与具体实操切入,带你彻底掌握 NumPy 数组的创建、维度与属性查看、索引切片机制,以及从逐元素运算到线性代数矩阵乘法的完整工作流。
一、为什么矩阵计算需要 NumPy:底层内存架构解析
初学者常有的疑惑是:既然原生 Python 列表通过 matrix = [[1, 2], [3, 4]] 已经能表示二维表格,为什么还要引入独立的第三方库?要理解两者的差异,必须从底层的内存结构说起。
Python 原生列表本质上是一个动态的指针数组。当你在列表中存放整数时,列表内保存的并不是整数值本身,而是指向分散在系统堆内存中 PyObject 结构的指针。对于二维嵌套列表,程序需要经历两层指针寻址才能读取到一个数字。这种非连续、高开销的指针链式结构会导致 CPU 缓存(L1/L2 Cache)命中率大幅下降,且完全无法利用现代 CPU 的并行向量计算(SIMD)能力。
与之相对,NumPy 的核心对象 ndarray(N-dimensional Array)将所有元素作为同一类型的纯二进制数据(如 64 位整数或 64 位浮点数),连续存储在一段完整的物理内存缓冲区(Data Buffer)中。数组头部(Array Header)仅记录数据的形状(shape)、步长(strides)和类型(dtype)等元信息。
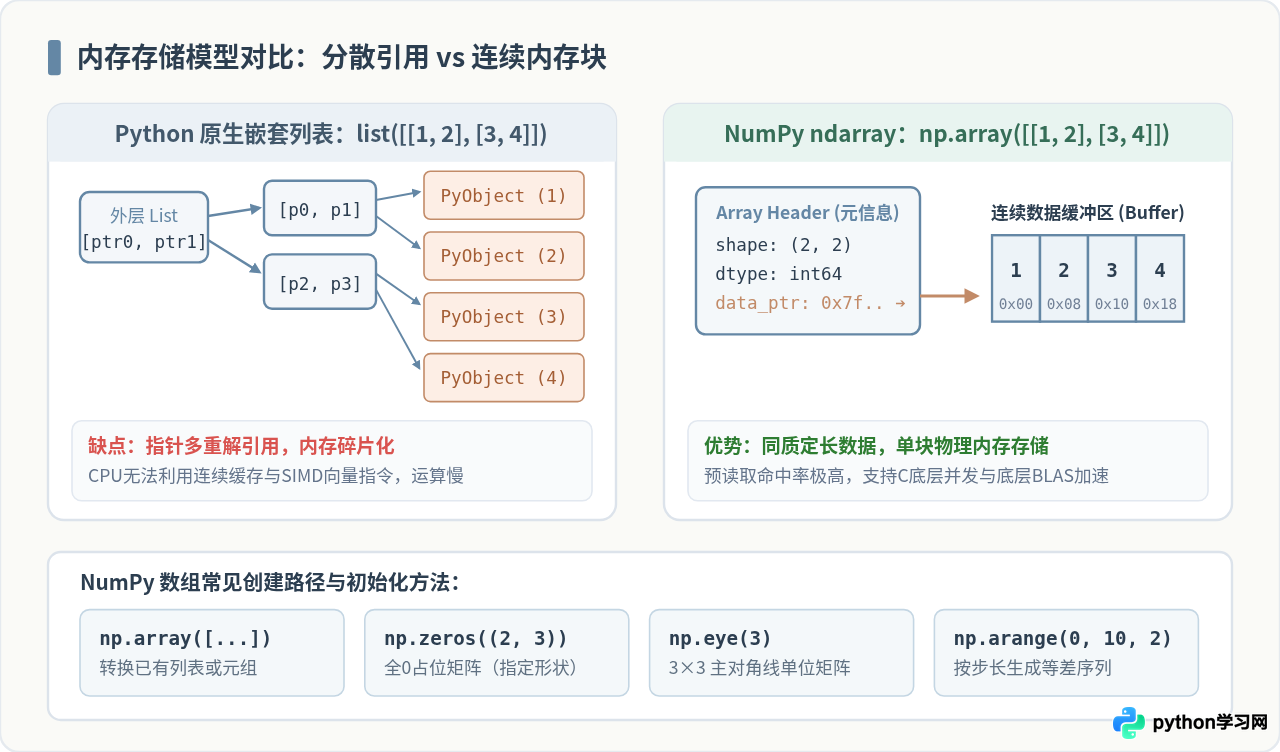
这种内存设计赋予了 NumPy 两大压倒性优势:第一,在连续内存上执行批量计算时,CPU 能以极高的吞吐率预读数据,效率相比原生循环通常有数十倍到上百倍的提升;第二,基于固定的步长(Strides)计算寻址,可以在不复制真实数据的前提下,实现瞬时的转置、切片和形状重塑。
二、创建 NumPy 数组:从基础向量到特定矩阵
在开始编写代码前,请确保环境中已正确安装 NumPy。若未安装,可在系统终端中执行标准包管理命令:
pip install numpy在 Python 脚本或交互式解释器中,按照社区公认的命名惯例导入模块:
import numpy as np1. 从原生序列直接转换
最直观的创建方式是调用 np.array() 函数,将 Python 的列表或元组转换为 ndarray:
# 创建一维行向量
vec = np.array([1, 2, 3, 4])

# 创建 2x3 二维矩阵
mat = np.array([
    [1.0, 2.0, 3.0],
    [4.0, 5.0, 6.0]
])

print("一维向量 vec:\n", vec)
print("二维矩阵 mat:\n", mat)2. 核心属性检查
创建数组后,无需打印全部数据,可通过以下核心属性直接洞察其数学结构:
mat.shape:返回一个元组,表示各维度的大小。例如(2, 3)代表 2 行 3 列。mat.ndim:返回维度的数量。一维数组为 1,二维矩阵为 2。mat.dtype:返回数组元素的数据类型。如float64、int64。NumPy 数组内所有元素必须类型一致。mat.size:返回数组中的总元素个数,等于各维度大小的乘积(2 × 3 = 6)。
3. 快速生成特定矩阵的内置函数
在算法编写与数值计算中,手动输入列表既低效又容易出错。NumPy 提供了针对常见数学矩阵的快速构建函数:
# 1. 全 0 矩阵:生成 3 行 4 列的全 0 浮点矩阵
zeros_mat = np.zeros((3, 4))

# 2. 全 1 矩阵:生成 2 行 3 列的全 1 整数矩阵
ones_mat = np.ones((2, 3), dtype=np.int32)

# 3. 单位矩阵(Identity Matrix):对角线为 1、其余全为 0 的 3x3 方阵
eye_mat = np.eye(3)

# 4. 等差序列向量:起始值 0,终止值 10(不含),步长 2
range_vec = np.arange(0, 10, 2)

# 5. 等间距采样:在 0 到 1 之间均匀生成 5 个数值
linspace_vec = np.linspace(0, 1, 5)

print("单位矩阵 eye(3):\n", eye_mat)
print("arange(0, 10, 2):\n", range_vec)
print("linspace(0, 1, 5):\n", linspace_vec)三、多维切片与索引:精准截取子矩阵
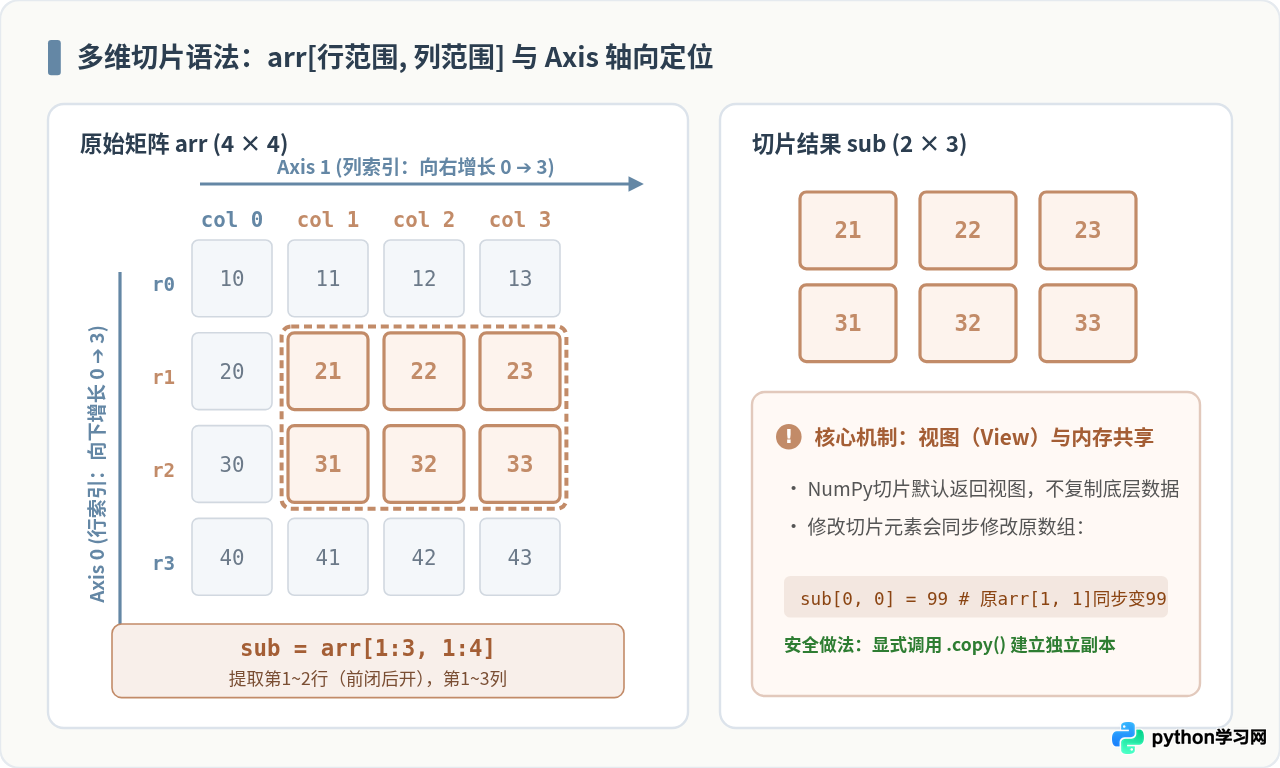
在多维矩阵中定位与提取子数据块是数据处理中最频繁的操作。NumPy 采用多维坐标轴概念:对于二维矩阵,axis=0 代表行(垂直向下延伸),axis=1 代表列(水平向右延伸)。
二维切片的标准语法为:arr[行起始:行结束:行步长, 列起始:列结束:列步长],范围严格遵循 Python “左闭右开”(包含起始索引,不包含结束索引)的规则。
以下代码展示了常用的切片与局部提取模式:
# 构建一个 4x4 的连续数字矩阵
grid = np.arange(10, 26).reshape(4, 4)
print("原始矩阵 grid:\n", grid)

# 提取第 1 到 2 行(索引 1:3),第 1 到 3 列(索引 1:4)
sub_matrix = grid[1:3, 1:4]
print("截取的 2x3 子矩阵 sub_matrix:\n", sub_matrix)

# 提取某一行或某一列
row_1 = grid[1, :]      # 提取第 1 行所有列,形状为 (4,)
col_2 = grid[:, 2]      # 提取第 2 列所有行,形状为 (4,)
print("第 1 行:", row_1)
print("第 2 列:", col_2)与原生 Python 列表切片会创建新列表不同,NumPy 的基本切片返回的是原数组的“视图”(View)。视图与原数组共享完全相同的底层内存缓冲区。
如果在切片结果上执行修改操作(例如 sub_matrix[0, 0] = 999),原数组 grid[1, 1] 的值也会同步变成 999!如果你需要修改切片而不影响原矩阵,必须显式调用 .copy() 方法生成独立内存副本:
# 安全操作:独立副本
sub_copy = grid[1:3, 1:4].copy()
sub_copy[0, 0] = 999  # 原矩阵 grid 不会受到任何影响
四、形状重塑与转置:灵活变换矩阵维度
矩阵计算经常需要在行向量、列向量和不同维度的二维表格之间进行变换。NumPy 提供了极其灵活的维度变换方法:
1. 使用 reshape 调整矩阵结构
reshape() 可以在不改变元素总量和排列顺序的前提下,重新划分行与列。要求变换前后的元素总数必须完全相等:
a = np.arange(1, 7)  # 包含 6 个元素的一维数组: [1, 2, 3, 4, 5, 6]

# 重塑为 2 行 3 列
m1 = a.reshape(2, 3)

# 传入 -1 让 NumPy 自动推导该维度的大小
m2 = a.reshape(3, -1)  # 自动计算得出列数为 2

print("2x3 矩阵:\n", m1)
print("3x2 矩阵 (使用 -1 自动推导):\n", m2)
2. 矩阵转置(Transpose)
矩阵转置是指将矩阵的行与列互换(即 $A^T$)。在 NumPy 中,直接访问二维数组的 .T 属性即可获得转置视图:
mat_orig = np.array([[1, 2, 3], [4, 5, 6]])  # shape (2, 3)
mat_t = mat_orig.T                           # shape (3, 2)

print("转置后矩阵:\n", mat_t)五、核心矩阵运算:逐元素计算、广播与矩阵点积
这是初学者最容易产生混淆的核心区域:数学中的“矩阵相乘”与编程语言中的算术乘法符号 * 在 NumPy 中具有截然不同的含义。
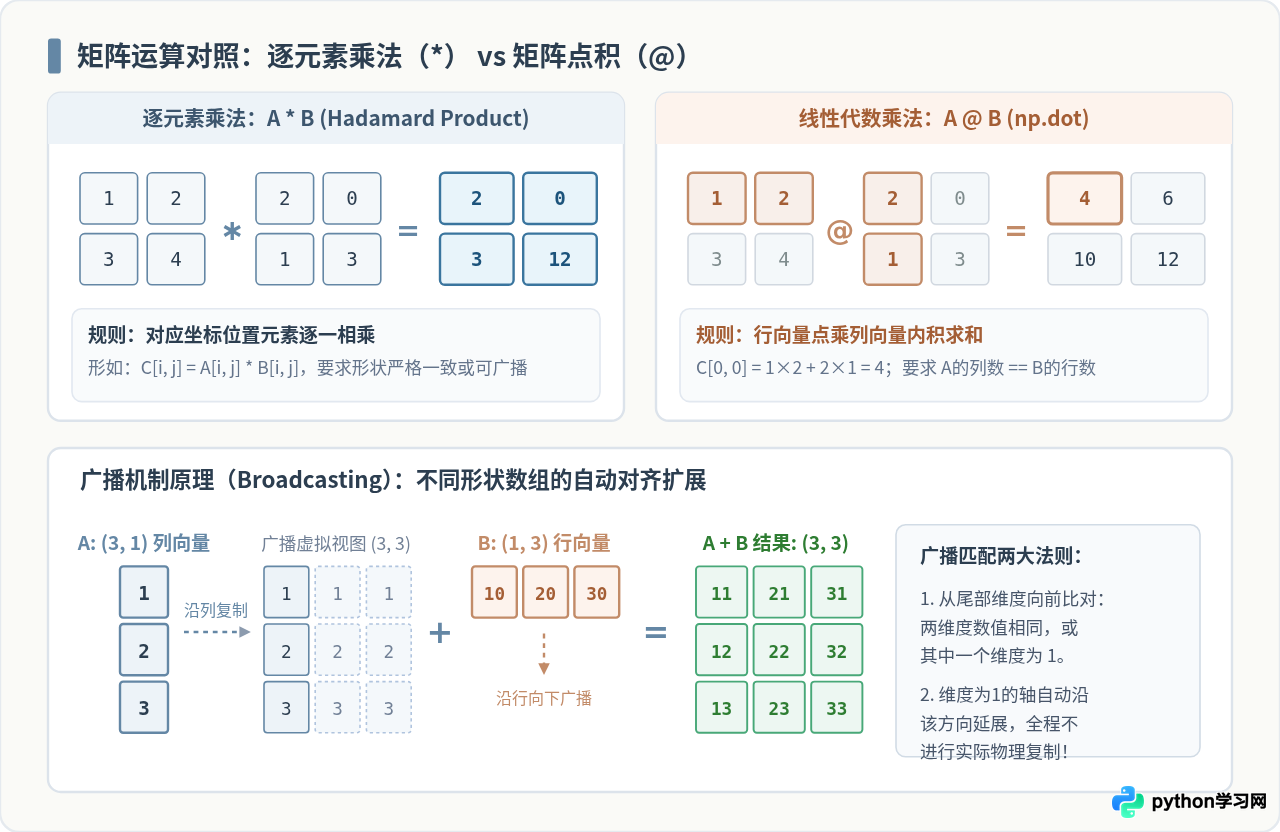
1. 逐元素数学运算(Element-wise Operations)
在 NumPy 中,标准的四则运算符(+、-、*、/、**)全部作用于对应位置的元素(数学上称为 Hadamard 积)。
A = np.array([[1, 2], [3, 4]])
B = np.array([[2, 0], [1, 3]])

# 逐元素加法与乘法
print("逐元素相加 A + B:\n", A + B)
print("逐元素相乘 A * B:\n", A * B)2. 线性代数中的矩阵乘法(Matrix Product / Dot Product)
线性代数定义的矩阵乘法规则是:结果矩阵的第 $i$ 行第 $j$ 列元素,等于第一个矩阵的第 $i$ 个行向量与第二个矩阵的第 $j$ 个列向量的内积(对应元素相乘再求和)。
在 Python 3.5 之后,推荐使用专用的中缀矩阵乘法运算符 @,也可以使用 np.dot(A, B) 或 np.matmul(A, B):
# 矩阵点乘:A (2x2) @ B (2x2)
dot_result = A @ B
print("矩阵点积 A @ B:\n", dot_result)
运算过程说明:结果的左上角元素为 $1 imes 2 + 2 imes 1 = 4$;右上角为 $1 imes 0 + 2 imes 3 = 6$;左下角为 $3 imes 2 + 4 imes 1 = 10$;右下角为 $3 imes 0 + 4 imes 3 = 12$。这与逐元素乘法 A * B 得到的结果完全不同。
3. 广播机制(Broadcasting):不同形状数组的运算
当两个数组的形状不完全相同时,NumPy 会尝试启动“广播”规则,自动将较小维度的数组在逻辑上沿特定方向复制延伸,以便完成逐元素计算。
广播成立的必要条件非常严格:从两个数组的尾部维度(即最右侧维度)向前比对,对于每一个维度,两个数组在该维度的长度必须满足以下两条之一:
- 维度的数值完全相等;
- 其中一个数组在该维度的长度为 1。
# 案例:将一个 1x3 的行向量加到一个 3x3 矩阵的每一行
matrix_3x3 = np.array([
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
])
row_vec = np.array([1, 2, 3])  # shape (3,) 广播为 (1, 3) 再延展为 (3, 3)

broadcast_sum = matrix_3x3 + row_vec
print("广播相加结果:\n", broadcast_sum)4. 常用线性代数工具:逆矩阵与行列式
NumPy 的 np.linalg 子模块集成了工业级的线性代数计算功能。对于非奇异方阵,可以通过 inv() 求解其逆矩阵,验证 $A @ A^-1 = I$:
# 求解可逆方阵的逆矩阵
M = np.array([[2.0, 1.0], [5.0, 3.0]])

# 计算行列式 det(M)
det_val = np.linalg.det(M)

# 计算逆矩阵
inv_M = np.linalg.inv(M)

print("行列式 det(M):", round(det_val, 4))
print("逆矩阵 inv_M:\n", inv_M)
print("验证 M @ inv_M(得到单位阵):\n", np.round(M @ inv_M))六、知识总结与实战避坑指南
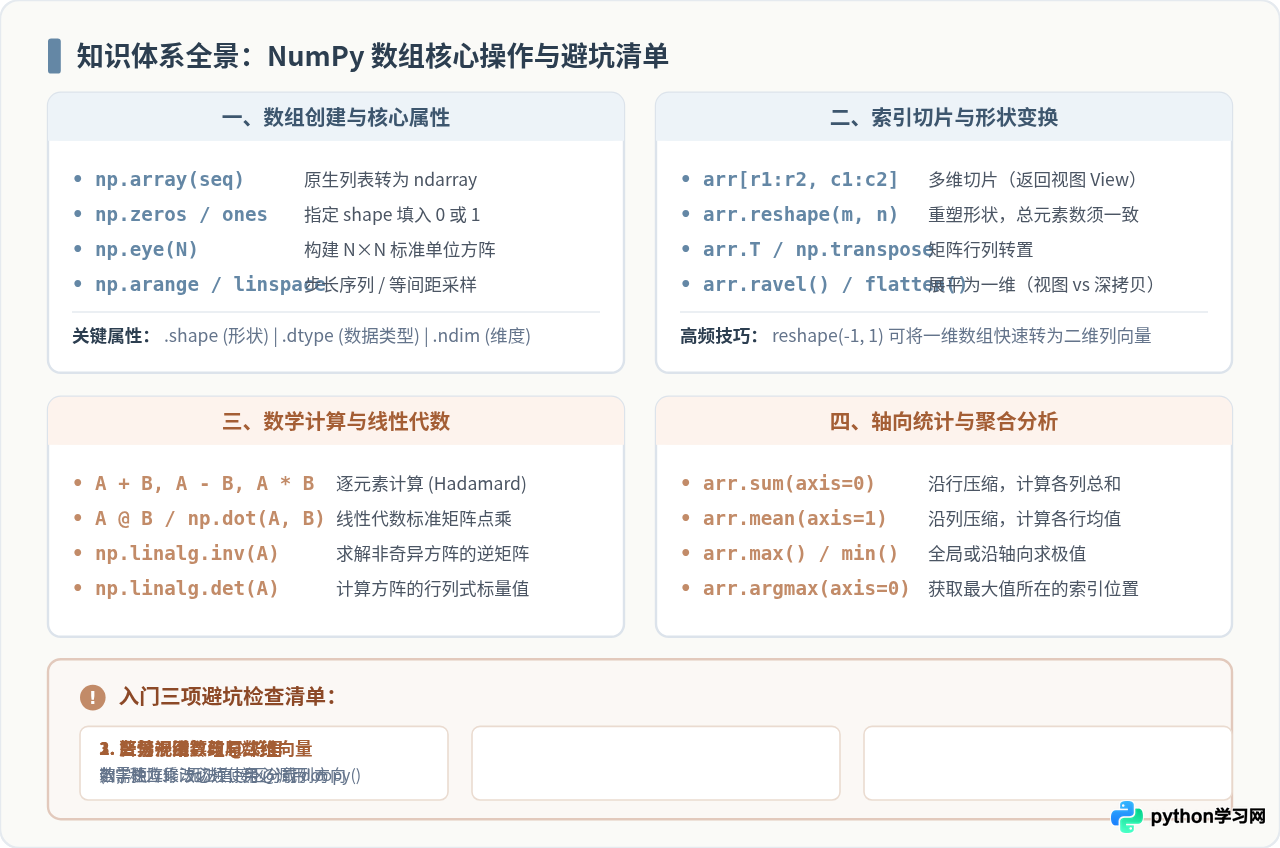
为了帮助大家在日常编码中快速查阅与验证,下图梳理了从数组创建、属性诊断、形状切片到高维运算的完整技术链路与常见避坑清单:
| 操作类型 | 标准语法示例 | 输出形状说明 | 核心注意事项 |
|---|---|---|---|
| 基础创建 | np.array([[1, 2], [3, 4]]) |
(2, 2) | 内部元素必须是同一种数据类型,否则会被强制降级向上转型 |
| 单位矩阵 | np.eye(3) |
(3, 3) | 主对角线全为 1,其余全为 0 的二维方阵 |
| 二维切片 | mat[0:2, 1:3] |
(2, 2) | 返回视图,对切片的赋值修改会直接反作用于原矩阵 |
| 安全拷贝 | mat[0:2, 1:3].copy() |
(2, 2) | 分配独立的连续数据缓冲区,切断与原数据的内存关联 |
| 形状重塑 | arr.reshape(2, -1) |
(2, N) | -1 允许自动推导,但前后元素总数量必须严格一致 |
| 逐元素乘 | A * B |
与输入相同或广播后形状 | 对应位置数值相乘,非线性代数矩阵乘法 |
| 矩阵乘法 | A @ B 或 np.dot(A, B) |
(m, k) @ (k, n) ➔ (m, n) | 前项列数必须严格等于后项行数,否则触发 ValueError |
熟练掌握 NumPy 数组的创建与矩阵操作,是进一步学习数据分析(Pandas)、科学计算(SciPy)以及现代深度学习框架(PyTorch / TensorFlow)的必备基石。通过合理运用连续内存向量化与切片机制,不仅能够写出简洁易读的数学公式化代码,更能让 Python 程序发挥出极致的数值计算效能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









