

怎么在Python中使用SQLAlchemy连接达梦数据库
详细讲解在Python中使用SQLAlchemy连接达梦数据库(DM8/DM7)的完整步骤与工程实践,包括底层驱动依赖、连接串规范、原生SQL测试、ORM模型映射与避坑指南。
dm+dmPython://user:pwd@host:port 构建 Engine,即可无缝支持原生 SQL 与 ORM 映射操作。
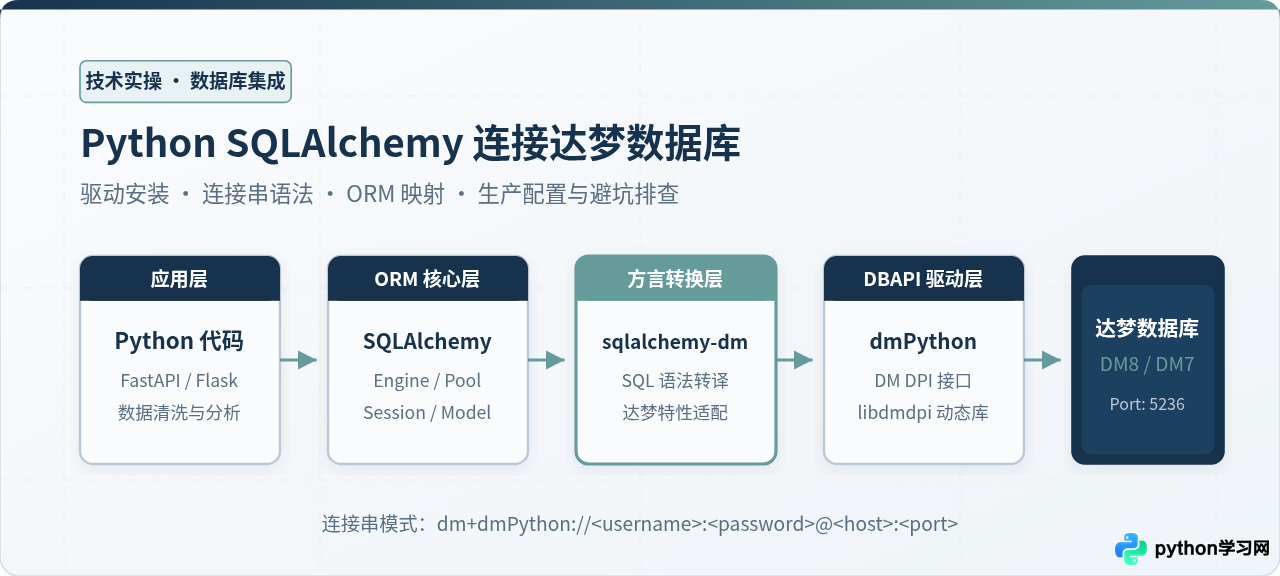
一、连接原理与核心组件分工
SQLAlchemy 是 Python 中广泛使用的 ORM 和数据库工具集,但它本身只内置了 SQLite、PostgreSQL、MySQL、Oracle 等常见数据库的方言(Dialect)。达梦数据库作为自主研发的关系型数据库,其 SQL 语法、数据类型体系及底层驱动与标准库存在一定差异。要在 SQLAlchemy 中与达梦正常通信,必须由以下四个核心分层协同工作:
- SQLAlchemy Core / ORM:负责上层业务的声明式模型定义、会话(Session)生命周期、连接池分配以及生成通用的 SQL 抽象语法树(AST)。
- 达梦方言(sqlalchemy-dm):充当“翻译官”,将 SQLAlchemy 生成的通用 SQL 语法翻译为达梦数据库支持的语法(例如分页语句、序列处理、主键自增机制),并将达梦专有类型映射为 SQLAlchemy 标准类型。
- 底层驱动(dmPython):遵循 Python DBAPI 2.0(PEP 249)规范的驱动实现,负责直接与达梦 C 语言接口(DM DPI)通信。
- 系统动态链接库(libdmdpi):达梦提供的底层本地运行时库(Linux 下为
libdmdpi.so,Windows 下为dmdpi.dll),负责底层的 TCP/IP 网络封包与协议传输。
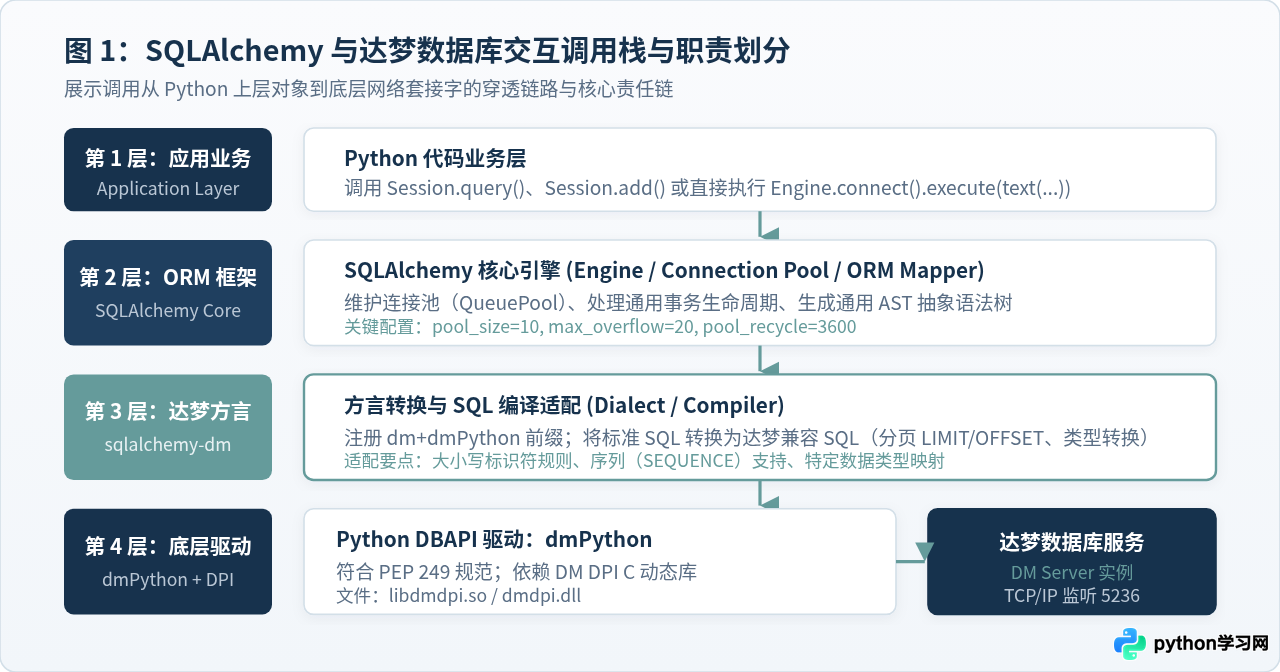
二、前置环境准备与依赖安装
连接达梦数据库的第一步是保证操作系统中存在达梦底层库,并且 Python 环境能够定位到它。
1. 配置达梦客户端运行时库(DM DPI)
dmPython 模块并非纯 Python 编写,而是一个依赖达梦 C 接口(DPI)的二进制扩展。因此,运行环境中必须具备达梦客户端运行环境(通常随达梦数据库服务端或达梦客户端软件包一起提供)。
在 Linux 操作系统中,达梦运行库位于安装目录的 bin 目录下(默认通常为 /opt/dmdbms/bin)。需要将该路径加入动态链接库搜索路径:
# 临时导出环境变量(测试验证)
export DM_HOME=/opt/dmdbms
export LD_LIBRARY_PATH=$DM_HOME/bin:$LD_LIBRARY_PATH

# 若需持久生效,可将其写入 /etc/profile 或 ~/.bashrc
在 Windows 操作系统中,需将达梦安装路径下的 bin 目录(如 C:\dmdbmsin)添加到系统的 PATH 环境变量中,并重启终端或 IDE。
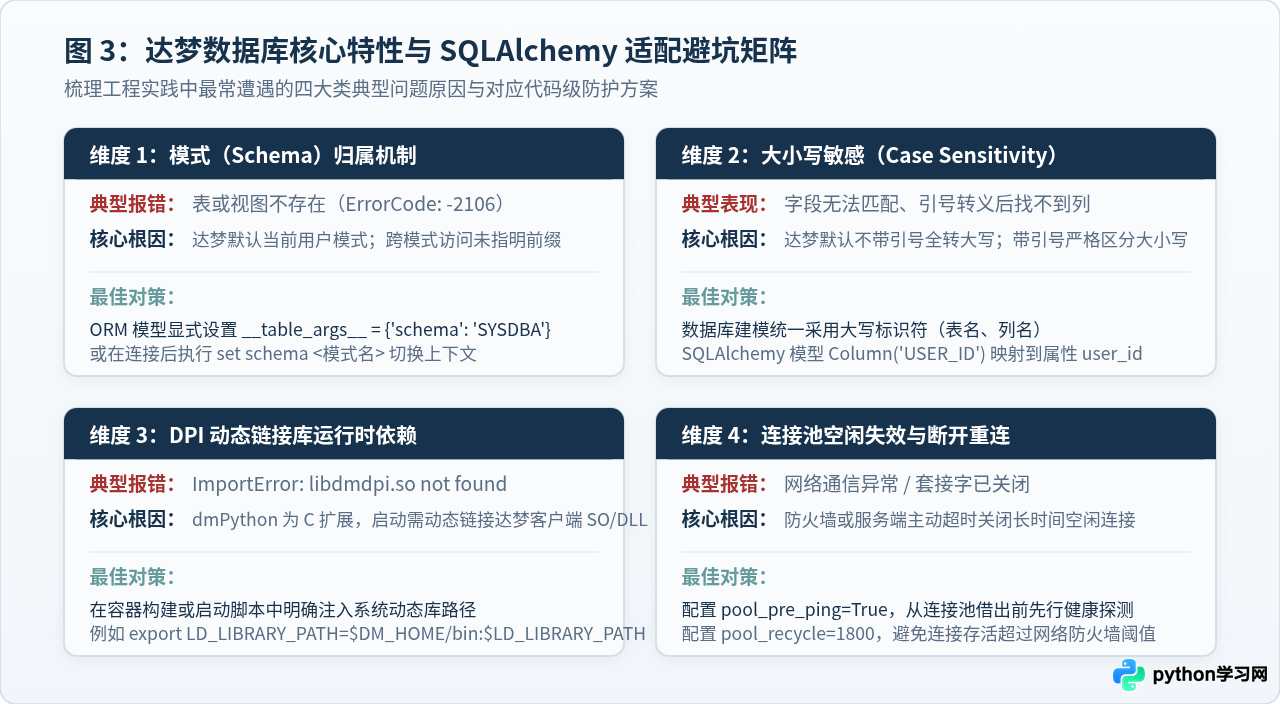
dmPython 时会直接抛出 ImportError: libdmdpi.so: cannot open shared object file: No such file or directory 错误。遇到此错误首先排查环境变量配置。
2. 安装 Python 驱动包与方言包
在确认系统库就绪后,通过 pip 安装 dmPython 驱动与 sqlalchemy-dm 方言包:
pip install dmPython
pip install sqlalchemy-dm
如果所在网络环境无法直接连接公网 PyPI,或者处于信创内网离线环境,达梦官方安装包中已内置了编译好的 .whl 文件,通常位于达梦安装目录下的 drivers/python/ 目录:
# 进入达梦安装目录驱动路径并离线安装
cd $DM_HOME/drivers/python
pip install dmPython-*.whl
pip install sqlalchemy_dm-*.whl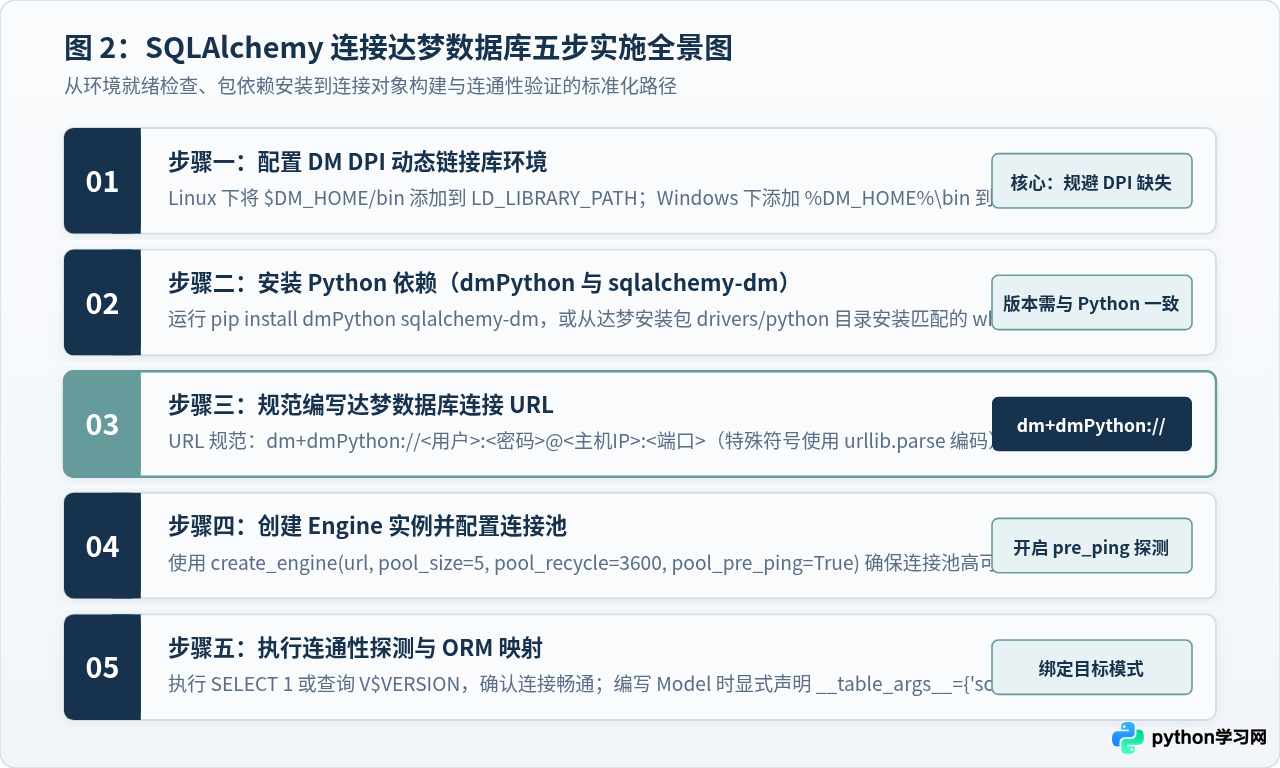
三、构建数据库连接串与创建 Engine
SQLAlchemy 依靠数据库统一资源标识符(Database URL)来确定使用的方言和驱动。达梦方言注册的前缀名称为 dm+dmPython。
1. 连接 URL 格式规范
连接串的标准结构如下:
dm+dmPython://<用户名>:<密码>@<主机地址>:<端口号>各部分参数的具体说明如下表所示:
| 参数项 | 示例值 | 说明 |
|---|---|---|
| 方言与驱动 | dm+dmPython |
固定前缀,指示 SQLAlchemy 载入 sqlalchemy-dm 并使用 dmPython |
| 用户名 | SYSDBA |
达梦数据库中的用户名称,默认为管理员账户或业务账户 |
| 密码 | SYSDBA001 |
用户对应的密码;若密码中包含 @、:、/ 等特殊字符,须使用 urllib.parse.quote_plus 编码 |
| 主机地址 | 192.168.1.100 |
达梦数据库服务监听的 IP 地址或域名 |
| 端口号 | 5236 |
达梦数据库默认端口为 5236,若修改过则填写对应端口 |
2. 特殊字符密码的安全转义
实际工程中密码往往包含复杂字符。如果直接拼接含有 @ 或 : 的字符串,会导致 URL 解析器切分错误。推荐使用 Python 标准库处理:
import urllib.parse
from sqlalchemy import create_engine

username = "SYSDBA"
raw_password = "P@ssw0rd#2026"
host = "192.168.1.100"
port = 5236

# 对密码进行 URL 编码
safe_password = urllib.parse.quote_plus(raw_password)
db_url = f"dm+dmPython://{username}:{safe_password}@{host}:{port}"

# 生产环境推荐配置连接池保活参数
engine = create_engine(
    db_url,
    echo=False,             # 开启后在控制台打印生成的 SQL
    pool_size=10,           # 连接池常驻连接数
    max_overflow=20,        # 允许超出连接池大小的最大连接数
    pool_recycle=3600,      # 连接回收时间(秒),防止长连接被服务端断开
    pool_pre_ping=True      # 借出连接前主动发送探测语句,自动剔除断开的失效连接
)
四、基础连通性测试与原生 SQL 执行
创建完 engine 实例后,建议先通过最基础的连接执行一条诊断 SQL,确认网络、凭据和动态库均正常可用。
1. 连通性测试代码
from sqlalchemy import create_engine, text

# 建立数据库引擎
engine = create_engine("dm+dmPython://SYSDBA:SYSDBA@127.0.0.1:5236")

def test_connection():
    try:
        # 使用上下文管理器借出物理连接,用毕自动归还
        with engine.connect() as conn:
            # 查询达梦数据库版本信息与当前系统时间
            stmt = text("SELECT BANNER, SYSDATE FROM V$VERSION")
            result = conn.execute(stmt)
            row = result.fetchone()
            print("连接成功!数据库版本信息:")
            print(f"版本: {row[0]}")
            print(f"服务器时间: {row[1]}")
    except Exception as e:
        print(f"连接失败,详细错误信息: {e}")

if __name__ == "__main__":
    test_connection()
预期输出结果示例:
版本: DM Database Server 64 V8.1.2.128-Build(2023.04.17-190184)ENT
服务器时间: 2026-10-31 17:15:00
五、ORM 模式映射与达梦特性避坑排查
在完成基础 SQL 测试后,若要使用 SQLAlchemy ORM,需要特别注意达梦数据库在“模式(Schema)归属”和“大小写敏感度”上的独特性。
1. 模式(Schema)的显式指定
达梦数据库的权限体系中,“用户”与“模式”关系紧密。创建用户时通常会默认创建一个同名的模式(如用户 SYSDBA 默认对应模式 SYSDBA)。如果当前登录账户与数据表所在的模式不一致,或者没有设置默认当前模式,直接执行 SELECT * FROM my_table 会抛出 表或视图不存在(-2106) 错误。
在 SQLAlchemy ORM 模型中,推荐通过 __table_args__ 显式指定表所属的模式:
from sqlalchemy.orm import declarative_base, sessionmaker
from sqlalchemy import Column, Integer, String, DateTime, func

Base = declarative_base()

class Department(Base):
    __tablename__ = "SYS_DEPARTMENT"
    # 关键:显式绑定模式名称,确保跨模式访问正常
    __table_args__ = {"schema": "SYSDBA"}

    id = Column("DEPT_ID", Integer, primary_key=True, autoincrement=True)
    name = Column("DEPT_NAME", String(100), nullable=False)
    created_at = Column("CREATED_AT", DateTime, server_default=func.now())

    def __repr__(self):
        return f"<Department(id={self.id}, name='{self.name}')>"
2. 大小写敏感特性处理
达梦在初始化实例时有一个重要参数 CASE_SENSITIVE(默认值为 1,表示大小写敏感)。
- 当语句中不带双引号时,达梦会将所有未加引号的标识符(表名、列名)自动转换为大写;
- 如果 Python 代码中通过 SQLAlchemy 自动反射或建表生成了带双引号的小写字段(如
"dept_name"),达梦会严格寻找小写列,导致查不到大写的实际列名。
工程规范:在编写模型时,建议如上述代码所示,将物理列名明确以大写指定(如 Column("DEPT_NAME", String(100))),而 Python 类属性依然可以使用符合 PEP 8 风格的小写名称(如 name),兼顾 Python 代码风格与数据库匹配精度。
3. ORM 增删改查完整示例
# 初始化会话工厂
SessionLocal = sessionmaker(bind=engine, autoflush=False, autocommit=False)

def run_orm_operations():
    # 自动建表(若表不存在)
    Base.metadata.create_all(engine)

    session = SessionLocal()
    try:
        # 1. 插入数据 (Create)
        new_dept = Department(name="研发部")
        session.add(new_dept)
        session.commit()
        print(f"数据插入成功,生成的主键 ID 为: {new_dept.id}")

        # 2. 查询数据 (Read)
        dept = session.query(Department).filter(Department.name == "研发部").first()
        print(f"查询到部门记录: {dept}")

        # 3. 更新数据 (Update)
        dept.name = "基础技术研发中心"
        session.commit()
        print(f"更新后部门名称: {dept.name}")

        # 4. 删除数据 (Delete)
        session.delete(dept)
        session.commit()
        print("记录已删除")

    except Exception as err:
        session.rollback()  # 发生异常立即回滚事务
        raise err
    finally:
        session.close()     # 确保释放连接回连接池

if __name__ == "__main__":
    run_orm_operations()
六、生产环境连接生命周期与最佳实践
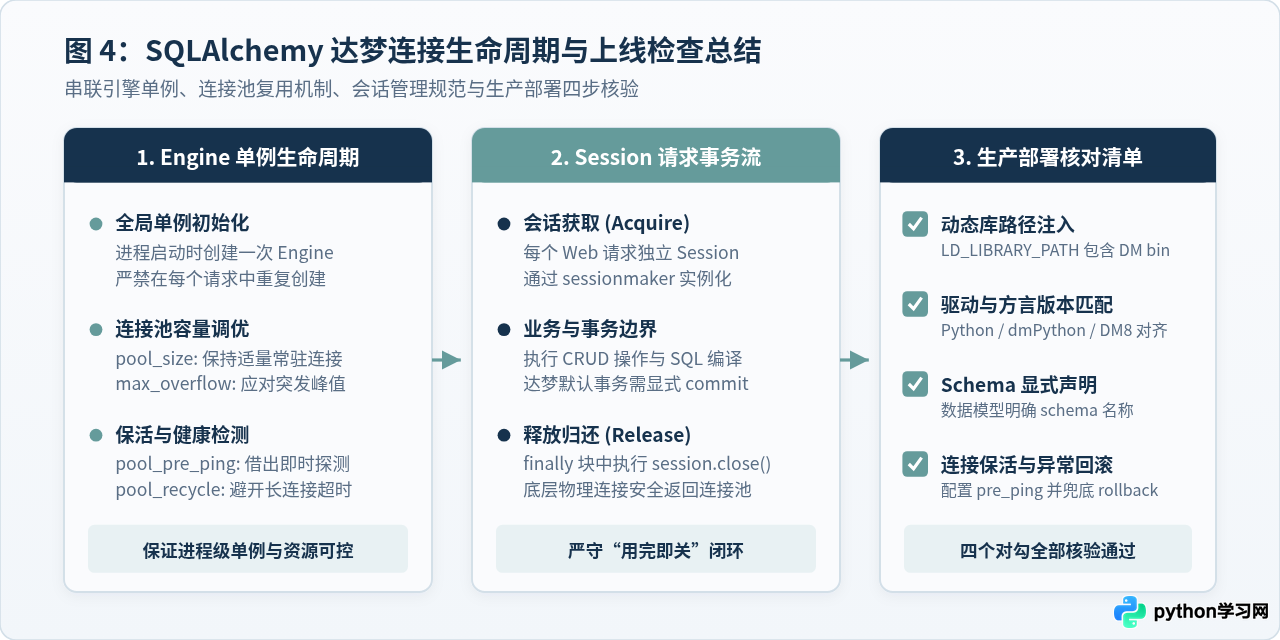
在 Web 框架(如 FastAPI、Django、Flask)或高并发后台任务中使用 SQLAlchemy 连接达梦时,必须妥善管理连接生命周期:
- Engine 维持单例:
create_engine内部包含连接池维护逻辑,应当在进程启动时初始化为全局单例,切忌在每次请求中重复调用create_engine,否则会导致连接泄漏与句柄耗尽。 - 必须开启连接探测(pool_pre_ping):达梦在网络防火墙或服务端配置了空闲超时时,会主动断开静默连接。开启
pool_pre_ping=True可以在从连接池借出连接前发送一次空查询,若发现断开会静默重连,避免前端遭遇Communication error报错。 - 会话生命周期严格闭环:使用
try...except...finally模式,确保无论业务成功还是发生异常,都会执行session.close(),防止连接卡在活跃状态无法回收。
七、总结
在 Python 中使用 SQLAlchemy 连接达梦数据库是一套标准化且成熟的工程链路:
- 环境层:确保操作系统的
LD_LIBRARY_PATH或PATH中包含达梦bin目录以供libdmdpi本地库加载; - 协议层:安装
dmPython驱动与sqlalchemy-dm方言包,构建dm+dmPython://标准连接串; - 应用层:通过
create_engine启用连接池与断线重连,并在 ORM 模型中明确标注schema与大写字段名; - 运维层:建立完整的单例与会话管理规范,保证事务的及时提交或回滚。
遵循上述步骤,即可让达梦数据库完全融入 Python 现代 Web 开发与自动化数据处理的技术栈中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









