

Python字符串格式化全解:f-strings、str.format()与%操作符对比
深入对比Python三大字符串格式化机制:printf风格百分号操作符、str.format()方法与f-strings字面值。全面解析底层原理、Mini-Language规范、执行性能、边界陷阱及工程选型指南。
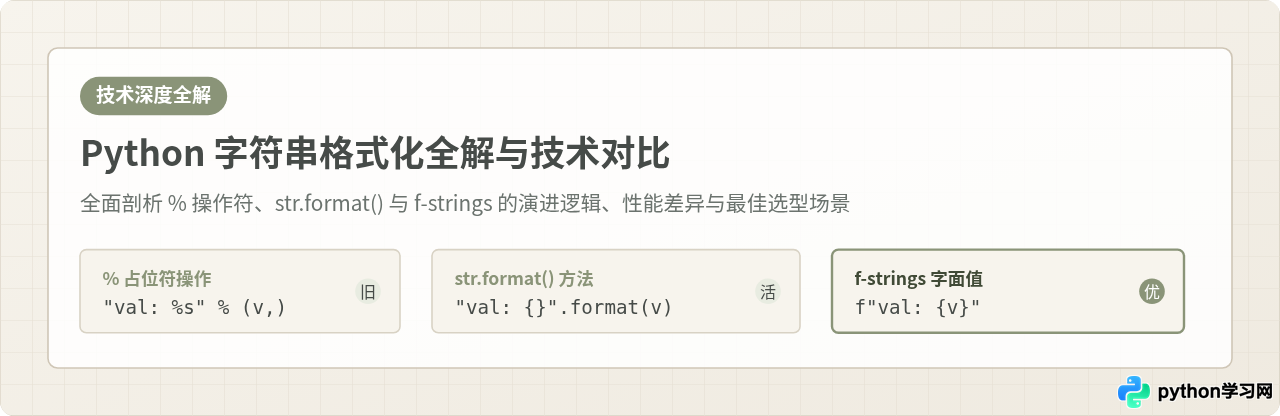
% 操作符,到功能更完备、面向对象的 str.format() 方法,再到 Python 3.6 确立的标准 f-strings(格式化字符串字面值)。结论十分明确:在常规业务开发与现代静态代码中,应毫不犹豫地优先选用 f-strings 以获取最高的可读性与编译期优化性能;在处理国际化(i18n)、外部动态配置或需要解耦模板生命周期的场景中,使用 str.format();而在标准库 logging 日志记录中,则保留传统的 % 机制以实现懒求值。
一、三种格式化机制的语法剖析与典型陷阱
为了在实际项目中写出健壮且规范的代码,我们需要先彻底掌握这三种格式化机制的具体书写形式、参数传递约束以及容易引发运行时异常的边界条件。
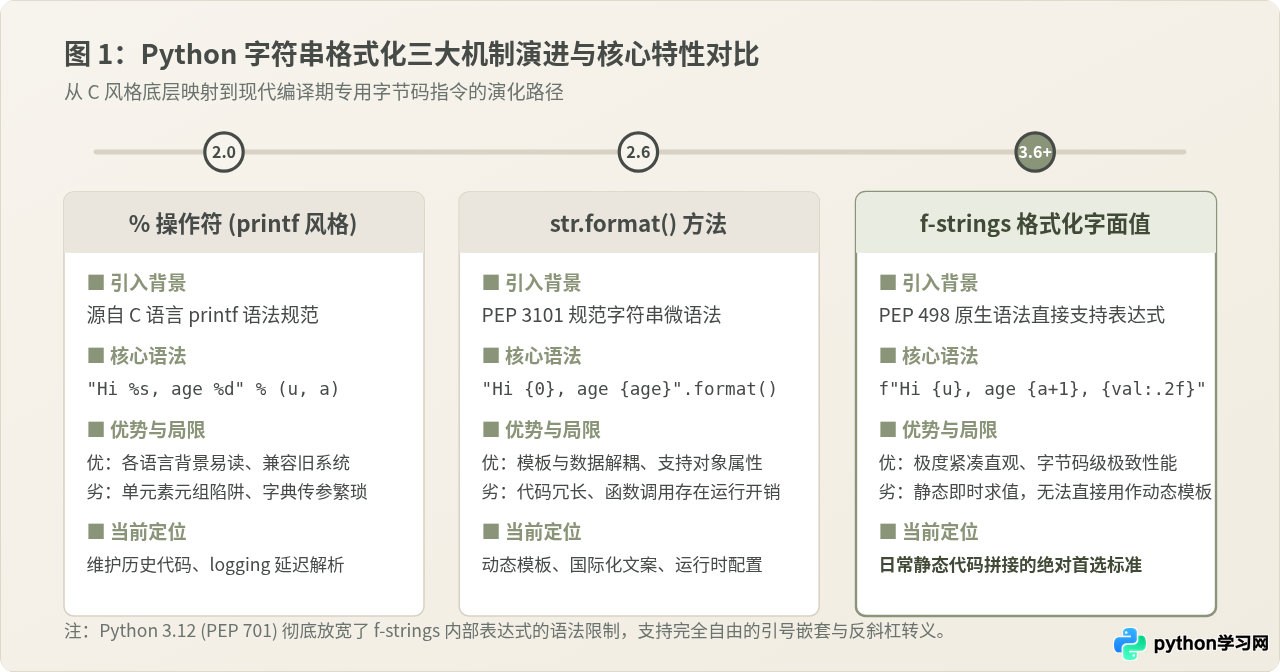
1. % 操作符(printf 风格)
% 格式化操作符是 Python 最早支持的插值方式(早在 Python 2.0 之前即已存在)。它的设计灵感直接来自 C 语言的 printf() 函数家族。其左侧为包含类型占位符的格式化字符串,右侧为对应的值、元组或映射字典:
name = "Alice"
score = 95.5
# 传递单一值或元组
text_tuple = "Student: %s, Score: %.1f" % (name, score)

# 传递字典映射(通过键名占位)
data = {"user": "Bob", "count": 3}
text_dict = "User %(user)s has %(count)d unread messages" % data
必须警惕的陷阱与局限:
- 单元素元组解包歧义: 当待格式化的变量本身恰好是一个元组时,
%会自动将其作为解包的参数列表对待。例如"%s" % (data,)如果漏写逗号写成"%s" % data,且data = (1, 2),解释器会报TypeError: not all arguments converted during string formatting。这种隐式解包行为极易在动态类型数据流中埋下难以排查的 Bug。 - 字典写法啰嗦且缺乏灵活校验: 采用
%(key)s语法时必须构造额外的字典对象,键名重复出现,可读性迅速劣变。
2. str.format() 方法
Python 2.6 和 3.0 正式引入了 str.format()(详见 PEP 3101)。它将格式化由底层的双目操作符改造为字符串实例的内建方法,引入了一套标准化且高度统一的微语言(Mini-Language)。
str.format() 支持位置索引、关键字参数、对象属性穿透以及字典/列表容器的键索引访问:
# 1. 自动位置匹配与指定索引
text_pos = "{} was born in {}".format("Guido", 1956)
text_idx = "{1} comes before {0}".format("Second", "First")

# 2. 命名参数与对象属性访问
class Server:
    def __init__(self, host, port):
        self.host = host
        self.port = port

srv = Server("127.0.0.1", 8080)
text_obj = "Connected to {server.host}:{server.port}".format(server=srv)

# 3. 字典与列表的直接索引穿透
config = {"timeout": 30, "retries": [3, 5]}
text_dict = "Timeout: {cfg[timeout]}s, Max retry: {cfg[retries][1]}".format(cfg=config)
核心架构优势: str.format() 最大的优势在于模板对象与数据注入的彻底解耦。模板可以在代码运行前存储在外部 YAML/JSON 配置文件、数据库或多语言 PO 文件中,在程序启动或收到用户请求后再行装配。
3. f-strings 格式化字符串字面值
Python 3.6 引入的 f-strings(PEP 498)彻底改变了日常字符串插值的面貌。只需在字符串前缀添加 f 或 F,大括号内即可编写任意合法的 Python 表达式,由解释器在当前局部/全局作用域内直接解析求值:
user = "carol"
items = ["apple", "banana"]

# 直接嵌入变量、函数与列表推导表达式
msg = f"User {user.upper()} holds {len(items)} items: {', '.join(items)}"

# Python 3.8+ 自调试语法(在表达式末尾添加 =)
width, height = 1920, 1080
debug_str = f"{width=}, {height=}, ratio={width/height:.2f}"
# 输出示例: width=1920, height=1080, ratio=1.78\。而在 Python 3.12 采用全功能 PEG 解析器后,所有的引号嵌套均被合法化(例如 f"{'\"'.join(['a', 'b'])}"),且反斜杠可在嵌套表达式内无限制使用。
二、底层机制与性能机理推导
很多开发者会好奇:为什么 f-strings 在各大性能基准测试中总能比 str.format() 和 % 快数倍?这并非简单的微优化,而是底层执行路径与编译时机的根本不同。
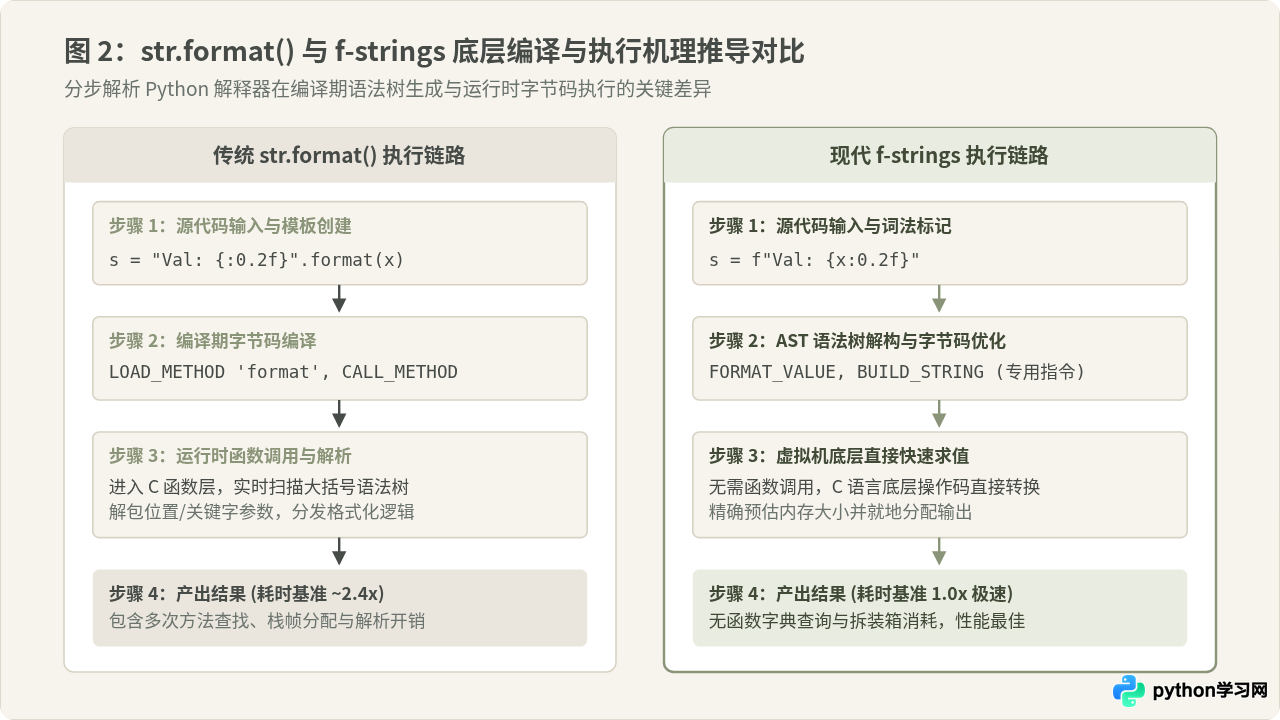
我们可以使用标准库的 dis 模块反编译字节码,直观验证这一推导:
import dis

def run_format(x):
    return "Value: {:0.2f}".format(x)

def run_fstring(x):
    return f"Value: {x:0.2f}"

# 查看 run_format 字节码:
# LOAD_CONST      'Value: {:0.2f}'
# LOAD_METHOD     'format'
# LOAD_FAST       x
# CALL_METHOD     1
# RETURN_VALUE

# 查看 run_fstring 字节码:
# LOAD_CONST      'Value: '
# LOAD_FAST       x
# FORMAT_VALUE    (2-arg format-spec)
# BUILD_STRING    2
# RETURN_VALUE
从字节码可以看出两者的本质分水岭:
str.format()是标准的用户态方法调用。在每次执行时,Python 虚拟机都必须查找字符串对象的format方法属性、建立调用栈帧、在 C 层动态遍历解析传入模板的大括号结构、处理参数打包,产生不可忽略的运行时开销。f-strings是编译期直接由语法解析器支持的原生字面值。在大括号内部出现的格式说明符直接在编译期被转换为专用的FORMAT_VALUE操作码,随后由BUILD_STRING指令进行底层的内存连续预分配与拼接。没有多余的方法字典查找,没有参数解包,速度达到原生 C 代码级别。
三、统一微语言(Mini-Language)格式规范拆解
无论是 str.format() 还是 f-strings,冒号 : 后面的格式控制符都完全遵守同一套标准 Mini-Language 规范。熟练掌握这一规范能够帮助我们写出高度工业化的数值格式化代码。
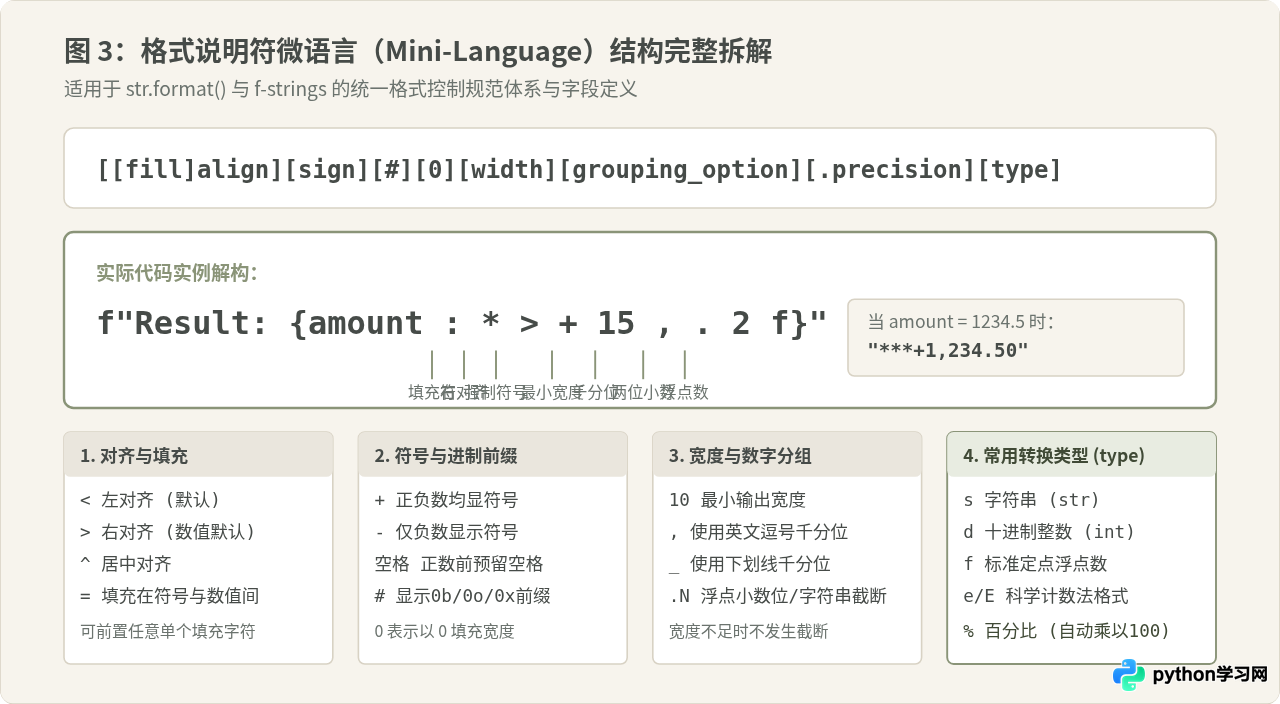
完整的微语言结构定义为:[[fill]align][sign][#][0][width][grouping_option][.precision][type]。以下是各要素的实际应用模式:
- 填充与对齐(
[fill]align): 对齐字符包括<(左对齐)、>(右对齐)、^(居中对齐)与=(符号居左,填充在符号与数字之间)。对齐符前方可附带单个任意填充字符,例如f"{val:*>10}"会在宽度不足 10 位时在左侧填充星号。 - 符号显示(
[sign]):+强制显示正负号;-仅负数显示符号(默认值);空格 则在正数前预留一个空格,使正负数在纵向排列时保持对齐。 - 千分位与分组(
[grouping_option]): 支持逗号,或下划线_作为千分位分隔符,例如f"{123456789:,}"输出123,456,789。 - 精度与截断(
[.precision]): 对于浮点数f,控制小数点后保留的位数;对于字符串s,控制最大保留字符数(多余部分直接截断)。 - 常用类型代码(
[type]):d(整数)、f(定点浮点数)、e/E(指数计数)、%(自动将数值乘以 100 并以百分号输出)、x/X(十六进制)、b(二进制)。
四、常见认知误区与关键边界辨析
关于这三种格式化方式,社区中长期存在若干“似是而非”的观点。我们通过具体场景与技术事实进行逐一辨析:
误区辨析 1:“% 操作符已被 Python 3 废弃,必须全量重构替换”
说法背景: 在 Python 3 早期制定的 PEP 3101 曾讨论过在未来移除 % 格式化操作符的可能性,许多教程据此声称该语法是“过时的遗留垃圾”。
事实与修正: CPython 核心团队从未正式开启废弃日程,而且在可预见的未来也不会移除 %。尤其在标准库 logging 模块中,官方文档明确推荐继续传递参数以使用 % 机制:
import logging
logger = logging.getLogger(__name__)

# 正确推荐写法:利用 logging 底层的延迟格式化机制
logger.debug("Processing request %s with payload %s", req_id, complex_calc())

# 错误做法:使用 f-string 会导致立即求值
# 即使当前日志级别是 INFO,complex_calc() 依然会被强制执行,带来无谓的性能损耗!
logger.debug(f"Processing request {req_id} with payload {complex_calc()}")
误区辨析 2:“f-strings 彻底淘汰了 str.format(),后者已无存在必要”
说法背景: f-strings 书写简短且性能更高,很多人认为新项目中不需要再写 str.format()。
事实与修正: 这种判断忽略了“模板定义”与“数据计算”在生命周期上的分离。f-strings 属于即时求值(Eager Evaluation),模板必须在代码编写期直接与上下文变量绑定。如果系统需要支持:
- 由前端管理员在配置页面配置邮件或短信提醒模板并保存在数据库中;
- 国际化多语言翻译(同一语义在英语和德语中词序不同,需要
"{0} {1}"与"{1} {0}"动态调整);
在这些情况下,f-strings 根本无法介入,必须使用 str.format() 或安全增强的 string.Template。
template.format(user=current_user)!因为攻击者可以通过 "{user.__class__.__init__.__globals__}" 访问全局命名空间,窃取环境密钥或执行任意代码。对于不可信外部模板,务必使用标准库的 string.Template,或使用严格的受限字典传参。
五、工程决策树与多维度对比总结
为了帮助团队在代码规范评审与工程落地中快速对齐,我们可以根据下方的决策树快速确定最佳选用方案。
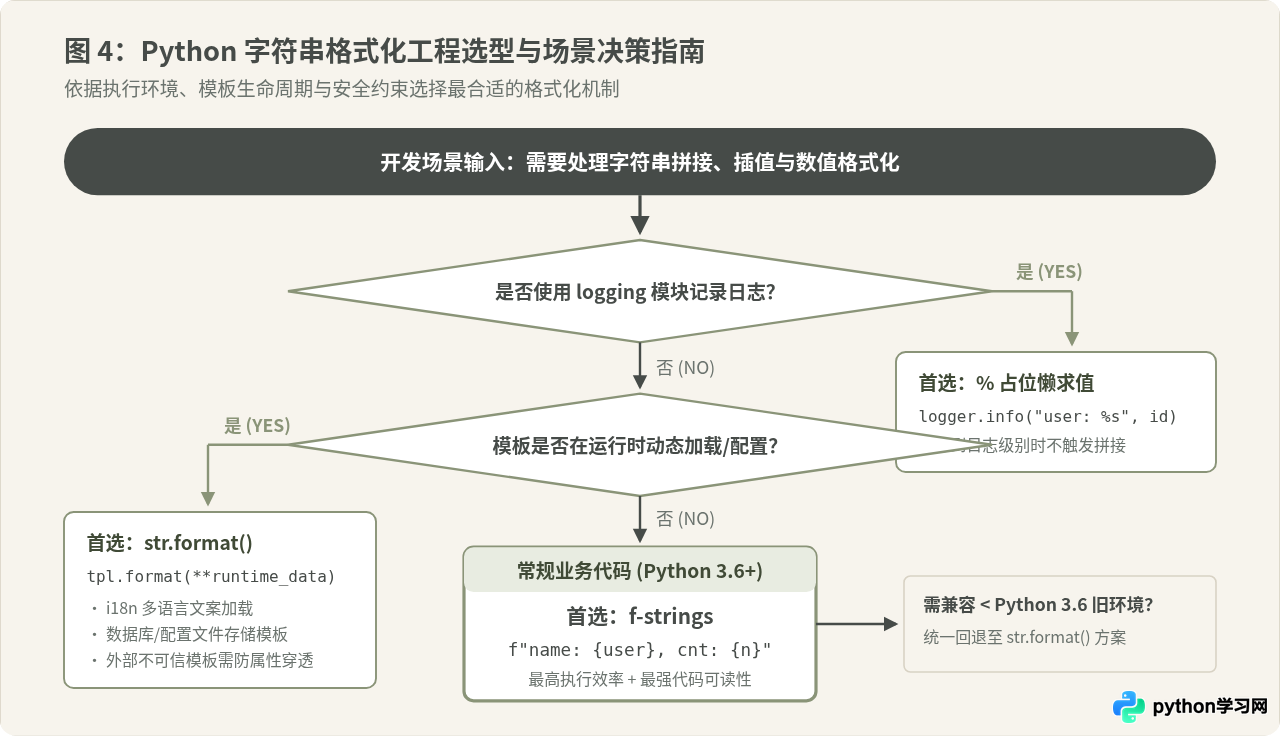
| 特性维度 | % 操作符 | str.format() | f-strings |
|---|---|---|---|
| 引入版本 | Python 2.0 之前 | Python 2.6 / 3.0 | Python 3.6+(3.12 增强) |
| 相对执行速度 | 中等(~1.5x 基准耗时) | 较慢(~2.4x 基准耗时) | 极快(1.0x 基准耗时) |
| 代码可读性 | 较差(长字符串变量与占位符割裂) | 中等(需匹配参数列表或 kwargs) | 极佳(变量与表达式就地直观内嵌) |
| 表达式支持 | 不支持(仅支持传入值) | 仅支持属性与索引访问 | 支持完整任意 Python 表达式与调用 |
| 动态外部模板 | 支持(字典传参) | 强力支持(解耦模板生命周期) | 不支持(语法限制必须就地即时求值) |
| 日志记录 (logging) | 天然集成且推荐(实现懒求值) | 需手动封装 | 需避免直接用于低于运行级别的 debug |
六、实践总结与选型口诀
掌握 Python 字符串格式化,关键在于理解求值时机(编译期 vs 运行时)与模板生命周期(静态内联 vs 动态加载)的权衡:
- 常规代码写 f-string: 只要字符串模板是你在代码中手写确定的,无论是否有复杂表达式或对齐需求,统一使用
f-strings。 - 动态模板用 format(): 如果模板需要跨网络传输、保存在配置文件或数据库中由用户配置,选择
str.format(),并注意防范不受信任字符串的属性注入风险。 - 系统日志留给 % 机制: 在使用
logging模块输出调试日志时,遵循官方惯例传递参数元组,利用内置机制避免不必要的性能开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









