

Python数据处理必备库函数:pandas与numpy核心接口解析
深入解析Python数据处理核心库pandas与numpy的高频接口与底层机制,涵盖内存布局、数据清洗、切片索引、广播计算与统计聚合的实际应用与选型指导。
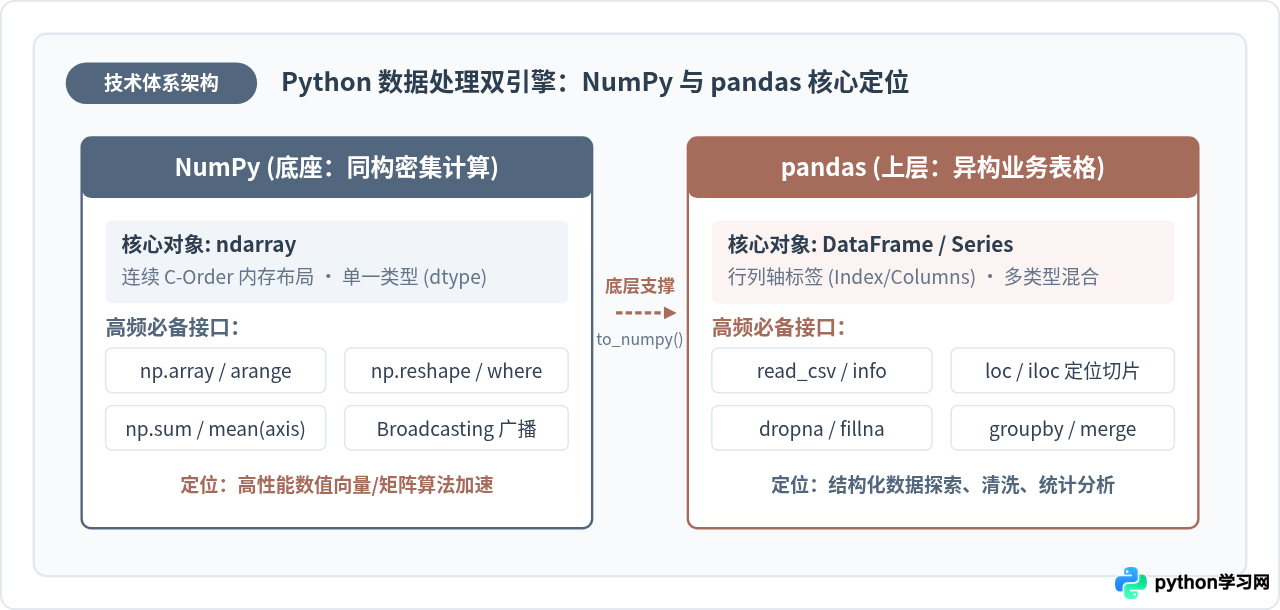
在 Python 数据科学与日常工程开发中,绝大多数结构化数据的清洗、筛选与数值计算,其底层均依赖 NumPy 与 pandas 两大核心库。NumPy 负责底层高性能同构多维数组(ndarray)及其向量化运算,而 pandas 则在此基础上封装了带有行列标签的高级异构表格结构(Series 与 DataFrame)。掌握两者的核心接口与调用逻辑,关键在于厘清数据在内存中的组织形式,并依据操作场景在“纯数值矩阵运算”与“带标签业务数据操作”之间做出精确选择。
一、基础底座:从内存结构看 ndarray 与 DataFrame 的分工
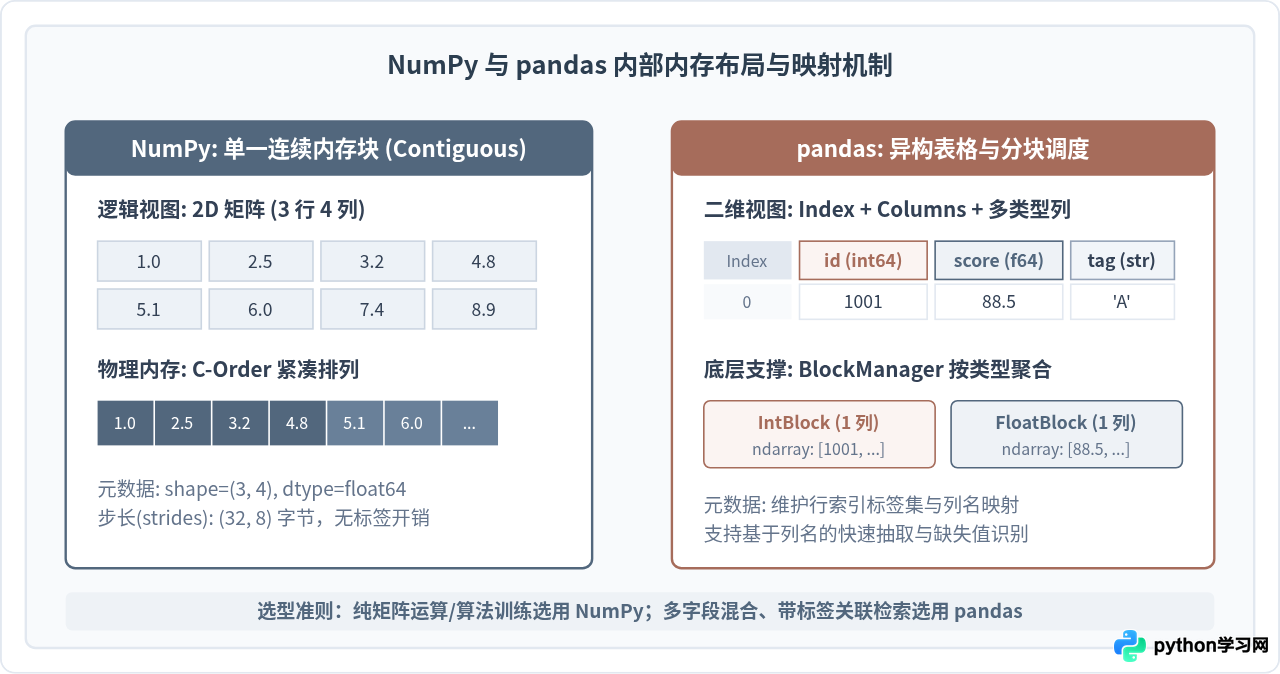
初学者在面对表格数据时,常常困惑于何时使用 NumPy,何时使用 pandas。产生这种困惑的根源在于忽视了两者的内存组织模式。NumPy 的基础是 ndarray(N-dimensional Array),它在物理内存中开辟一段连续的地址空间,要求容器内的所有元素必须具有相同的类型(如统一为 float64 或 int32)。这种同质性使得 CPU 能够利用现代 SIMD 指令集进行并行计算,大幅降低循环开销。
与此相对,pandas 的核心数据结构 DataFrame 模拟的是现实业务中的二维数据表。现实数据往往混合了整型、浮点型、字符串及时间戳。因此,pandas 在底层采用了 BlockManager(在较新版本中逐步演进为 ArrayManager)架构,将相同类型的列捆绑为一个个内部的 NumPy 数组或扩展数组,并在此之上封装了行索引(Index)和列标签(columns)。
数组与数据框的创建接口
构建数组时,NumPy 提供了基于规则和边界的生成函数。最常见的是 np.array()、np.arange() 和 np.linspace():
# 环境准备:Python 3.8+,需安装 numpy 与 pandas
import numpy as np
import pandas as pd

# 1. 使用 numpy 构建规则数值向量与固定步长数组
arr_step = np.arange(start=0, stop=10, step=2)     # 左闭右开区间
arr_lin = np.linspace(start=0, stop=1, num=5)      # 指定样本数,闭区间

# 2. 从 numpy 数组无缝构筑 pandas DataFrame
mat = np.array([[10, 20.5], [30, 40.8], [50, 60.2]])
df = pd.DataFrame(data=mat, columns=['feature_a', 'feature_b'])
当需要将清洗完成的表格输入到 scikit-learn 或 PyTorch 等机器学习库时,调用 df.to_numpy()(早先版本为 df.values)即可将带有业务标签的 DataFrame 重新“剥离”为底层的 NumPy 二维数组。
二、数据准备与质量探查:核心工作流与高频接口
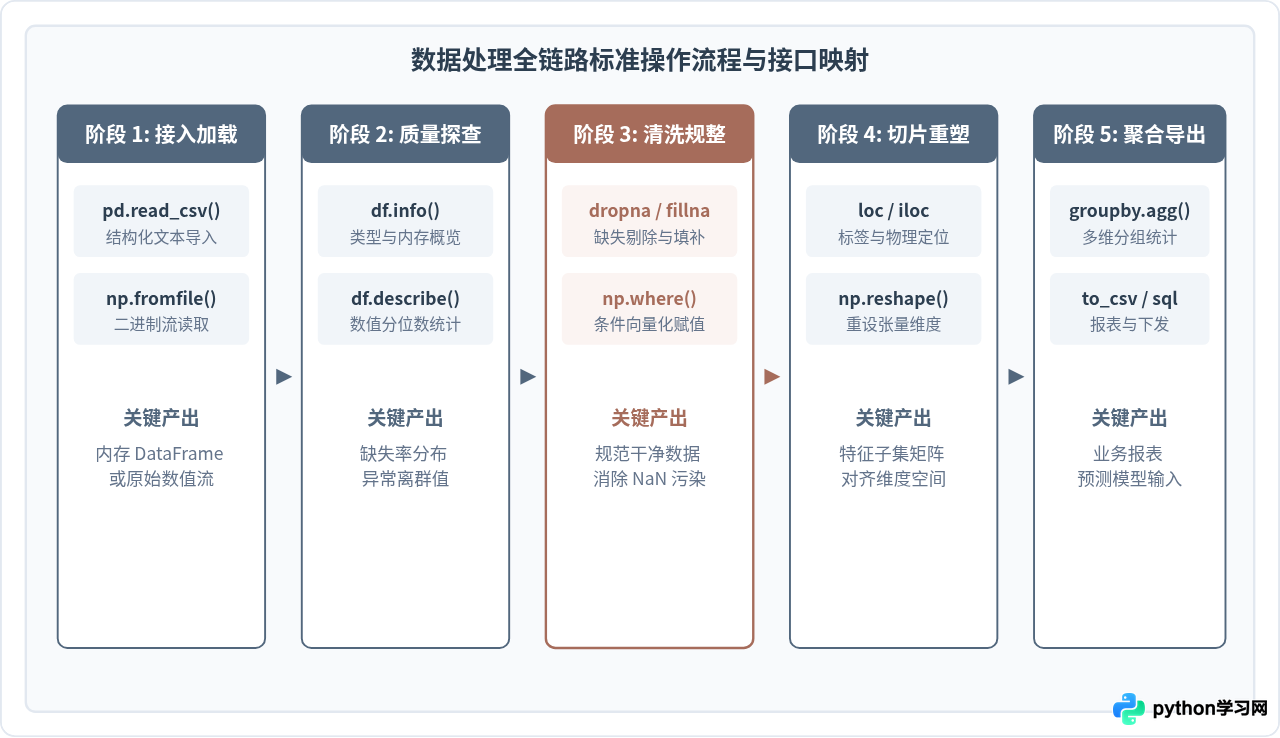
在实际项目落地中,绝大部分数据处理任务遵循固定的阶段演进:从源端数据读取、字段属性探查,到缺失值清理与维度对齐。熟练掌握每个阶段的接口搭配,能大幅减少低效的试错循环。
1. 质量探查:info() 与 describe()
加载数据后,首要任务是掌握非空值计数与各列内存占用。调用 df.info() 能在终端输出完整的列名、非空计数(Non-Null Count)以及每列的实际存储类型(Dtype);而 df.describe() 则针对数值型列自动计算均值、标准差、四分位数(25%, 50%, 75%)及极值。
2. 缺失值诊断与条件替换:isna、dropna 与 np.where
真实数据不可避免存在空缺。对于少量缺失行,可调用 dropna() 剔除;对于数值型特征,常调用 fillna() 填充固定值或中位数。而在根据条件给新字段赋值时,NumPy 的 np.where(condition, x, y) 具有极高的执行效率。
# 模拟包含缺失与异常的业务数据集
raw_data = {
    'user_id': [101, 102, 103, 104, 105],
    'amount': [120.0, np.nan, 340.5, 0.0, -15.0],
    'city': ['Beijing', 'Shanghai', None, 'Shenzhen', 'Beijing']
}
df_order = pd.DataFrame(raw_data)

# 查看缺失情况统计
missing_summary = df_order.isna().sum()

# 填充金额缺失为均值,城市缺失为 'Unknown'
mean_val = df_order['amount'].dropna().mean()
df_order['amount'] = df_order['amount'].fillna(mean_val)
df_order['city'] = df_order['city'].fillna('Unknown')

# 结合 np.where 进行高效向量化分类判定(避免使用 slow iterrows)
df_order['status'] = np.where(df_order['amount'] > 100, 'High', 'Standard')df.dropna(inplace=True) 这种就地修改写法。然而在最新的 pandas 2.0+ 最佳实践中,官方已明确不推荐频繁使用 inplace=True,因为其往往并不真正节省内存,还会破坏链式调用的可读性,甚至引发隐蔽的 SettingWithCopyWarning 报警。显式重新赋值(df = df.dropna())是更加稳妥的现代习惯。
三、索引切片与重塑机制:loc/iloc 与广播规则
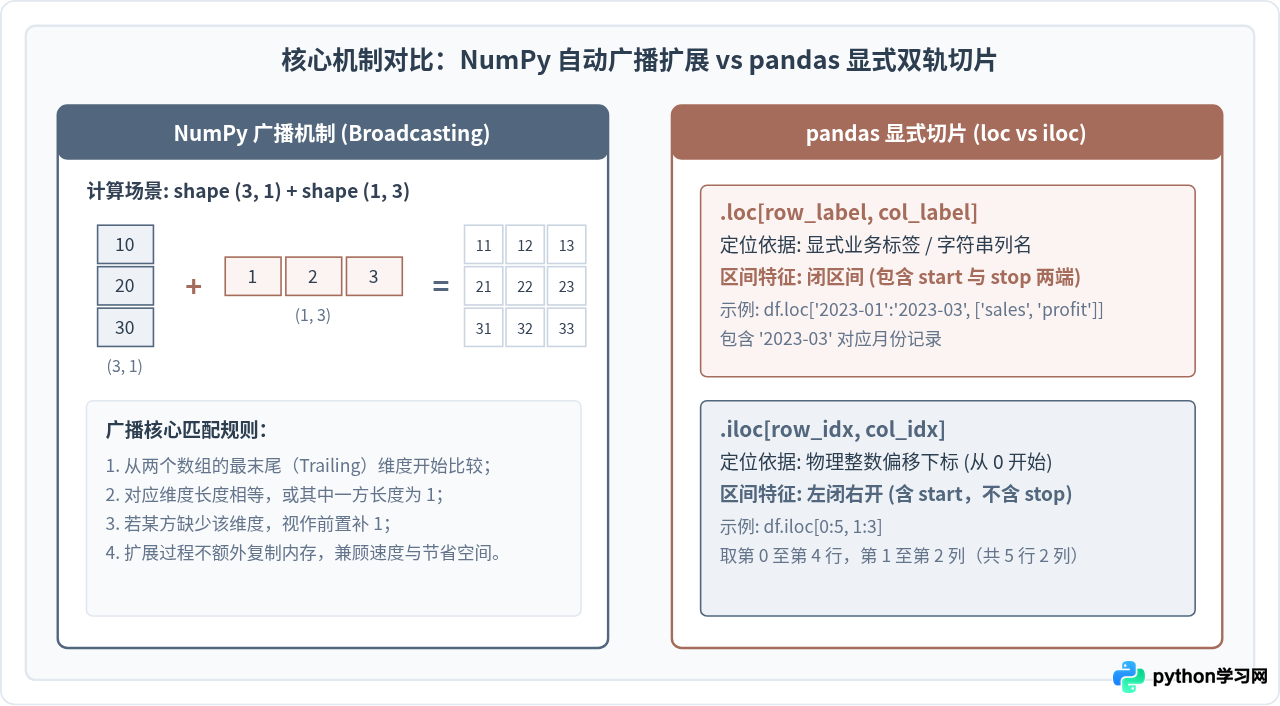
在多维数据提取中,pandas 的切片体系与 NumPy 的维度重组是核心操作。很多开发者容易在 loc 和 iloc 的区间闭合规则上犯错,而在进行跨维度矩阵加减时,也容易因不理解广播规则(Broadcasting)而导致维度报错。
1. loc 与 iloc 的精细区分
在处理时间序列或重置了索引的 DataFrame 时,必须清楚定位机制:
loc严格按标签寻址。如果行索引为整数[10, 20, 30],df.loc[10:20]匹配的是名字叫 10 和 20 的索引行,且闭区间包含末尾的 20。iloc严格按从 0 开始的物理序号寻址。无论行索引的名称为何,df.iloc[0:2]永远抽取前两行(下标为 0 和 1),遵循 Python 标准的左闭右开原则。
df_demo = pd.DataFrame(
    data={'score': [95, 88, 72, 60]},
    index=['alice', 'bob', 'charlie', 'david']
)

# 基于标签定位:包含 'charlie'
subset_loc = df_demo.loc['alice':'charlie', ['score']]

# 基于位置定位:前 2 行(索引 0 和 1),不包含索引 2
subset_iloc = df_demo.iloc[0:2, 0:1]2. NumPy 维度变换:reshape 与广播计算
np.reshape(a, newshape) 能够在保持数据总量不变的前提下重塑数组维度。传入 -1 可使 NumPy 根据其他维度自动推导尺寸。
base_vec = np.arange(12)
matrix_3x4 = base_vec.reshape(3, 4)     # 变形为 3 行 4 列
matrix_auto = base_vec.reshape(2, -1)   # 自动推导为 2 行 6 列

# 广播计算实例:标准化处理(每列减去均值,除以标准差)
col_mean = matrix_3x4.mean(axis=0)       # shape 为 (4,)
normalized = matrix_3x4 - col_mean      # (3, 4) 与 (4,) 触发广播自动沿行扩展
四、统计聚合与多表关联:groupby 与 ufunc 运算
数据分析的最终目标往往是汇总统计指标或将多方业务数据关联。NumPy 负责单列或纯数值矩阵的高速指标收敛,而 pandas 负责处理分组聚合(Split-Apply-Combine)与关系型连接(Merge)。
1. NumPy 通用函数(ufunc)与坐标轴选择
NumPy 的 np.sum、np.mean、np.std 均接收 axis 参数。对于二维数组,理解 axis 的最简单口诀是:指定哪个 axis,就沿着哪个轴压缩坍塌。
axis=0:跨行压缩,垂直向下坍塌,最终保留列统计量。axis=1:跨列压缩,水平向右坍塌,最终保留行统计量。
2. pandas 分组聚合:groupby 与 agg()
在 pandas 中,groupby() 负责拆分数据。结合 agg() 能够对不同的列实施差异化的聚合计算:
sales_df = pd.DataFrame({
    'category': ['Electronics', 'Electronics', 'Clothing', 'Clothing', 'Home'],
    'item_sales': [3500.0, 1200.0, 450.0, 300.0, 890.0],
    'quantity': [2, 1, 3, 2, 4]
})

# 结合 agg() 传递字典实现多指标定制统计
category_summary = sales_df.groupby('category').agg({
    'item_sales': ['sum', 'mean'],
    'quantity': 'max'
})3. 多表关联:pd.merge 关系运算
当需要合并两个数据源时,pd.merge(left, right, on='key', how='inner|left|right|outer') 提供了类似 SQL 的 Join 功能。建议在合并大型表前,先校验连接键的唯一性或在 merge 时设置 validate='many_to_one' 等约束,以防止由于重复键产生意外的数据膨胀笛卡尔积。
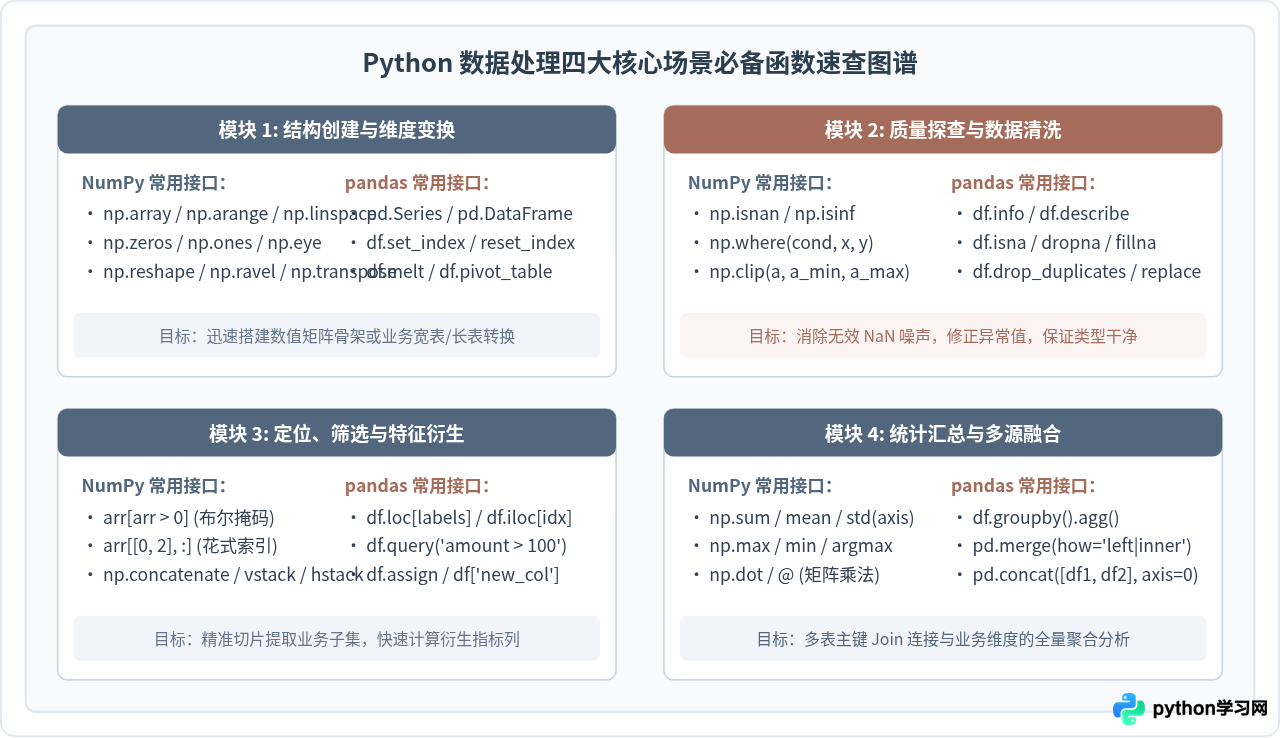
五、常用核心函数决策与速查图谱
为了便于在日常编写代码时迅速定夺应当调用的接口,下图归纳了数据处理四大高频任务场景下,NumPy 与 pandas 的精选核心函数库。
工程实践建议
- 避免在 DataFrame 上使用 Python 原生
for循环:类似for idx, row in df.iterrows()的逐行遍历操作开销巨大。应优先考虑向量化表达式(如df['c'] = df['a'] + df['b'])或结合np.where,其执行速度通常比原生迭代快数十到上百倍。 - 留意下推数值精度降低内存:对于不需要高精度的字段,使用
df['col'].astype(np.float32)或整型压缩(如np.int16),能将海量数据的内存驻留减半,有效避免大型任务遭遇 OOM(内存溢出)。 - 合理界定职责边界:数据清洗、字段重命名、缺失填补、异构表关联交由 pandas 处理;当进入密集数学计算、相似度矩阵求解或特征张量输入阶段时,及时调用
to_numpy()将数据移交至 NumPy 处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









