

Python for循环遍历字典键、值及键值对的三种方式
系统解析Python中使用for循环遍历字典的三种核心方式:遍历键、遍历值以及同时遍历键值对,包含底层机制解析、代码示例、元组解包及遍历中修改字典的避坑指南。
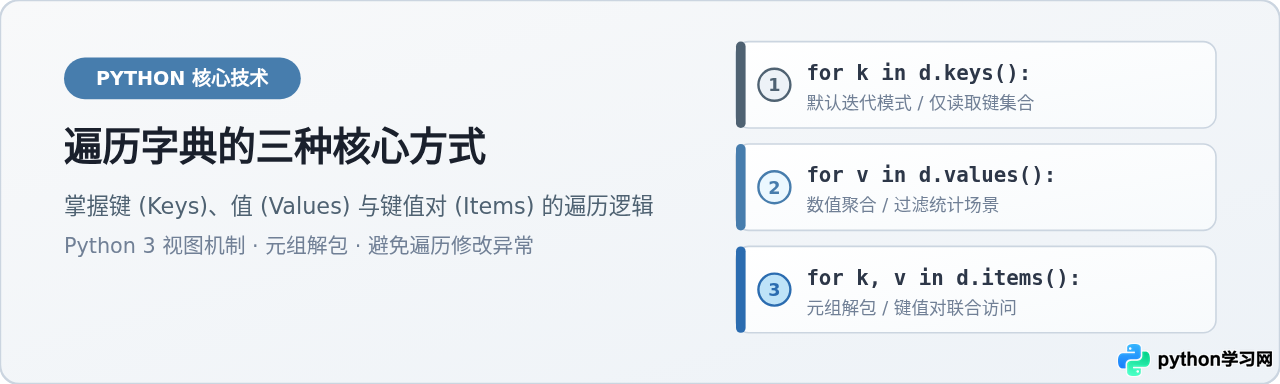
for 循环操作字典时,实际需求通常划分为三类:只需处理键、只需处理值,或需要键与值同步参与逻辑。针对这三类场景,Python 提供了三种直接的迭代方式:默认或显式遍历键(.keys())、遍历值集合(.values()),以及借助元组解包同时遍历键与值(.items())。
一、字典在 Python 中的迭代特性
Python 字典是基于哈希表实现的键值映射容器。在 Python 3.7 及更高版本中,字典不仅具备常数级时间复杂度的查找性能,还保证了元素插入顺序的确定性。
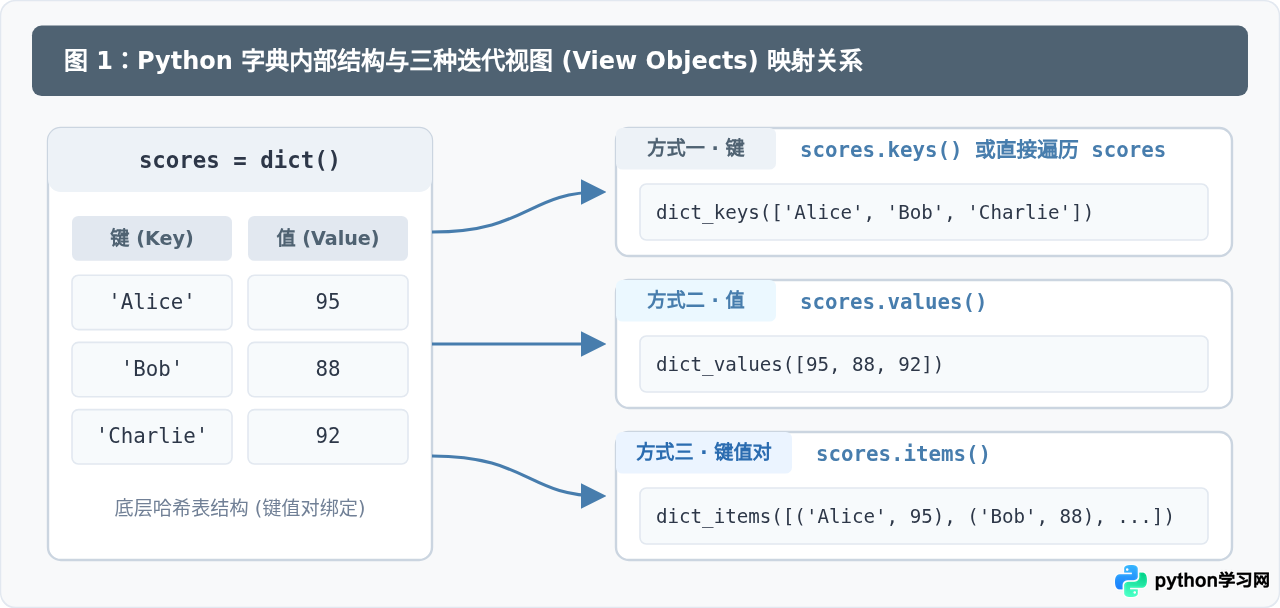
对字典调用迭代方法时,返回的并非静态列表副本,而是动态的字典视图对象(Dictionary View Objects),包括 dict_keys、dict_values 和 dict_items。这些视图对象提供了对底层字典数据的只读迭代接口,当底层字典内容变更时,视图所反映的数据会动态更新。
二、方式一:遍历字典的键(Keys)
当业务逻辑仅需要检查键的存在性、统计键集合,或者需要按照键名依次检索时,应当遍历字典的键。获取键有两种常见书写方式。
1. 直接遍历字典对象(推荐写法)
在 Python 语法中,字典本身就是一个可迭代对象,其默认的迭代器行为就是产生键名。这是最符合 Python 习惯(Pythonic)的紧凑写法:
# 示例字典:各学科的考评学分
course_credits = {
    "Calculus": 4,
    "Linear Algebra": 3,
    "Data Structure": 4,
    "Computer Network": 3
}

# 直接遍历字典,循环变量每次获取一个键
for course in course_credits:
    print(f"课程名称: {course}")
课程名称: Linear Algebra
课程名称: Data Structure
课程名称: Computer Network
2. 显式调用 dict.keys() 方法
也可以通过显式调用 course_credits.keys() 达到相同的遍历效果:
for course in course_credits.keys():
    print(f"课程名称: {course}")
何时显式使用 .keys()? 从循环迭代效率来看,两种写法完全相同。显式调用 .keys() 的主要价值在于表达明确的编码意图,或者需要对键视图执行集合操作(如交集 keys() & other_dict.keys()、差集等运算)时。在普通的 for 循环中,直接写 for key in d: 更加简洁明了。
三、方式二:遍历字典的值(Values)
当业务处理完全围绕数值指标展开,无需反查是哪一个键拥有该数值时(例如数值求和、计算平均值、寻找最值或状态判定),应当使用 dict.values() 方法。
# 示例字典:某服务器连续五分钟的内存使用率 (百分比)
mem_usage_samples = {
    "10:01": 68.5,
    "10:02": 72.1,
    "10:03": 75.4,
    "10:04": 81.0,
    "10:05": 78.2
}

total_usage = 0.0
sample_count = 0

# 仅遍历内存数值,忽略时间戳键
for usage in mem_usage_samples.values():
    total_usage += usage
    sample_count += 1

average_usage = total_usage / sample_count
print(f"采样点总数: {sample_count}")
print(f"平均内存使用率: {average_usage:.2f}%")
平均内存使用率: 75.04%
性能注意点: 如果此时采用 for k in d: total += d[k],每一次循环都需要对 k 进行一次哈希运算与桶查找;而 d.values() 直接从哈希表中提取值指针,避免了二次索引寻址,执行更加高效。
四、方式三:同时遍历键与值(Key-Value 对)
在需要将属性名与具体数值关联输出、格式化报表,或根据数值条件筛选特定键时,同时获取键与值是最高频的操作模式。Python 提供了 dict.items() 方法。
1. 元组解包语法与机制
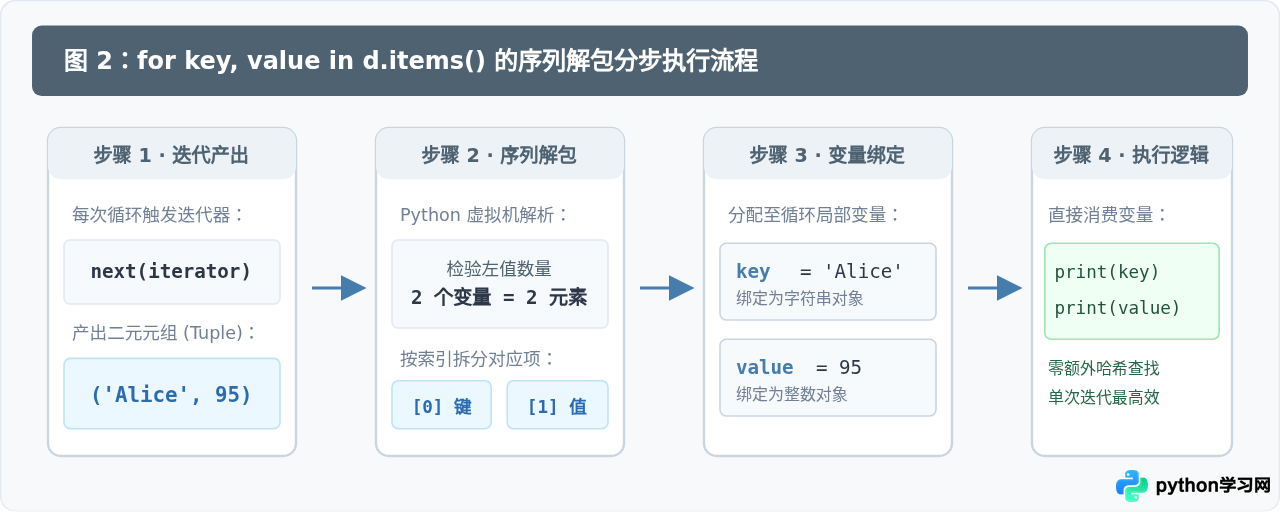
dict.items() 在每次迭代时产出一个形如 (key, value) 的二元元组。利用 Python 内建的序列解包特性,可以在 for 语句头部直接定义两个变量分别接收键和值:
# 示例字典:微服务健康状态检查
service_status = {
    "auth-api": "UP",
    "payment-gateway": "UP",
    "order-service": "DOWN",
    "notification-worker": "UP"
}

# 使用 key, value 接收解包结果
for service_name, status in service_status.items():
    indicator = "正常" if status == "UP" else "异常"
    print(f"服务 [{service_name}] 运行状态: {indicator}")
服务 [payment-gateway] 运行状态: 正常
服务 [order-service] 运行状态: 异常
服务 [notification-worker] 运行状态: 正常
2. 对比反模式:为什么不要用 d[key] 二次查找
初学者容易写出如下形式的代码:
# 不推荐的反模式代码
for key in service_status:
    value = service_status[key]  # 冗余的二次哈希查找
    print(key, value)
这种写法存在两个明显缺陷:其一,代码可读性较差,每次都需要手动索引;其二,service_status[key] 会强制 Python 重新在字典哈希表中进行键哈希计算与冲突比对。而 service_status.items() 直接在单次遍历中一并提供键与值,无论在代码优雅度还是在执行效率上都明显更优。
五、避坑指南:遍历中修改字典引发的异常与安全方案
在遍历字典时,一个极为普遍的错误是在循环体内部增加或删除字典项。
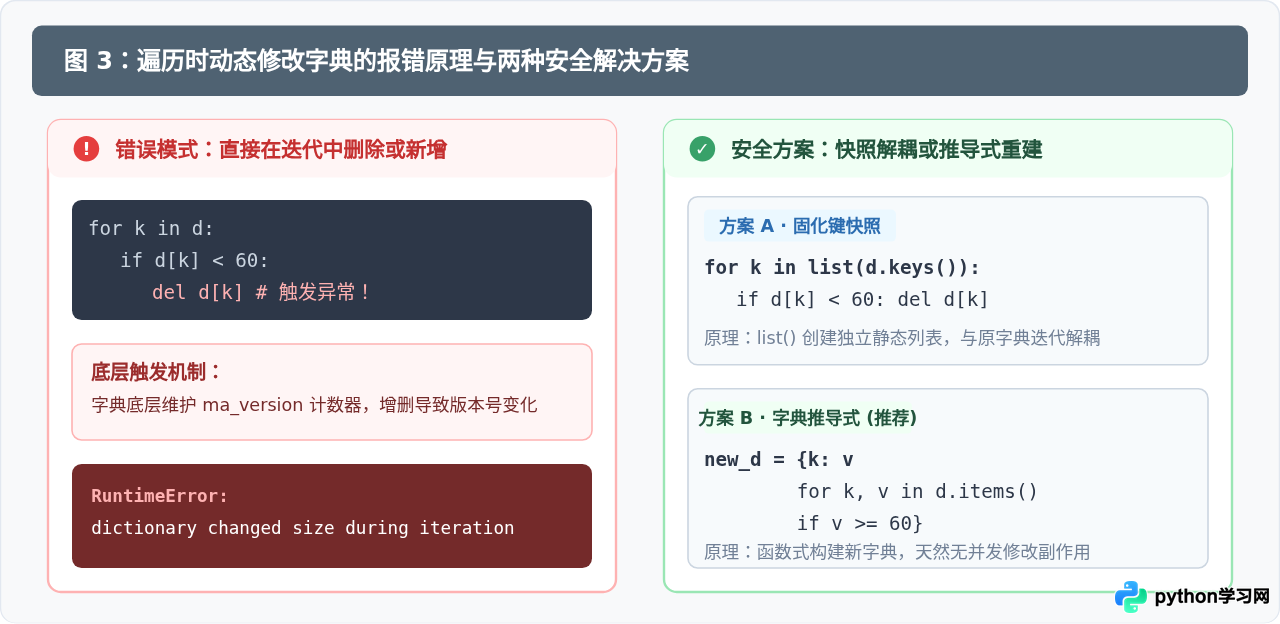
1. 故障表现与触发根因
尝试在遍历过程中删除不合格项:
# 错误示例代码:在迭代中删除元素
stock_levels = {"apple": 15, "banana": 0, "orange": 8, "pear": 0}

for fruit in stock_levels:
    if stock_levels[fruit] == 0:
        del stock_levels[fruit]  # 触发 RuntimeError
原因分析: Python 字典底层维护了一个内部版本计数器(ma_version_tag)。当迭代器创建时,它会记录当下的版本号。在单次迭代步进时,如果检测到底层字典的长度发生改变(无论是 del、pop() 还是新增键值),迭代器为了避免因哈希表重排导致漏读或死循环,会主动抛出 RuntimeError 中断执行。
2. 安全修复方案 A:通过 list() 制造静态键快照
如果确实需要在原字典上就地执行删除,可以使用 list() 函数先将键转换为一个独立的列表快照,遍历该快照列表:
stock_levels = {"apple": 15, "banana": 0, "orange": 8, "pear": 0}

# 通过 list() 固化键的副本,循环迭代的是独立的列表,原字典的修改不会影响该列表
for fruit in list(stock_levels.keys()):
    if stock_levels[fruit] == 0:
        del stock_levels[fruit]

print("清理后的库存:", stock_levels)
3. 安全修复方案 B:使用字典推导式重构(推荐)
在函数式编程或现代 Python 实践中,更倡导生成新数据对象而非就地改变原状态。字典推导式能够用一行代码完成过滤:
stock_levels = {"apple": 15, "banana": 0, "orange": 8, "pear": 0}

# 纯函数式生成新字典,逻辑清晰且无副作用
valid_stocks = {fruit: qty for fruit, qty in stock_levels.items() if qty > 0}

print("过滤后的有效库存:", valid_stocks)
六、三种遍历方式的对比与选型决策
下表汇总了三种遍历方式的语法、返回值类型、变量绑定形式与适用场景:
| 遍历目标 | 标准语法 | 底层视图类型 | 每次循环产物 | 典型适用场景 |
|---|---|---|---|---|
| 仅遍历键 | for k in d: |
dict_keys |
单个键对象 (Key) | 仅检查属性名、提取键列表、校验存在性 |
| 仅遍历值 | for v in d.values(): |
dict_values |
单个值对象 (Value) | 数值求和、平均值统计、找最值,无需反查键名 |
| 同时遍历键与值 | for k, v in d.items(): |
dict_items |
二元元组解包 (k, v) |
格式化打印输出、按值筛选键、字典重构与序列化 |
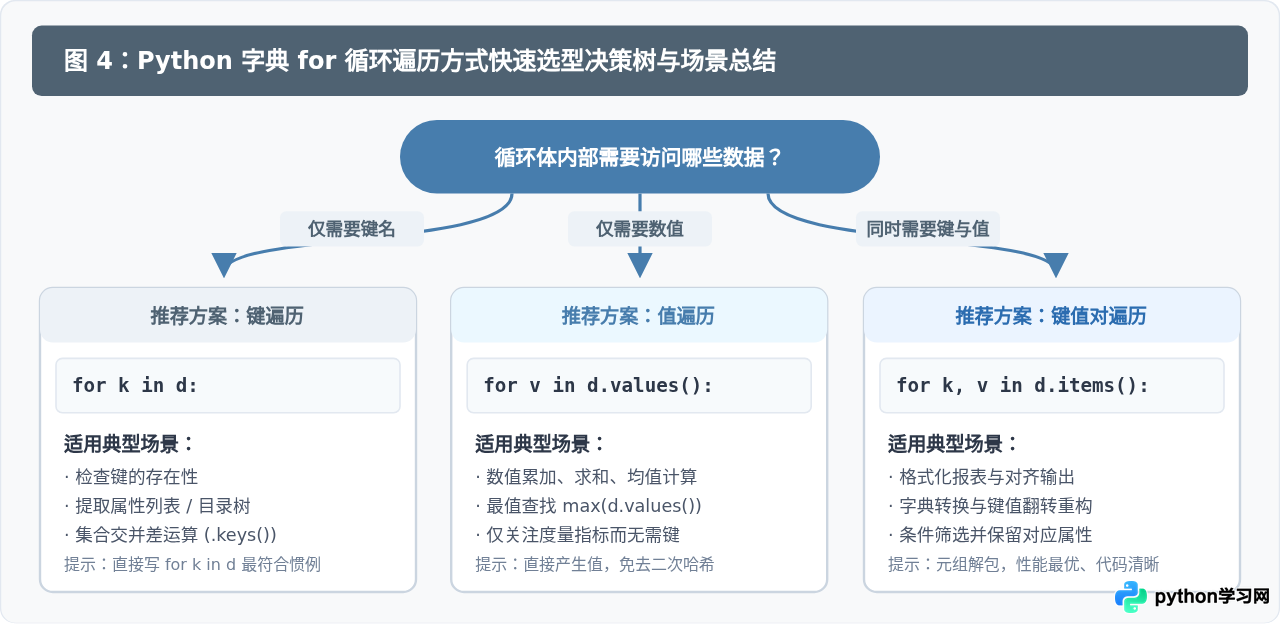
在编写字典遍历逻辑时,遵循“按需索取”原则:只用键就写 for k in d:;只用值就写 for v in d.values():;两者都用务必使用 for k, v in d.items():,坚决避免在仅获取键的循环中反复使用 d[k] 索引访问。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









