

Python爬虫入门:用requests和BeautifulSoup抓取静态网页数据
本教程针对初学者,深入浅出地讲解如何使用Python的requests库与BeautifulSoup4库抓取并解析静态网页数据。内容涵盖HTTP通信原理、User-Agent伪装、DOM节点定位、异常防御及完整实战代码示例。
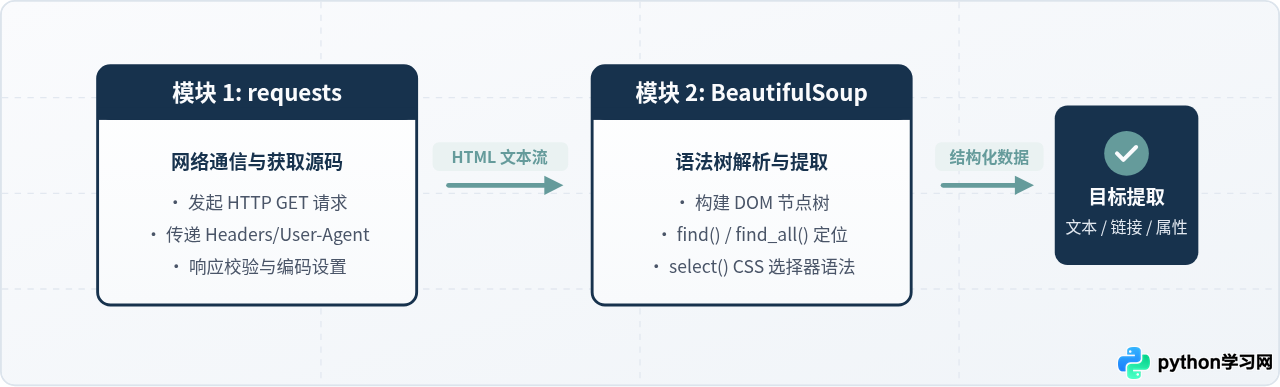
一、静态网页抓取的核心运作原理
在开始写代码前,需要明确什么是“静态网页”。所谓静态网页,是指当客户端向服务器发出 URL 请求后,服务器直接返回已经渲染完整的 HTML 文档。用户在网页上看到的所有文字、列表和链接,已经全部以纯文本形式存在于这段 HTML 源码中。这与依靠前端 JavaScript 脚本异步拉取 JSON 数据再在浏览器本地渲染的“动态网页”有着本质区别。
正因为数据已经就绪,我们不需要在本地启动庞大沉重的完整浏览器内核(如 Selenium 或 Playwright),只需要通过网络通信库拿到 HTML 字符串,再交给解析库进行标签筛选即可。
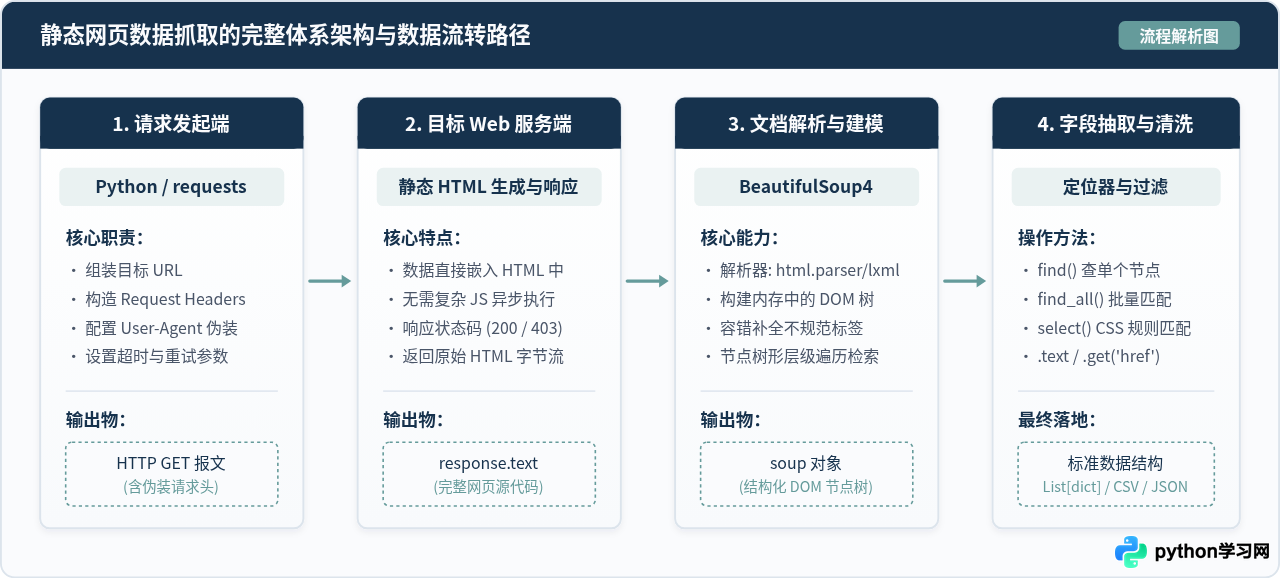
整个处理过程分为四个紧密衔接的环节:
- 请求发起(requests):组装目标网址与必要的 HTTP 请求头(重点是
User-Agent标识),向服务端发起标准的 HTTP GET 请求。 - 网络传输与响应:目标服务器接收请求并返回状态码(如 200 表示成功),同时回传 HTML 字节流。
- 语法建模(BeautifulSoup4):解析器(内置的
html.parser或第三方lxml)读取 HTML 字符串,自动修补缺失的闭合标签,在内存中构建起树状的 DOM(文档对象模型)节点结构。 - 节点定位与提取:通过标签名、CSS 类名、ID 或层级选择器,遍历定位到目标节点,读取其中的文本或属性值,最终存入列表或保存为文件。
二、环境准备与依赖安装
完成本项目需要 Python 3.6 及以上环境。核心依赖为两个第三方库:用于网络请求的 requests 和用于解析 HTML 的 beautifulsoup4。同时,推荐安装高性能解析器 lxml 作为底层支持(如果不安装,也可以使用 Python 自带的 html.parser)。
打开终端或命令行工具,执行以下安装命令:
# 建议使用 pip 安装核心依赖
pip install requests beautifulsoup4 lxml
安装完成后,可以在 Python 交互环境中导入模块以验证是否就绪:
import requests
from bs4 import BeautifulSoup

print(requests.__version__)
print(BeautifulSoup)
如果没有抛出 ModuleNotFoundError 错误,说明运行环境已经准备完毕。
三、分步实战:从发送请求到定位解析
为了让抓取过程条理清晰,我们按照标准的开发顺序拆解为五个关键步骤,并逐一分析其中的代码写法与注意事项。
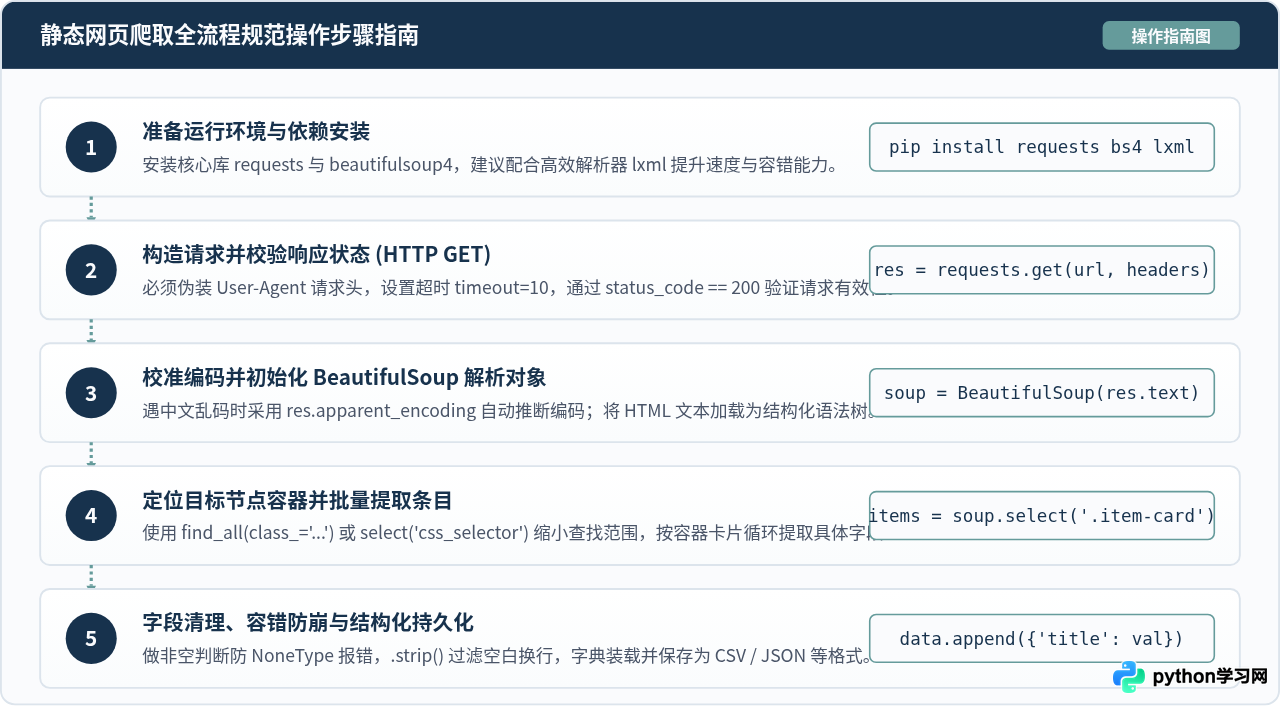
第 1 步:用 requests 发起 HTTP GET 请求
发起请求时,最容易被初学者忽视的是 User-Agent(用户代理)。很多网站的服务器如果检测到请求头中包含 Python 默认的 python-requests/x.x.x 标识,会直接返回 403 Forbidden 拦截访问。因此,必须在请求头中附带常规浏览器的标识信息。
import requests

url = "https://quotes.toscrape.com/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

# 设置 10 秒超时,防止网络卡顿造成程序永久挂起
response = requests.get(url, headers=headers, timeout=10)

# 检查 HTTP 状态码
if response.status_code == 200:
    print("请求成功,网页字节长度:", len(response.text))
else:
print(f"请求失败,状态码:{response.status_code}")如果抓取中文网站时发现控制台输出乱码,通常是因为 requests 根据 HTTP 头猜错了编码(例如误判为 ISO-8859-1)。此时只需在读取 response.text 前加入一行代码:response.encoding = response.apparent_encoding,即可自动根据网页实际字节内容矫正编码。
第 2 步:构建 BeautifulSoup 解析对象
拿到 HTML 字符串后,需要将其交给 BeautifulSoup 实例化为 DOM 对象。构造函数接收两个参数:HTML 文本内容,以及所选用的解析引擎。
from bs4 import BeautifulSoup

# 优先使用速度更快的 lxml;若未安装可换用 "html.parser"
soup = BeautifulSoup(response.text, "html.parser")

# 测试读取页面标题标签
print("页面标题:", soup.title.string)
第 3 步:熟练运用核心定位器定位元素
BeautifulSoup 提供了两套非常便捷的定位风格:基于方法签名的 find() / find_all(),以及基于前端样式的 select() / select_one() CSS 选择器。下表对比了两者的差异与使用习惯:
| 操作目标 | find / find_all 风格 | select (CSS 选择器) 风格 | 返回值类型 |
|---|---|---|---|
| 查找符合条件的第一个节点 | soup.find('div', class_='item') |
soup.select_one('div.item') |
Tag 对象(未找到返回 None) |
| 查找所有符合条件的节点 | soup.find_all('div', class_='item') |
soup.select('div.item') |
Tag 对象构成的列表(未找到返回空列表) |
| 提取标签内部文字 | tag.get_text(strip=True) |
tag.get_text(strip=True) |
字符串(去除首尾空白) |
| 提取标签属性(如 href、src) | tag.get('href') 或 tag['href'] |
tag.get('href') |
字符串属性值 |
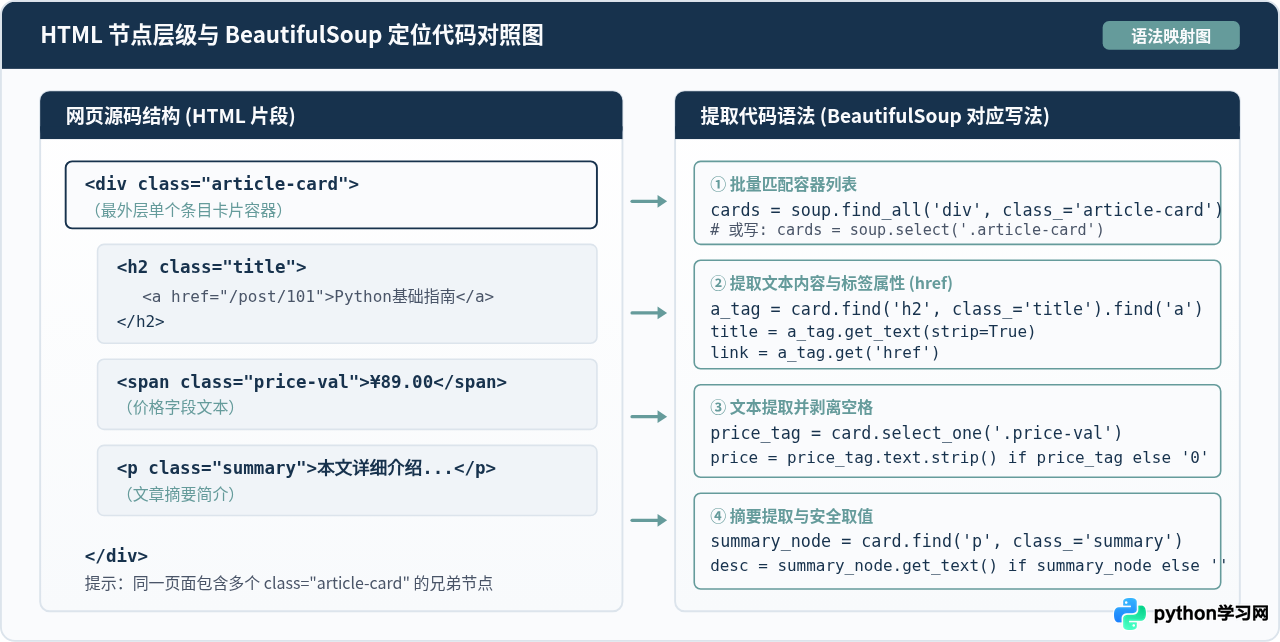
在实际抓取列表中,通常采用“两级查找法”:先定位到包裹每一条数据的最外层容器节点(例如循环 soup.find_all('div', class_='quote')),再在每个子节点内部查找该条目专属的标题、作者和标签。这样做能确保每个字段严格对应所属条目,绝不会发生错位。
四、完整可运行的实战案例
下面是一个完整的可执行 Python 脚本,以公开的名言练习网站(quotes.toscrape.com)为例,演示从网络请求、DOM 树提取、异常捕获到清洗输出的完整流程:
import requests
from bs4 import BeautifulSoup

def scrape_quotes(page_url):
    # 1. 配置请求头
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    try:
        # 2. 发起网络请求
        response = requests.get(page_url, headers=headers, timeout=10)
        response.raise_for_status()  # 若响应状态码不是 200 则主动触发 HTTPError

        # 自动纠正网页编码
        response.encoding = response.apparent_encoding
    except requests.exceptions.RequestException as err:
        print(f"网络请求出现异常: {err}")
        return []

    # 3. 构造解析对象
    soup = BeautifulSoup(response.text, "html.parser")

    # 4. 寻找所有名言卡片节点
    quote_elements = soup.find_all("div", class_="quote")
    results = []

    # 5. 遍历每个卡片并防御性提取字段
    for item in quote_elements:
        # 提取名言正文
        text_node = item.find("span", class_="text")
        text = text_node.get_text(strip=True) if text_node else ""

        # 提取作者
        author_node = item.find("small", class_="author")
        author = author_node.get_text(strip=True) if author_node else "未知"

        # 提取标签列表 (同一个卡片下有多个 a.tag)
        tag_nodes = item.find_all("a", class_="tag")
        tags = [t.get_text(strip=True) for t in tag_nodes]

        results.append({
            "quote": text,
            "author": author,
            "tags": tags
        })

    return results


if __name__ == "__main__":
    target_url = "https://quotes.toscrape.com/"
    data = scrape_quotes(target_url)

    print(f"成功抓取到 {len(data)} 条名言数据:
")
    for idx, entry in enumerate(data[:3], start=1):
        print(f"[条目 {idx}]")
        print(f"  内容: {entry['quote']}")
        print(f"  作者: {entry['author']}")
        print(f"  标签: {', '.join(entry['tags'])}")
        print("-" * 50)
运行结果示例(非实际网络输出,仅展示数据格式):
成功抓取到 10 条名言数据:

[条目 1]
  内容: “The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”
  作者: Albert Einstein
  标签: change, deep-thoughts, thinking, world
--------------------------------------------------
[条目 2]
  内容: “It is our choices, Harry, that show what we truly are, far more than our abilities.”
  作者: J.K. Rowling
  标签: abilities, choices
--------------------------------------------------
五、开发中的常见问题排查与避坑准则
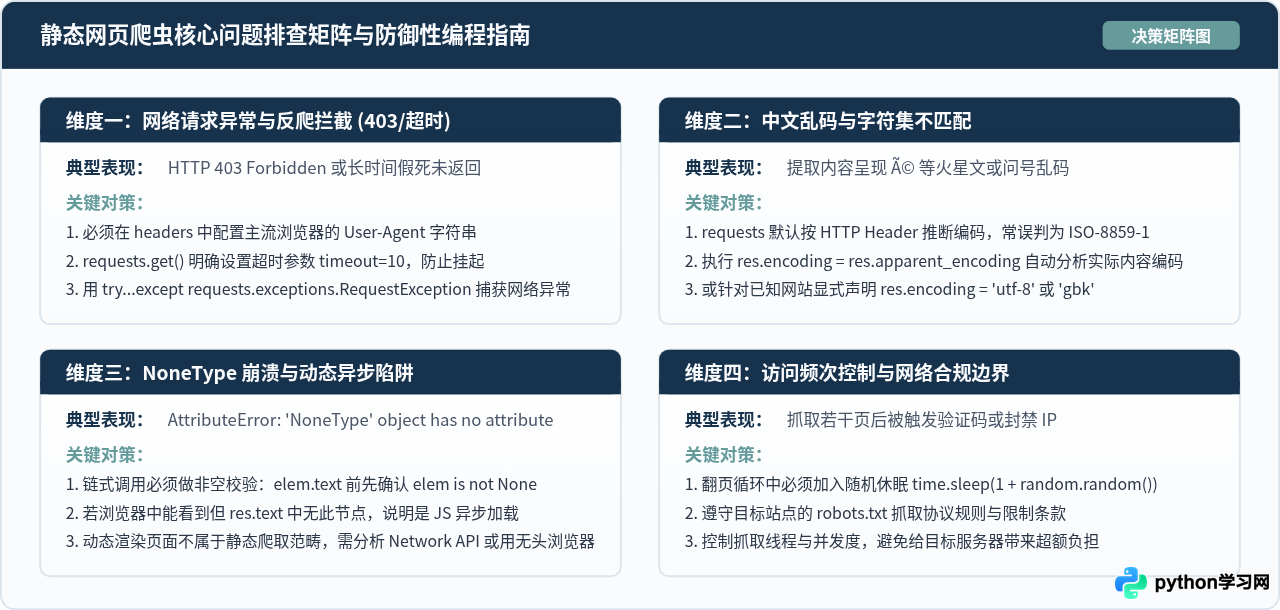
在编写爬虫的过程中,初学者最常遭遇四类挫折:网络请求超时、中文字符乱码、NoneType 报错以及找不到节点。理解它们的成因与应对决策,是写出健壮爬虫的关键。
- 严防
AttributeError: 'NoneType' object has no attribute 'get_text':
这是使用 BeautifulSoup 最频繁出现的报错。原因在于调用find()未找到指定标签,返回了None,紧接着直接调用.get_text()或.text就会直接崩溃。因此提取前务必做非空校验(如三元表达式node.text if node else "")。 - 排查“浏览器里有,抓下来却没有”的假象:
如果在浏览器控制台审查元素时明明看得到某个<div>,但用 Python 打印response.text却搜索不到,通常是因为该部分内容是网页加载后通过 Ajax / JavaScript 异步渲染的。对于这种内容,仅靠requests无法执行 JS 脚本,需要使用浏览器开发者工具中的 Network(网络)选项卡排查真实的后端 JSON 接口,或者使用 Selenium / Playwright 等无头浏览器进行渲染抓取。 - 合理控制请求频率(频控与礼貌爬取):
循环抓取多页数据时,切忌在for循环中无间隔高频并发请求。应导入time模块,在每次请求后调用time.sleep(1)暂停片刻。这既是对目标服务器资源的尊重,也能有效避免触发服务器的防御性封锁。
requests 负责“拿到网页”,BeautifulSoup 负责“拆解提取”。掌握这套流水线后,面对任何传统的静态内容站点,只需右键“查看网页源代码”,找准对应标签的 class 或 id,即可快速完成数据抽取。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









