

怎么用Python编写带最大重试次数的异常处理循环
详细讲解如何在Python中编写带最大重试次数的异常处理循环,从基础for-else结构到指数退避、精准异常过滤及通用重试装饰器实现,解决网络抖动与临时故障。
编写带最大重试次数的异常处理循环,核心是使用固定上限的 for 循环结合 try...except 结构:在每次迭代中执行目标操作,一旦成功执行则使用 break 或直接 return 退出循环;若触发可重试异常,则在未达到上限前等待并继续重试,在达到上限后重新抛出异常或进入兜底流程。
一、为什么优先选择 for 循环而非 while 循环
在初学阶段,很多开发者倾向于使用 while True 或 while retries < max_retries 来控制循环。这种写法需要手动管理计数器累加变量。一旦在异常捕获分支中因条件跳转、continue 或未覆盖的逻辑遗漏了计数器自增,程序就会陷入难以排查的无限死循环。
相比之下,Python 的 for attempt in range(1, max_retries + 1) 具备明确的有界迭代边界。计数器由迭代器自动递增,即使发生未预期的跳转也不会破坏循环终结条件。此外,Python 的 for 循环自带 else 子句支持:当循环正常耗尽迭代且未被 break 打断时,将自动进入 else 代码块,非常适合用于处理“全部重试失败”后的终极兜底逻辑。
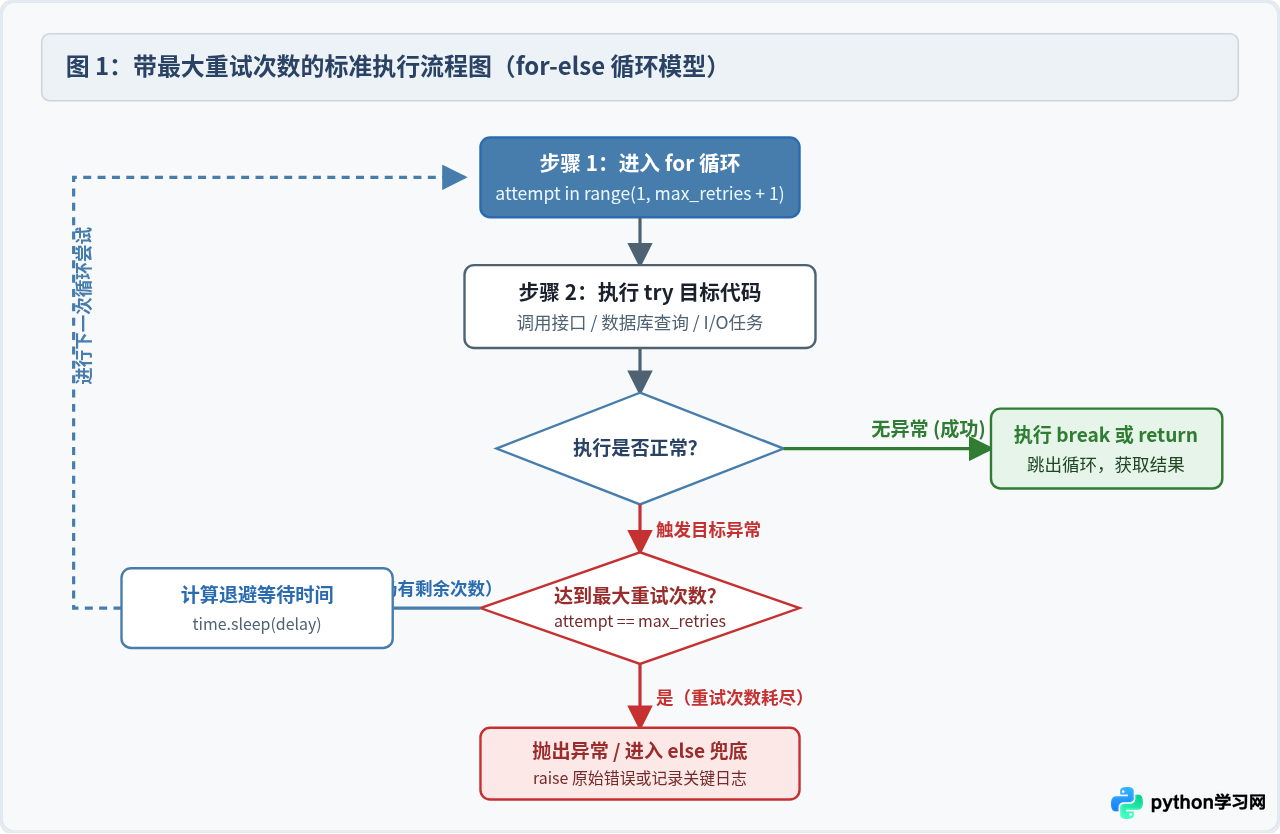
二、标准实现:编写第一个带上限的重试循环
以下是一个可直接运行的标准示例。该代码模拟了一个不稳定的远程网络请求:最大重试次数设置为 3 次,初始等待时间为 1 秒。
import time
import random

def unreliable_network_fetch():
    """模拟可能发生短暂故障的外部服务"""
    if random.random() < 0.7:
        raise ConnectionError("远程服务器响应超时或重置连接")
    return {"status": 200, "data": "成功获取业务数据"}

def fetch_with_retry(max_retries=3, delay=1.0):
    """
    带有最大重试次数的网络请求执行函数
    :param max_retries: 最大尝试次数(必须为正整数)
    :param delay: 每次重试间的固定等待秒数
    :return: 请求成功后的返回结果
    :raises: ConnectionError 在重试耗尽后抛出最后一次捕获的异常
    """
    for attempt in range(1, max_retries + 1):
        try:
            print(f"[Attempt {attempt}/{max_retries}] 正在尝试请求远程接口...")
            result = unreliable_network_fetch()
            print("[Success] 请求成功,正在处理数据。")
            return result
        except ConnectionError as err:
            print(f"[Warning] 第 {attempt} 次请求失败: {err}")
            if attempt == max_retries:
                print(f"[Error] 已达到最大重试次数 {max_retries},重试中止。")
                raise  # 重新抛出最后一次捕获的异常,保留完整调用栈

            # 尚未耗尽重试次数,执行等待后继续下一次循环
            print(f"[Info] 等待 {delay} 秒后发起下一次重试...")
            time.sleep(delay)

if __name__ == "__main__":
    try:
        data = fetch_with_retry(max_retries=3, delay=1.0)
        print("最终执行结果:", data)
    except ConnectionError as final_error:
        print("任务最终失败,捕获到外层异常:", final_error)
except 分支中达到最大次数时,务必使用不带参数的裸 raise 语句。这样能够完整保留最初发生异常时的调用栈(Traceback),便于在生产日志中准确定位底层原因。切忌使用 raise Exception("请求失败") 替换原始异常,这会丢失底层根因信息。
三、避免重试风暴:退避策略与随机抖动
在上面的基础示例中,每次重试之间的等待时间是固定的(1秒)。这种策略在本地开发或低并发脚本中可行,但在真实的分布式环境与网络通信中存在严重缺陷。
当远程依赖服务发生瞬时故障或过载时,如果所有并发客户端都采用固定的间隔(如每隔 1 秒重试),就会产生雷鸣群拥效应(Thundering Herd Problem)。大量客户端的重试请求会在同一时刻集中击中服务端,导致本已过载的服务彻底崩溃。
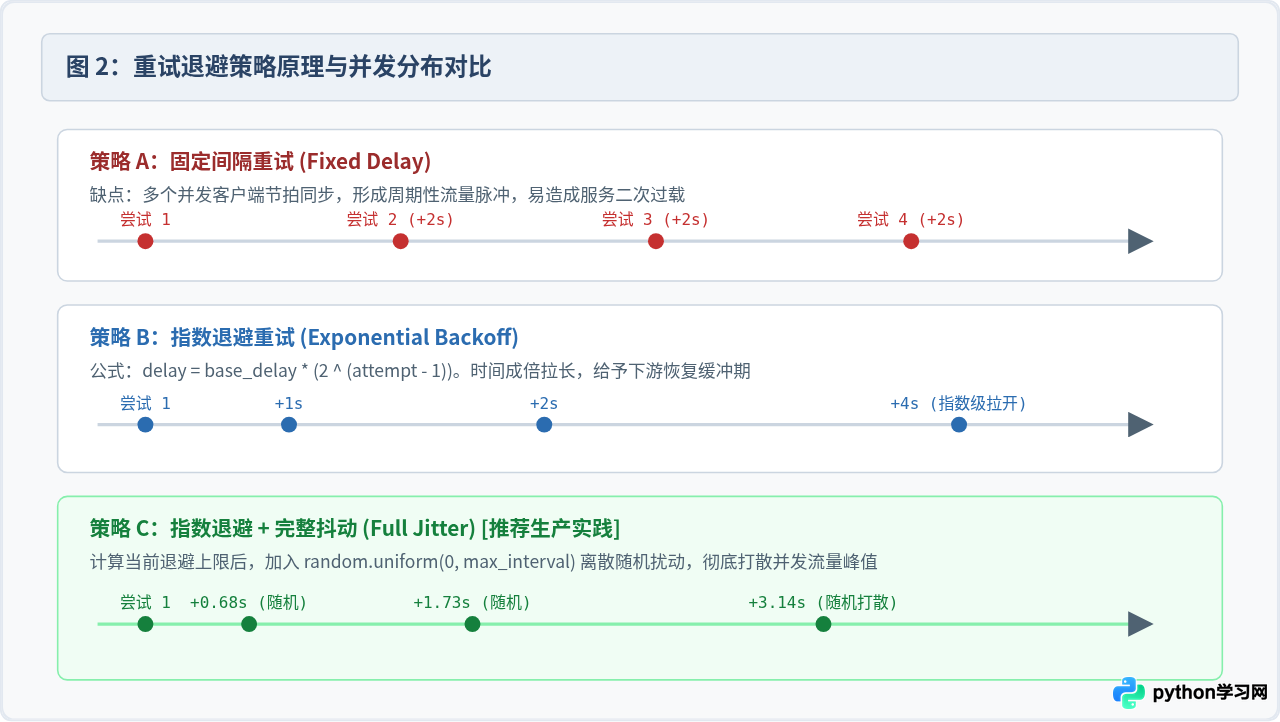
改进退避算法后的重试等待计算公式如下:
import time
import random

def calculate_backoff(attempt, base_delay=1.0, max_delay=30.0, backoff_factor=2.0):
    """
    计算加入随机抖动的指数退避时间 (Full Jitter)
    :param attempt: 当前重试轮次 (从 1 开始)
    :param base_delay: 基础等待时间 (秒)
    :param max_delay: 最大等待时间上限 (秒)
    :param backoff_factor: 指数递增因子
    :return: 经过抖动计算后的休眠秒数
    """
    # 1. 计算理论指数等待时间
    calculated_delay = base_delay * (backoff_factor ** (attempt - 1))

    # 2. 设置最大休眠上限截断,避免极端情况下休眠过长
    capped_delay = min(calculated_delay, max_delay)

    # 3. 完整抖动:在 [0, capped_delay] 区间内生成均匀分布随机数
    sleep_duration = random.uniform(0, capped_delay)
    return sleep_duration
四、异常分类与重试边界判定
一个健壮的重试循环绝不能盲目捕获所有异常。如果使用了宽泛的 except Exception:,可能会把参数错误(ValueError)、代码逻辑 Bug(TypeError、IndexError)或鉴权失败(401/403)等确定性错误也纳入重试。
这类错误属于“致命且永久(Permanent)”的问题,无论重试多少次都会必然失败。无谓的重试只会浪费系统资源,延误告警发现。只有瞬态网络错误(Transient Faults)才应当被重试。
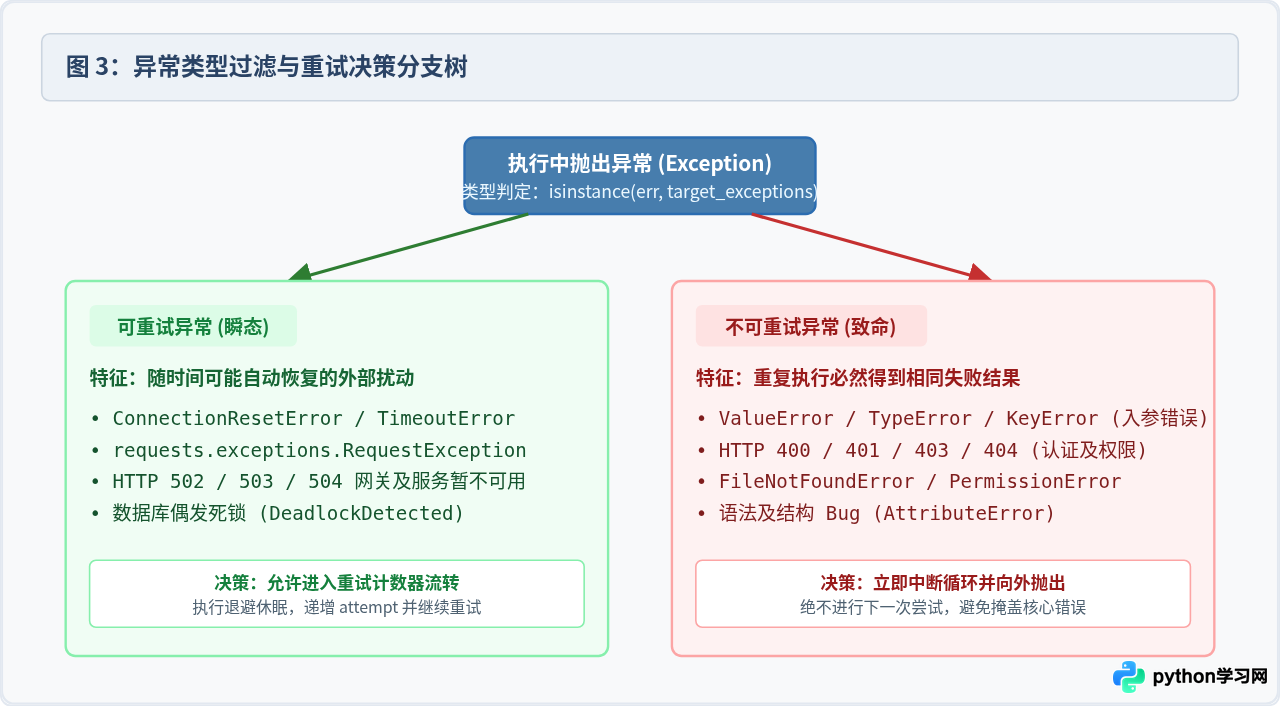
在代码中,应通过元组明确指定需要捕获的异常类型,例如 except (ConnectionResetError, TimeoutError) as err:。
五、工程化封装:编写通用重试装饰器
如果在每个调用外部服务的地方都手写一遍 for 循环和 try...except,会导致大量样板代码冗余。将重试逻辑封装为 Python 函数装饰器,是保持业务代码干净、可复用的最佳实践。
以下封装支持自定义重试次数、退避基数、最大上限及可捕获异常元组:
import time
import random
import logging
from functools import wraps

# 配置标准日志输出
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("RetryHandler")

def retry(
    max_retries=3,
    base_delay=1.0,
    max_delay=10.0,
    backoff_factor=2.0,
    jitter=True,
    retry_exceptions=(Exception,)
):
    """
    通用重试装饰器
    :param max_retries: 最大重试次数
    :param base_delay: 基础延时秒数
    :param max_delay: 最大延时上限
    :param backoff_factor: 指数乘数
    :param jitter: 是否启用随机抖动
    :param retry_exceptions: 触发重试的异常类元组
    """
    def decorator(func):
        @wraps(func)
        def wrapper(*args, **kwargs):
            last_exception = None

            for attempt in range(1, max_retries + 1):
                try:
                    return func(*args, **kwargs)
                except retry_exceptions as exc:
                    last_exception = exc

                    if attempt == max_retries:
                        logger.error(
                            "函数 [%s] 达到最大重试次数 (%d/%d),调用最终失败: %s",
                            func.__name__, attempt, max_retries, exc
                        )
                        raise

                    # 计算退避时间
                    delay = base_delay * (backoff_factor ** (attempt - 1))
                    delay = min(delay, max_delay)
                    if jitter:
                        delay = random.uniform(0, delay)

                    logger.warning(
                        "函数 [%s] 第 %d 次执行捕获异常: %s。将在 %.2f 秒后重试...",
                        func.__name__, attempt, exc, delay
                    )
                    time.sleep(delay)

            # 理论上不会到达此处,若出现则重新抛出最后异常
            if last_exception:
                raise last_exception
        return wrapper
    return decorator
如何使用装饰器修饰业务函数
# 业务调用示例
@retry(
    max_retries=4,
    base_delay=0.5,
    max_delay=5.0,
    retry_exceptions=(ConnectionError, TimeoutError)
)
def query_payment_status(order_id: str):
    """模拟查询第三方支付订单状态"""
    # 模拟偶发的网络超时
    if random.random() < 0.6:
        raise TimeoutError("网关连接超时")
    return {"order_id": order_id, "status": "PAID"}

if __name__ == "__main__":
    result = query_payment_status("ORD-20261031-8899")
    print("返回数据:", result)
六、生产环境关键规范与总结
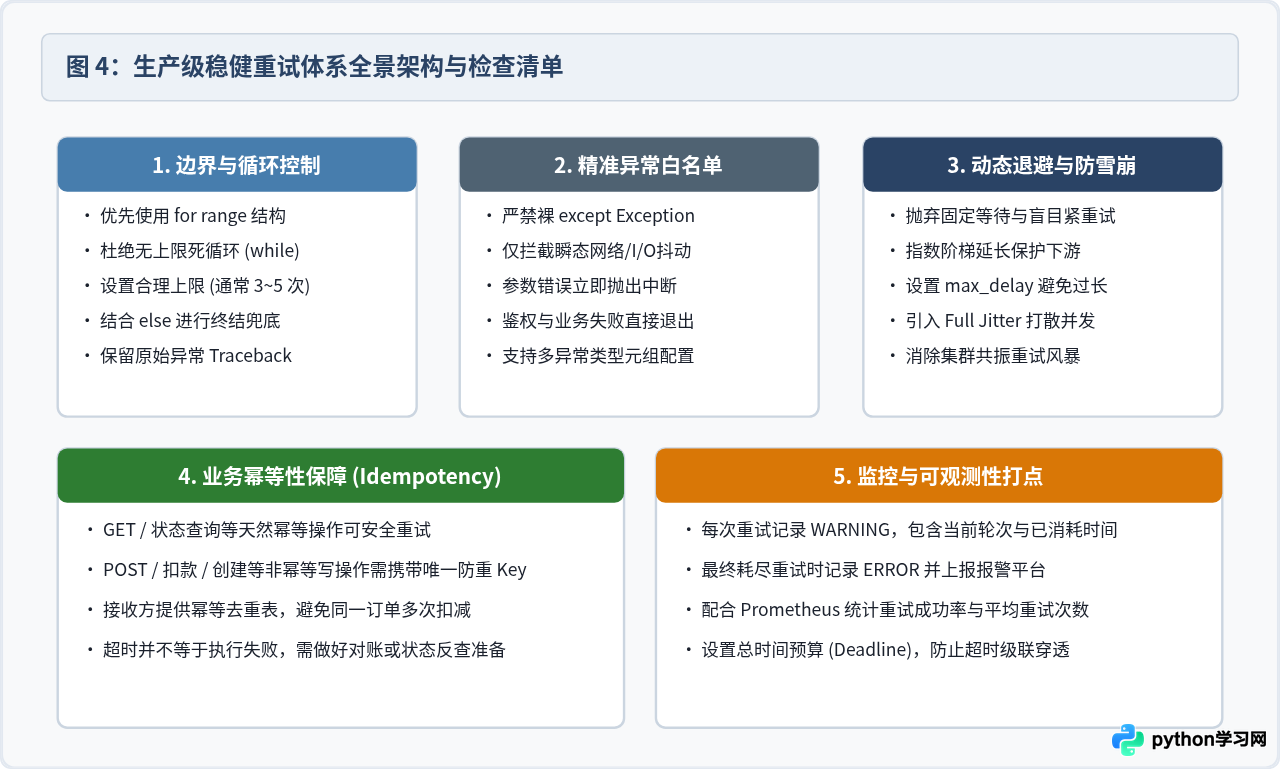
在正式将重试逻辑上线前,除了掌握上述循环写法,还需遵守以下核心原则:
- 接口幂等性保障:重试意味着相同的动作可能被重复触发。对于非幂等接口(如扣款、创建资源、消息发送),必须依赖服务端提供的
Idempotency-Key唯一凭据或客户端预生成的全局流水号,严防因重试导致的重复扣款或数据重复插入。 - 全局超时约束:重试循环的总耗时可能随着退避时间拉长而迅速增加。如果上层调用方(如 Web HTTP 请求)有 5 秒的总超时时间,内部重试如果持续 10 秒就会导致连接被外层强制断开。建议设定跨重试的总时间预算(Deadline/Timeout Budget)。
- 日志可观测性:重试不等于静默吞没错误。必须在每次触发重试时输出带有
attempt次数、异常原因及休眠时间的WARNING日志;在重试耗尽时输出ERROR日志并上报监控指标。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









