

Python代码中用下划线(_)忽略不需要的变量值
深入解析在Python中利用单下划线(_)和星号下划线(*_)作为占位符忽略多余变量值的技术原理、典型场景、进阶用法与潜在冲突防范。
假设你正在处理服务端的 API 响应,或者从数据库执行一条多表查询,获得了一个结构清晰的四元组数据:("2026-10-28", "auth_service", "LOGIN_SUCCESS", 200)。在当下的业务逻辑中,你只需要校验状态码 200 并记录日期,而服务名和日志标识符在当前函数中完全不需要参与运算。如果显式地将每个字段都命名为具体变量,现代代码静态检查工具(例如 Flake8、Pylint)会抛出一连串“Unused variable”的警告,后续维护代码的同事也会困惑这些变量是否在某处遗漏了消费。
在 Python 社区的编程惯例中,针对这类“语法上必须接收、但逻辑上无需使用”的冗余数据,标准做法是使用单个下划线 _ 作为临时占位变量(Throwaway Variable)。它向 Python 解释器、代码检查器以及阅读代码的人传递出一个明确的意图:这个位置的值已被显式丢弃,无须关注。
一、下划线忽略变量的核心机制与语义
从 Python 语法的角度来看,下划线 _ 本质上并不是一个特殊的关键字,而是一个完全合法的普通标识符。这意味着当你写下 _ = value 时,解释器确实创建了一个名为 _ 的局部或全局变量,并将其指向对应的内存对象。
然而,Python 官方约定与 PEP 8 风格指南赋予了它约定俗成的语义:
- 读者意图明确:代码审阅者看到
_会立刻意识到该值不参与任何业务计算,减少心智负担。 - 静态工具免疫:大多数代码静态分析器(如 Flake8、Ruff、Pylint、IDE 语法检查)默认将
_视作忽略项,不会对其触发“变量未被使用(unused variable)”的告警。 - 语义精简:避免开发者花费时间构思诸如
dummy、temp_unused_val等繁琐且不统一的临时名称。
二、典型场景:定长元组与列表解包
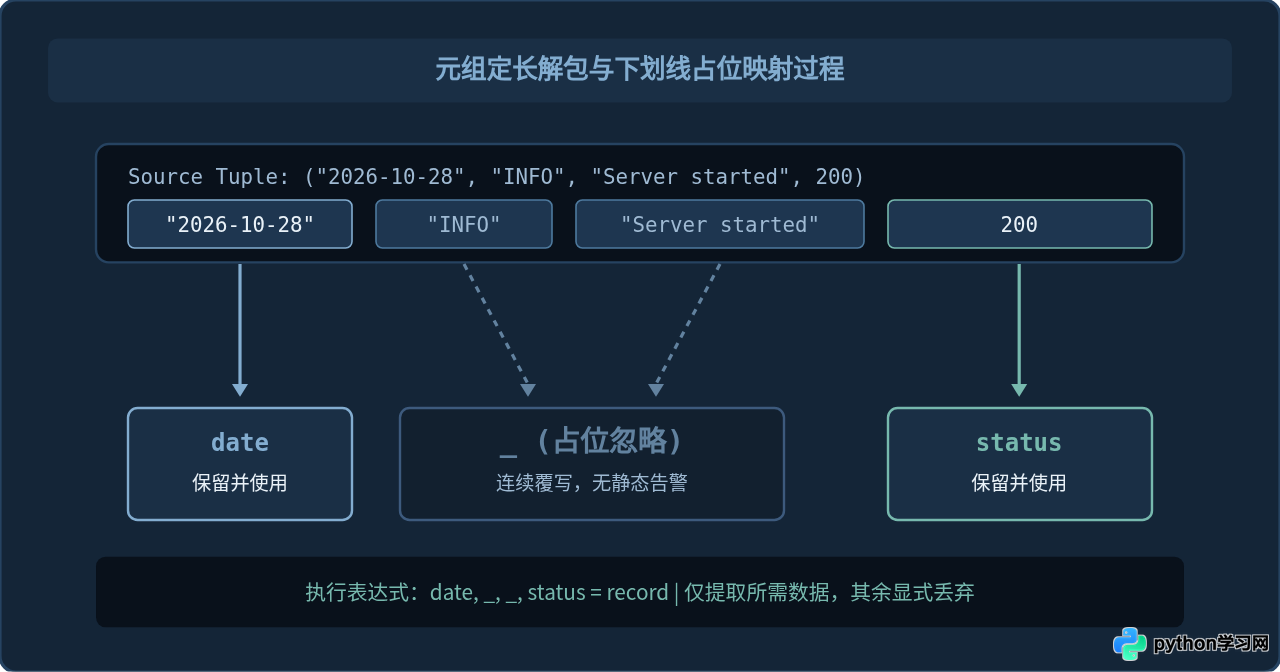
最常见的使用场景是解包固定长度的序列。当函数返回多个值,或者解构一个已知结构的元组时,利用下划线可以精准跳过特定槽位。
# 示例 1:仅获取第一个和最后一个元素
record = ("2026-10-28", "INFO", "Server started", 200)
date, _, _, status = record

print(f"日期: {date}, 状态: {status}")
# 输出: 日期: 2026-10-28, 状态: 200
在上面的解包操作中,第二个和第三个元素分别被依次赋值给 _。虽然同一语句中 _ 被连续覆盖赋值,但这完全合法,因为我们本来就不关心它们的内容。
三、进阶场景:星号解包 (*_) 忽略任意多个元素
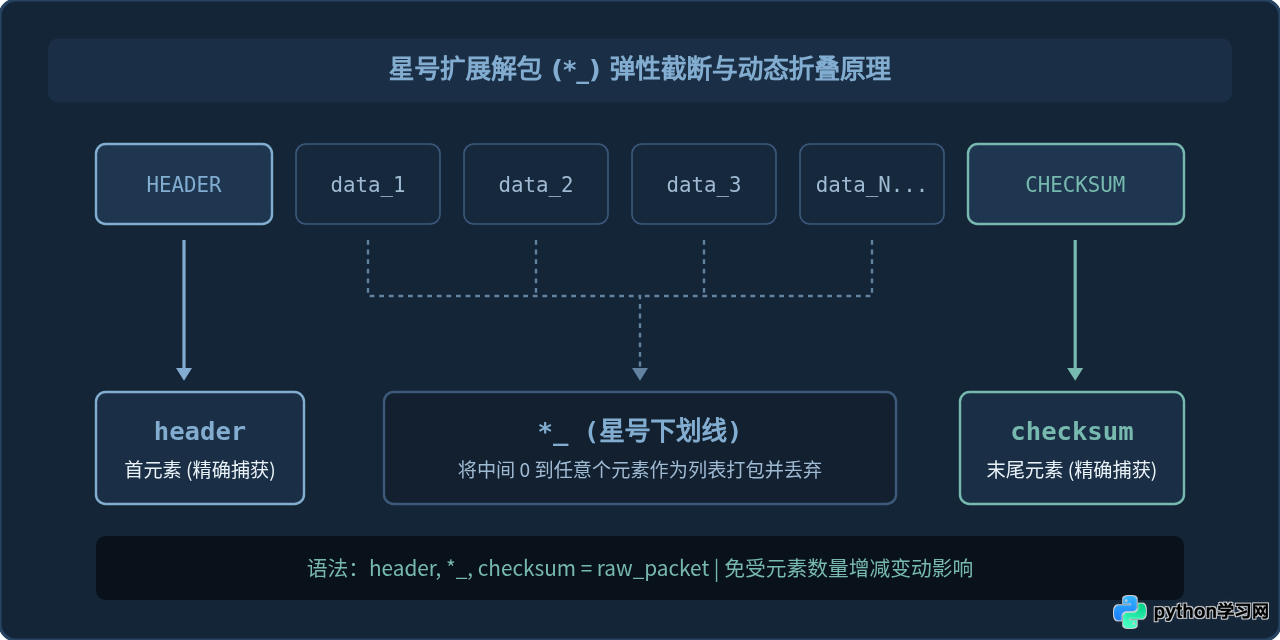
如果数据序列长度较长,或者长度不可预估,单纯书写多个下划线 _, _, _ 不仅冗长而且容易因数量不匹配引发 ValueError: too many values to unpack。Python 3 引入的扩展可迭代解包(Extended Iterable Unpacking)允许配合星号 * 使用:
# 示例 2:仅提取头部与尾部,忽略中间所有字段
raw_packet = ["HEADER_V2", 101, 204, 512, 889, "CHECKSUM_OK"]
header, *_, checksum = raw_packet

print(header)    # 输出: HEADER_V2
print(checksum)  # 输出: CHECKSUM_OK
语法 *_ 会将中间剩余的 [101, 204, 512, 889] 打包为一个列表并赋值给 _。这种写法具备极强的鲁棒性:无论中间包含 0 个、1 个还是数千个元素,解包都能稳定完成,而不需要修改接收变量的个数。
四、其他高频使用场景
1. 仅需重复次数的 for 循环
当你只需要循环执行特定次数的代码块,而不需要使用计数索引变量时,使用 _ 是标准习惯:
# 执行 5 次重试请求
for _ in range(5):
    success = send_heartbeat()
    if success:
        break
对比 for i in range(5),使用 _ 能让阅读者第一眼确信循环体内部绝对没有依赖迭代步数 i 的偏移逻辑,代码意图更加纯粹。
2. 遍历字典时仅关心键或值
在遍历字典的 items() 视图时,若有时仅需其中一项:
config_map = {"timeout": 30, "retry": 3, "buffer_size": 4096}

# 仅检查是否存在大于 1000 的数值配置项
for _, val in config_map.items():
    if val > 1000:
print(f"发现高阈值配置项: {val}")虽然 for _, val in config_map.items() 语义清晰,但如果确实只关心字典的值或键,更优且运行速度更快的写法是直接调用 for val in config_map.values() 或 for key in config_map.keys(),从而省去元组构建与解包的微小开销。
五、底层机制与潜在冲突防范
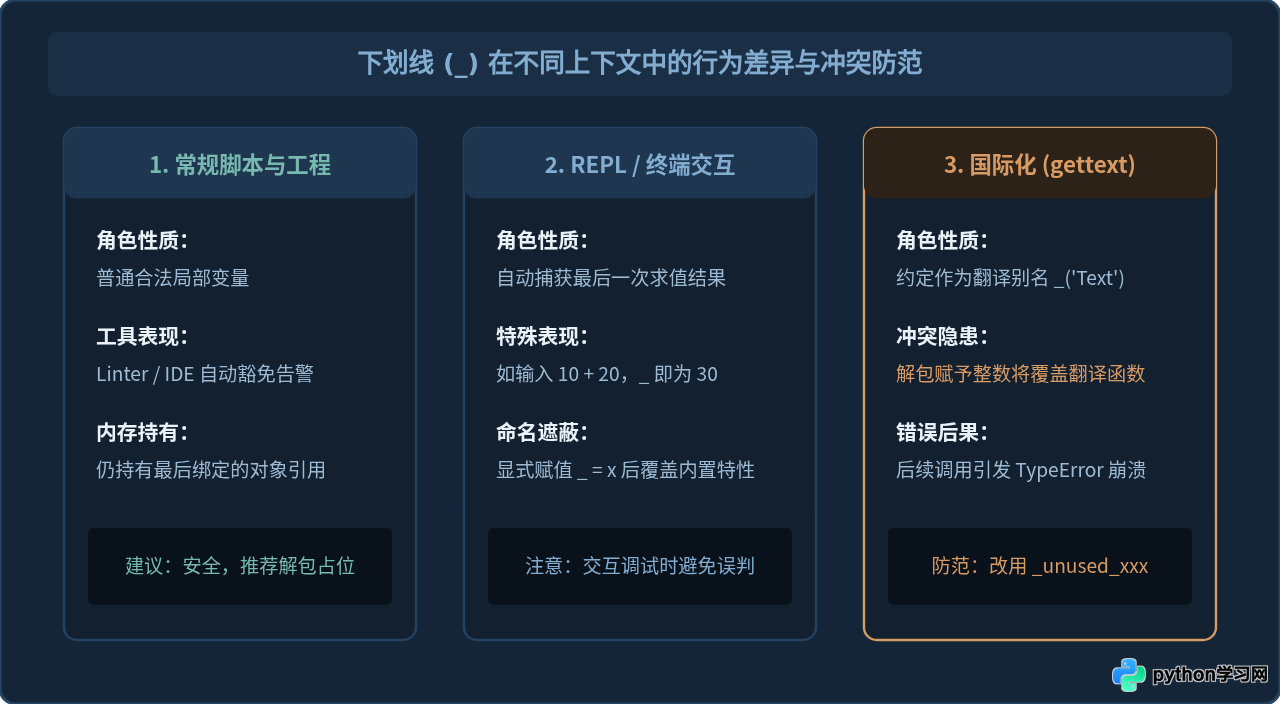
尽管下划线使用极为方便,但如果不了解其在特殊上下文中的特殊角色,可能会引入隐蔽的 Bug。以下列出了三种必须了解的运行边界:
1. 国际化(gettext)冲突风险
在许多 Web 框架(例如 Django、Flask)或多语言客户端项目中,国际化工具 gettext 通常会将翻译函数绑定为单下划线:
from gettext import gettext as _

print(_("Welcome back!"))

# 危险操作:解包时意外覆盖了翻译函数
status, _ = get_response()

# 此处抛出 TypeError: 'int' object is not callable!
print(_("Operation succeeded."))避坑指南:在涉及国际化多语言的项目中,解包忽略变量时应避免裸写 _,而应采用具名忽略方式,如 _status、_unused 或 dummy。
2. 避免过度忽略导致代码可读性断崖
当解包列表中存在多个具有特定业务含义但暂时不使用的字段时,全部写成 _ 会使后续代码维护者无法直观获知元组的原始数据结构:
# 较差写法:难以获知中间 3 个元素分别代表什么
user_id, _, _, _, is_active = fetch_user_record()

# 推荐写法:带前缀下划线,既表明忽略意图,又保留了文档说明价值
user_id, _created_at, _ip_addr, _role, is_active = fetch_user_record()
在 Python 代码规范中,任何以单下划线开头的变量名(如 _temp、_role)同样会被绝大多数代码审查工具判定为“有意未使用的变量”,既消除警告,又兼顾了代码的可读自解释性。
3. 内存释放问题
因为 _ 在当前作用域中是一个真实存在的引用,所以如果它绑定了一个体积巨大的对象(例如数以 GB 计的数组或文件句柄),该对象在作用域退出或 _ 被重新覆盖前将无法被 Python 垃圾回收机制(GC)清理。处理超大型数据时需注意适时使用 del _ 解除引用。
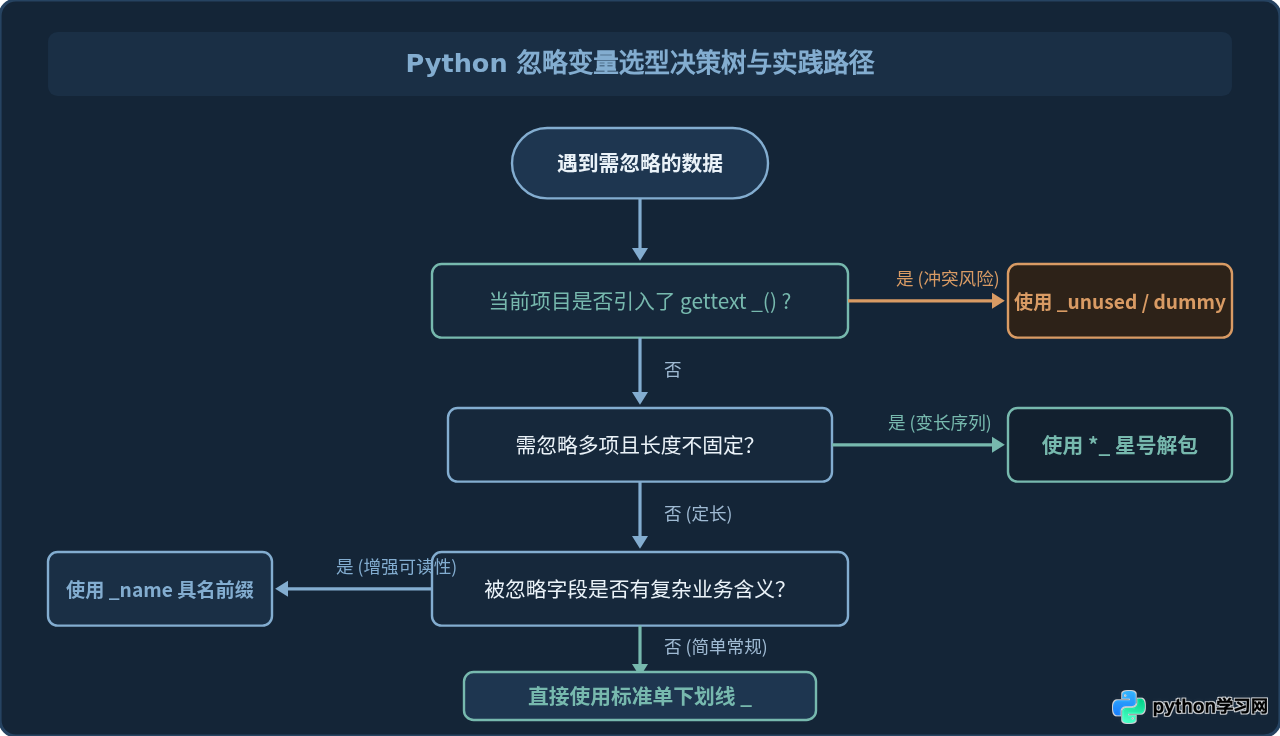
六、忽略变量的选择决策路径
针对不同解包与循环场景,开发者可以根据下表与决策图选择最规范的处理方案:
| 场景特征 | 推荐语法 | 优点 | 典型示例 |
|---|---|---|---|
| 简单定长序列,跳过个别位置 | _ |
简洁明了,PEP 8 标准通用 | a, _, c = get_triple() |
| 变长序列,截取头部或尾部 | *_ |
弹性容错,无惧元素数量变化 | first, *_, last = sequence |
| 需要兼顾结构可读性的复杂数据 | _fieldname |
代码自解释,消除 linter 告警 | uid, _created, _ip = row |
| 项目已导入 gettext 国际化库 | _unused 或 dummy |
彻底避免覆盖 _() 翻译函数 |
code, _unused = parse() |
| 仅需要循环计数的固定迭代 | for _ in range(n) |
明确表达循环体与计数值解耦 | for _ in range(3): retry() |
七、核心总结
在 Python 代码编写中,合理利用下划线丢弃冗余变量是一项基础而关键的代码洁癖体现:
- 核心意图:单下划线
_是 Pythonic 的语法约定,用于显式声明变量不被消费,并规避静态分析器的无用变量警告。 - 组合技巧:对于变长或长序列,优先配合星号
*_优雅截断,避免手工硬编码多个占位符。 - 边界清晰:在多语言项目(gettext)中防止命名覆盖;在结构复杂的数据中善用
_fieldname兼顾可读性与干净的代码指标。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









