

Python数据导入报错怎么修?解决编码错误与格式不匹配问题
深入解析Python及Pandas在数据导入时常见的编码错误与格式不匹配报错,提供文件真实编码检测、参数配置、脏行过滤以及类型固化的完整修复方案与标准化导入流程。
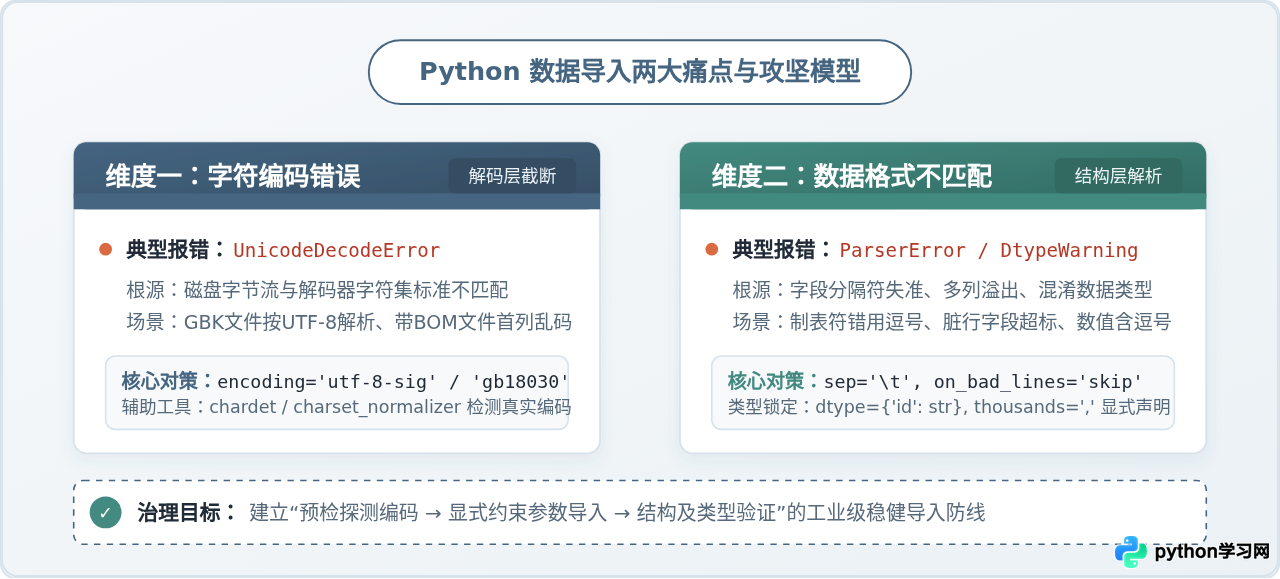
在 Python 中使用 Pandas 或内置文件模块导入数据时,终端弹出的 Traceback 报错往往让人措手不及。但无论错误表现得多么复杂,绝大多数问题都集中在两个明确的技术切面上:第一类是字符集解码失败导致的 UnicodeDecodeError,第二类则是行字段超标、分隔符错位或混淆数据类型引发的 ParserError、DtypeWarning 与 ValueError。解决这两类问题的核心逻辑非常直接:先通过错误栈精确定位报错发生在“字符解码阶段”还是“结构解析阶段”,随后用编码探测工具明确文件物理编码,或通过显式指定分隔符、隔离脏数据行及固化列类型,使数据流平稳加载入内存。
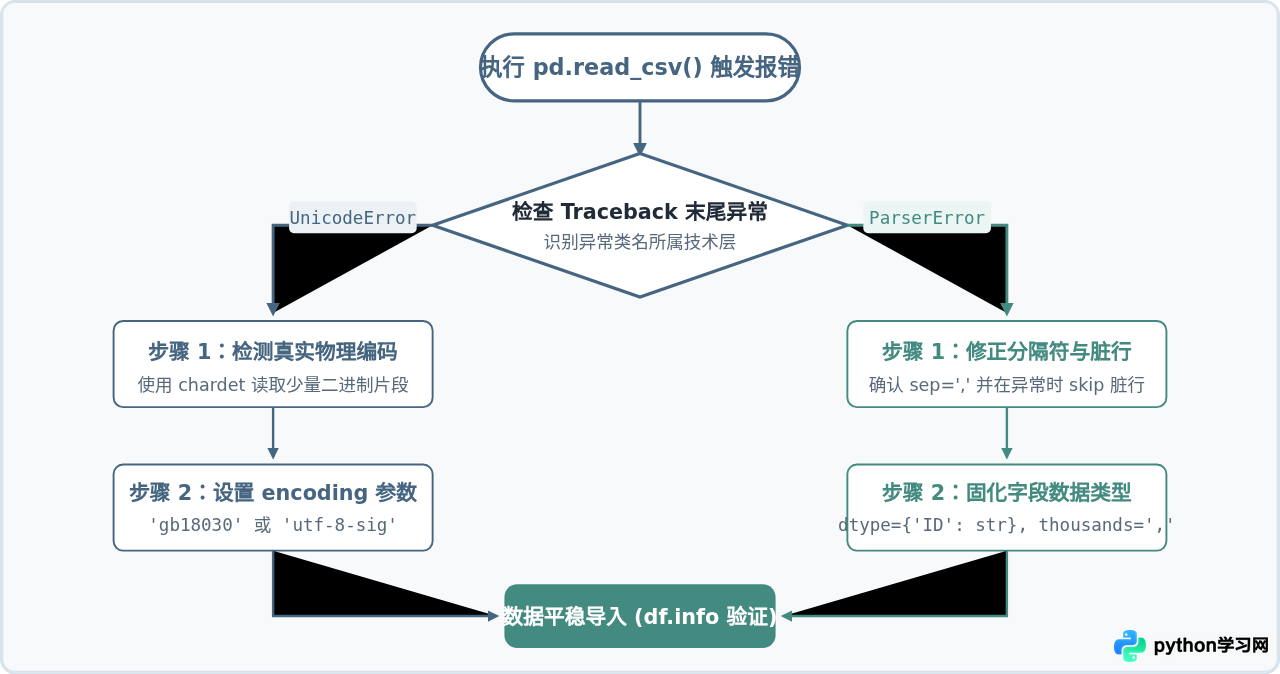
一、快速诊断:从报错栈精确定位问题根源
面对长串报错信息,许多人习惯盲目复制去网上搜索,往往会尝试大量不适用的参数。实际上,Python 的 Traceback 在末尾已经清晰指明了故障层级:
-
编码错误(解码层故障):末尾明确输出
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x... in position ...: invalid continuation byte。这意味着 Python 尝试把硬盘上的二进制字节流还原为字符串时,字节特征违背了指定编码规范(通常是默认的 UTF-8)。此时数据根本尚未进入表格解析阶段。 -
格式不匹配(结构层故障):末尾抛出
pandas.errors.ParserError: Error tokenizing data. C error: Expected X fields in line Y, saw Z,或者终端提示DtypeWarning: Columns (X) have mixed types。这说明文件已成功解码为文本字符,但在按行和逗号切割字段时,某些行的字段数量超出了表头规范,或是 Pandas 在抽样推断字段类型时发现了冲突值。
二、彻底解决编码错误(UnicodeDecodeError)
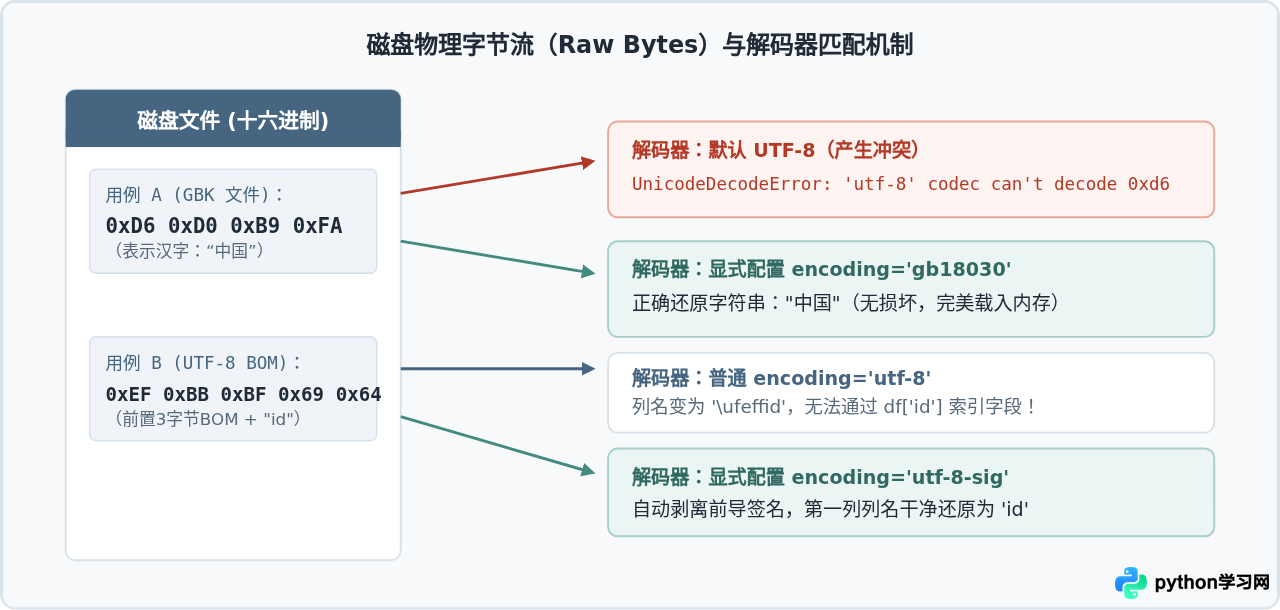
Python 3 默认在所有文本处理环节使用 UTF-8 编码。然而,国内绝大部分历史业务系统、Windows 环境下的办公软件(如中文版 Excel)导出的 CSV 文件,底层通常采用 GBK 或 GB18030 字符集;另有部分 Windows 导出的 UTF-8 文件会强制插入 3 字节的 BOM 标记头。
1. 底层机理:字节与解码规则的错位
文件在存储介质上本质全是一串十六进制字节。例如汉字“中”在 GBK 中编码为双字节 D6 D0,而在 UTF-8 中编码为三字节 E4 B8 AD。当 Pandas 尝试使用 UTF-8 解码器处理 GBK 文件的字节 0xD6 时,UTF-8 规则判定其属于多字节序列的引导字节,但后随字节无法满足 UTF-8 规范格式,系统便会立刻终止程序并抛出 UnicodeDecodeError。
2. 排查三部曲与修复方案
遇到编码报错时,请严格按以下步骤修复:
第一步:自动探测文件的真实物理编码。无需打开大文件盲猜,直接使用 Python 提供的 charset_normalizer 或 chardet 读取文件前数千字节进行特征推断:
import charset_normalizer

def detect_file_encoding(file_path: str) -> str:
    # 只需读取前 10000 字节,即可精确推断文件特征,避免加载数 GB 数据耗尽内存
    with open(file_path, "rb") as f:
        raw_bytes = f.read(10000)

    result = charset_normalizer.from_bytes(raw_bytes).best()
    if result is not None:
        return result.encoding
    return "utf-8"

# 示例调用
real_encoding = detect_file_encoding("sales_data.csv")
print(f"探测得到的文件真实编码: {real_encoding}")
# 示例输出:探测得到的文件真实编码: GB18030
第二步:选择容错率更高的字符集声明。当检测到中文编码倾向时,推荐优先选用 gb18030 而非 gbk。因为 GB18030 是国家强制标准,不仅全面向下兼容 GBK 和 GB2312,还补齐了冷僻字、少数民族文字及特殊符号。
import pandas as pd

# 方案 A:针对国内软件导出的常见中文报表
df = pd.read_csv("sales_data.csv", encoding="gb18030")

# 方案 B:针对由 Windows Excel 导出并带签名的 UTF-8 文件
df = pd.read_csv("sales_data_excel.csv", encoding="utf-8-sig")

# 验证导入结果
print(f"导入成功,数据维度:{df.shape}")
print("列名列表:", df.columns.tolist()[:3])
# 示例输出:
# 导入成功,数据维度:(12500, 8)
# 列名列表:['订单编号', '客户姓名', '下单时间']
第三步:非关键损坏字节的保底容错(慎用)。如果数据来自爬虫抓取或网络截断,文中混合了少量不可解析的乱码字节,且业务上允许丢弃个别乱码字,可以通过标准库 open() 注入 errors="replace" 包装后导入:
import pandas as pd

# 通过 open 对象的 errors 参数规避单个字节损坏中断
with open("corrupted_data.csv", mode="r", encoding="utf-8", errors="replace") as f:
    df = pd.read_csv(f)

print("包含轻微损坏字节的数据已容错读入,坏字符已被替换为标准问号符号。")
三、攻克格式不匹配问题(分隔符、字段不齐与数据类型混乱)
当字符编码解决后,数据流进入结构解析阶段。此时的挑战主要在于数据源生成时的格式瑕疵。
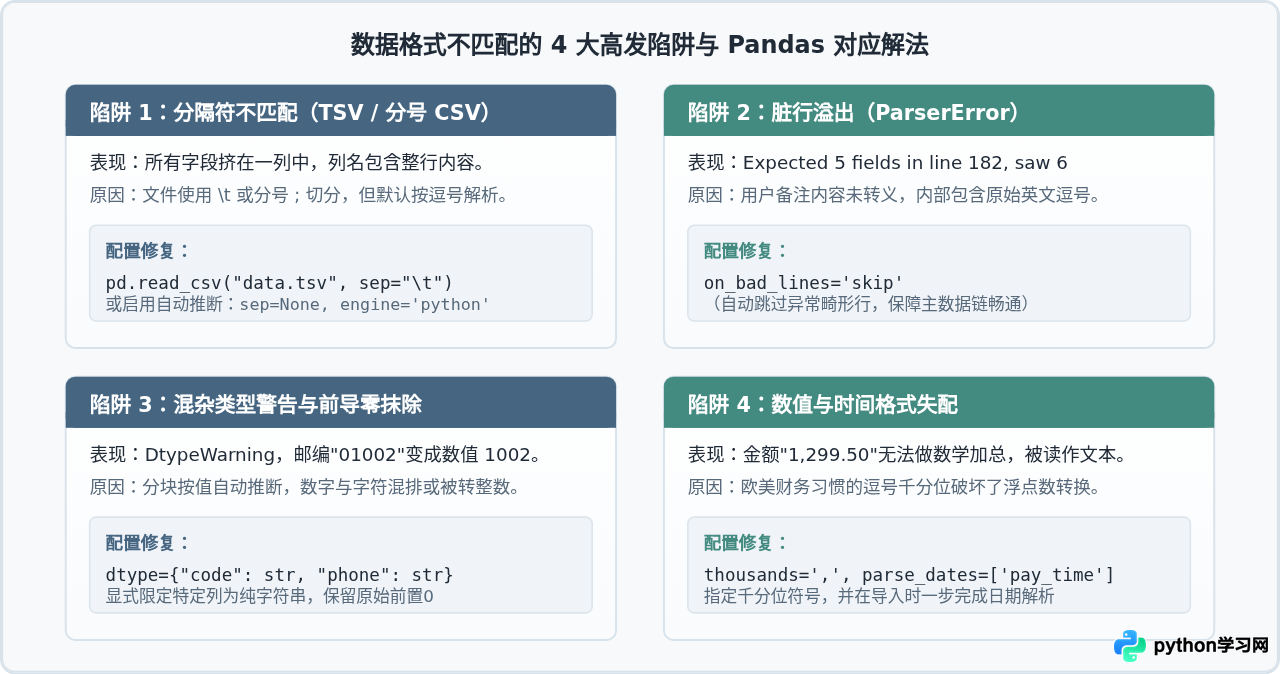
1. 分隔符失准处理
部分数据文件扩展名虽为 .csv,但实际上是由欧洲系统导出(使用分号 ; 作为分隔符,逗号用作小数位),或是制表符分隔的 TSV 文件。如果强行按默认逗号读取,整个文件的所有内容都会被归拢为单一列。
处理方案:可以显式声明 sep="\t" 或 sep=";"。如果不确定分隔符,可以配置 sep=None 并指定 engine="python",让 Python 正则引擎通过首批数据自动推导实际的分隔符:
import pandas as pd

# 让 Python 引擎自动探测实际使用的分隔符(制表符、逗号或分号)
df = pd.read_csv("unknown_export.csv", sep=None, engine="python")
print(f"成功识别并拆分为 {len(df.columns)} 个字段")
2. 字段超标与脏行隔离(解决 ParserError)
CSV 解析核心机制依赖每行中分隔符数量的绝对一致。如果业务文本中包含了未转义的半角逗号(例如地址字段 "No.12, West Road" 缺少外层引号包裹),解析器就会在该行检测到多余的字段,抛出:
pandas.errors.ParserError: Error tokenizing data. C error: Expected 6 fields in line 42, saw 7
在 Pandas 1.3.0 之前,开发者常用 error_bad_lines=False,但在现代 Pandas 版本中该参数已被废弃,标准参数变更为 on_bad_lines。根据业务场景,你有两种处理方式:
import pandas as pd

# 策略一:跳过异常行(适用于海量日志分析,个别脏数据不影响大盘走势)
df_clean = pd.read_csv("user_logs.csv", on_bad_lines="skip")

# 策略二:自定义回调函数记录脏数据行,便于后续修正核查
bad_records = []

def record_bad_line(bad_line: list):
    bad_records.append(bad_line)
    return None  # 返回 None 表示在当前 DataFrame 中丢弃该行

df_audited = pd.read_csv(
    "user_logs.csv",
    engine="python",
    on_bad_lines=record_bad_line
)

print(f"有效数据入库行数: {len(df_audited)}")
print(f"截获异常脏行数量: {len(bad_records)}")
# 示例输出:
# 有效数据入库行数: 9850
# 截获异常脏行数量: 150
3. 混合类型推断与前导零保护
Pandas 默认按块(Chunk)扫描数据来自动推断列类型。若某列前 1000 行全为纯数字,而后序数据中夹杂了字母或特定符号,Pandas 就会抛出 DtypeWarning: Columns (...) have mixed types。更为隐蔽的问题在于用户 ID、电话号码或组织代码等字段,若被自动推断为整型,开头的 0 会被静默抹除(如 "0123" 变成数值 123)。
处理方案:使用 dtype 参数显式传参字典,强行锁定关键字段的物理类型;同时针对含有财务千分位逗号的数字列,声明 thousands=",":
import pandas as pd

# 声明关键列的数据类型方案
custom_schema = {
    "user_id": str,     # 强制保持字符串,避免工号前导 0 丢失
    "phone": str,       # 手机号统一以字符形式保留
    "status_code": str
}

df = pd.read_csv(
    "transactions.csv",
    dtype=custom_schema,
    thousands=",",                     # 自动将 "1,450.00" 转换为浮点数 1450.00
    parse_dates=["transaction_date"],  # 直接转化为 datetime64 格式
    na_values=["N/A", "null", "--"]    # 规范化异常占位符为标准 NaN
)

print(df.dtypes)
# 示例输出:
# user_id                   object
# phone                     object
# amount                   float64
# transaction_date  datetime64[ns]
四、构建稳健的数据导入生产规范
为了避免在日常数据分析和生产脚本中频繁修补报错,建立一套三层防御的“标准化导入模版”是最佳实践:
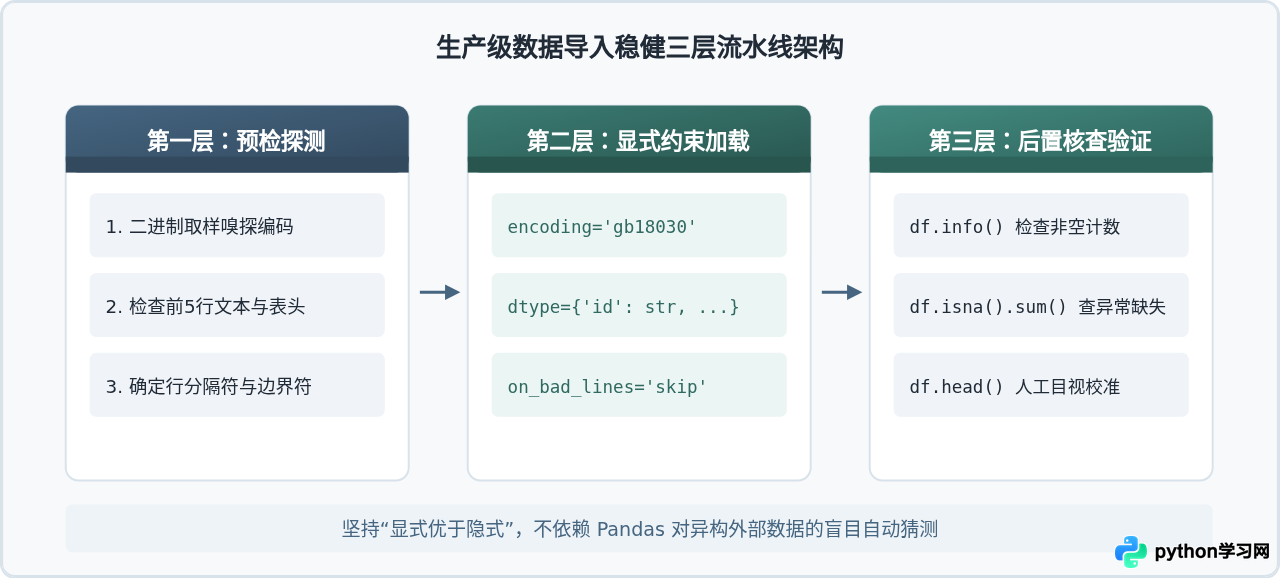
常见导入配置速查表
| 常见问题 / 报错提示 | 典型诱因 | 标准修复参数设置 |
|---|---|---|
UnicodeDecodeError: 'utf-8' codec... |
中文 Windows 系统导出的 CSV 采用 GBK/GB18030 字符集 | encoding='gb18030' |
列名开头显示类似 \ufeffid 乱码 |
带有微软签名 BOM 头的 UTF-8 CSV 文件 | encoding='utf-8-sig' |
ParserError: Expected X fields, saw Y |
某行正文中包含未转义的原始分隔符或缺失闭合引号 | on_bad_lines='skip' |
| 全表所有字段被压缩合并进单一列 | 实际分隔符为制表符 \t 或分号 ; |
sep='\t' 或 sep=';' |
身份证、单号开头的 0 导入后消失 |
被 Pandas 默认自动推断为 int64 整数 |
dtype={'id_no': str} |
带有千分位的金额(如 "2,350.00")被转为文本 |
逗号阻碍了标准浮点型推断解析器 | thousands=',' |
生产级统一加载函数模版
在团队开发中,推荐封装统一的鲁棒导入函数,把上述所有排查与容错逻辑固化下来:
robust_csv_loader.pyimport os
import pandas as pd
import charset_normalizer
def robust_read_csv(
file_path: str,
key_str_cols: list = None,
parse_dates: list = None
) -> pd.DataFrame:
"""
自适应物理编码与容错的数据导入核心函数
"""
if not os.path.exists(file_path):
raise FileNotFoundError(f"未找到目标文件: {file_path}")
# 1. 探测物理编码
with open(file_path, "rb") as f:
sample = f.read(20000)
detected = charset_normalizer.from_bytes(sample).best()
enc = detected.encoding if detected else "utf-8"
# 若推测为中文编码,直接升级为最全标准的 gb18030
if enc.lower() in ["gb2312", "gbk"]:
enc = "gb18030"
# 2. 构建类型锁定字典
dtype_dict = {col: str for col in key_str_cols} if key_str_cols else None
# 3. 稳健导入
df = pd.read_csv(
file_path,
encoding=enc,
dtype=dtype_dict,
parse_dates=parse_dates,
thousands=",",
on_bad_lines="skip",
low_memory=False
)
return df
# 生产调用示例
if __name__ == "__main__":
df_result = robust_read_csv(
"monthly_orders.csv",
key_str_cols=["order_sn", "customer_tel"],
parse_dates=["created_at"]
)
print(f"数据加载完成,有效条数: {len(df_result)}")
print(df_result.info())通过在数据入口处明确排查路径:编码层用工具嗅探加显式声明,格式层用稳健参数和类型锁定隔离异常,便能彻底根除 Python 数据导入过程中的各类顽疾,保障下游分析与模型构建的高效进行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









