

Python字符串切片返回空值的常见原因分析
深入分析Python字符串切片s[start:stop:step]返回空值的常见原因,涵盖步长方向冲突、负索引颠倒、越界静默截断及动态查找返回值异常等核心场景与系统排查方法。
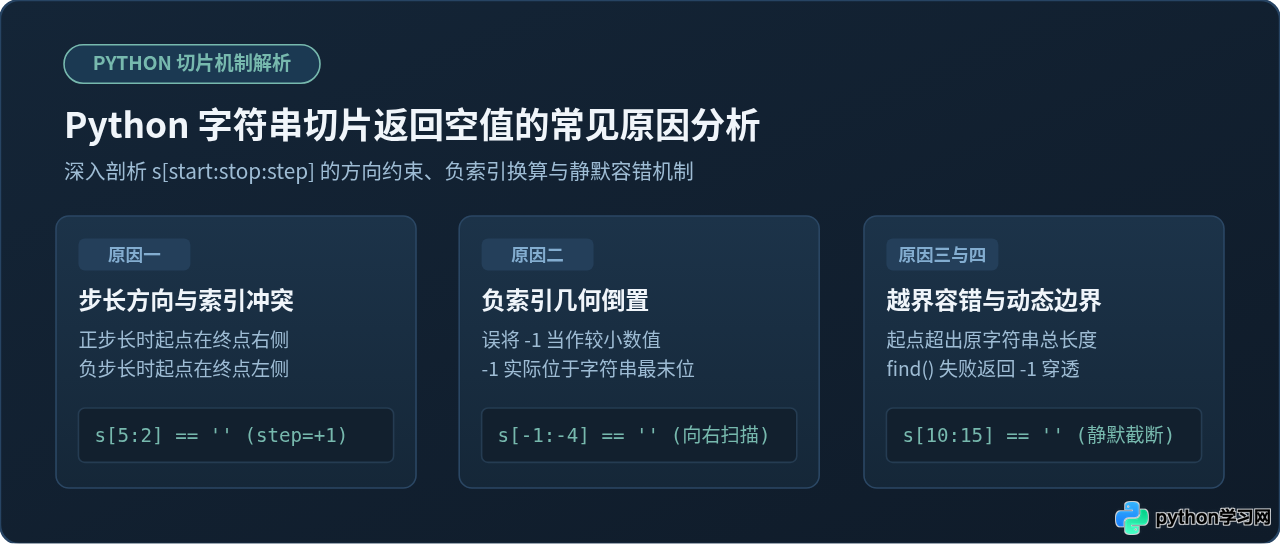
在处理文本解析或提取特定字段时,读者可能会遇到一种令人困惑的现象:代码顺利执行完成,没有触发预期的 IndexError,但拿到的目标字符串却是一个空值 ""。例如提取日志文件的时间戳后缀,或者尝试截取倒数几个字符时,变量悄无声息地变成了空串,直接导致下游逻辑无法获得有效输入。
这种现象源于 Python 切片机制内置的容错哲学。与单元素索引访问(例如 s[10])在越界时立即报错不同,字符串切片 s[start:stop:step] 采取了“尽力提取、异常判空”的设计原则。理解切片为何返回空值,关键在于掌握其内部指针的移动方向与边界校验逻辑。
一、核心原理:切片指针的推进方向与区间约束
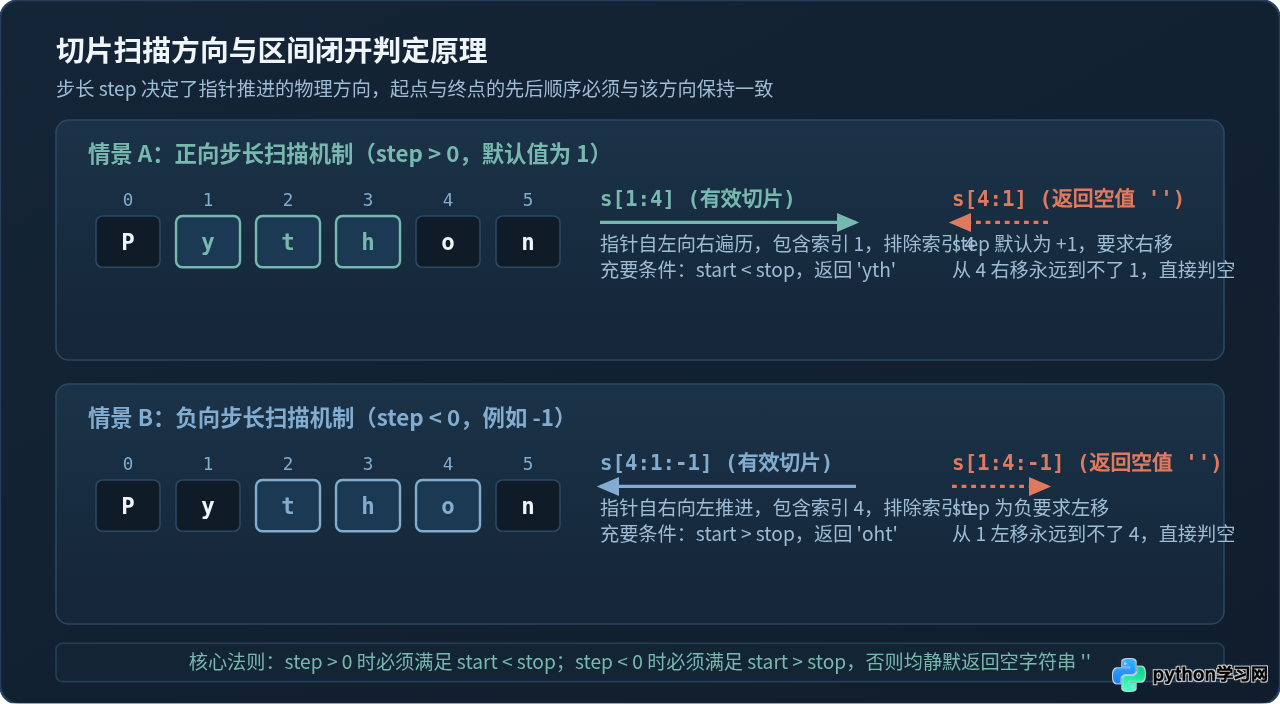
Python 字符串切片的完整语法为 s[start:stop:step],其中包含三个控制参数。当省略部分参数时,Python 会按以下默认值进行填充:
- 正向扫描模式(
step > 0或缺省step=1):start默认为 0,stop默认为len(s)。此时指针从左向右推进,切片区间遵循左闭右开原则[start, stop)。成立的基本条件是start < stop。 - 负向扫描模式(
step < 0):start默认为 -1(指向字符串末尾字符),stop默认为序列最左侧之前。此时指针从右向左推进。成立的基本条件是start > stop。
如果给定的起始位置与结束位置无法在指定步长所决定的几何方向上形成有效区间,Python 并不会报错,而是判定当前区间包含 0 个字符,直接返回空字符串 ""。
二、原因一:步长正负与索引先后顺序冲突
这是编写切片逻辑时最容易出现的失误。当需要从后向前反向提取字符时,如果忘记显式传入负步长,或者在提供了负步长后仍按从左往右的顺序书写起止索引,切片操作就会落空。
1. 反向截取未指定负步长
假设我们希望从字符串 "Python" 中提取索引 4 到索引 1 之间的字符(即倒序提取 'oht')。如果不指定步长,代码将按默认的正步长 step=1 执行:
s = "Python"
# 期望倒序提取索引 4 到索引 1 的字符,但未指定步长
result = s[4:1]

print("结果:", repr(result))
# 示例输出: 结果: ''原因解释:默认 step=1 决定了指针必须向右移动。起始点位于索引 4,而目标终止点位于索引 1(在 4 的左侧)。指针向右移动永远无法触达索引 1,因此循环直接终止,返回空字符串。
修正方法:显式将步长指定为 -1,即写为 s[4:1:-1],此时输出为 'oht'。
2. 提供了负步长,但起点仍在终点左侧
同理,当指定了负步长 step=-1 时,指针移动方向被设定为向左。如果起点小于终点,也会立即落空:
s = "Python"
# 步长为负数,但起点 1 位于终点 4 的左侧
result = s[1:4:-1]

print("结果:", repr(result))
# 示例输出: 结果: ''
三、原因二:负索引计算偏差与起点落后于终点
Python 支持从右向左计数的负索引,最后一个字符索引为 -1,倒数第二个为 -2。但在实际书写中,负数的数值直觉往往与字符串的物理空间顺序产生冲突。
常见的错误书写形如 s[-1:-4]。在数学上,-1 大于 -4;但在字符串布局中,-1 代表最右端的位置,而 -4 位于其左侧四个位置:
s = "Python"
# 索引映射:
#  P   y   t   h   o   n
# -6  -5  -4  -3  -2  -1

result = s[-1:-4]
print("结果:", repr(result))
# 示例输出: 结果: ''排查负索引切片时,可通过公式 real_idx = len(s) + neg_idx 将负索引统一还原为绝对非负索引。在长度为 6 的 "Python" 中:
-1转换为6 + (-1) = 5-4转换为6 + (-4) = 2
因此 s[-1:-4] 在内部等价于 s[5:2:1]。根据正步长规则,起点 5 大于终点 2,自然返回空值。
修正方案:若希望正向获取该区间字符,应将较小索引写在前面:s[-4:-1],返回 'tho';若确实需要倒序截取,则补充负步长:s[-1:-4:-1],返回 'noh'。
四、原因三:起始索引超出字符串长度(静默截断)
在通过索引读取单个字符时,超出字符串长度会抛出 IndexError: string index out of range。但切片机制为了保证链式操作与批量处理的稳定性,采取了静默截断策略。
当切片的起始索引大于或等于字符串总长度(start >= len(s))时,切片直接返回空字符串:
s = "cat"
print("字符串长度:", len(s))  # 3

# 起始索引 5 大于字符串实际长度
result = s[5:10]
print("切片结果:", repr(result))
# 示例输出: 切片结果: ''
这种特性在处理固定宽度报文或变长输入时极其隐蔽。如果数据流中偶尔出现少于预期长度的残缺字段,原本设计用来提取“第 5 到第 10 位”的代码不会抛错报警,而是将空值默默传递给后续代码,可能在很远的环节才引发类型或业务异常。
五、原因四:起止索引重合或动态查找未命中导致失效
由于切片是“左闭右开”区间 [start, stop),当 start == stop 时,该区间包含的有效字符个数为 0,必然返回空字符串:
s = "workflow"
print(repr(s[3:3]))
# 示例输出: ''
更棘手的情况来自动态计算索引。开发者常配合 str.find() 或 str.rfind() 来动态定位分隔符。当子字符串不存在时,find() 会返回 -1。如果不加校验直接把 -1 作为切片终点或起点,就会产生意想不到的空切片:
filename = "archive_backup"  # 注意:文件名中不包含点号 '.'

# 尝试获取点号之前的前缀
dot_pos = filename.find(".")   # 未找到,返回 -1

# 表达式实际上变成了 filename[0:-1]
# 原本期望获取全名,结果却丢失了最后一个字符
prefix = filename[0:dot_pos]

# 更典型的是截取分隔符之间的内容:
tag_start = filename.find("@")  # -1
tag_end = filename.find("#")    # -1
tag = filename[tag_start:tag_end]  # 变成 filename[-1:-1],直接返回空串 ''
print("tag 结果:", repr(tag))
# 示例输出: tag 结果: ''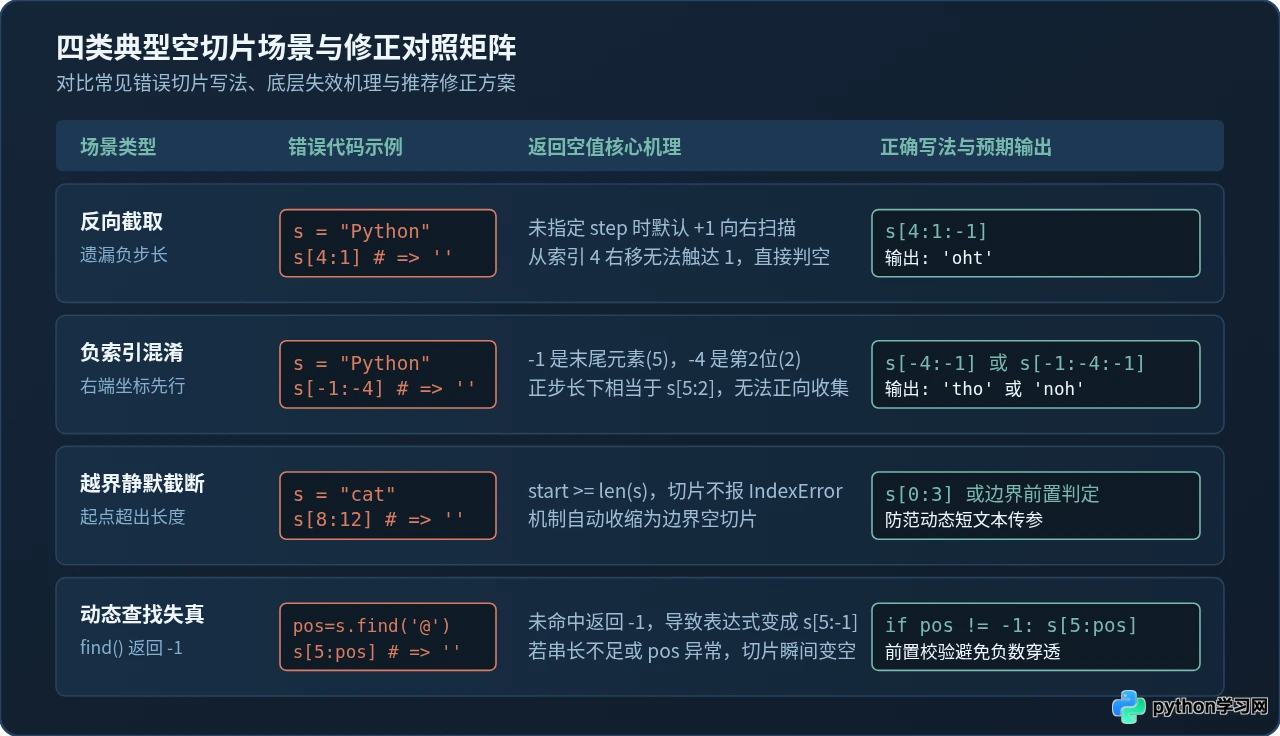
六、切片返回空值的系统排查与修复步骤
当发现数据处理流水线中切片结果意外为空时,可按以下标准化五步流程逐层排查与修复:
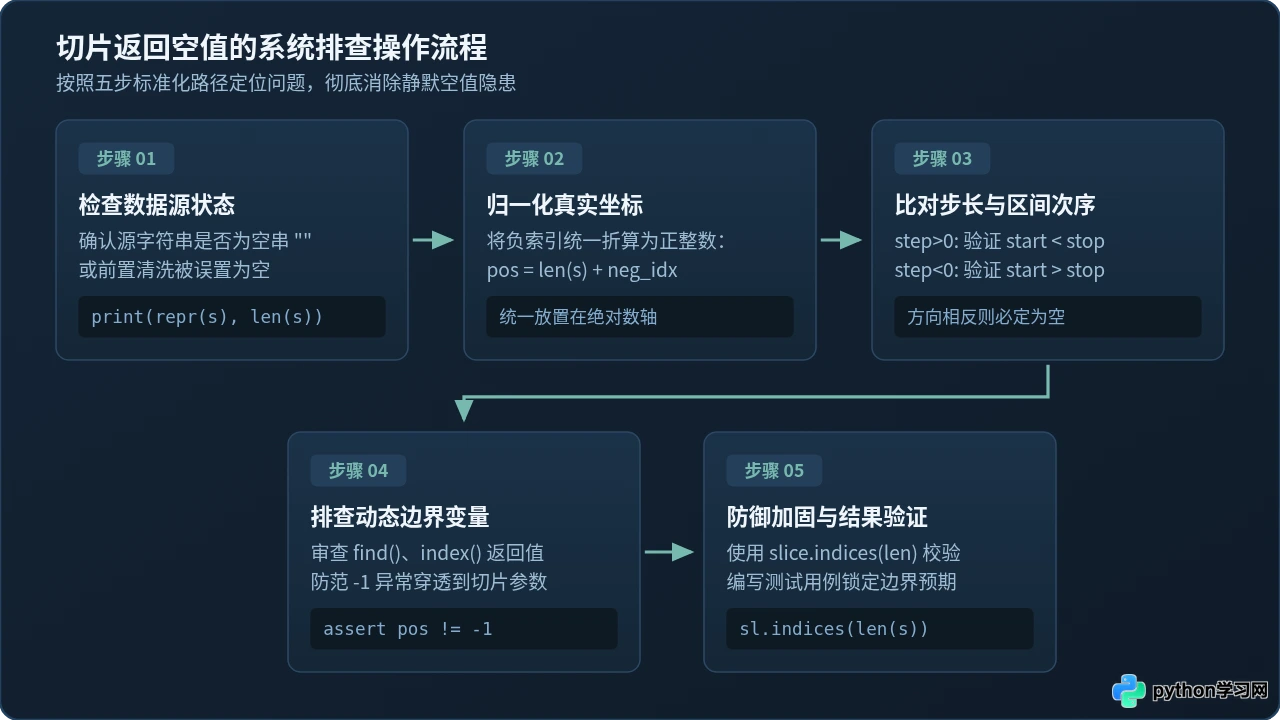
- 步骤一:检查源字符串状态
在切片前加入调试输出print(repr(s), len(s)),确认源对象本身是否原本就是空字符串"",或已被前置逻辑清洗剥离。 - 步骤二:归一化真实坐标
若参数中存在负数索引,利用公式len(s) + idx将其换算为非负整数坐标,将其投影在绝对坐标轴上观察相对位置。 - 步骤三:比对步长与区间次序
检查step的符号极性:- 若
step > 0(包含默认缺省),必须满足start < stop; - 若
step < 0,必须满足start > stop。
step符号。 - 若
- 步骤四:排查动态计算边界
检查所有参与切片计算的变量(如str.find()、正则匹配结果、偏移量相加),增加assert pos != -1或前置条件判断,杜绝-1穿透至切片参数。 - 步骤五:验证修复与防御加固
使用标准测试用例验证极限情况(包括空串、单字符串、刚好越界等边界输入),确保代码在各种长度下表现稳健。
七、防御性切片编写实践
为了让切片代码在生产环境中更健壮,建议在编写关键截取逻辑时采纳以下两项规范:
1. 全串反转规范写法
字符串反转不需要计算复杂的倒数起始索引,直接缺省起点与终点,利用 s[::-1] 即可安全遍历整个序列:
s = "Hello, World!"
reversed_s = s[::-1]
print(reversed_s)  # 示例输出: '!dlroW ,olleH'
2. 使用 slice 对象的 indices 方法规范化边界
Python 提供了原生的 slice 类。对于复杂的动态切片逻辑,可以调用 slice.indices(length) 方法,该方法能够根据传入的序列长度,自动将负索引、超出范围的索引和缺省值转换为标准的三元非负整数元组 (start, stop, step):
def safe_slice(text: str, start=None, stop=None, step=None) -> str:
    sl = slice(start, stop, step)
    # indices 接收字符串长度,返回合法转换后的 (start, stop, step)
    actual_start, actual_stop, actual_step = sl.indices(len(text))

    # 校验是否会产生有效提取
    if (actual_step > 0 and actual_start >= actual_stop) or \
       (actual_step < 0 and actual_start <= actual_stop):
        return ""

    return text[actual_start:actual_stop:actual_step]

# 测试越界与负数参数
sample = "Database"
print(repr(safe_slice(sample, -2, -6, -1)))  # 'saba'
print(repr(safe_slice(sample, 10, 20)))       # ''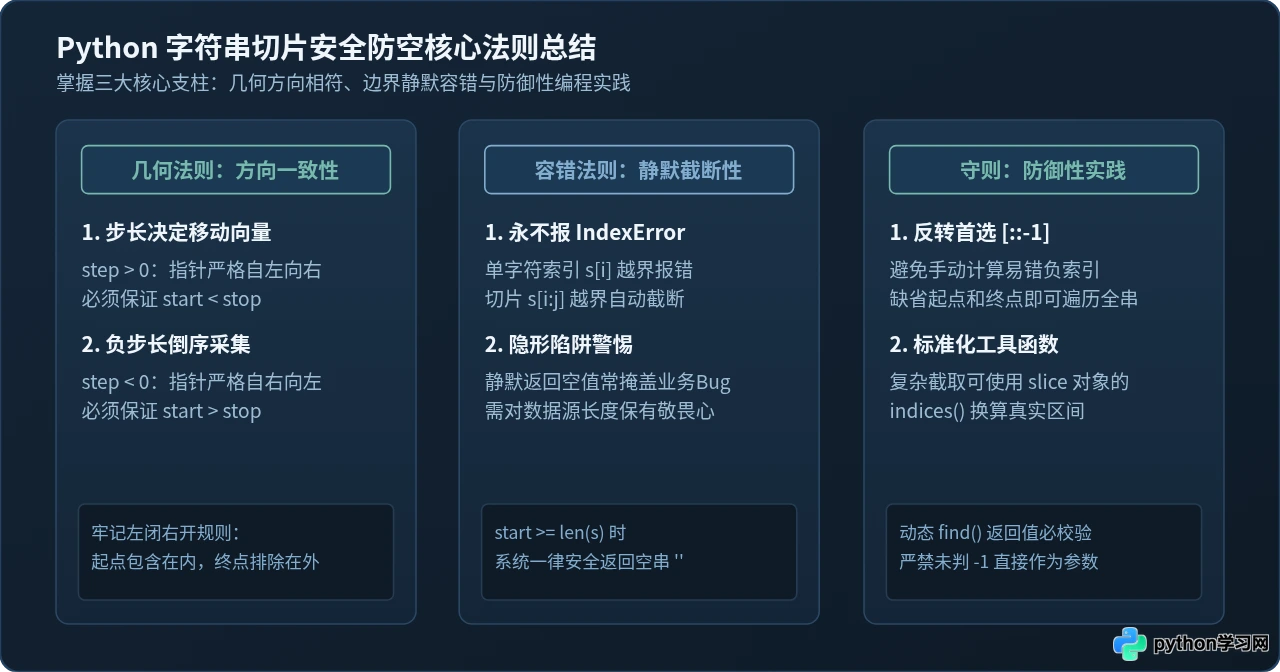
八、总结
Python 字符串切片返回空值并非运行时故障,而是语言规范中“区间判定与越界容错”机制的必然结果。排查此类问题的核心抓手是:
- 看步长符号:正步长向右要求
start < stop,负步长向左要求start > stop; - 防负索引错位:牢记
-1代表序列最右侧,向右扫描不可逾越; - 审视动态边界:防范
str.find()的-1穿透与非预期的短文本输入。
在设计字符串解析逻辑时,主动结合参数校验与边界换算,即可从根源上杜绝切片返回意外空值的隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









