

提升Python爬虫速度:aiohttp异步并发抓取实现指南
深入讲解如何使用 Python 标准库 asyncio 与第三方异步 HTTP 客户端 aiohttp 突破网络 I/O 阻塞瓶颈,通过非阻塞事件循环、信号量限流、连接池复用及异常容错设计,构建稳定高效的高并发抓取架构。
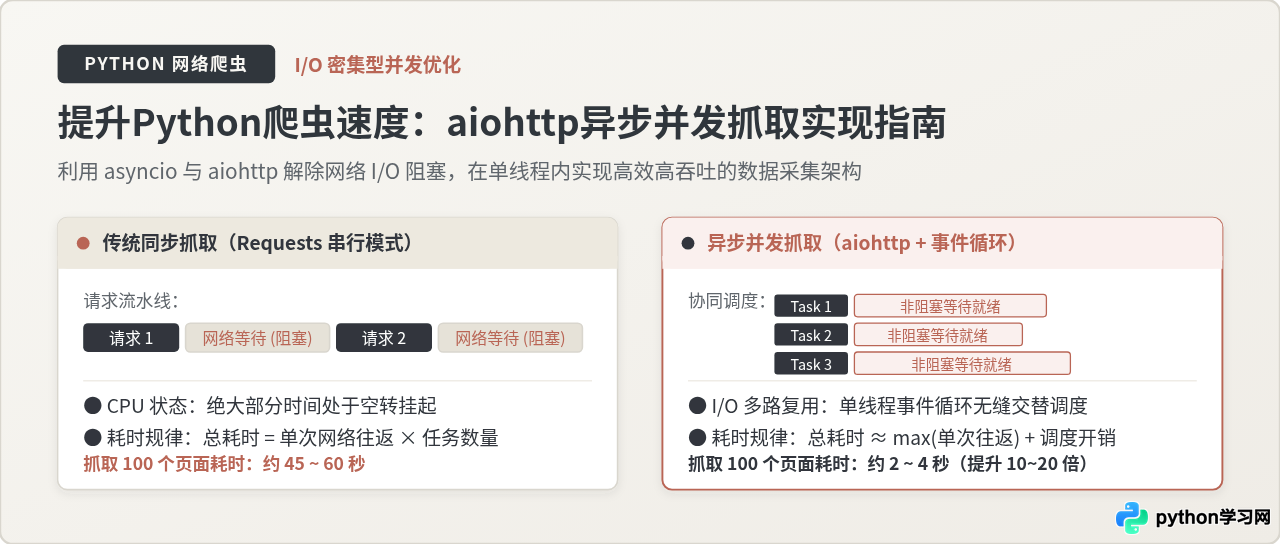
传统 Python 爬虫在面对成千上万个页面时,绝大部分耗时并非消耗在本地 CPU 解析上,而是浪费在等待目标服务器建立连接与返回数据的网络 I/O 阻塞中。通过 Python 原生标准库 asyncio 配合专门为异步网络设计的 aiohttp 客户端,可以在单个系统线程内实现轻量级协程并发调度,让程序在等待网络响应的同时持续处理其他请求,将成百上千次抓取的耗时从数十分钟压缩至几十秒。本文将完整介绍异步网络抓取的底层机理、标准五步实现范式、信号量控流策略以及规避生产环境事故的关键细节。
一、网络 I/O 瓶颈与异步协程工作机理
编写 Python 爬虫时,最为普及的工具是 requests 库。然而 requests 的底层网络调用是完全同步阻塞的:当执行 requests.get(url) 时,操作系统内核会将当前线程挂起,直到远端服务器完成 TCP 握手、HTTP 解析并将完整的响应字节流回传完毕,该函数才会返回。如果抓取 100 个页面,每个页面网络往返延迟为 0.5 秒,串行累加耗时至少需要 50 秒。
为了提升速率,许多初学者首先会尝试 concurrent.futures.ThreadPoolExecutor 多线程池。但在操作系统层面,每个操作系统原生线程都拥有独立的栈空间(默认通常为 8MB),创建数百个线程不仅耗尽系统内存,更会导致 CPU 在操作系统内核态与用户态之间频繁进行上下文切换,带来沉重的性能损耗。同时,受限于 CPython 的全局解释器锁(GIL),线程池在应对高并发连接时往往会在 50 到 100 个线程左右触碰天花板。
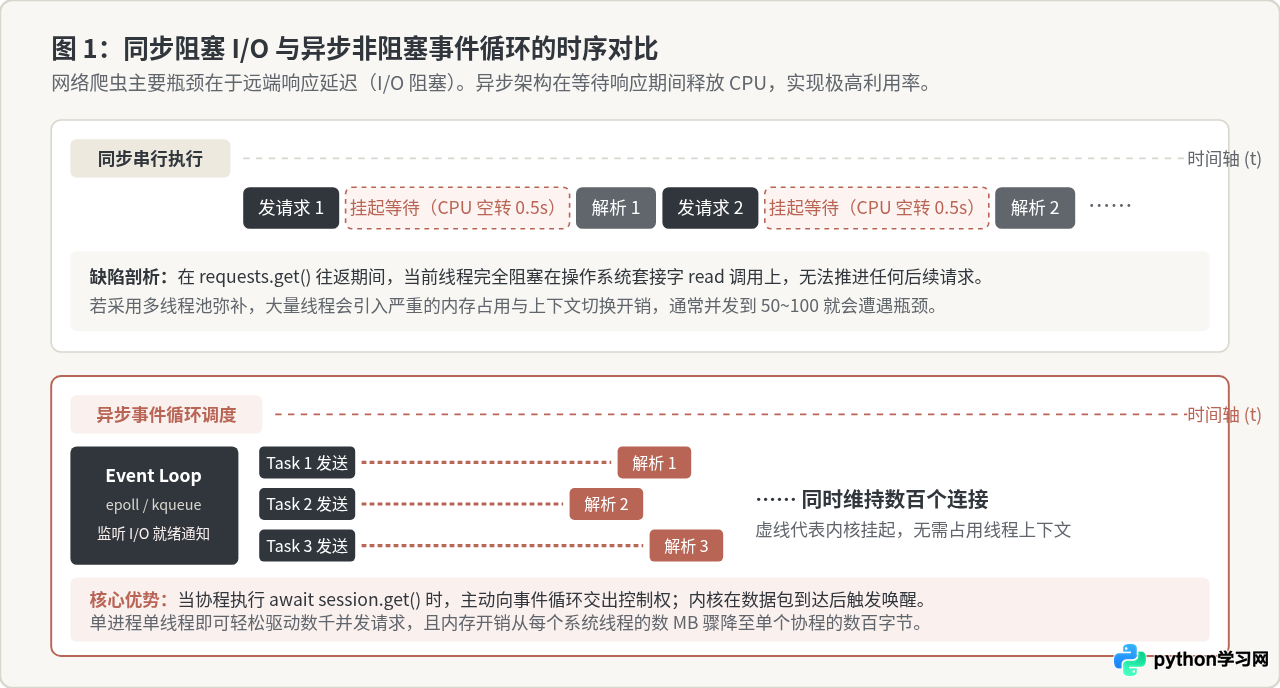
异步编程采用的是完全不同的工作模型。它运行在单进程单线程内,基于操作系统的多路复用机制(Linux 上的 epoll、macOS 上的 kqueue)。其运转逻辑包括三个核心事实:
- 协程(Coroutine)极其轻量:单个协程在 Python 中只是由事件循环跟踪的微型上下文对象,内存开销通常只有几百字节,在一台普通服务器上轻松驻留数万个协程而不会耗尽系统资源。
- 主动让渡 CPU:当协程执行到带有
await session.get()的语句时,它会向事件循环(Event Loop)注册套接字(Socket)等待通知,并主动暂停当前函数执行权。 - 非阻塞轮询唤醒:事件循环在这段等待时间内,可以立即调用其他就绪的协程发出后续请求。一旦网卡收到某个目标 URL 的响应数据包,内核触发就绪事件,事件循环立刻唤醒对应的协程继续执行结果解析。
aiohttp 协程处理,而将数据清洗解析提交给 ProcessPoolExecutor 进程池。
二、开发环境准备与 ClientSession 生命周期核心规范
使用 aiohttp 要求 Python 3.8 或更高版本。在终端中使用 pip 命令安装核心库:
# 终端安装命令
pip install aiohttp
在正式编写异步抓取逻辑前,必须明确 aiohttp.ClientSession 的用法规范。在传统的 requests 脚本中,开发者往往习惯在每个抓取函数内部随手调用 requests.get()。如果将这种思维生搬硬套到异步编程中:
# ⚠️ 严重反模式:千万不要在每个协程内部新建 ClientSession
async def bad_fetch(url):
    async with aiohttp.ClientSession() as session:
        async with session.get(url) as response:
            return await response.text()
上面的写法会导致每一个 URL 请求都单独创建并销毁一个独立的底层 TCP 连接池,完全丧失了 HTTP/1.1 的长连接复用(Keep-Alive)特性。不仅会导致每次请求都重复经历 TCP 三次握手与 TLS 证书协商,耗时增加数倍,更会在高并发时使本机操作系统堆积数以千计处于 TIME_WAIT 状态的套接字,最终抛出 OSError: [Errno 24] Too many open files。
正确规范:在整个爬虫运行周期中,应当保持 ClientSession 对象的全局单例或在主调度函数中作为顶层上下文管理器创建,然后将其作为参数传递给所有具体的子协程复用。
三、aiohttp 异步并发抓取标准实施流程
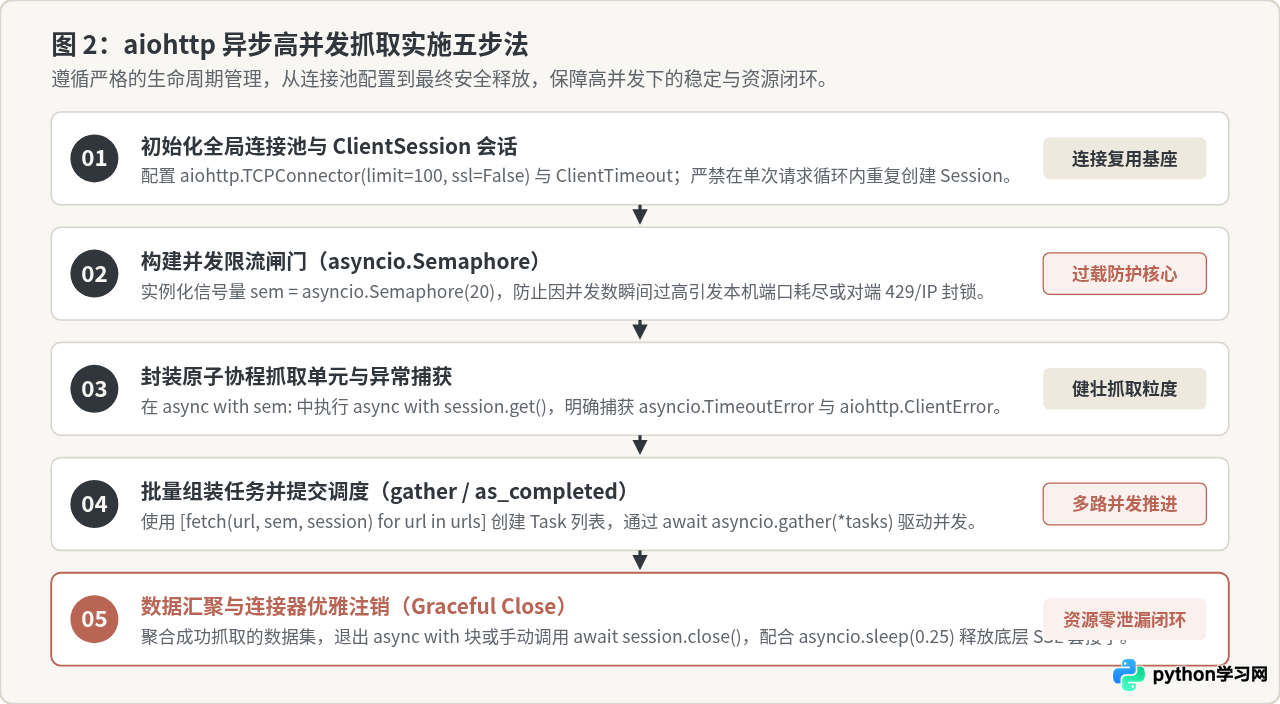
构建一套可执行、工业级健壮的异步爬虫,需要严格遵循规范的调用链条。下图梳理了从连接池配置、信号量限流、协程包装、任务分发到优雅关闭的完整五步实施流程:
完整可运行示例代码
下面是一个完整的并发抓取实现。该代码展示了信号量限制、单会话复用、超时配置以及并发任务调度的完整逻辑:
import asyncio
import aiohttp
import time
from typing import List, Optional

# 步骤 3:封装原子协程抓取单元
async def fetch_url(
    url: str,
    sem: asyncio.Semaphore,
    session: aiohttp.ClientSession
) -> Optional[dict]:
    # 通过信号量申请并发配额槽位
    async with sem:
        try:
            async with session.get(url) as resp:
                if resp.status == 200:
                    text = await resp.text()
                    return {"url": url, "status": 200, "length": len(text)}
                else:
                    return {"url": url, "status": resp.status, "length": 0}
        except asyncio.TimeoutError:
            # 超时异常处理
            return {"url": url, "status": "timeout", "length": 0}
        except aiohttp.ClientError as e:
            # 网络连接层故障(如 DNS 失败、连接重置)
            return {"url": url, "status": "client_error", "error": str(e)}

# 主调度与生命周期管理
async def main(target_urls: List[str]):
    # 步骤 1:配置连接池与超时
    timeout_cfg = aiohttp.ClientTimeout(total=15, connect=5)
    connector = aiohttp.TCPConnector(limit=100, limit_per_host=30, ssl=False)

    # 步骤 2:设置并发闸门(限制同时在飞的请求数量)
    concurrency_limit = 20
    sem = asyncio.Semaphore(concurrency_limit)

    headers = {{
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }}

    # 顶层 Context Manager,全局单例会话
    async with aiohttp.ClientSession(connector=connector, timeout=timeout_cfg, headers=headers) as session:
        # 步骤 4:批量组装任务
        tasks = [fetch_url(u, sem, session) for u in target_urls]

        # 驱动所有协程并发运转并收集结果
        start_time = time.perf_counter()
        results = await asyncio.gather(*tasks, return_exceptions=True)
        elapsed = time.perf_counter() - start_time

        # 步骤 5:结果统计输出
        success_count = sum(1 for r in results if isinstance(r, dict) and r.get("status") == 200)
        print(f"完成 {{len(target_urls)}} 个 URL 抓取,成功: {{success_count}},总耗时: {{elapsed:.2f}} 秒")
        return results

if __name__ == "__main__":
    # 生成演示目标 URL 列表(实际使用时替换为目标站点)
    urls = [f"https://httpbin.org/delay/1" for _ in range(50)]
    asyncio.run(main(urls))
示例执行过程剖析:上面提交了 50 个每个耗时约 1 秒的延迟测试请求。如果使用传统的 requests 串行请求,需要依次耗时 50 秒以上;但在上述异步并发结构中,由于配置了 Semaphore(20),系统以 20 个请求为一组并发推进,总耗时仅需大约 2.5 ~ 3 秒即可完成全部 50 个请求,抓取吞吐效率提升了 15 倍以上。
四、关键细节:并发控制与连接池管理机制
很多开发者在初尝异步带来的速度优势后,容易犯下一个极端错误:试图将几千甚至数万个任务直接全部扔进 asyncio.gather(*tasks) 中,且不设置任何并发上限。这种“裸奔并发”必然会遭遇如下灾难:
- 本地资源耗竭:瞬时向内核申请数千个 TCP 套接字,超出操作系统的文件描述符上限(File Descriptors Limit),直接抛出致命崩溃。
- 触发远端熔断:瞬时的大规模连接冲击会触发目标站点的 WAF(Web 应用程序防火墙)保护机制,返回
429 Too Many Requests、403 Forbidden或直接拉黑本机 IP 地址。
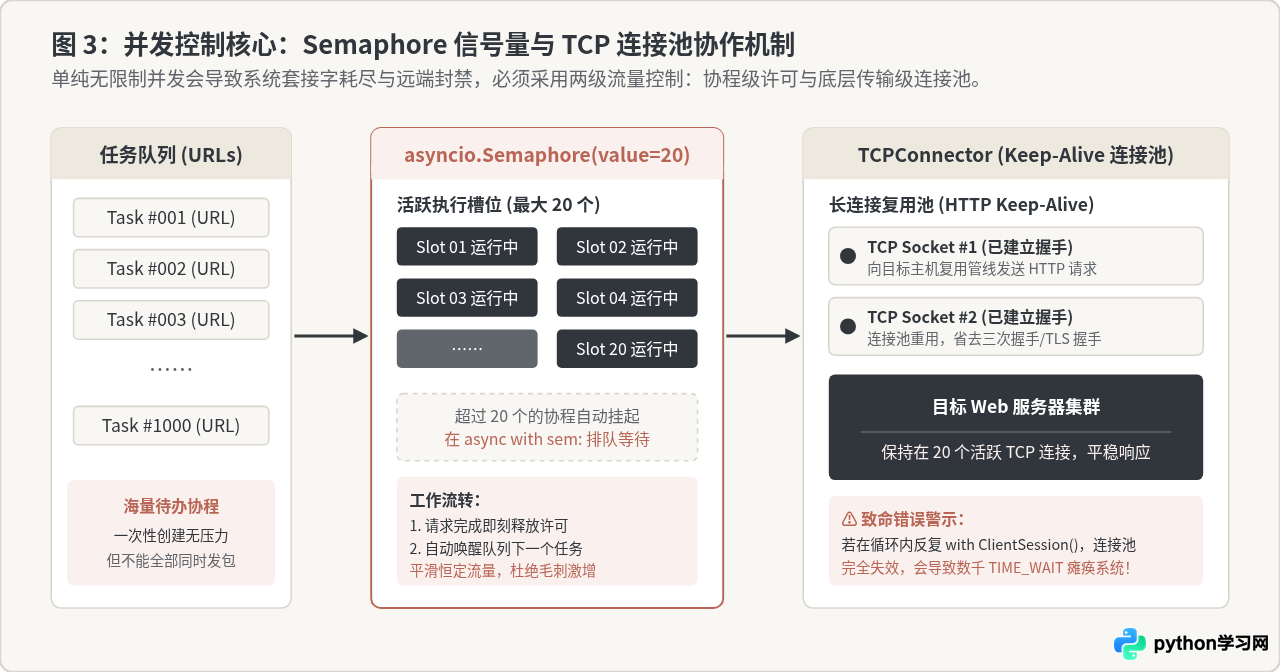
为了实现稳定可控的高并发,必须在代码中构建两层缓冲控制机制:
1. 协程层限流:asyncio.Semaphore
信号量(Semaphore)内部维护一个原子计数器。初始化为 20 时,表示同时只允许 20 个协程进入 async with sem: 保护区。当第 21 个任务尝试进入时,它会在该代码行被事件循环自动挂起;每当有一个处于保护区内的任务抓取完成并退出上下文时,计数器加 1,并自动唤醒排在队首的一个挂起任务。这种“恒定流量窗口”能够平滑抹平网络冲击波,既发挥并发能力,又保护本地与目标服务器。
2. 传输层复用:TCPConnector 参数调优
在初始化 ClientSession 时,通过显式传入自定义的 TCPConnector 实例来精细控制底层网络行为:
| 参数名 | 推荐典型值 | 具体作用与控制目的 |
|---|---|---|
limit |
100 | 整个 Connector 允许同时保持的底层 TCP 连接总数上限。 |
limit_per_host |
20 ~ 30 | 限制对同一个域名(主机)允许建立的最大并发连接数,防止单点打满目标服务器。 |
ssl |
False / ssl_context | 若抓取非敏感公开内容且遭遇远端不合规证书报错时,可显式指定 ssl=False 忽略证书校验,大幅降低 TLS 握手计算耗时。 |
enable_cleanup_closed |
True | 在长时间运行的爬虫进程中,定期清理处于关闭状态的底层传输连接,防止隐匿的内存泄露。 |
五、健壮性工程设计:超时、重试与异常分流
在大规模网页抓取任务中,网络波动与死链是绝对必然发生的常态。如果未对异常进行细粒度隔离,一个失败的请求便可能导致整个 asyncio.gather 异常中断退出。
1. 细致配置超时时长
aiohttp 默认的全局超时时间为整整 300 秒(5 分钟)。如果目标服务器因故挂起而没有主动断开连接,爬虫就会默默等待 5 分钟,长时间霸占一个信号量槽位。因此,必须显式定义 ClientTimeout:
# 精确拆分连接超时与读取超时
timeout = aiohttp.ClientTimeout(
    total=20,     # 单个请求全过程(含排队与完整数据接收)的最大总耗时
    connect=5,    # 建立 TCP 握手的最大等待时间
    sock_read=10  # 套接字在两次数据包到达之间的最大读取等待间隔
)
2. 指数退避重试装饰器
对于偶发性的超时与 502/503 临时服务端错误,可以通过简单的异步重试机制提高抓取成功率:
async def fetch_with_retry(url, sem, session, max_retries=3):
    for attempt in range(1, max_retries + 1):
        try:
            async with sem:
                async with session.get(url) as resp:
                    if resp.status == 200:
                        return await resp.text()
                    elif resp.status in [429, 502, 503, 504]:
                        # 遇到限流或服务端波动,等待后重试
                        await asyncio.sleep(attempt * 1.5)
                        continue
                    else:
                        # 遇到 404 等客户端确定性错误,直接退出无需重试
                        return None
        except (asyncio.TimeoutError, aiohttp.ClientError):
            if attempt == max_retries:
                return None
            await asyncio.sleep(attempt * 1.5)
六、生产环境避坑清单与关闭治理
将 aiohttp 爬虫部署到生产服务器或后台定时任务时,以下四个维度的设计要点直接决定了程序的稳定性与系统的健康度:
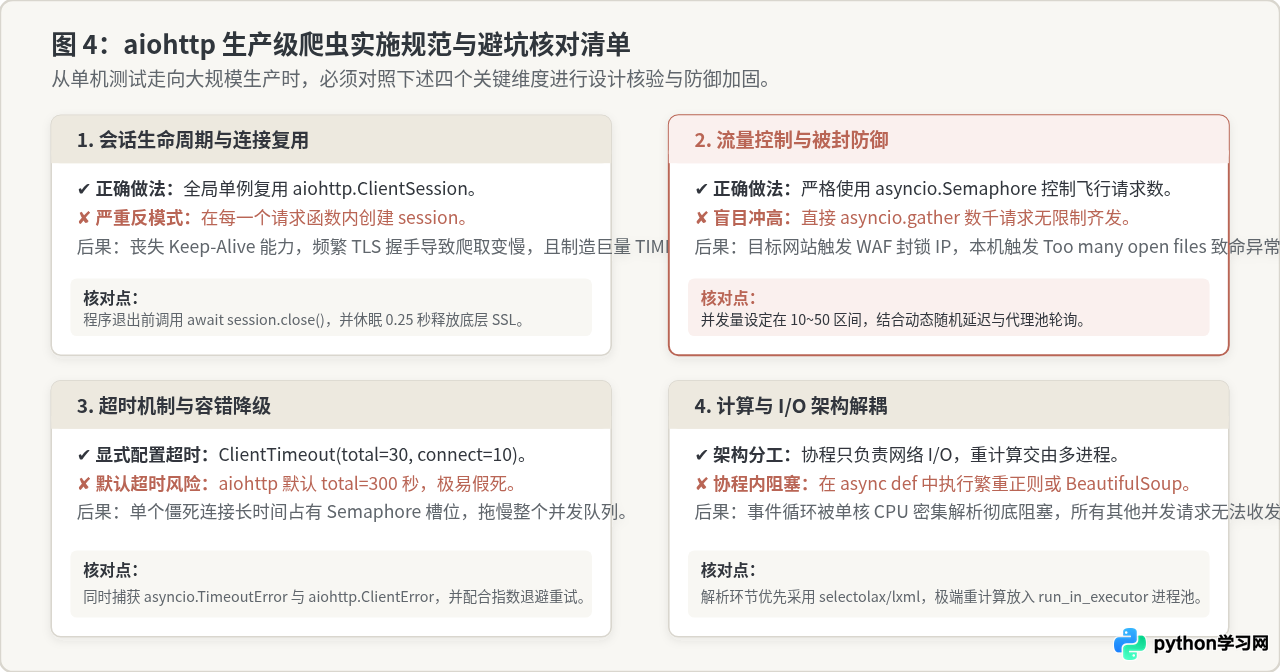
1. 规避 “Unclosed client session” 告警与安全退出
如果在 Python 程序退出时没有妥善关闭 session,终端通常会打印刺眼的红字警告:Unclosed client session / Unclosed connector。这不仅影响日志整洁,还意味着底层仍有未完成挥手的套接字处于游离状态。
根治方案:确保在退出事件循环前显式等待 session 关闭,并在使用 SSL 时额外休眠 0.25 秒,以便底层操作系统 SSL 传输通道完成 FIN 报文挥手闭环:
# 推荐的会话收尾保护写法
async def run_crawler():
    session = aiohttp.ClientSession()
    try:
        # 执行实际爬虫任务……
        pass
    finally:
        await session.close()
        # 等待 asyncio 内部底层 SSL 传输完成清理
        await asyncio.sleep(0.25)
2. 数据流式读取,杜绝内存膨胀
当抓取大文件、PDF 或超长 JSON API 时,直接调用 await resp.text() 或 await resp.read() 会将整个响应体一次性全量加载进内存。并发 50 个大文件下载时,内存会迅速被撑爆导致 OOM(Out Of Memory)。
面对海量大响应,应当使用流式迭代器(Streaming)分块处理并落盘:
async with session.get(large_file_url) as resp:
    with open("output.bin", "wb") as f:
        async for chunk in resp.content.iter_chunked(64 * 1024):
            f.write(chunk)
七、核心总结
利用 aiohttp 提升 Python 爬虫性能的本质,是用极低开销的协程协同,榨干网络 I/O 阻塞期间被白白闲置的 CPU 调度能力。在具体工程实践中,务必牢记以下核心守则:
- 单例复用连接池:维持唯一的
ClientSession对象,彻底发挥 HTTP Keep-Alive 连接复用优势。 - 严设信号量限流:通过
asyncio.Semaphore主动平滑出站流量,杜绝本地端口枯竭与对端 WAF 封禁。 - 精确拆解超时粒度:废弃 300 秒默认设置,将连接与读取超时控制在可预期阈值内,配合退避重试隔离慢速僵尸节点。
- 计算与 I/O 职责分离:复杂的 HTML 解析交给快速解析器或多进程执行,防止 CPU 密集型任务阻断异步事件循环的主脉搏。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









