

Python数据分析入门:Pandas与NumPy核心库学习路线
面向Python数据分析初学者的实操路线指南,拆解NumPy数组计算与Pandas表格处理的核心知识分工、关键API用法与端到端清洗分析流程。
掌握Python数据分析的关键不是通读所有API手册,而是建立一条以NumPy为底层数值基础、以Pandas为核心表格操作工具的渐进式应用路径。本文明确划分两个库的分工边界,给出从基础结构、切片索引、数据清洗到综合聚合分析的具体操作规范与验证示例,帮助初学者在最短时间内具备处理真实表格数据的工程能力。
第一阶段:理解NumPy与Pandas的核心分工
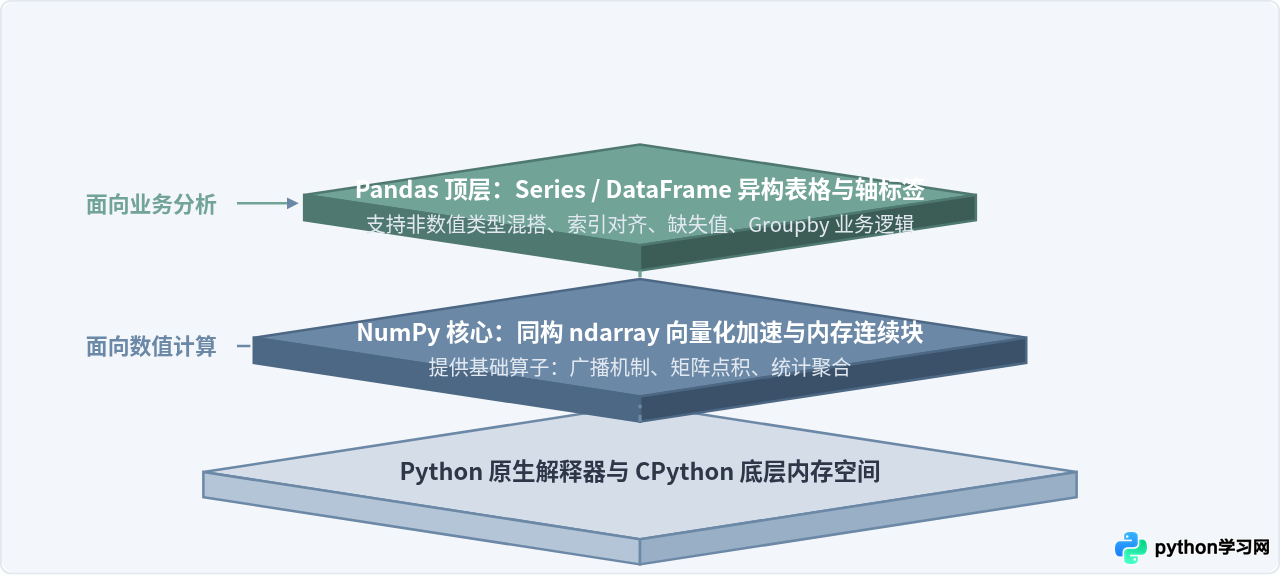
初学者容易产生一个疑问:既然Pandas能读写表格并进行统计计算,为什么还要花精力学习NumPy?要理解两者的关系,需要从数据底层和应用场景来观察它们的依赖结构。
NumPy的核心是ndarray(N维数组),它要求数组内所有元素具备完全相同的原生数据类型(如全为float64或int32)。这种紧凑的连续内存布局摒弃了Python原生列表的指针寻址开销,使向量化算术与线性代数计算能直接调用底层C与BLAS优化指令。但ndarray缺乏元数据描述能力,没有行标签,也不适合直接处理多类型混杂的现实业务数据。
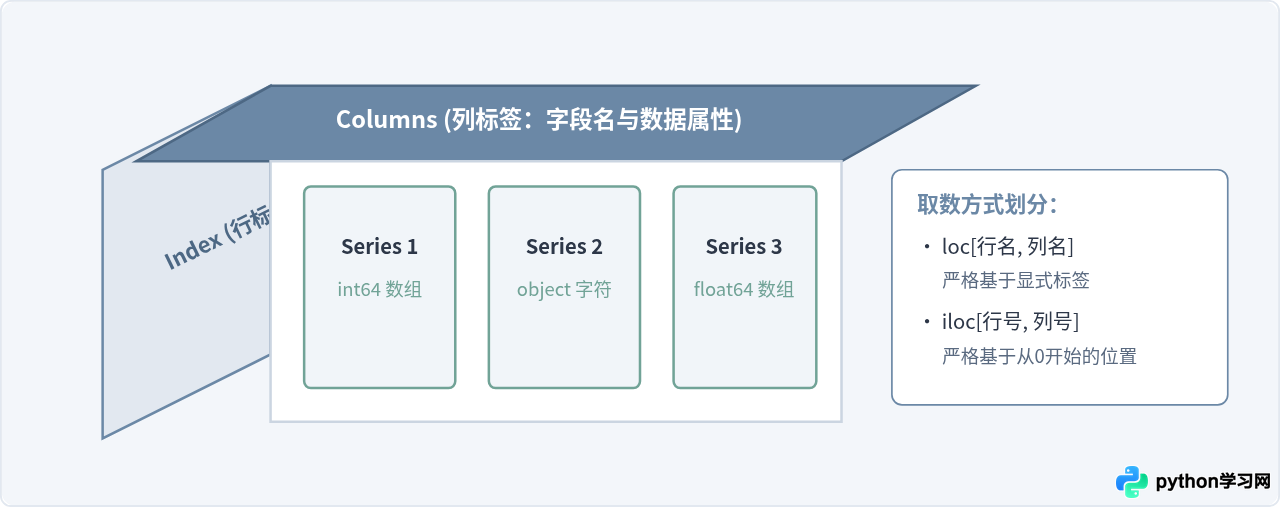
Pandas则是建立在NumPy之上的高级封装。它的核心数据结构DataFrame本质上是由多个等长的NumPy数组构成的列集合,并在此基础上增加了行索引(Index)和列名标签(Columns)。Pandas接管了杂乱数据的对齐、缺失值处理、时间序列和文本清洗等日常任务,而在底层进行数值算术时,依然交由NumPy的高性能算子执行。
第二阶段:NumPy必备技能清单与实操
学习NumPy不需要背诵全部数学函数,初学者只需要掌握三个核心能力:创建多维数组、理解广播机制(Broadcasting)、以及掌握布尔条件过滤。
1. 数组构造与形态变换
日常分析中经常需要将列表转为矩阵或构造基准网格。最常用的是np.array()、np.arange()和reshape()。
import numpy as np

# 构造一个 2 行 3 列的二维浮点数组
matrix = np.arange(1, 7, dtype=float).reshape(2, 3)
print("原始矩阵:\n", matrix)
print("形状属性:", matrix.shape)
print("数据类型:", matrix.dtype)
示例输出:
原始矩阵:
 [[1. 2. 3.]
 [4. 5. 6.]]
形状属性: (2, 3)
数据类型: float64
2. 广播机制(Broadcasting)的运算规则
广播允许不同形状的数组在特定规则下进行算术运算,避免手动书写双重循环。其核心规则是:两个数组在各个维度上对齐时,如果该维度的长度相等,或者其中一个维度的长度为1,则可以执行运算;否则报错。
# 2x3 矩阵加上一个 1x3 的一维数组
weights = np.array([10.0, 20.0, 30.0])
result = matrix + weights
print("广播相加结果:\n", result)
示例输出:
广播相加结果:
 [[11. 22. 33.]
 [14. 25. 36.]]
3. 布尔索引与向量化条件截取
在NumPy中筛选数据不要使用if-else遍历数组,而应直接在方括号内传入条件表达式:
# 筛选出大于 3 的所有元素并重新赋值
mask = result > 20
print("布尔掩码:\n", mask)
print("符合条件的元素:", result[mask])

# 向量化替换:将小于等于 20 的替换为 0,其余保留
cleaned = np.where(result > 20, result, 0)
print("条件替换结果:\n", cleaned)NumPy的基础切片(如
sub = matrix[0, :])返回的是原数组的视图(View),修改sub的值会导致原始matrix的值同步被修改。如果需要脱离关联,必须显式调用sub = matrix[0, :].copy()生成副本。
第三阶段:Pandas数据重塑与核心检索
当数据进入带有字段名、交易ID或非数值标记的阶段时,需要全面转入Pandas。掌握Pandas的第一步是彻底厘清loc与iloc的选择边界。
1. Series与DataFrame的组织形式
Series是一维带标签数组,DataFrame是二维二维表格。每个表格具备两个轴:行轴(index,axis=0)与列轴(columns,axis=1)。
2. 精确数据定位:loc 与 iloc 的区别
在日常脚本中,混淆显式标签和物理序号是导致KeyError与数据覆盖最常见的根源。以下为标准对照代码:
import pandas as pd

df = pd.DataFrame({
    'item': ['Monitor', 'Keyboard', 'Mouse', 'Desk'],
    'price': [1200.0, 150.0, 80.0, 600.0],
    'stock': [15, 40, 60, 5]
}, index=['p1', 'p2', 'p3', 'p4'])

# 方式一:基于显式标签 loc (包含切片右端点)
subset_loc = df.loc['p1':'p3', ['item', 'price']]

# 方式二:基于物理序号 iloc (左闭右开,不含右端点)
subset_iloc = df.iloc[0:2, 0:2]

print("loc 提取结果:\n", subset_loc)
print("\niloc 提取结果:\n", subset_iloc)
示例输出:
loc 提取结果:
         item   price
p1   Monitor  1200.0
p2  Keyboard   150.0
p3     Mouse    80.0

iloc 提取结果:
         item   price
p1   Monitor  1200.0
p2  Keyboard   150.0
第四阶段:真实场景下的数据清洗与分析执行流程
从纯净教程跳入真实业务场景,数据往往伴随着空值、字符串夹杂空格、错误类型等问题。必须通过规范的4步流程进行清洗与提取。
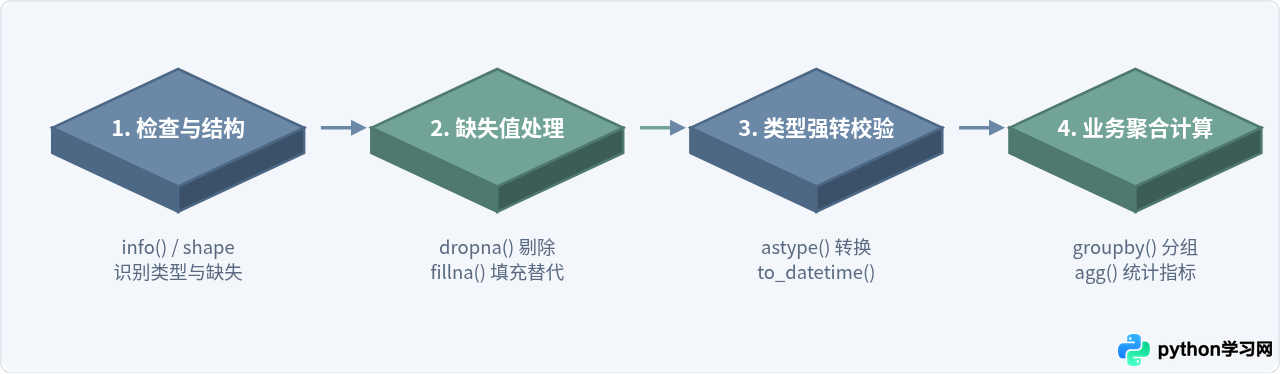
以下为一个端到端清洗与聚合统计的完整代码示例,模拟包含脏数据的订单明细处理:
import pandas as pd
import numpy as np

# 构造含有缺失值和类型异常的原生数据
raw_data = {
    'order_id': ['1001', '1002', '1003', '1004', '1005'],
    'dept': ['East', 'West', 'East', 'North', np.nan],
    'revenue': ['240.5', '180.0', np.nan, '520.0', '310.2'],
    'return_flag': [0, 1, 0, 0, 0]
}
df_orders = pd.DataFrame(raw_data)

# 步骤 1:填充或丢弃空值
# 对部门为空的记录进行剔除,收入为空的使用中位数填充
df_orders = df_orders.dropna(subset=['dept']).copy()

# 步骤 2:字段类型转换
# revenue 当前为 object 字符串,需要转为浮点型以供统计
df_orders['revenue'] = df_orders['revenue'].astype(float)
median_val = df_orders['revenue'].median()
df_orders['revenue'] = df_orders['revenue'].fillna(median_val)

# 步骤 3:业务派生列(利用 NumPy 高效判定)
# 如果营收超过 200 且未退货,标记为有效重点订单
df_orders['is_key'] = np.where(
    (df_orders['revenue'] > 200) & (df_orders['return_flag'] == 0),
    True,
    False
)

# 步骤 4:多维度聚合
summary = df_orders.groupby('dept').agg(
    order_count=('order_id', 'count'),
    total_revenue=('revenue', 'sum'),
    avg_revenue=('revenue', 'mean')
).reset_index()

print("清洗后的明细:\n", df_orders)
print("\n部门汇总报表:\n", summary)
示例输出:
清洗后的明细:
   order_id   dept  revenue  return_flag  is_key
0     1001   East    240.5            0    True
1     1002   West    180.0            1   False
2     1003   East    210.25           0    True
3     1004  North    520.0            0    True

部门汇总报表:
     dept  order_count  total_revenue  avg_revenue
0   East            2         450.75       225.375
1  North            1         520.00       520.000
2   West            1         180.00       180.000
第五阶段:学习进阶全景与检查标准
掌握了上述核心链路后,初学者应当有针对性地验收当前掌握水平,并把后续进阶目标放在性能优化与多表关联上,而不是盲目刷题。
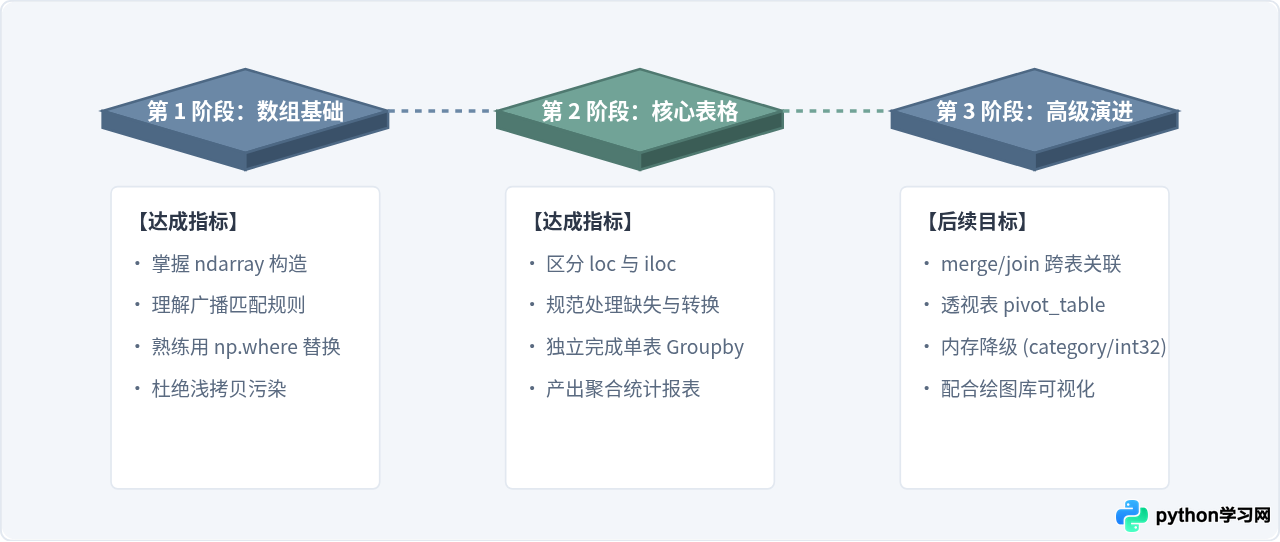
判断本路线学习是否达标的标准非常具体:当你拿到一份几十兆的CSV文件时,能够不再使用任何原生的Python for 循环,而是完全依靠NumPy的广播算子和Pandas的向量化链式调用完成读取、排查脏数据、处理缺失值并输出统计摘要。此时,你已经跨过了数据分析最核心的工程门槛。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









