

Python数据分析常用库:Pandas与NumPy核心函数速查
全面梳理Python数据分析两大基石库NumPy与Pandas的核心高频函数与实战语法,深入辨析轴向定义、切片索引、视图与副本等常见易混点,并提供标准分析流水线与全景速查图解。
在Python数据科学体系中,NumPy与Pandas构成了最核心的数据处理基座。NumPy专注于底层连续内存的高性能同质数值计算,而Pandas则在上层封装了带行/列索引标签的异质结构化表格。日常数据分析中超过80%的业务逻辑均由两者的核心函数协作完成。本文旨在系统提炼两大库的高频核心函数,梳理标准分析流水线,并针对轴向定义、切片索引及副本机制等易混淆误区提供具体辨析与可复现的代码示例。
一、底层定位与核心数据架构解析
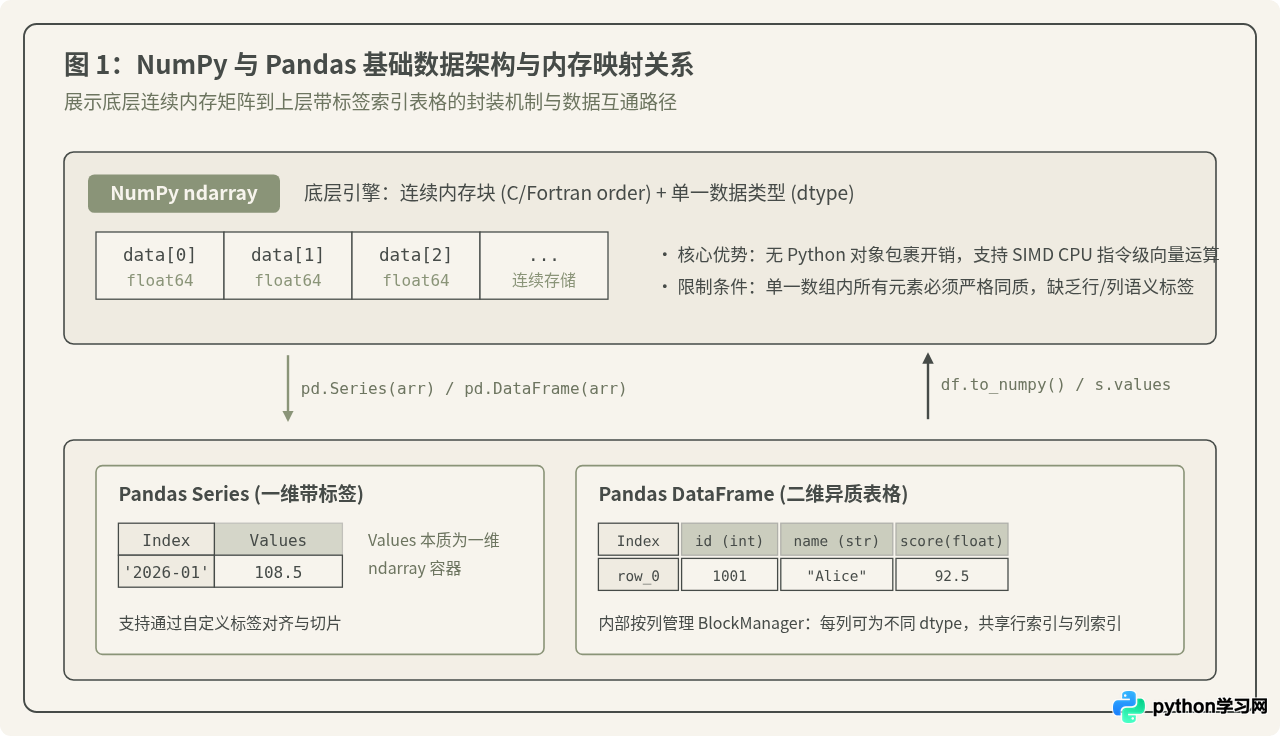
理解NumPy与Pandas的协作关系,首先需要看清它们在内存与抽象层级上的差异。NumPy的核心是ndarray(N-dimensional Array),它在连续的C或Fortran内存块中存储单一类型(如float64或int32)的数据。由于没有Python对象的额外指针包裹开销,底层可以直接调用SIMD指令集进行极速向量化运算。
而Pandas的核心对象为Series(一维带标签数据)和DataFrame(二维异质表格)。DataFrame的本质是多个长度相同、共享行索引的Series的集合。在其内部,Pandas使用BlockManager将相同数据类型的列合并管理,其底层的每一列数值数组依然由NumPy的ndarray驱动。
1. 常用对象创建与属性检查
在工程实践中,以下函数用于快速构造初始数组或查看数据维度与类型属性:
Python代码示例:对象构建与结构检视import numpy as np
import pandas as pd
# 1. NumPy 核心数组生成
arr_1d = np.array([10, 20, 30], dtype=np.float64)
arr_zeros = np.zeros(shape=(3, 4), dtype=np.float32) # 3行4列全零矩阵
arr_range = np.arange(0, 10, 2) # array([0, 2, 4, 6, 8])
arr_lin = np.linspace(0.0, 1.0, num=5) # 生成5个等间距采样点
# 2. Pandas DataFrame 构建
data = {
'user_id': [101, 102, 103],
'category': ['Tech', 'Design', 'Tech'],
'score': [88.5, 94.0, 79.5]
}
df = pd.DataFrame(data, index=['u1', 'u2', 'u3'])
# 3. 维度与类型检视
print(arr_zeros.shape) # 示例输出: (3, 4)
print(arr_zeros.dtype) # 示例输出: float32
print(df.dtypes) # 查看各列具体类型
print(df.shape) # 示例输出: (3, 3)二、NumPy 核心函数与向量化运算
NumPy的核心优势在于“消除显式循环”。通过内置通用函数(ufunc)和向量化操作,对整个数组的数学运算能够以底层编译语言的速度执行。
1. 形状重塑与多维操作
改变数据形状而不发生深层内存拷贝是NumPy的拿手绝活。
arr.reshape(m, n):在元素总数恒定前提下重构形状,返回原数组的视图(View)。若传入-1,NumPy将自动推算该轴的长度。arr.ravel()与arr.flatten():两者均将多维数组展平为一维。核心区别在于ravel()优先返回原数组视图,无额外内存开销;而flatten()必然分配新内存并返回独立副本。np.expand_dims(arr, axis):在指定轴插入长度为1的新维度,常用于多维张量形状对齐与矩阵广播。
2. 数值统计与条件分支函数
Python代码示例:NumPy 高频运算与条件替换arr = np.array([[12, 45, 78],
[34, 89, 23]])
# 统计聚合函数
val_sum = np.sum(arr, axis=0) # 示例输出: array([ 46, 134, 101])
val_mean = np.mean(arr, axis=1) # 示例输出: array([45., 48.66666667])
idx_max = np.argmax(arr, axis=1) # 示例输出: array([2, 1]) 返回极大值所在列位置
# 条件截断与三元分支
clipped = np.clip(arr, a_min=20, a_max=80) # 小于20替换为20,大于80替换为80
flagged = np.where(arr >= 50, 'High', 'Low') # 示例输出: [['Low', 'Low', 'High'], ['Low', 'High', 'Low']]
当对两个形状不同的数组进行二元算术运算时,NumPy从末尾维度(即最右侧)向前逐一对比尺寸。两个维度兼容需满足以下两个条件之一:
维度数值严格相等,或者其中一个维度长度为1。若都不满足,则抛出ValueError: operands could not be broadcast together。
三、Pandas 核心处理流水线与高频函数
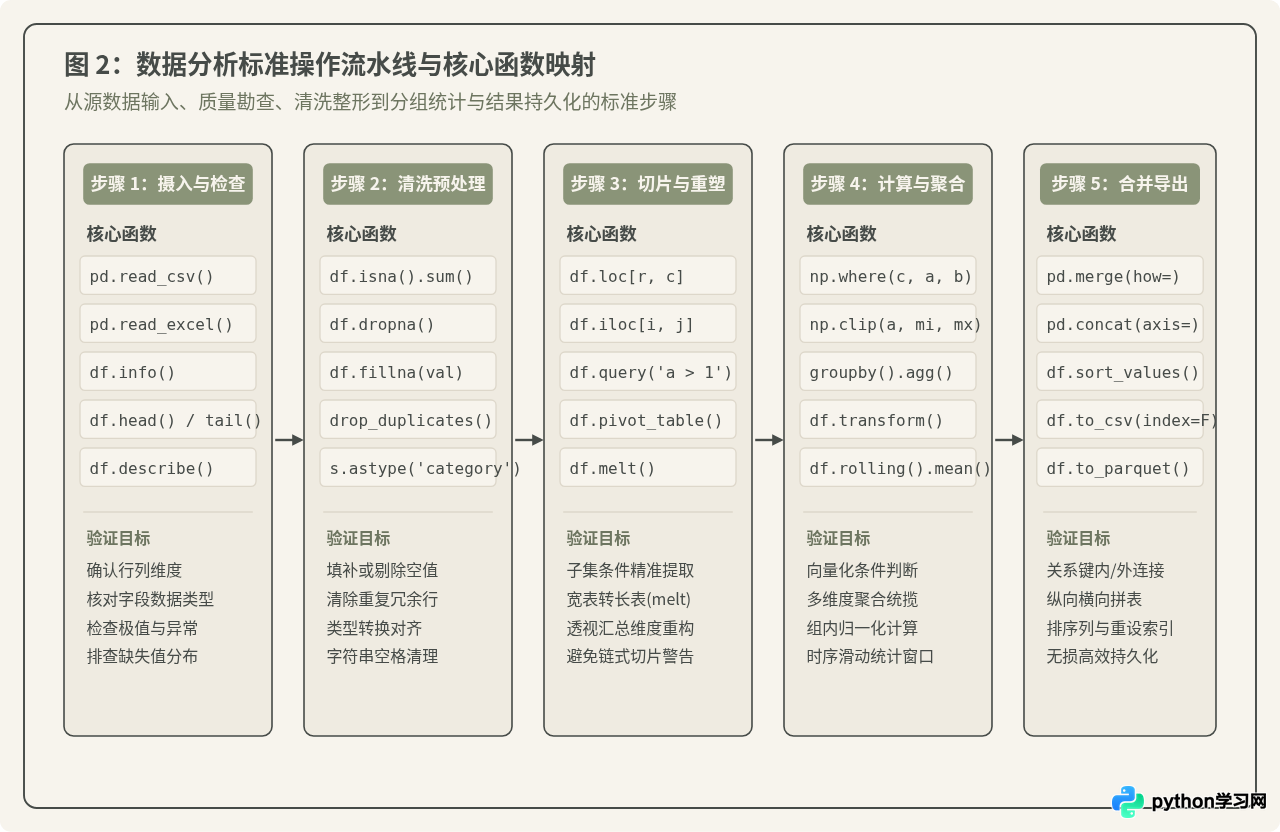
在典型的数据分析项目中,数据处理通常遵循清晰的阶段演进:从数据读取与环境探查、质量清理、切片重构,一直到分组聚合与结果输出。
1. 数据摄入与初探
数据加载后应第一时间通过宏观探查函数建立对数据的初步认知,核实数据量级、缺失率与内存消耗:
pd.read_csv('filepath', parse_dates=[...]):加载CSV文件,通过parse_dates参数直接完成时序字段的ISO格式解析。df.info(memory_usage='deep'):输出各列名称、非空计数、精确数据类型以及深层真实内存占用。df.describe(include='all'):输出数值列的均值、标准差、四分位数,以及类别列的唯一样本量(unique)和众数(top)。
2. 缺失值与数据质量清洗
Python代码示例:数据清洗与类型规整# 统计每列缺失率
null_rate = df.isna().mean()
# 丢弃关键字段缺失的记录
df_clean = df.dropna(subset=['user_id', 'score'])
# 缺失值填充:类别列填充常量,数值列填充中位数
df_clean['category'] = df_clean['category'].fillna('Unknown')
df_clean['score'] = df_clean['score'].fillna(df_clean['score'].median())
# 清除重复主键记录,保留最后一次出现的记录
df_clean = df_clean.drop_duplicates(subset=['user_id'], keep='last')
# 内存优化:将低基数字符串转换为分类类型
df_clean['category'] = df_clean['category'].astype('category')3. 分组聚合与连接重塑
聚合操作遵循“拆分(Split)-应用(Apply)-合并(Combine)”模式。groupby()配合agg()能够以声明式语法对不同列同时执行不同统计指标:
# 多字段差异化聚合
summary = df.groupby('category', observed=False).agg(
    avg_score=('score', 'mean'),
    max_score=('score', 'max'),
    record_count=('user_id', 'count')
).reset_index()

# 多表关联合并 (类似 SQL Left Join)
df_merged = pd.merge(df, summary, on='category', how='left')

# 数据长宽表转换 (透视与逆透视)
# 宽表化:创建透视表
pv_table = df.pivot_table(index='user_id', columns='category', values='score', fill_value=0)
# 长表化:逆透视扁平化
melted = pd.melt(df, id_vars=['user_id'], value_vars=['score'], var_name='metric', value_name='val')
四、核心易混淆机制深度辨析
初学者与中级开发者在使用NumPy与Pandas时,经常在几个特定语法点上产生认知混淆。本节针对最典型的三个问题展开深入辨析。
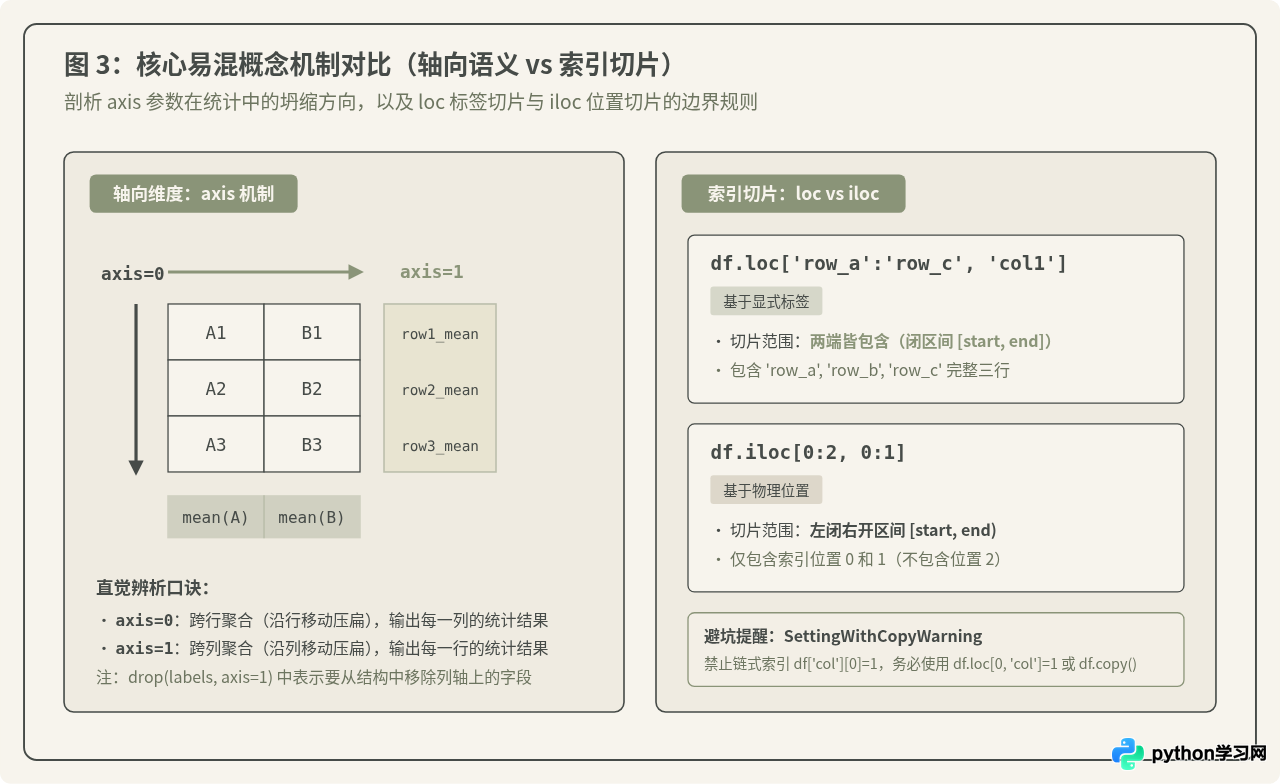
辨析 1:axis=0 与 axis=1 的直觉倒置
很多开发者认为“0代表行,1代表列”,因此直觉上会以为 df.mean(axis=0) 是“求每一行的均值”。这种理解恰恰相反。
原因解析:axis 参数在聚合函数中指定的不是“保持不变的维度”,而是“遍历与被压缩消除的轴向”。
axis=0:函数沿着行方向(纵向)移动遍历。行维度被压缩合并,最终输出的是针对每一列的汇总结果。axis=1:函数沿着列方向(横向)移动遍历。列维度被压缩合并,最终输出的是针对每一行的汇总结果。- 注意反例:在
df.drop('col_name', axis=1)中,参数含义则是“要移除的标签位于列索引轴上”。统一的记忆方式是:axis 指定的是操作应用所在的轴向本身。
辨析 2:loc 与 iloc 的区间闭合规则
在Python原生切片(如 list[0:3])以及NumPy切片中,区间规则普遍遵循计算机科学传统的“左闭右开”(包含起始,排除末尾)。但Pandas的 .loc 却与众不同:
df.iloc[0:3]:基于纯整数位置(Integer-location)。严格遵循左闭右开区间,仅选取行号为 0、1、2 的数据,不包含 3。df.loc['2026-01':'2026-03']:基于显式标签(Label-location)。两端皆为闭区间,结果中完整包含'2026-01'、'2026-02'以及末尾的'2026-03'。
为什么 loc 要设计为双闭区间?因为在字母、非连续字符串或日期标签体系中,用户无法预知目标标签的“下一个紧邻标签”是什么。如果采用右开区间,用户为了包含 '2026-03' 就不得不去推算其下一个键,这在工程上极易引发偏离错误。
辨析 3:视图(View)、副本(Copy)与 SettingWithCopyWarning
在进行条件赋值时,经常会遇到Pandas弹出的 SettingWithCopyWarning 警告。常见反例如下:
# ❌ 错误做法:链式索引赋值 (Chained Indexing)
# 这一步产生链式调用:df[df['score'] < 60] 可能返回一个临时视图或副本
# 在临时对象上修改数值无法保证原 DataFrame 被同步修改,从而引发警告
df[df['score'] < 60]['status'] = 'Retest'

# ✅ 正确做法 1:使用 .loc 单次二维显式定位赋值
df.loc[df['score'] < 60, 'status'] = 'Retest'

# ✅ 正确做法 2:若确实需要派生子集并独立修改,显式调用 .copy()
sub_df = df.loc[df['score'] >= 90].copy()
sub_df['honor'] = 'Passed'
五、高频核心函数全景速查矩阵
为了方便日常开发与代码查阅,下表汇总了日常开发中使用频率最高的核心函数。配合图4的全景速查图,可以在编码时迅速定位对应功能。
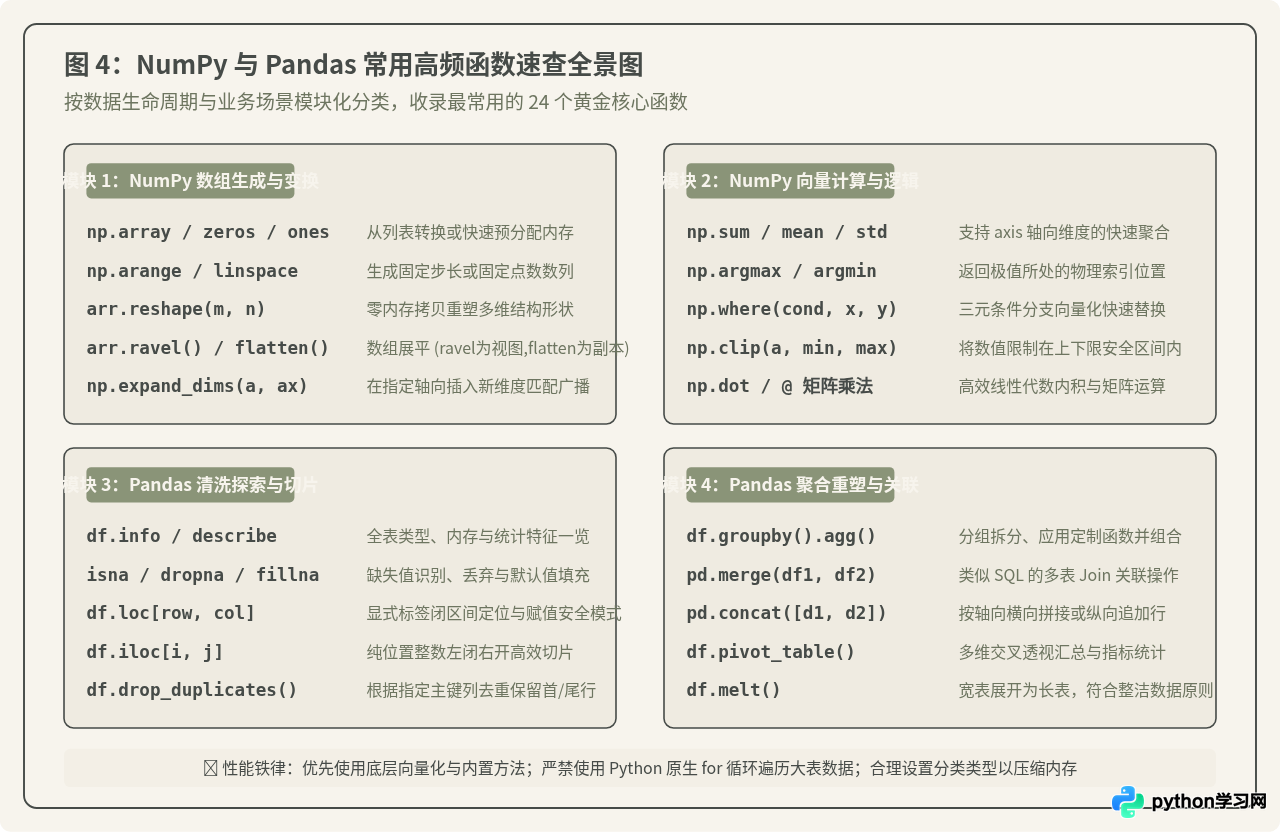
| 库分类 | 核心函数 / 方法 | 主要应用场景 | 典型返回值 / 效果 |
|---|---|---|---|
| NumPy | np.array() / np.zeros() |
内存初始化、从列表构建多维数组 | 返回连续内存的 ndarray 对象 |
| NumPy | arr.reshape(shape) |
在不改动内存底层数据的前提下重构维度 | 返回原数组的全新形状视图 |
| NumPy | np.where(cond, x, y) |
多维向量化条件分支赋值判断 | 按条件选取对应位置元素的数组 |
| NumPy | np.sum() / mean() / std() |
按指定 axis 轴向统计各维度聚合值 | 标量或降低一个维度的结果数组 |
| Pandas | pd.read_csv() / to_csv() |
结构化文本数据的高效加载与持久化保存 | 返回 DataFrame / 写入本地文件 |
| Pandas | df.info() / df.describe() |
数据概貌、非空统计、类型与分布探测 | 输出数据概况诊断文本与统计特征表 |
| Pandas | df.loc[] / df.iloc[] |
分别基于标签与位置的子集切片与安全赋值 | Series / DataFrame 切片视图或副本 |
| Pandas | df.isna() / fillna() / dropna() |
缺失值的排查统计、空值填充与脏数据剔除 | 布尔掩码 / 清洗后的整洁 DataFrame |
| Pandas | df.groupby().agg() |
对分类字段进行分组并按列施加定制聚合函数 | 返回聚合计算后的统计指标表格 |
| Pandas | pd.merge() / pd.concat() |
关系型主键连接(Join)与横纵向追加拼表 | 返回完成合并对齐的复合 DataFrame |
日常最佳实践与性能原则
- 优先利用底层向量化:严禁使用
for index, row in df.iterrows()处理大规模数据。若无法直接使用内置运算符,应优先使用df.apply(),更复杂的场景可将核心列转为 NumPy 数组直接处理。 - 慎用
inplace=True:在现代 Pandas(特别是 2.0+ 引入 Copy-on-Write 机制后),inplace=True并不能带来真正的内存节省,反而破坏了方法链式调用(Method Chaining)的代码连贯性,推荐采用重新赋值方式(如df = df.dropna())。 - 合理管理数值精度与类别类型:对于基数低(唯一值少)的文本字段,显式转换为
category类型可减少 70% 以上的内存开销;对整型数值按实际范围指定int32或int16可有效缓解内存瓶颈。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









