

Python Pandas DataFrame按某一列排序:sort_values用法详解

在 Pandas 中对表格数据进行按列重排,最核心、最直接的方法是调用 DataFrame.sort_values()。其基本语法为 df.sort_values(by='目标列名')。默认情况下,该方法按照升序(由小到大、由低到高)排列整行数据,并返回一个新的 DataFrame。掌握该方法的核心在于理清排序列指定、升降序切换、缺失值安放位置以及行索引的处理方式。
一、核心机制与工作原理
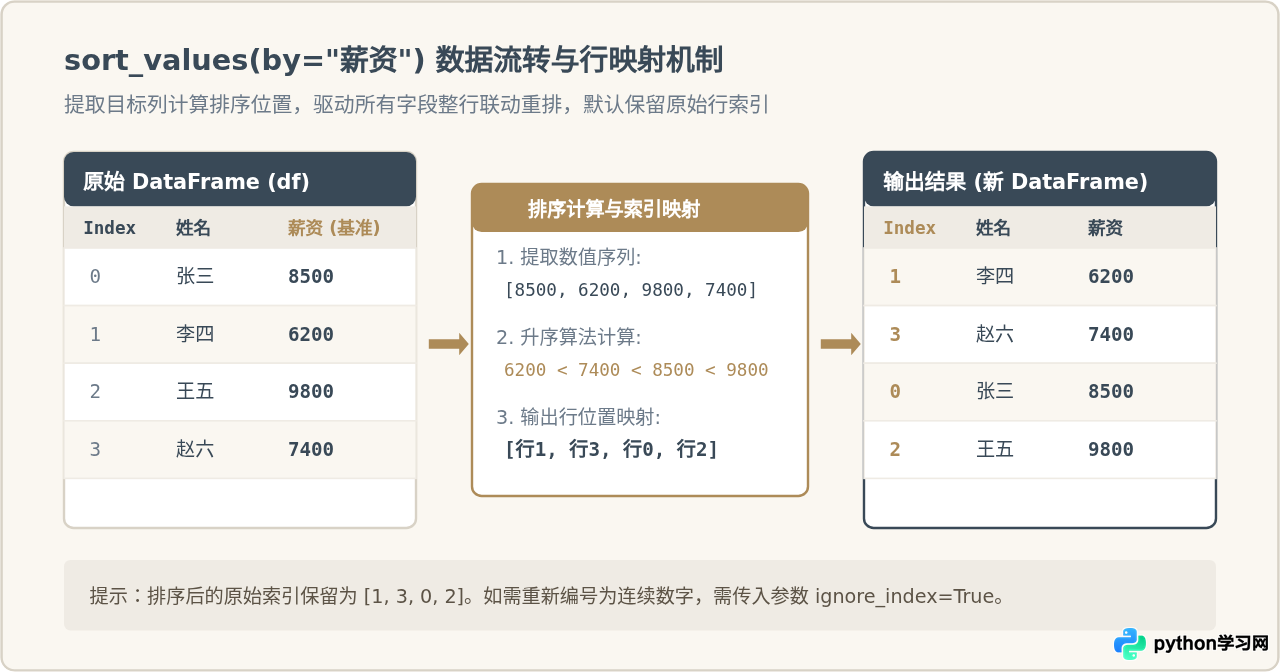
理解 sort_values 的关键在于明确“按某一列排序”并非只移动该列自身的数值,而是以该列为基准,带动所有关联字段进行整行位移。Pandas 会提取目标列中的各个值,通过内部排序算法生成对应的数据行映射索引,再按此映射顺序重新组装整个 DataFrame。
需要特别留意的是,Pandas 默认会完整保留原有的行索引编号(Index),并将其随行数据一同移动。这意味着排序后的表格第一行索引未必是 0。若希望重置为顺序索引,则需要配合 ignore_index 参数。
二、基础操作与完整示例
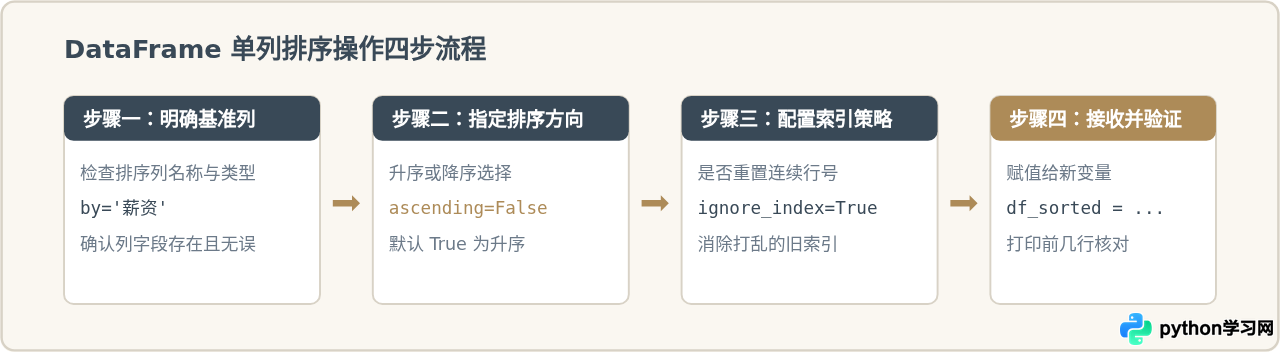
在日常数据清洗与分析中,单列排序的使用频次最高。下面通过构建一个员工信息表,演示从初始数据准备到升序、降序排序的具体步骤。
1. 准备示例数据
import pandas as pd

# 构建示例员工数据
data = {
    '姓名': ['张三', '李四', '王五', '赵六', '钱七'],
    '部门': ['技术', '市场', '技术', '运营', '市场'],
    '薪资': [8500, 6200, 9800, 7400, 11000],
    '工龄': [3, 1, 5, 2, 4]
}
df = pd.DataFrame(data)
print(df)2. 单列升序排序(默认)
当只传入 by='薪资' 时,Pandas 默认使用升序排列(从最低薪资到最高薪资):
# 按薪资升序排列
df_asc = df.sort_values(by='薪资')
print(df_asc)3. 单列降序排序(ascending=False)
如果业务需求需要从高到低排列(例如筛选薪资最高的员工),只需设置 ascending=False:
# 按薪资降序排列
df_desc = df.sort_values(by='薪资', ascending=False)
print(df_desc)三、核心参数行为与对比分析
DataFrame.sort_values 的完整函数签名包含多个参数:
DataFrame.sort_values(
    by,
    axis=0,
    ascending=True,
    inplace=False,
    kind='quicksort',
    na_position='last',
    ignore_index=False,
    key=None
)
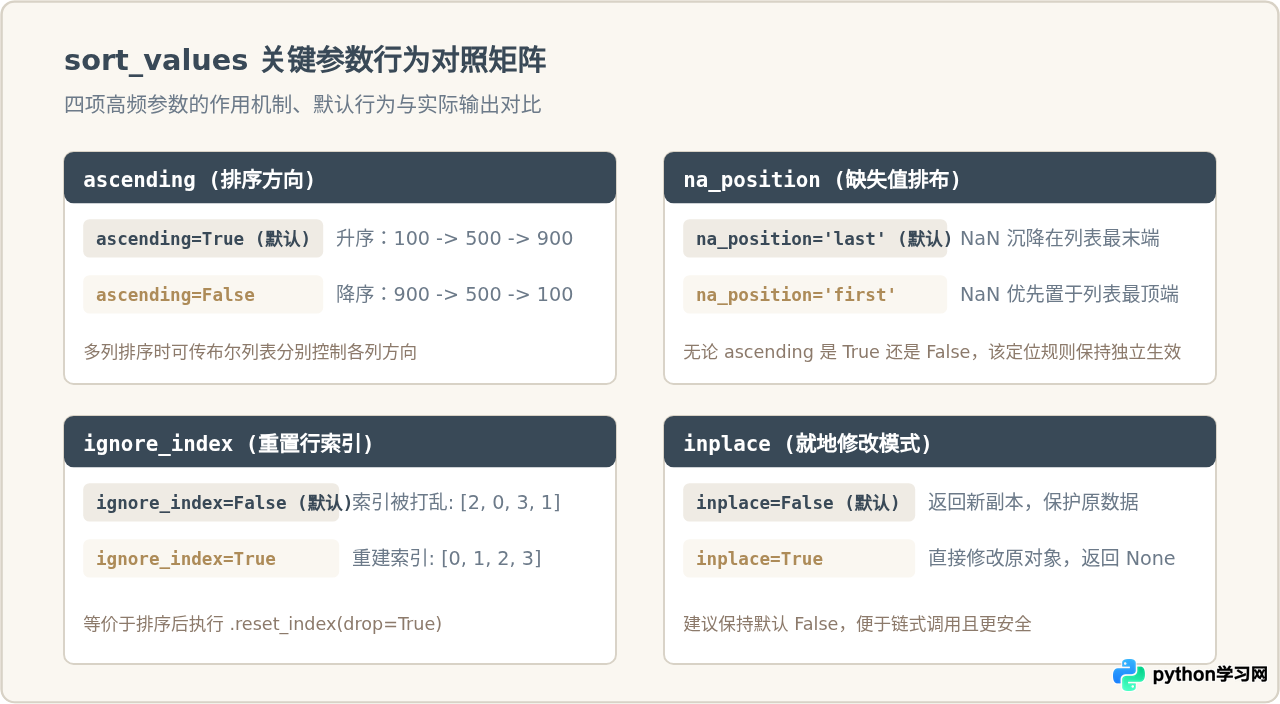
在实际编码中,除 by 之外,最为关键且容易产生行为差异的参数有 4 个:ascending、na_position、ignore_index 以及 inplace。各参数的核心功能与典型取值如下表所示:
| 参数名称 | 默认值 | 可选值 | 核心作用与说明 |
|---|---|---|---|
by |
无(必填) | 字符串或列表 | 指定作为排序依据的一个或多个列名。 |
ascending |
True |
bool 或 list of bool |
控制升序还是降序。True 为由小到大,False 为由大到小。 |
na_position |
'last' |
'first' 或 'last' |
指定缺失值(NaN)在排序结果中的位置,放在末尾或最前。 |
ignore_index |
False |
bool |
是否重置索引。设为 True 时生成 0, 1, 2... 的顺序整数索引。 |
inplace |
False |
bool |
是否就地修改原对象。True 返回 None,False 返回新副本。 |
key |
None |
可调用函数(Callable) | 在排序前对列数据执行转换(如小写化、取绝对值),不改变原列值。 |
1. 缺失值处理:na_position 参数
真实业务数据往往包含空值(NaN)。默认情况下,na_position='last' 会把缺失值丢在最后;如果业务需要优先审查缺失项,可显式指定 na_position='first':
import numpy as np

# 构造含缺失值的测试数据
df_with_nan = pd.DataFrame({
    '项目': ['A', 'B', 'C', 'D'],
    '评分': [88.5, np.nan, 92.0, np.nan]
})

# 将缺失值排在最前
df_nan_first = df_with_nan.sort_values(by='评分', na_position='first')
print(df_nan_first)2. 规范行号:ignore_index 参数
如果不希望在排序后看到错乱的旧行索引,推荐直接在 sort_values 中设置 ignore_index=True,无需额外调用 reset_index(drop=True):
# 排序后直接重置索引为 0, 1, 2...
df_clean_index = df.sort_values(by='薪资', ignore_index=True)
print(df_clean_index)3. 自定义函数排序:key 参数
在 Pandas 1.1.0 及更高版本中引入了 key 参数。它接收一个函数,并在排序前将该函数映射到指定列,按转换后的结果计算大小,但最终输出的数据依然保持原样。例如希望按字符串长度或者忽略大小写排序:
df_text = pd.DataFrame({
    '城市': ['北京', '乌鲁木齐', '上海', '呼和浩特']
})

# 按城市名称字数长短升序排序
df_len_sorted = df_text.sort_values(by='城市', key=lambda col: col.str.len())
print(df_len_sorted)四、进阶场景:多列优先级组合排序
在实际报表中,单纯的一列排序往往无法满足业务逻辑。例如“先按部门分组,同一个部门内再按薪资由高到低排列”。此时可以将 by 和 ascending 都传入列表:
# 多列组合排序:部门升序,部门内部薪资降序
df_multi = df.sort_values(
    by=['部门', '薪资'],
    ascending=[True, False],
    ignore_index=True
)
print(df_multi)执行逻辑说明:Pandas 首先依据列表中的第一个元素 '部门' 进行排序;当遇到部门名称完全相同的数据行时,再依据第二个元素 '薪资' 按对应的降序规则进行次级排序。
五、常见错误与避坑指南
- 误用
sort_index()代替sort_values():sort_index()是基于行或列的索引标签排序,而非基于列内的实际数据内容。如果想按某一列的数值高低排列,必须使用sort_values(by=...)。 - 未接收返回值导致原数据未改变:许多初学者执行了
df.sort_values(by='薪资')之后,打印df发现顺序完全没变。这是因为默认inplace=False,原对象并未被改写。正确做法是将其赋值给新变量df_sorted = df.sort_values(...)。尽量避免在生产环境滥用inplace=True,因为就地修改不利于构建链式数据流水线。 - 列名拼写或大小写不匹配:
by传入的列名必须与df.columns中的名称完全一致(区分中英文字符与大小写),否则会直接抛出KeyError。在编写动态脚本时,建议先使用if '列名' in df.columns进行存在性校验。 - 混合数据类型的隐式比较问题:如果排序列中同时混杂了字符串和数值(例如
['10', 2, '20']),Python 3 会抛出TypeError: '<' not supported between instances of 'int' and 'str'。排序前应先使用pd.to_numeric()统一数据类型。
六、总结与实战速查
为了在日常编码中快速选定正确的排序参数与写法,下方的速查决策图总结了不同业务场景下的推荐组合方式:
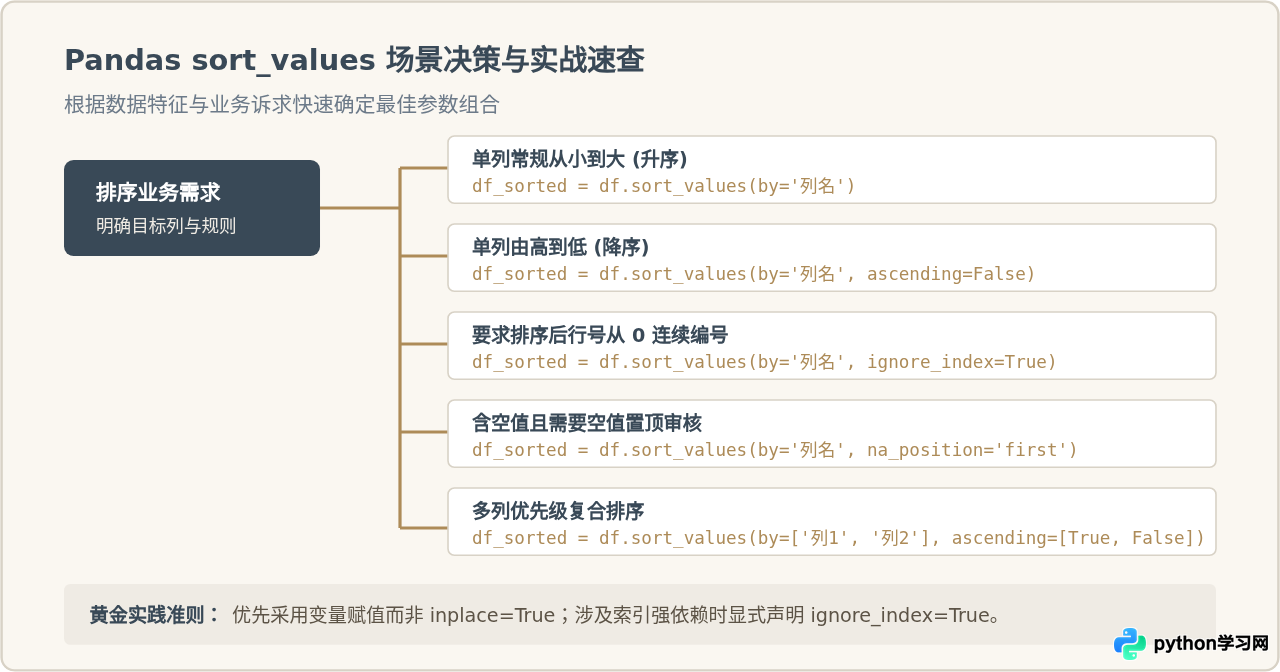
总结:sort_values 是 Pandas 结构化数据处理中不可或缺的重排工具。使用时牢记三个核心要点:用 by 锁定排序列、用 ascending 指定排序朝向、用 ignore_index 控制新行号,即可应对绝大多数表格数据排序场景。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









