

为什么PyPy比CPython快:Python解释器性能优化原理
深入解析PyPy相较于CPython大幅提升纯Python代码执行速度的底层机制,详解字节码解释与追踪JIT编译、对象解包及垃圾回收优化的核心原理与适用边界。
PyPy 之所以比官方默认的 CPython 运行更快,核心在于它采用追踪即时编译(Tracing JIT)技术将热点循环直接编译为优化后的机器码执行,并配合基于虚拟对象的逃逸分析与未装箱内存布局,消除了原生 Python 动态类型检查与频繁对象封装带来的巨大开销。本文将通过执行架构、JIT工作流程、对象内存结构以及垃圾回收机制这四个工程维度,拆解 PyPy 提速的根本原因与适用边界。
1. 核心架构差异:字节码求值循环 vs 即时机器码
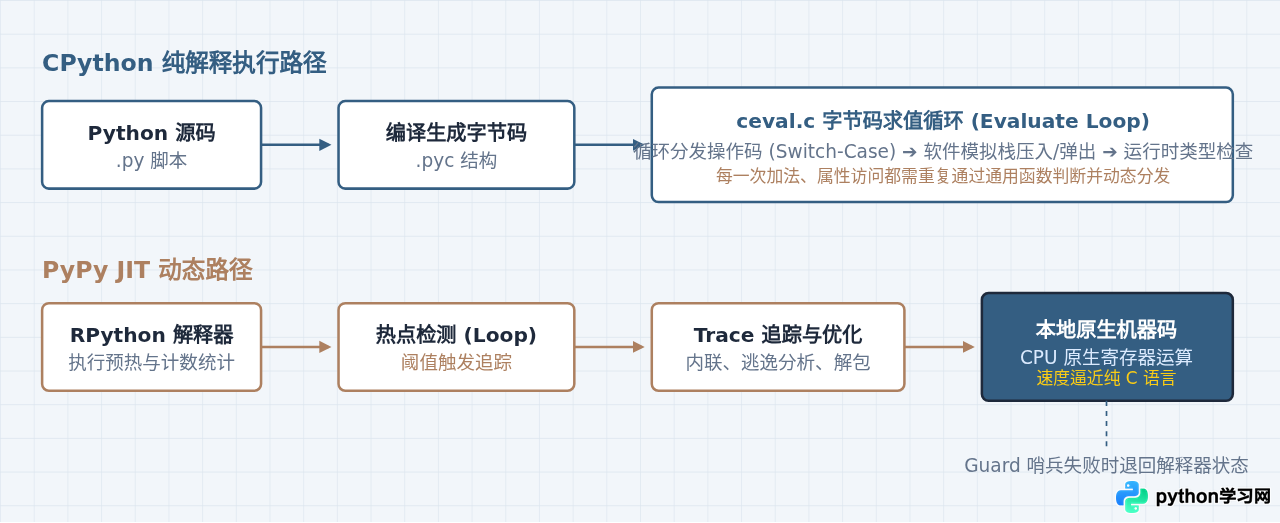
标准 CPython 解释器在执行代码时,会先将 .py 源码解析为 AST 并生成字节码序列。随后的执行完全依赖一个用 C 语言编写的巨大死循环(ceval.c 中的求值循环)。每读取一个操作码(Opcode),解释器都需要经过一次庞大的 switch-case 分发,并处理操作数栈的压栈与弹栈操作。
相比之下,PyPy 并不单纯停留于解释字节码。它使用 RPython(Restricted Python)构建了解释器底座,并在运行时对执行频率高的代码路径(热点,Hotspots)直接翻译为主机硬件支持的 CPU 机器指令。一旦代码被编译为本地指令,后续调用将直接在 CPU 物理寄存器中运算,完全绕开了解释器循环与操作码分发开销。
2. 追踪式 JIT(Tracing JIT)的工作过程与推导
Java HotSpot 等传统方法级 JIT 倾向于将整个方法(Method)作为编译单元。而 PyPy 采用的是更为激进的追踪式 JIT(Tracing JIT),因为在动态语言中,函数内部可能包含多条分支,但运行时的绝大多数执行时间往往聚焦在某几条固定循环路径上。
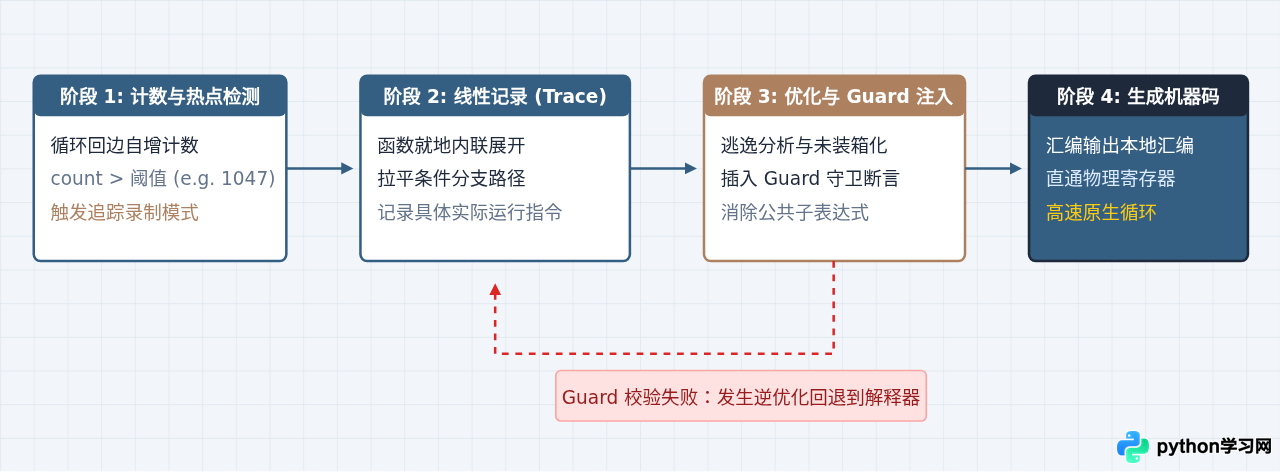
PyPy 的 JIT 引擎主要分为四个阶段展开:
- 识别循环与预热计数:解释器在运行字节码时,会在循环回边(Loop Backedge)设置计数器。当某个循环的迭代次数达到预设阈值(通常为数百次)时,该循环被标记为热点。
- 生成线性追踪记录(Trace):解释器进入追踪模式。在此模式下,解释器一边正常解释代码,一边像录像机一样记录实际执行的操作序列。这个过程会彻底拉平所有函数调用(自动内联),形成一条没有多态分支的线性指令流。
- 假设与哨兵校验(Guard):由于 Python 是动态类型语言,PyPy 在记录这条线性路径时,会对变量的类型做出假设。引擎会在 Trace 中插入微型断言指令,即“哨兵(Guard)”。如果运行中变量类型未发生改变,指令顺畅下行;若类型发生变化,Guard 失败,执行立刻安全回退至解释器。
- 后端编译为原生机器指令:优化后的线性 Trace 会直接被汇编器生成为目标架构(x86-64、ARM 等)的本地机器指令,常驻在内存代码段中。后续迭代直接调用该地址执行。
3. 对象未装箱与逃逸分析:消除内存垃圾
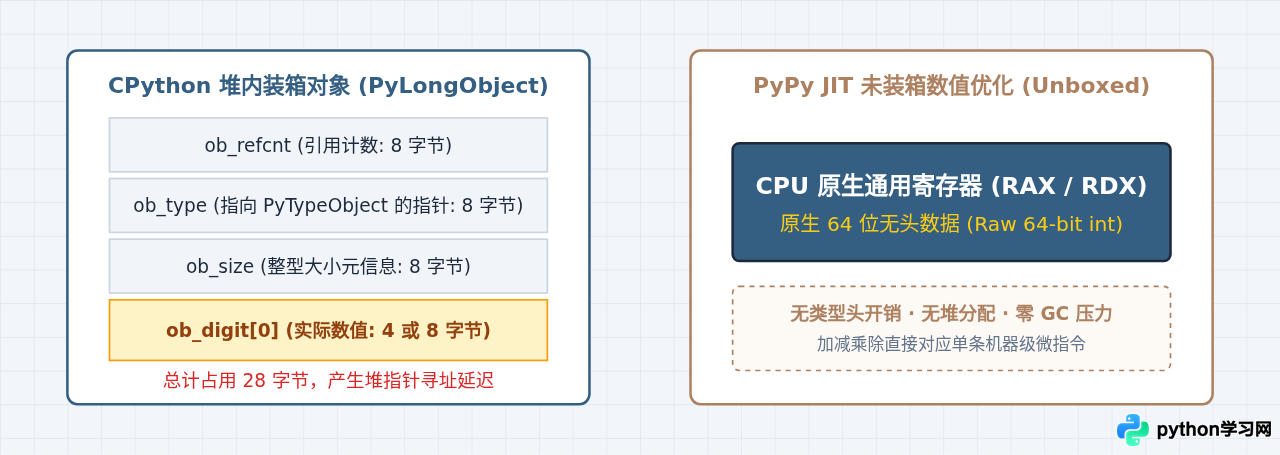
在 CPython 中,甚至连最基本的整型数值 1 也是一个完整的堆分配对象(PyLongObject)。一个整数在 64 位 CPython 环境下通常需要占用 28 个字节,包含用于垃圾回收的引用计数、类型对象指针以及数值缓冲区。更关键的是,两个数字相加 a + b,CPython 必须先解包引用、分配一个新的 PyLongObject 堆内存,再将相加后的结果放入其中。
PyPy 通过两项内存优化技术彻底打破了这种瓶颈:
- 未装箱(Unboxing):在 JIT 追踪到局部循环中只涉及标量计算时,PyPy 会将这些值保留在 CPU 寄存器或栈内存中(即 C 语言原生机器字长 64 位),完全不创建堆对象。
- 逃逸分析(Escape Analysis):PyPy 会分析对象的作用域。如果一个对象在函数或循环内部分配,且生命周期没有“逃逸”到外部(例如没有返回到上一层,也没有赋值给全局变量),那么该对象的内存分配会被完全省略,其属性直接打散成原始变量寄存器。
4. 垃圾回收机制对比:引用计数 vs 分代移动 GC
运行效率不仅取决于计算过程本身,还深受垃圾回收机制的影响。两者的回收模型存在本质不同:
- CPython:引用计数为主,分代标记为辅。 CPython 的核心机制是引用计数(Reference Counting)。虽然这让无循环引用的对象可以瞬间释放,但代价是极其高昂的:每一次对象传递、函数入参、列表追加,都伴随着
Py_INCREF和Py_DECREF的内存写入。在高并发与密集计算场景下,频繁修改引用计数字段极易导致 CPU 缓存失效。 - PyPy:Incminimark 垃圾回收器。 PyPy 弃用了引用计数,转而采用类似 Java JVM 现代垃圾收集器的分代移动 GC(Generational Moving GC)。对象创建时分配在连续的年轻代托儿所(Nursery)内存中,分配速度如同指针位移般迅速;短期临时对象在新生代清理时被批量抹除,不产生内存碎片,大幅减轻了 CPU 的内存总线压力。
5. 代码示例验证与性能实测观测
为了直观观测上述优化带来的运行差异,可以通过下面这段典型的 CPU 密集型循环运算进行验证:
import time

def compute_heavy_loop(iterations: int) -> int:
    total = 0
    for i in range(iterations):
        # 典型的标量运算与临时对象生成
        total += (i % 3) * 2 - (i % 5)
    return total

if __name__ == "__main__":
    count = 50_000_000
    start = time.perf_counter()
    result = compute_heavy_loop(count)
    duration = time.perf_counter() - start
    print(f"Result: {result} | Elapsed Time: {duration:.4f}s")
在相同硬件环境下分别使用 CPython 与 PyPy 运行该脚本,可以获得明确的特征差异:
# 使用 CPython 3.11 执行示例
$ python3 test_perf.py
Result: -10000000 | Elapsed Time: 2.7634s

# 使用 PyPy3 (v7.3.x) 执行示例
$ pypy3 test_perf.py
Result: -10000000 | Elapsed Time: 0.0812s
i 和 total 均为整型且不向外部逃逸,因此在生成的机器码中将它们直接分配在硬件寄存器中,原先数千万次的 Python 对象解包与属性查找在本地指令中缩减为仅需几个 CPU 周期的位运算与减法指令。
6. 适用场景决策与性能边界
PyPy 的极致性能并非毫无代价。了解 PyPy 在哪些场景“不快”甚至“更慢”,是技术选型时的关键判断依据:
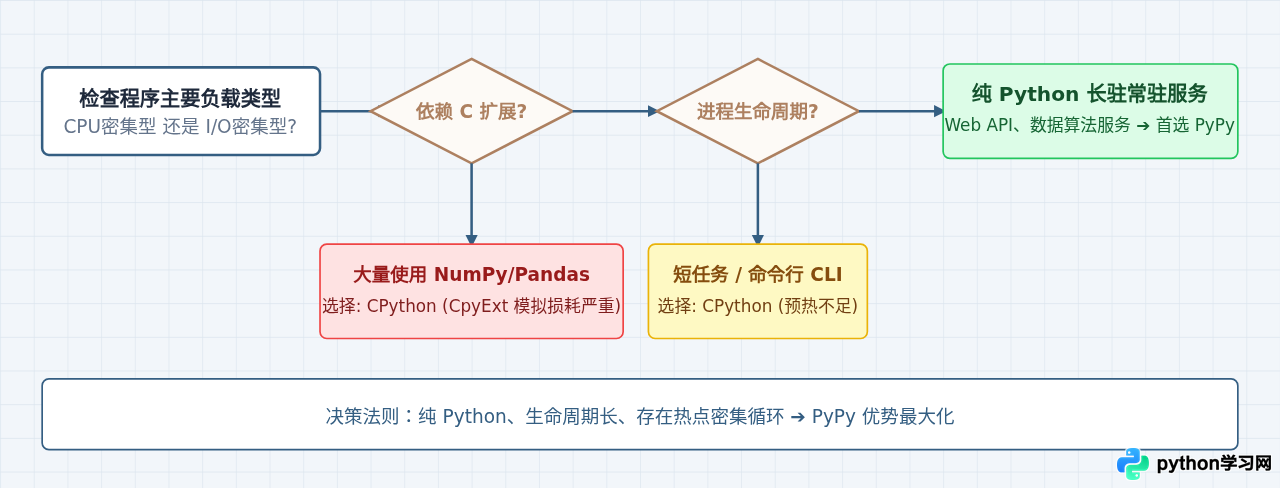
| 场景与技术维度 | CPython | PyPy |
|---|---|---|
| 纯 Python 算法与循环 | 逐行解释执行,速度较慢。 | JIT 生成本地机器指令,性能提升数倍至数十倍。 |
| C 扩展(C-API)库兼容性 | 原生集成,速度最快,无缝支持 NumPy、Pandas 等。 | 通过 cpyext 模拟层兼容,跨语言调用有额外封装开销。 |
| 内存消耗与预热开销 | 启动迅速,内存占用小,无 JIT 预热延迟。 | 保留 JIT 编译器、Trace 元信息,内存底噪较大。 |
| 服务运行模式 | 适合命令行脚本、短生命周期 Serverless 任务。 | 适合长生命周期驻留进程(Web 服务、Worker 队列)。 |
7. 总结
PyPy 之所以比 CPython 展现出压倒性的执行速度,其本质是将传统解释器的被动单步模拟执行,革新为基于真实运行时分析的动态原生机器码生成。通过追踪即时编译(Tracing JIT)、Guards 守卫保护、未装箱标量优化以及高效的分代 GC,PyPy 成功抵消了 Python 动态特性带来的主要性能损耗。在构建无需沉重 C 扩展的长生命周期纯 Python 业务系统时,PyPy 依然是极具性价比的免改动加速方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









