

Python基础100题实战:怎么将练习题转化为小型项目代码
深入解析如何将Python基础100题中的离散练习题转化为健壮实用的小型项目代码。通过纯函数抽象、数据链串联、工程防腐与CLI封装四步法,辅以工时记录分析器的完整实战案例,帮助初学者跨越从刷题到做项目的思维鸿沟。
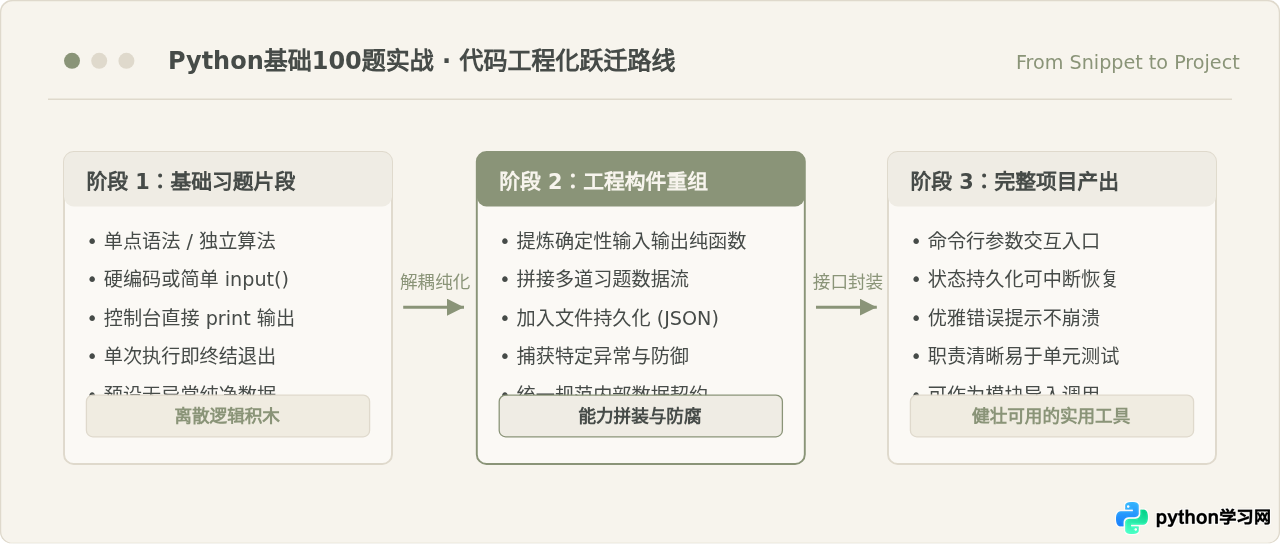
一、认识断层:练习题与项目代码的本质差异
在各大 Python 学习论坛中,“刷完 100 道基础题就能直接做项目”是一种流行度极高但也极易误导人的说法。这种说法之所以看似合理,是因为 100 题通常全面覆盖了列表推导、字典操作、字符串清洗、递归、文件读取以及简单面向对象等核心语法要点,确实提供了构建项目的全部“语法材料”。在题目要求明确、测试用例标准且输入完全合规的理想场景下,这个说法能够初步成立。
然而,一旦脱离了预设的做题环境,这一说法就需要重大修正:真实世界的项目从来不会提供预处理好的纯净输入,也不会在单次计算完毕打印一行文字后就自动销毁。现实软件需要长时间持续响应、在各种脏数据和非法操作面前保持稳定、跨会话保存运行状态,并且允许使用者通过参数或交互来调度功能。
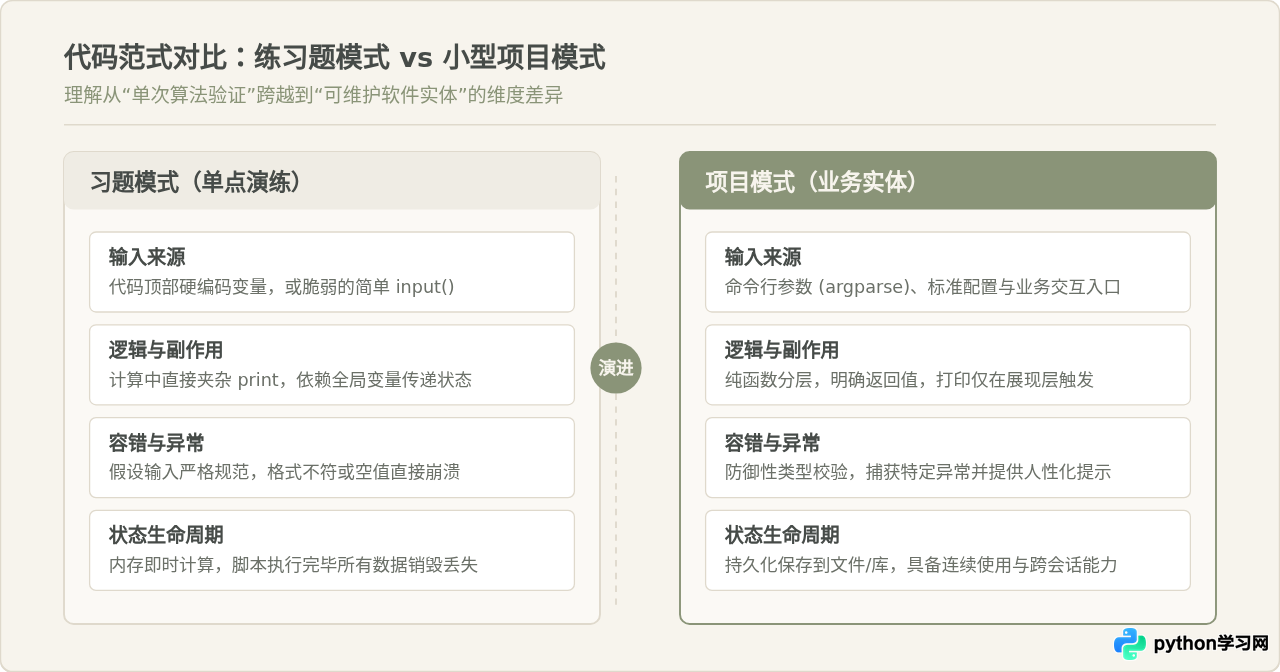
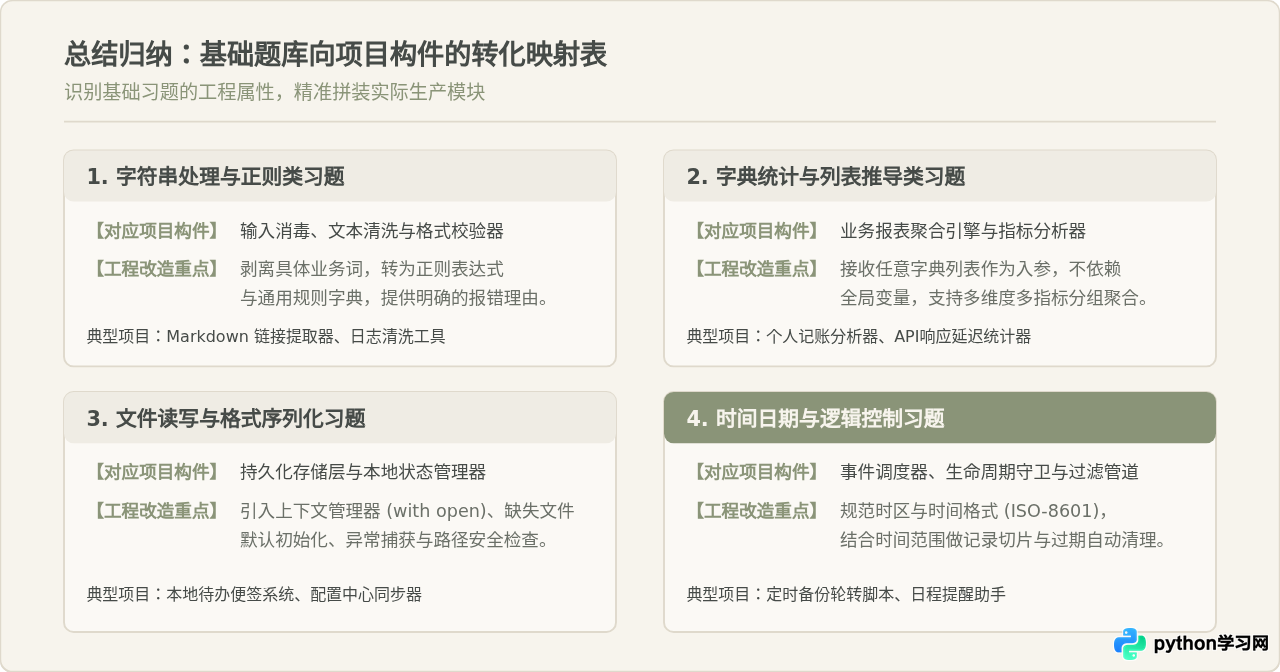
将练习题代码演进为项目代码,必须首先理解两者在四个核心维度的架构差异:
- 输入方式的演变:练习题往往依赖代码首行的静态硬编码变量或一段极易抛错的
input();项目代码则采用命令行参数解析(如argparse)、配置文件或标准交互管道。 - 逻辑副作用与返回值:练习题喜欢在算法执行中直接调用
print(),并将状态散落在全局变量中;项目代码将计算逻辑剥离为纯函数,通过明确的return返回结构化数据,展示层仅在最外层工作。 - 异常防御与健壮性:练习题默认所有数据类型与格式均合法;项目代码则假定外部输入随时可能缺失、破损或超界,必须配置针对性的异常捕获与容错回退。
- 状态生命周期:练习题的生命周期仅持续数毫秒,脚本终止数据即湮灭;项目代码依靠本地 JSON、CSV 或轻量数据库管理持久化状态,支持中断并随时继续。
二、标准转化:四步演进操作流程
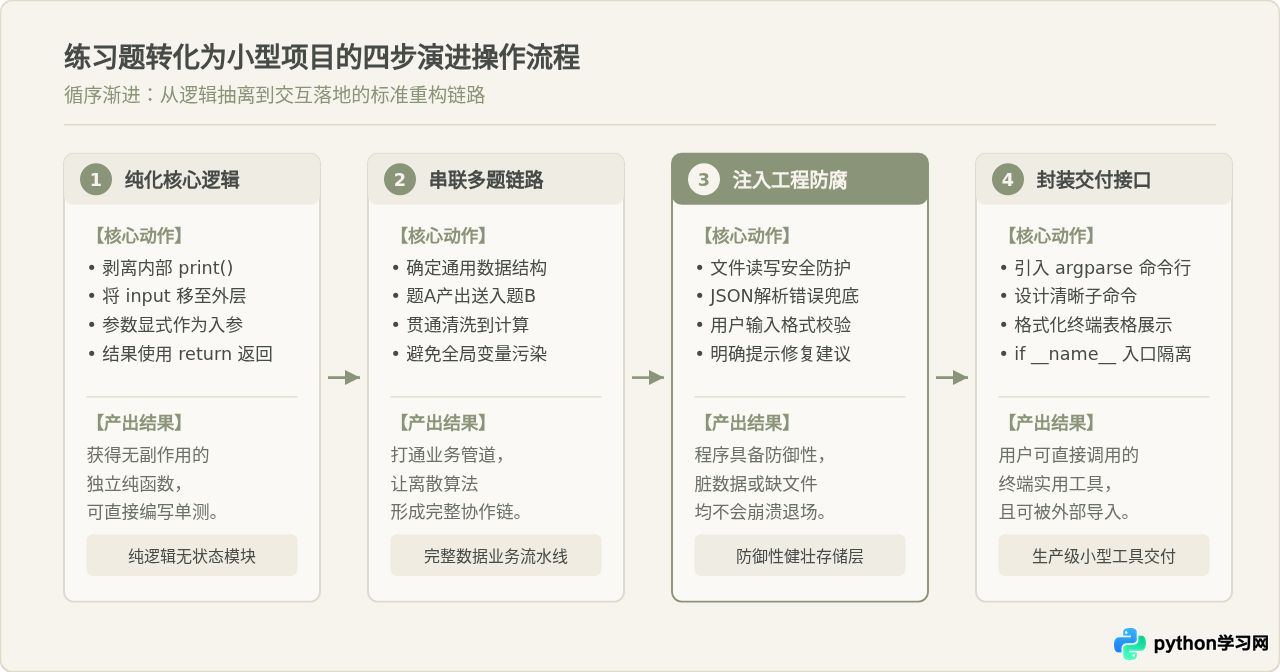
要把平时练习写出的零散代码重构成模块化项目,推荐遵循标准化的四步演进法。每一步都针对特定的代码坏味道进行针对性治理,避免直接将多道题目的代码未经修改就粗暴粘贴到一个文件内。
第 1 步:纯化核心逻辑,剥离全局副作用
找出练习题中真正承担计算或转换的代码段,将其提取为一个独立的函数。严格禁止函数内部出现 input() 和 print()。所有的前置数据必须通过函数形参传入,所有的计算结果必须通过 return 返回。满足这个条件的函数称为“纯逻辑函数”,它不依赖外部全局变量,调用百次结果恒定,可以直接为其编写单元测试。
第 2 步:识别技术积木,打通多题数据链路
小型项目通常是 2 至 4 个基础练习题逻辑的组合体。在规划项目时,先确定标准的数据交换格式(如 Python 字典或 dataclass)。例如:
- 使用“字符串清洗与提取题”的逻辑处理原始输入;
- 将清洗后的数据送入“时间差计算题”提取时间区间;
- 将区间数据送入“字典统计加权题”生成分析指标。
前一个函数的返回值直接作为后一个函数的入参,数据顺畅流转,彻底消灭用全局变量临时存数据的隐患。
第 3 步:注入工程防腐层与安全持久化
纯粹的算法在遇到空文件、坏字符串或磁盘写入中断时非常脆弱。防腐层的工作是设立检查闸口:
- 输入校验:对传入的日期、数值范围进行预检,捕获
ValueError,并附带可读的提示,而非直接让 Python 抛出追踪栈。 - 安全 I/O:读取文件时预判
FileNotFoundError,若不存在则自动初始化空的合法结构;写入时通过异常捕获防止因写入中断导致文件损坏。
第 4 步:封装交付接口与运行入口
最后,为整套流水线装配一个“操作外壳”。使用标准库 argparse 声明清晰的子命令(如 add、list、report),并将调度逻辑置于 if __name__ == '__main__': 保护块内。这样既保证了该脚本可以在终端中作为独立 CLI 工具使用,也允许其他脚本将其作为模块直接 import 核心函数。
三、全流程实战:将三道基础练习题整合成工时分析工具
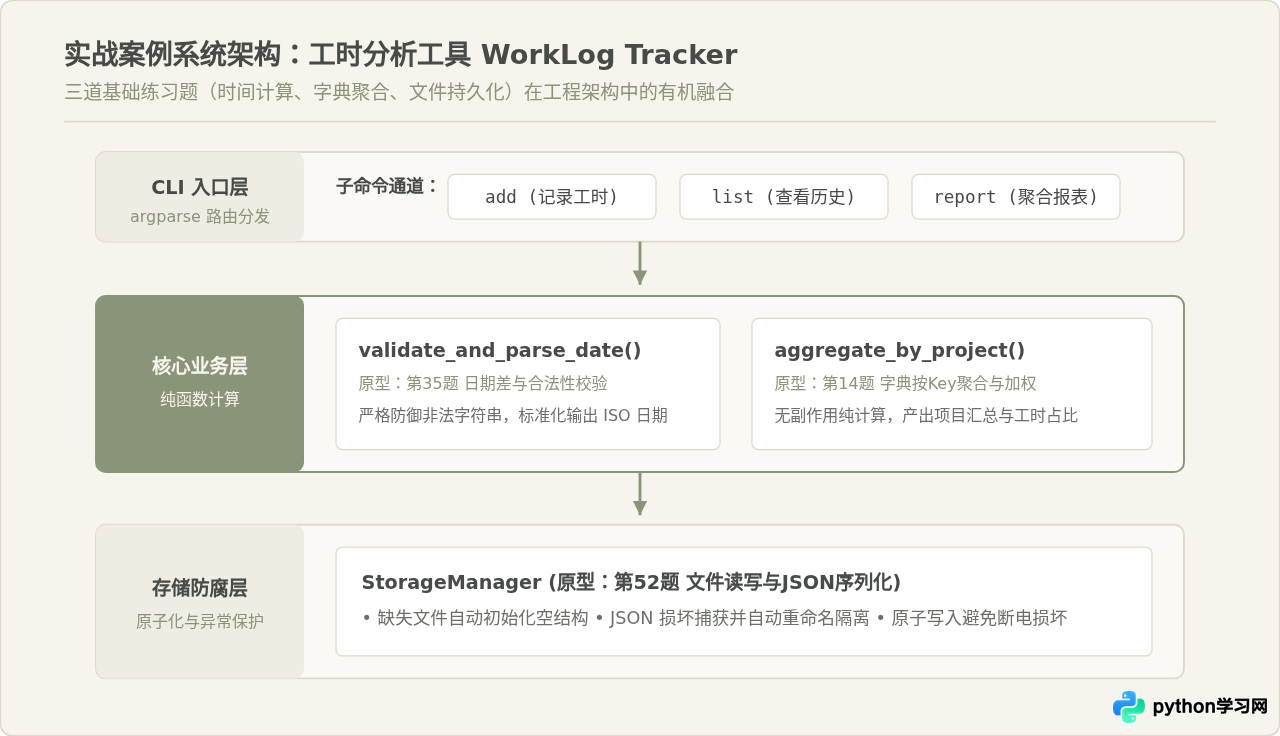
为了具体展现上述转化方法,我们选取经典的 Python 100 题中的 3 道代表性原型,将其组装并改造成一个终端实用工具——工时记录与分析器(WorkLog Tracker)。
1. 选取的 3 道基础原型题目
- 原型题 A(第 35 题常见形态):输入日期字符串,计算该日期是星期几并校验格式是否合法。
- 原型题 B(第 14 题常见形态):给定一个学生成绩或销售清单字典,统计每个分类的总数及均值。
- 原型题 C(第 52 题常见形态):读取并向磁盘写入 JSON 格式的字典列表。
input() 串在一起,中间用全局变量传递,最后用 with open() 写入。一旦某次输入的日期格式错误,或者 JSON 文件不存在,整个程序瞬间崩毁,甚至覆盖已有数据。
2. 工程化模块代码拆解与实现
我们按照纯函数层、存储防腐层、交互调度层三个阶段实现代码。代码仅使用 Python 3 标准库,无需安装任何第三方扩展。
模块 1:业务校验与聚合纯函数(原题 A 与 原题 B 的纯化)
将日期校验与聚合统计提炼为没有副作用的独立函数:
from datetime import datetime
from typing import Dict, List, Any

def parse_and_validate_date(date_str: str) -> str:
    """
    纯函数:将用户输入的日期字符串校验并统一格式化为 YYYY-MM-DD。
    若输入非法,抛出明确的 ValueError 供上层处理。
    """
    cleaned = date_str.strip()
    try:
        dt = datetime.strptime(cleaned, "%Y-%m-%d")
        return dt.strftime("%Y-%m-%d")
    except ValueError:
        raise ValueError(f"日期格式错误: '{date_str}',正确格式应为 YYYY-MM-DD (例如 2026-11-04)")

def aggregate_worklog(records: List[Dict[str, Any]]) -> Dict[str, Any]:
    """
    纯函数:根据项目分类汇总工时,计算各项目总工时及所占百分比。
    不进行任何打印操作,直接返回结构化统计字典。
    """
    if not records:
        return {"total_hours": 0.0, "projects": {}}

    project_totals: Dict[str, float] = {}
    total_hours = 0.0

    for item in records:
        proj = item.get("project", "未分类").strip()
        hours = float(item.get("hours", 0.0))
        project_totals[proj] = project_totals.get(proj, 0.0) + hours
        total_hours += hours

    breakdown = {}
    for proj, hours in project_totals.items():
        pct = (hours / total_hours * 100) if total_hours > 0 else 0.0
        breakdown[proj] = {
            "hours": round(hours, 2),
            "percentage": round(pct, 1)
        }

    return {
        "total_hours": round(total_hours, 2),
        "projects": breakdown
    }
模块 2:存储防腐层(原题 C 的工程升级)
对文件读写操作增加“存在性防御”、“解析损坏防御”以及“安全写入保护”:
import json
import os

class SafeJsonStorage:
    def __init__(self, filepath: str):
        self.filepath = filepath

    def load_data(self) -> List[Dict[str, Any]]:
        """安全加载数据:若文件不存在自动返回空列表;若文件损坏则重命名备份,防止覆盖丢失。"""
        if not os.path.exists(self.filepath):
            return []
        try:
            with open(self.filepath, "r", encoding="utf-8") as f:
                content = f.read().strip()
                if not content:
                    return []
                data = json.loads(content)
                if isinstance(data, list):
                    return data
                return []
        except (json.JSONDecodeError, UnicodeDecodeError):
            backup_path = f"{self.filepath}.corrupt.bak"
            os.rename(self.filepath, backup_path)
            print(f"[警告] 数据文件损坏,已隔离备份至 {backup_path},并重置为空记录集。")
            return []

    def save_data(self, data: List[Dict[str, Any]]) -> bool:
        """安全持久化:先写入临时文件,确保落盘成功后再替换原文件,避免断电导致文件清空。"""
        temp_file = f"{self.filepath}.tmp"
        try:
            with open(temp_file, "w", encoding="utf-8") as f:
                json.dump(data, f, ensure_ascii=False, indent=2)
            os.replace(temp_file, self.filepath)
            return True
        except OSError as e:
            if os.path.exists(temp_file):
                os.remove(temp_file)
            print(f"[错误] 写入磁盘失败: {e}")
            return False
模块 3:CLI 交互入口组装(小型项目总装)
通过 argparse 将离散函数组装成具备实际操作价值的终端工具:
import argparse
import sys

DATA_STORE_PATH = "worklog_data.json"

def cli_add_record(storage: SafeJsonStorage, date_str: str, project: str, hours: float, note: str):
    try:
        valid_date = parse_and_validate_date(date_str)
    except ValueError as err:
        print(f"[输入错误] {err}")
        return

    if hours <= 0 or hours > 24:
        print("[输入错误] 单次工时必须在 0 到 24 小时之间。")
        return

    records = storage.load_data()
    record = {
        "id": len(records) + 1,
        "date": valid_date,
        "project": project.strip(),
        "hours": round(hours, 2),
        "note": note.strip()
    }
    records.append(record)
    if storage.save_data(records):
        print(f"[成功] 记录已添加: {valid_date} | {project} | {hours}h | {note}")

def cli_list_records(storage: SafeJsonStorage):
    records = storage.load_data()
    if not records:
        print("暂无工时记录。使用 'add' 子命令添加一条新记录。")
        return

    print(f"{'ID':<4} | {'日期':<10} | {'项目分类':<12} | {'工时(h)':<8} | {'备注'}")
    print("-" * 55)
    for r in records:
        print(f"{r['id']:<4} | {r['date']:<10} | {r['project']:<12} | {r['hours']:<8.1f} | {r['note']}")

def cli_show_report(storage: SafeJsonStorage):
    records = storage.load_data()
    if not records:
        print("暂无记录可供分析。")
        return

    report = aggregate_worklog(records)
    print("=== 工时统计汇总报表 ===")
    print(f"累计登记总工时: {report['total_hours']} 小时\n")
    print(f"{'项目分类':<14} | {'工时(h)':<10} | {'占比'}")
    print("-" * 38)
    for proj, stat in report["projects"].items():
        print(f"{proj:<14} | {stat['hours']:<10.1f} | {stat['percentage']}%")

def build_parser() -> argparse.ArgumentParser:
    parser = argparse.ArgumentParser(description="WorkLog Tracker: 轻量工时记录与分析小工具")
    subparsers = parser.add_subparsers(dest="command", help="支持的子命令")

    # add 命令
    p_add = subparsers.add_parser("add", help="添加一条工时记录")
    p_add.add_argument("-d", "--date", required=True, help="日期 (YYYY-MM-DD)")
    p_add.add_argument("-p", "--project", required=True, help="项目名称")
    p_add.add_argument("-t", "--hours", type=float, required=True, help="消耗工时(小时)")
    p_add.add_argument("-m", "--note", default="", help="工作备注")

    # list 命令
    subparsers.add_parser("list", help="查看所有历史记录")

    # report 命令
    subparsers.add_parser("report", help="生成项目分类汇总报表")

    return parser

def main():
    parser = build_parser()
    args = parser.parse_args()

    if not args.command:
        parser.print_help()
        sys.exit(0)

    storage = SafeJsonStorage(DATA_STORE_PATH)

    if args.command == "add":
        cli_add_record(storage, args.date, args.project, args.hours, args.note)
    elif args.command == "list":
        cli_list_records(storage)
    elif args.command == "report":
        cli_show_report(storage)

if __name__ == "__main__":
    main()
3. 操作验证与示例输出
将上述代码保存为 worklog.py。在命令行终端中执行如下指令进行验证(以下命令与运行结果分开呈现):
执行命令 1:添加一条合法记录
终端示例输出:
执行命令 2:测试防御机制,输入错误格式日期
终端示例输出:
执行命令 3:添加更多记录后生成汇总报表
终端示例输出:
四、常见误区与辨析
在将基础题转化为项目的过程中,初学者常常陷入以下三个误区,需要针对性地纠正:
误区 1:代码行数多、用了类和设计模式才算“项目”
辨析:项目的本质在于“针对真实需求提供闭环解决方案”,而不是代码行数的堆砌。一个仅有 100 行代码、但能正确处理参数、安全持久化且不轻易崩溃的终端小脚本,其工程完整度远胜于一个 1000 行却充斥着全局变量、毫无异常防护的长脚本。初学者不必强行套用复杂的工厂模式或庞大的三层架构,掌握“函数职责单一”与“分层解耦”即可满足绝大多数小型工具的构建。
误区 2:使用宽泛的 except Exception: pass 敷衍错误
辨析:许多初学者知道要做异常处理,但图省事直接写通配异常捕获并静默忽略。这种做法非常危险,它会悄悄吞掉语法错误、变量名拼写错误(NameError)和内存溢出,使得程序在发生致命错误时假装正常运行,给排查问题带来极大困难。正确的做法是:只捕获当前代码预期可能发生的特定异常(如 ValueError, FileNotFoundError),并在捕获后向用户输出清晰的修复提示。
误区 3:直接把多个题目的文件用 import 串在一起
辨析:如果基础题脚本里没有使用 if __name__ == '__main__': 包装,并在顶层直接执行了 input() 或 print(),那么在被其他脚本导入的那一刻,它就会立即弹窗或阻塞终端,导致主程序无法正常调度。必须先将练习题改写为无副作用的函数后,再进行跨文件引用。
五、总结:从单题到项目的自查清单
练习题是锻炼语法敏感度的“磨刀石”,而小型项目则是验证工程思维的“试金石”。完成转化后,可以使用以下四项检查清单来检验代码的工程达标度:
| 检查维度 | 合格标准 | 常见不合格表现 |
|---|---|---|
| 逻辑纯洁度 | 业务核心函数无全局变量依赖,无 input() 与 print(),入参和返回值清晰明确。 |
函数内直接调用 input() 索取输入,或计算结果直接打印无 return。 |
| 数据持久化 | 程序退出重启后,先前保存的业务状态与数据能够完整恢复;支持文件不存在时自愈。 | 数据只保存在列表变量中,程序一关闭数据全部丢失;或缺失文件直接抛错退出。 |
| 异常防御力 | 面对非法字符串、空值或边界数值时,提供清晰指引并优雅退出,绝不输出大段 Traceback。 | 输入格式稍有不符立即抛出未捕获的 ValueError 造成程序异常终止。 |
| 接口可用性 | 对外具备统一入口(如 argparse 命令行或规范模块名),既能独立运行也能被外部安全调用。 |
所有逻辑平铺在全局代码块,导入该脚本时立即强制执行全部测试用例。 |
按照这个思路,你可以把平时练习的“文本逆序题”、“质数筛选题”、“爬虫解析题”逐步拼接成“个人笔记索引工具”、“服务器指标监控脚本”等真实可用的日常小帮手,真正完成从“做题者”到“开发者”的能力蜕变。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









