

Python正则表达式中re模块与r前缀的关系
深入解析Python正则表达式中re模块与r前缀的本质关系,阐明Python字符串词法层与re正则引擎层的双层解析机制,通过代码示例与原理解析彻底解决反斜杠转义困扰。
r 前缀误当成 re 模块的一部分,甚至认为是 regex 的缩写。实际上,re 模块与 r 前缀分属于两个完全独立的层级:r 前缀(Raw String,原始字符串)是 Python 语言自身的词法分析修饰符,负责阻止 Python 解释器对反斜杠 \ 执行转义替换;而 re 是 Python 标准库内置的正则表达式匹配模块,负责接收字符串并将其编译为正则状态机。二者之所以总是结对出现,是因为正则表达式严重依赖反斜杠来定义元字符,而 r 前缀能够阻断 Python 解释器的提前介入,保证模式文本原封不动地交由 re 引擎解析。
一、层级分工:Python 词法分析与 re 正则引擎
要理解 re 与 r 的关系,关键在于看清 Python 程序运行时的两道工序。任何一段写在 .py 脚本或交互环境中的代码,在交由具体函数执行之前,都必须先通过 Python 解释器的词法分析(Lexical Analysis)。
这就构成了清晰的双层处理结构:
- 第一层:Python 解释器(词法与语法分析层)。解释器读取代码文本中的字符串字面量,根据语法规则将其转化为内存中的
str对象。在此阶段,普通字符串中的反斜杠会被解释为转义序列(例如r前缀,解释器就会关闭这套转义逻辑,字符字面值原样保留。 - 第二层:re 模块(正则表达式引擎层)。当调用
re.search()、re.match()或re.compile()时,re模块接收到的仅仅是一个普通的内存str对象。re引擎拥有自己独立的语法规范,会把接收到的字符序列解析为正则表达式状态机,并在其中寻找正则元字符(如\d代表数字、代表单词边界)。
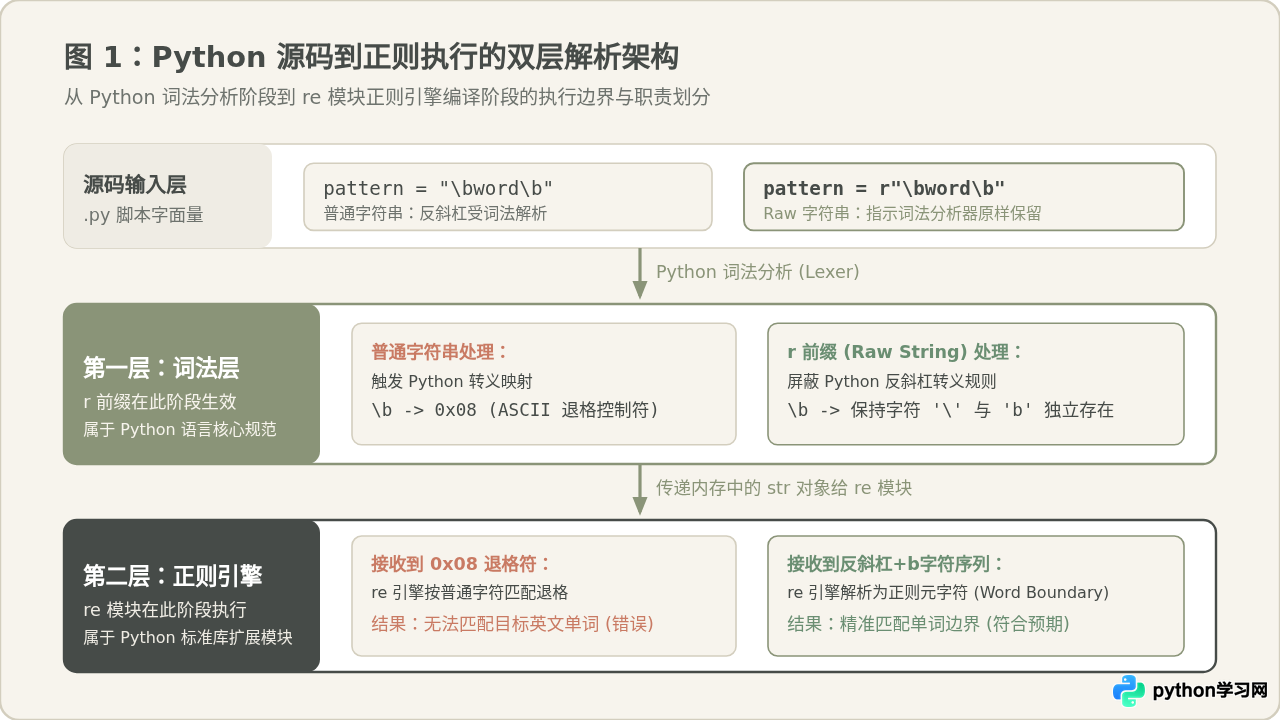
从架构图可以看出,r 前缀发生在第一层,属于 Python 语言的基础语法机制;re 模块运作在第二层,属于标准库业务逻辑。re 模块本身既看不到你是否写了 r,也不在乎这个字符串是如何生成的——它只对传入的 str 内容负责。
二、核心矛盾:反斜杠的双重转义困局
既然两者彼此独立,为什么编写正则表达式时却几乎必须带上 r 前缀?根本原因在于反斜杠 \ 在 Python 语法和正则表达式语法中同时承担了“转义引导符”的双重角色。
1. 致命的同名冲突:以词边界
在正则表达式语法中, 表示匹配一个单词的边界(Word Boundary),不消耗字符;而在 Python 字符串规范中, 对应 ASCII 编码为 0x08 的退格控制符(Backspace)。
如果编写正则时不加 r 前缀,灾难就会在第一阶段悄然发生:
import re

text = "cat category concatenation"

# 错误示范:使用普通字符串,未加 r 前缀
pattern_wrong = "cat"
result_wrong = re.findall(pattern_wrong, text)
print("普通字符串匹配结果:", result_wrong)
# 示例输出:普通字符串匹配结果: []

# 正确示范:使用 r 前缀定义原始字符串
pattern_correct = r"cat"
result_correct = re.findall(pattern_correct, text)
print("r前缀字符串匹配结果:", result_correct)
# 示例输出:r前缀字符串匹配结果: ['cat']
在上面的错误示范中,Python 解释器在看到 "cat" 时,根据字符串转义规则直接把 替换成了退格键字符 。re 模块收到的内容实际上是 'cat'。正则引擎以为你要在文本中寻找一个包含物理退格键的 cat,自然匹配落空。
而在 r"cat" 中,r 前缀阻止了解释器的转义折叠,进入内存的字符串明确保持了反斜杠与字母 b 两个独立字符,re 模块得以准确将其识别为词边界。
2. 匹配字面量反斜杠的“四斜杠”难题
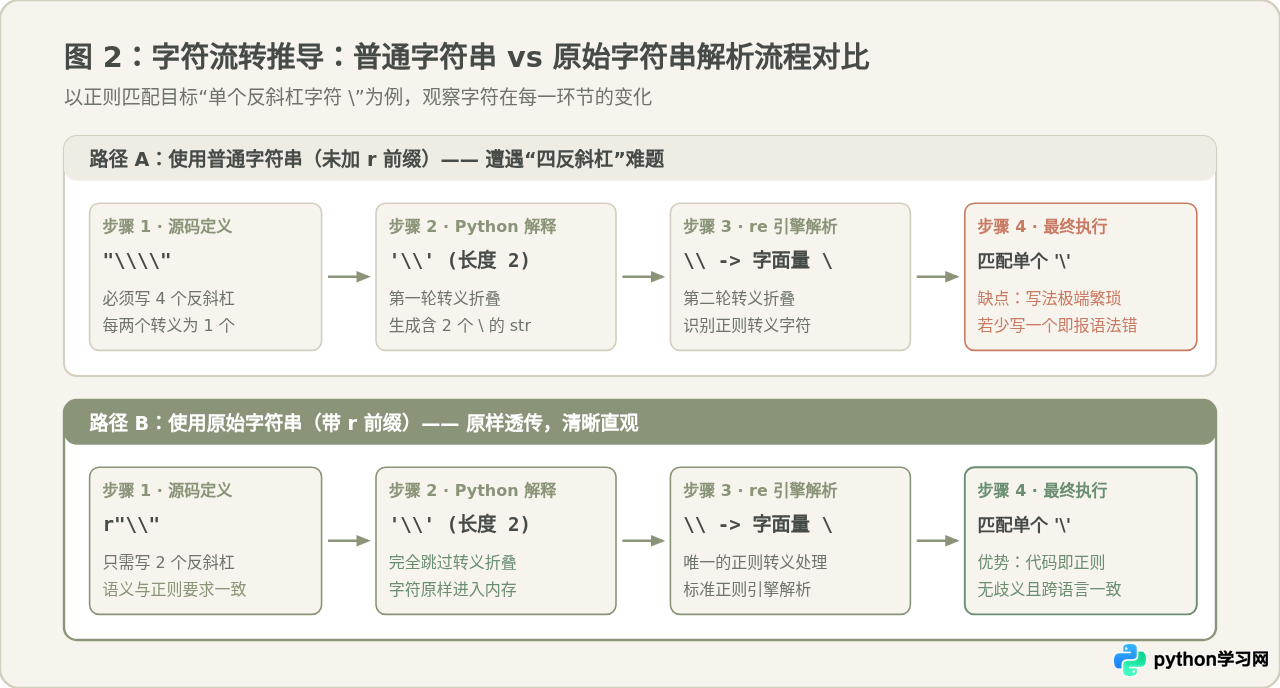
当需要匹配文本中真实存在的反斜杠(如 Windows 文件路径 C:\Windows\System32)时,矛盾更为剧烈。正则表达式语法规定,反斜杠自身是特殊符号,若要匹配字面量 \,必须用 \ 转义。
如果不使用 r 前缀:
- 要让
re模块收到两个反斜杠\,Python 字符串层面对每个反斜杠都需要转义; - 因此必须在源码中连续写出 4 个反斜杠:
"\\"; - Python 词法分析将
"\\"折叠为内存中的\; re模块拿到\,再将其解析为单个字面量\。
而使用 r 前缀时,Python 词法层不发生折叠,源码直接写 r"\",re 模块直接收到 \,逻辑完全吻合。
3. Python 3.12+ 的非法转义语法警告
过去很多人习惯写 "\d+" 或 "\w+",因为 \d 在 Python 语法中不是合法的控制字符,早期的 Python 解释器对此宽容处理,遇到未知的转义字符就原样保留了反斜杠。这就造成了一种“不加 r 也能跑”的错觉。
SyntaxWarning: invalid escape sequence '\d'。在未来的 Python 版本中,这一警告将直接升级为 SyntaxError 语法错误。因此,使用 r"\d+" 不仅是可读性规范,更是保证代码向后兼容的必要条件。
三、容易混淆的三个认知误区辨析
围绕 re 与 r 的关联,日常开发中有三种极具代表性的说法。这些说法往往抓住了一部分表象,但在逻辑上存在偏差:
误区一:“r 前缀是 re 模块的专用前缀”
辨析与修正:这种说法完全颠倒了概念归属。r 是 Python 内置的基础字面量修饰语法,早在没有导入 re 模块时就已经存在并生效。在任何需要保留原始反斜杠的场景中,r 都能独立发挥作用,例如:
- Windows 绝对路径:
path = r"C:
ew_folder	est.txt"
(避免 - LaTeX 数学公式字符串:
latex = r"rac{lpha}{eta}"; - 包含大量特殊符号的文档注释或代码模板。
误区二:“不用 r 前缀,正则表达式就无法运行”
辨析与修正:这种说法把“强烈推荐”误当成了“语法强制”。如果正则模式中没有任何反斜杠(例如 re.search("hello.*world", text)),普通字符串与带 r 的字符串在 Python 词法层解析结果完全相同,运行结果也毫无二致。即便包含反斜杠,只要程序员愿意写出像 "\\" 或 "\d+" 这样的转义代码,re 引擎同样能正常工作。不用 r 并不是“无法运行”,而是“极难书写、极易出错、极难维护”。
误区三:“加了 r 前缀后,正则表达式自身的转义就被禁用了”
辨析与修正:这种理解混淆了转义的生效层级。r 前缀仅仅且只能阻止 Python 字符串层面的转义,绝不会干扰 re 引擎内部的解析机制。写下 r"\d" 时,Python 解释器老老实实传递了 \ 和 d 两个字符,而 re 模块拿到之后,依然会把 \d 当作代表“0-9数字”的正则转义元字符来处理。
四、工程实践中的操作规范与边界陷阱
在实际编写生产代码时,建议遵循以下清晰的操作原则:
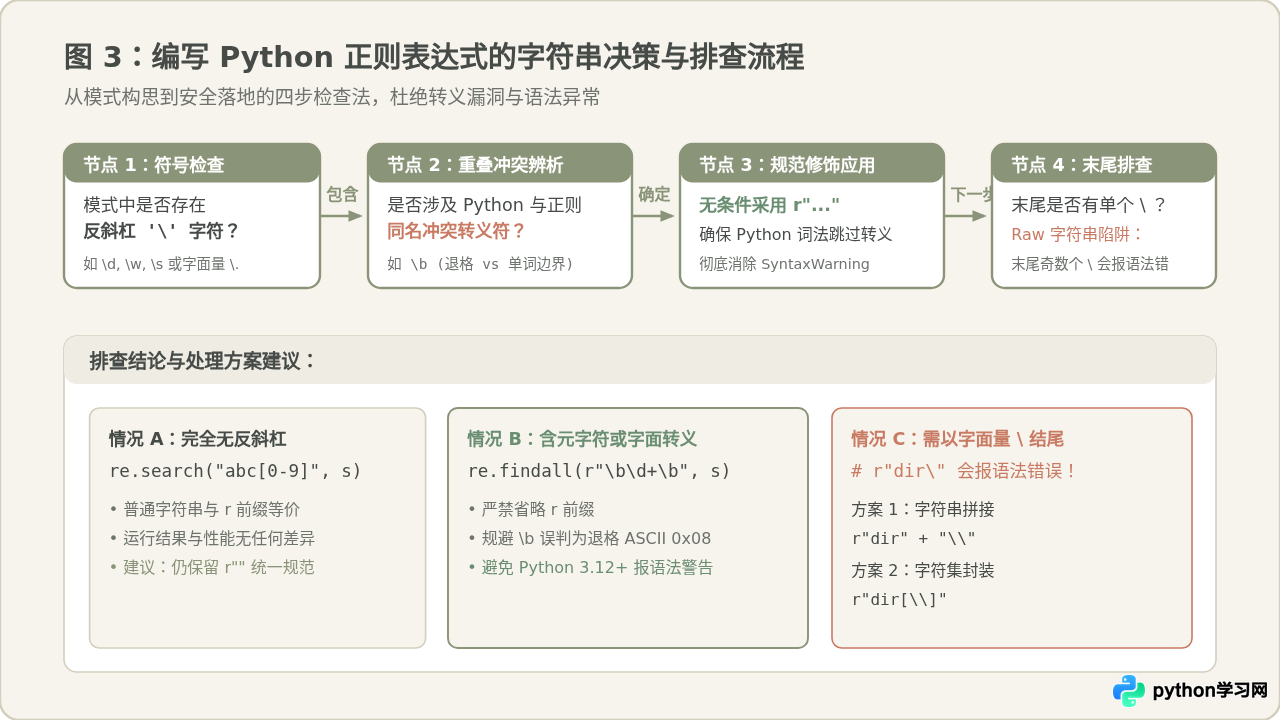
1. 编写正则模式时无条件使用 r""
不要根据“当前模式有没有斜杠”来决定是否加 r。模式在后续维护中随时可能增加 \d、\s 或边界锚点,统一采用 r"..." 前缀能够建立肌肉记忆,彻底免除后续改动时的转义审查成本。
2. 警惕 Raw 字符串的末尾反斜杠陷阱
虽然 r 前缀关闭了反斜杠的转义功能,但在 Python 词法解析器中,存在一条历史遗留规则:任何字符串(包括 raw 字符串)都不能以奇数个反斜杠结尾。
# 语法错误示例:尝试用原始字符串表达以单个反斜杠结尾的模式
# pattern = r"test"  -> SyntaxError: unterminated string literal
原因在于 Python 词法分析器即便在原始字符串中,遇到 " 时仍会认为反斜杠在对后方的引号进行转义,从而导致末尾的闭合引号被吃掉,直接报出字符串未闭合的语法错误。
若需要匹配以字面量反斜杠结尾的内容,推荐两种规避方案:
# 方案一:采用字符串普通拼接
pattern = r"test" + "\\"

# 方案二:利用正则表达式字符集方括号包裹
pattern = r"test[\]"
3. 动态字符串入正则时善用 re.escape()
r 前缀只对代码中的静态字面量起作用。如果正则模式中包含从外部用户输入、配置文件或网络请求中读取的动态变量,r 前缀无能为力。此时应当使用 re 模块提供的 re.escape() 函数对变量进行安全转义,防止注入攻击或模式解析错误:
import re

user_input = "item (v1.0)"  # 包含正则元字符括号
safe_keyword = re.escape(user_input)  # 转换为 'item\ \(v1\.0\)'

pattern = rf"{safe_keyword}"  # 结合 rf 前缀安全构造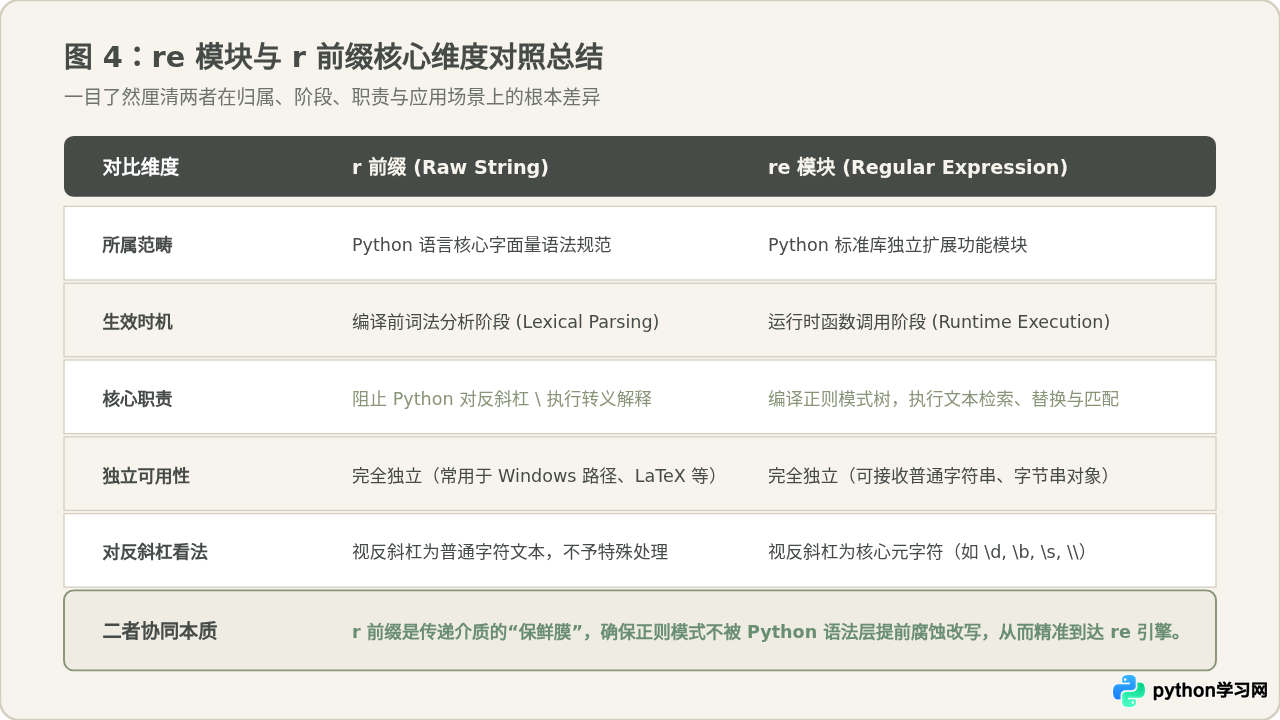
核心总结
简而言之,r 是 Python 语言层给开发者的“输入工具”,用于保障字符串字面量不被提前篡改;re 是标准库给开发者的“处理引擎”,用于对已经生成的字符串执行正则编译与匹配。
二者虽无直接代码绑定,却在分工协作中达成了最佳实践:用 r 锁定输入文本,用 re 发挥正则威力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









