

从Python基础语法到办公自动化实战的学习路线
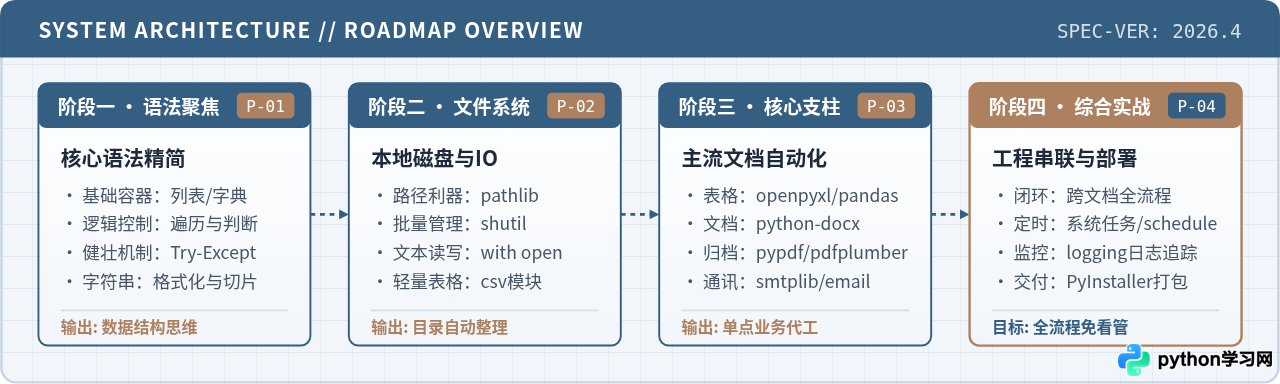
系统梳理从Python基础语法向办公自动化实操进阶的完整学习路线。明确语法聚焦与取舍边界,提供文件整理、Excel汇算、Word报告批量生成及工程化调度实战方案与规范。
第一阶段:面向办公场景的基础语法取舍
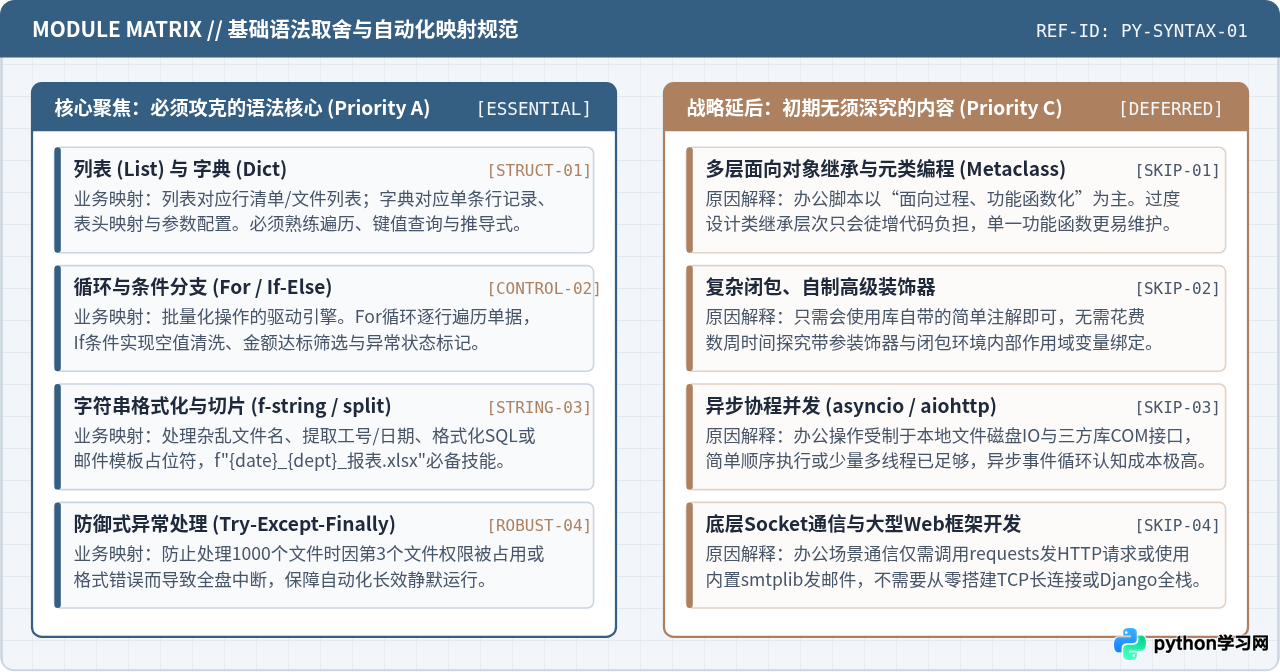
许多初学者在学习 Python 时容易陷入误区:试图把一本数百页的语法教程从头到尾学完,结果花费数周时间在面向对象多重继承、元类、自制装饰器和异步事件循环上,却连批量修改文件夹中的十个文件名都无从下手。办公自动化的核心工作逻辑是数据批处理,因此对语法的学习应当高度聚焦于数据容器与流程控制。
1. 必须优先掌握的五项核心语法
- 列表(List)与字典(Dict):在办公场景中,列表直接对应多行记录、多份文件路径清单;字典则对应单条结构化数据(如 Excel 的单行内容:字段名为键,单元格为值)。必须熟练掌握字典的键值存取(
dict.get()设置默认值)、列表推导式以及二者的多层嵌套遍历。 - For 循环与枚举(enumerate / zip):自动化操作的本质就是用循环替代人工逐个点击。掌握遍历列表、字典键值对,以及利用
zip()对齐多个数据列,利用enumerate()获取带行号的序号。 - 条件判断与布尔逻辑(if-elif-else):用于数据清洗与业务逻辑校验,例如判断单元格数值是否为空、金额是否大于预算阈值、文件名是否包含特定日期关键字。
- 字符串切片与格式化(f-string):办公流程中涉及大量的动态命名。必须熟练使用
f"{dept}_{date}_汇总表.xlsx"构造路径,以及使用str.strip()清理多余空格、str.replace()替换特殊字符、str.split()拆分工号与部门。 - 防御式异常处理(try-except):批量处理上百份表格时,极易因其中某一份表格格式破损、缺少列或被其他程序占用而报错中断。使用
try-except捕获具体异常(如KeyError,ValueError,FileNotFoundError),记录跳过原因后继续执行后续文件,是脚本能在实际业务中稳定运行的关键。
2. 办公自动化初期应果断延后的语法内容
在起步阶段,读者应主动舍弃以下技术细节:复杂的类继承体系(办公脚本以结构清晰的函数组合为主)、深层闭包与自制元编程装饰器、asyncio 异步协程(办公自动化主要受限于本地磁盘与 COM 接口,多线程或顺序流已完全足够),以及底层网络套接字编程。将有限的精力聚焦在真正能产生价值的数据处理机制上。
第二阶段:本地文件系统与基础数据流自动化
掌握了核心语法后,进入自动化的第一道实战关卡是掌控本地磁盘。办公环境中的原始资料往往以零散文件的形式分散在各级子目录中,手动查找、解压与重命名费时费力。此阶段的目标是使用 Python 内置库实现磁盘操作全自动化。
1. 文件操作的技术选型:pathlib 优于 os.path
早期的 Python 教程多使用 os.path 进行字符串拼接,极易在 Windows 反斜杠(\)与 Unix 正斜杠(/)之间引发路径转义错误。现代 Python 推荐全面采用标准库 pathlib.Path,它以面向对象方式封装路径操作,支持跨平台斜杠操作符 /、属性提取(.stem 获取主文件名、.suffix 获取后缀)以及模式通配符检索(.glob() 与 .rglob())。配合标准库 shutil,可无缝完成文件复制、剪切与压缩包解压。
2. 实战任务:混乱下载目录按类别与日期自动归档
下面是一个标准的实用脚本。它扫描指定的下载目录,排除临时文件,按扩展名分类创建对应归档目录,并将 30 天未修改的文件重命名附加修改日期后迁移归档。
from pathlib import Path
import shutil
import datetime

def organize_download_folder(target_dir: str):
    base_path = Path(target_dir).resolve()
    if not base_path.exists():
        print(f"[错误] 目标路径不存在: {base_path}")
        return

    # 定义目标类别及对应的文件后缀
    rule_map = {
        "表格文件": [".xlsx", ".xls", ".csv"],
        "文档资料": [".docx", ".doc", ".pdf", ".pptx"],
        "压缩归档": [".zip", ".rar", ".7z", ".tar.gz"],
        "图片资源": [".png", ".jpg", ".jpeg", ".svg"]
    }

    archive_root = base_path / "归档目录"
    archive_root.mkdir(exist_ok=True)
    summary_count = {category: 0 for category in rule_map}
    summary_count["其他杂项"] = 0

    # 遍历目标目录下的所有顶层文件(跳过子文件夹)
    for file_path in base_path.iterdir():
        if file_path.is_dir() or file_path.name.startswith("~"):
            continue

        ext = file_path.suffix.lower()
        matched_category = "其他杂项"
        for category, extensions in rule_map.items():
            if ext in extensions:
                matched_category = category
                break

        dest_dir = archive_root / matched_category
        dest_dir.mkdir(exist_ok=True)

        # 获取文件修改时间并格式化
        mtime = datetime.datetime.fromtimestamp(file_path.stat().st_mtime)
        date_str = mtime.strftime("%Y%m%d")
        new_name = f"{date_str}_{file_path.name}"
        dest_file = dest_dir / new_name

        try:
            shutil.move(str(file_path), str(dest_file))
            summary_count[matched_category] += 1
            print(f"[已整理] {file_path.name} -> {matched_category}/{new_name}")
        except Exception as e:
            print(f"[跳过] 移动文件失败 {file_path.name}: {e}")

    print("
--- 整理结果汇总 ---")
    for cat, count in summary_count.items():
        print(f"{cat}: {count} 个文件")

if __name__ == "__main__":
    # 执行示例:请传入读者本地的实际测试目录
    organize_download_folder("./workspace/downloads")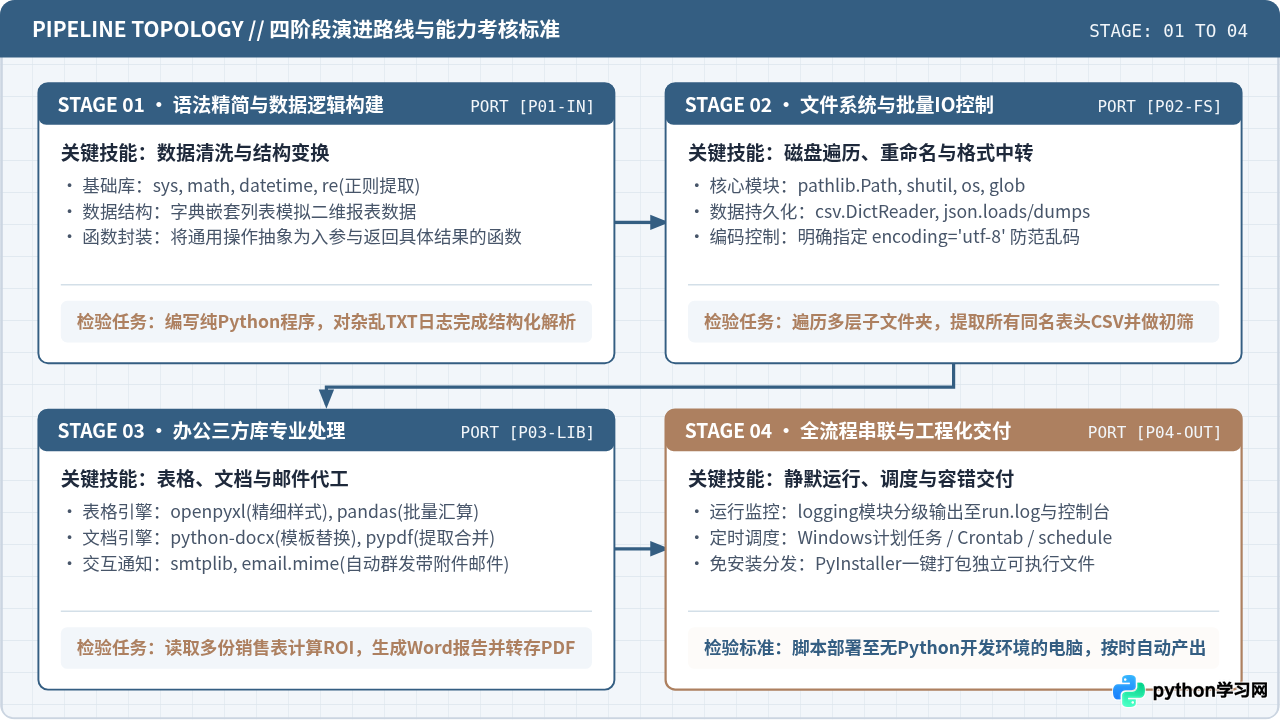
第三阶段:办公自动化三大核心支柱实战
在具备文件组织能力后,学习重点应转入办公软件的三大核心介质:Excel 数据处理、Word/PDF 报告输出,以及邮件/通知的分发。这三大支柱构成了现代企业自动化办公的核心骨架。
1. Excel 自动化:openpyxl 与 pandas 的合理分工
处理 Excel 时,初学者常在 openpyxl 与 pandas 之间举棋不定。两者的使用边界非常明确:
| 对比维度 | openpyxl | pandas |
|---|---|---|
| 核心专长 | 样式调整、公式保留、插入图表、跨单元格合并、模板填报 | 批量多表聚合(Merge)、分组透视(Groupby)、海量数值清洗 |
| 运算性能 | 基于单元格逐个操作,数据量超 5 万行时较慢 | 底座基于 C/NumPy 向量化运算,数十万行秒级统计 |
| 样式控制 | 精细控制字体颜色、填充底色、边框网格线 | 主要聚焦纯数据本身,原生样式导出能力较简略 |
| 最佳场景 | 按照公司既定精美排版模板填充最终结果表 | 读取 20 个分支机构的原始台账并做统一合并汇总 |
2. 实战任务:多部门销售月报自动聚合与异常标红
业务场景:各部门每月分别上报 Excel 台账,需要将多张工作表合并,计算各部门销售总额与达成率,并将达成率低于 80% 的单元格自动填充浅红底色以示预警。
from pathlib import Path
import pandas as pd
import openpyxl
from openpyxl.styles import PatternFill, Font, Alignment, Border, Side

def process_sales_reports(input_dir: str, output_file: str):
    data_dir = Path(input_dir).resolve()
    all_data = []

    # 1. 批量遍历各部门报表
    for xlsx_file in data_dir.glob("*.xlsx"):
        if xlsx_file.name.startswith("~") or xlsx_file.name == Path(output_file).name:
            continue
        try:
            df = pd.read_excel(xlsx_file, engine="openpyxl")
            # 校验必需字段
            required_cols = {"部门", "销售员", "目标额", "实际额"}
            if not required_cols.issubset(set(df.columns)):
                print(f"[警告] {xlsx_file.name} 缺少必要列,跳过处理")
                continue
            all_data.append(df)
        except Exception as e:
            print(f"[报错] 读取文件失败 {xlsx_file.name}: {e}")

    if not all_data:
        print("[提示] 未找到有效的销售数据文件")
        return

    # 2. 使用 pandas 完成分组聚合与指标核算
    combined_df = pd.concat(all_data, ignore_index=True)
    summary = combined_df.groupby("部门", as_index=False)[["目标额", "实际额"]].sum()
    summary["达成率(%)"] = (summary["实际额"] / summary["目标额"] * 100).round(2)
    summary["状态"] = summary["达成率(%)"].apply(lambda x: "达成" if x >= 100 else ("预警" if x < 80 else "正常"))

    # 3. 输出至临时文件并使用 openpyxl 进行样式美化
    temp_output = Path(output_file).resolve().with_suffix(".tmp.xlsx")
    summary.to_excel(temp_output, index=False, engine="openpyxl")

    wb = openpyxl.load_workbook(temp_output)
    ws = wb.active
    ws.title = "部门达成汇总"

    # 样式配置:工程蓝表头,浅红预警填充
    header_fill = PatternFill(start_color="345E82", end_color="345E82", fill_type="solid")
    header_font = Font(name="Microsoft YaHei", size=11, bold=True, color="FFFFFF")
    warn_fill = PatternFill(start_color="FCE8E6", end_color="FCE8E6", fill_type="solid")
    warn_font = Font(name="Microsoft YaHei", size=10, color="C5221F", bold=True)
    thin_border = Border(
        left=Side(style='thin', color='CBD5E1'),
        right=Side(style='thin', color='CBD5E1'),
        top=Side(style='thin', color='CBD5E1'),
        bottom=Side(style='thin', color='CBD5E1')
    )

    # 渲染表头
    for col in range(1, ws.max_column + 1):
        cell = ws.cell(row=1, column=col)
        cell.fill = header_fill
        cell.font = header_font
        cell.alignment = Alignment(horizontal="center", vertical="center")

    # 渲染数据行与预警
    for row in range(2, ws.max_row + 1):
        rate_cell = ws.cell(row=row, column=4)  # 达成率列
        status_cell = ws.cell(row=row, column=5) # 状态列

        for col in range(1, ws.max_column + 1):
            c = ws.cell(row=row, column=col)
            c.border = thin_border
            c.font = Font(name="Microsoft YaHei", size=10)

        # 达成率低于 80% 则标红预警
        if rate_cell.value and float(rate_cell.value) < 80.0:
            rate_cell.fill = warn_fill
            rate_cell.font = warn_font
            status_cell.fill = warn_fill
            status_cell.font = warn_font

    # 自适应列宽
    for col in ws.columns:
        max_len = max(len(str(cell.value or '')) for cell in col)
        col_letter = openpyxl.utils.get_column_letter(col[0].column)
        ws.column_dimensions[col_letter].width = max(max_len * 2.2, 14)

    wb.save(temp_output)
    # 原子性替换为正式输出文件
    target_path = Path(output_file).resolve()
    temp_output.replace(target_path)
    print(f"[成功] 汇总报表已生成: {target_path}")

if __name__ == "__main__":
process_sales_reports("./sales_data", "./reports/2026_03_部门月报汇总.xlsx")3. Word/PDF 模板自动化与邮件分发
在生成结构化数据报表后,业务下游往往需要将汇总数据注入到正式的 Word 总结报告模板中,并最终转换为 PDF 归档发送给管理层:
- Word 报告批量套打:使用
python-docx打开固定排版的模板文档,通过正则遍历段落查找约定的占位符(例如{department_name}、{total_sales}),将其替换为清洗后的数据,并在指定书签位置动态插入汇总表格或 Matplotlib 生成的趋势图。 - PDF 提取与无缝合并:对于现存的不可编辑发票与审批单,使用
pypdf库进行多页合并、加盖水印或页面拆分;若需要提取 PDF 中的非结构化表格数据,则引入pdfplumber提取表格文本并转化为 pandas DataFrame。 - 邮件自动发送(smtplib + email):使用 Python 内置的
smtplib连接企业邮箱 SMTP 服务器,利用email.mime.multipart.MIMEMultipart构造邮件正文,将生成的 Excel 或 PDF 文件以二进制流形式加载为附件(application/octet-stream),实现一键分发与抄送。
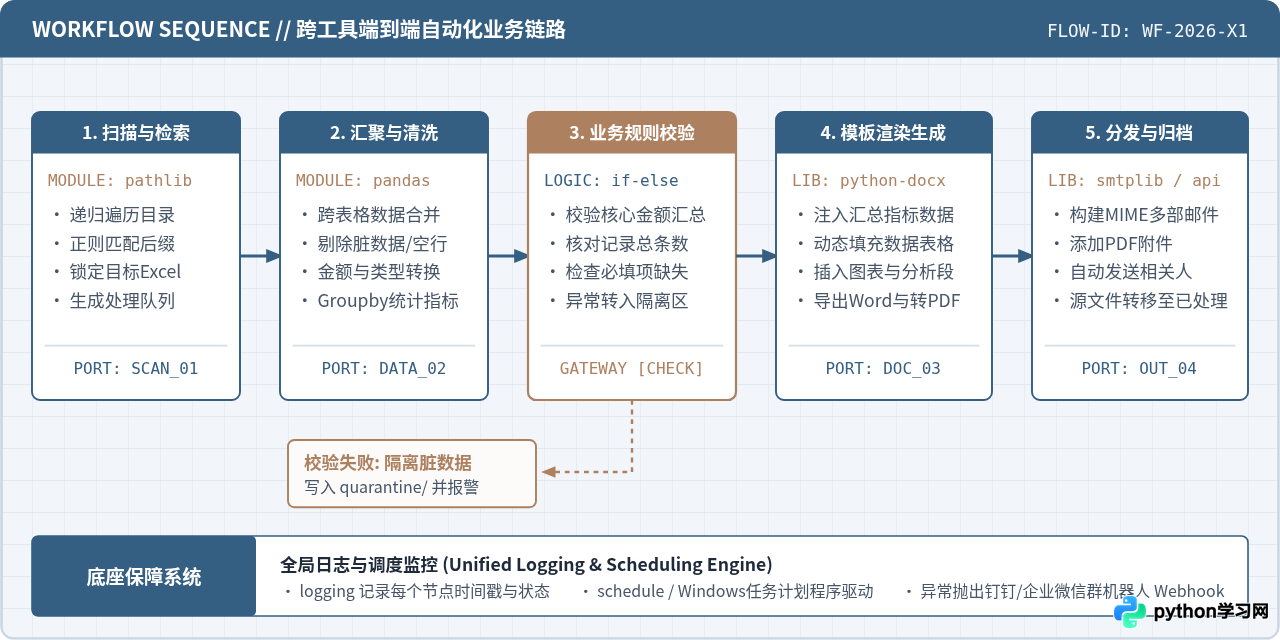
第四阶段:综合工作流串联与工程化部署
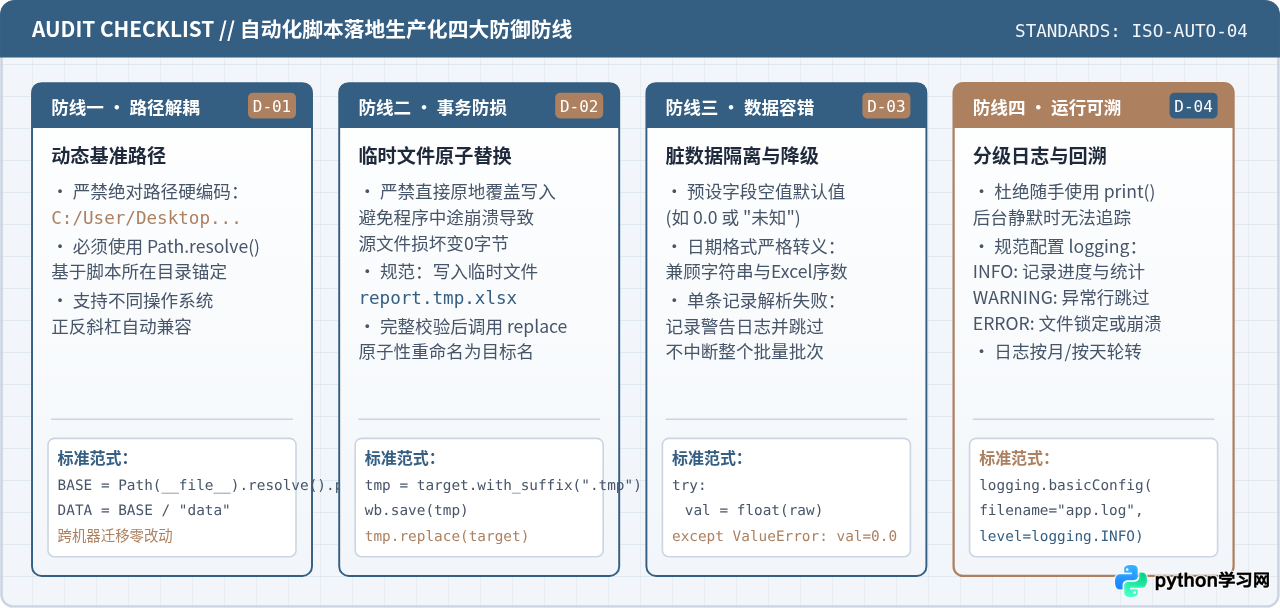
完成了单点脚本编写后,真正的挑战在于让脚本“脱离开发者的手动点击,在无人值守的生产环境中稳定运作”。这就是自动化工程化的核心目标。本节梳理生产化必须落实的四大防线。
1. 路径动态解耦与跨平台适配
初学者代码中最常见的失效隐患是写死类似 C:\Users\Administrator\Desktop\data 的绝对路径。一旦将脚本发给同事或部署在其他电脑上,就会立即崩溃。标准的做法是始终通过当前文件位置计算相对路径基准:
# 规范做法:始终以当前脚本所在文件路径为基准锚点
BASE_DIR = Path(__file__).resolve().parent
INPUT_DIR = BASE_DIR / "inputs"
OUTPUT_DIR = BASE_DIR / "outputs"
INPUT_DIR.mkdir(parents=True, exist_ok=True)
2. 使用 logging 替代 print 进行运行追踪
当自动化程序挂载在系统后台定时执行时,没有任何交互控制台能看到 print() 输出。此时必须配置标准库 logging,按日期将执行进度、跳过的脏数据和错误堆栈完整记录到日志文件中,便于事后排查与审计。
import logging
from pathlib import Path

def setup_logger(log_dir: Path) -> logging.Logger:
    log_dir.mkdir(parents=True, exist_ok=True)
    log_file = log_dir / "automation_runtime.log"

    logger = logging.getLogger("OfficeAutomation")
    logger.setLevel(logging.INFO)

    # 避免重复挂载 Handler
    if not logger.handlers:
        file_handler = logging.FileHandler(log_file, encoding="utf-8")
        formatter = logging.Formatter(
            fmt="%(asctime)s [%(levelname)s] (%(filename)s:%(lineno)d) - %(message)s",
            datefmt="%Y-%m-%d %H:%M:%S"
        )
        file_handler.setFormatter(formatter)
        logger.addHandler(file_handler)

    return logger
3. 自动化任务调度机制
定时运行并不需要自写死循环加 time.sleep(),后者既耗费 CPU 资源又极易因系统睡眠而失效。生产环境有两种推荐策略:
- 系统原生调度(首选):在 Windows 系统中使用“任务计划程序”(Task Scheduler),新建基本任务,触发器设置为每日固定时间,操作设置为启动 Python 解释器并指定脚本绝对路径;在 macOS / Linux 环境中使用
crontab。 - 轻量级代码内调度:使用第三方库
schedule库编写长驻守护进程,语法直观:schedule.every().day.at("18:30").do(job)。
4. 免安装环境打包交付(PyInstaller)
为了让未安装 Python 环境的业务同事也能直接使用自动化成果,可使用 pyinstaller -F -w main.py 将整个项目及其依赖库打包为一个独立的 .exe 应用程序。结合 config.ini 配置文件,业务人员无需接触代码,只需修改配置文件中的路径与阈值即可自如使用。
学习成果检验标准与避坑指南
完成全流程学习后,读者可依据以下里程碑清单客观评估自己的掌握程度,并对照避开高发陷阱:
| 进阶节点 | 能力考核标准 | 典型业务场景 |
|---|---|---|
| 基准达标 | 能用标准库遍历目录,对多份文件重命名、提取 CSV 并输出清洗后的列表。 | 下载目录自动归档、按日期整理历史日志。 |
| 单项熟练 | 能熟练运用 openpyxl / pandas 批量读写 Excel,并进行跨表匹配与样式美化。 | 多部门月度报表合并计算、员工考勤汇总。 |
| 跨介质串联 | 能将 Excel 清洗结果注入 Word 模板生成 PDF 附件,并自动发送邮件。 | 薪资单自动生成与个性化邮件一对一分发。 |
| 生产级交付 | 具备完善的异常跳过机制、日志记录、原子性文件防损写入与定时调度能力。 | 无人值守每日清晨自动跑批生成经营看板。 |
在编写自动化脚本时,永远不要直接对原始数据文件执行写操作。网络波动、断电、内存溢出或字段格式转换异常都可能导致写入中途崩溃,从而将原文件损坏为 0 字节的空文件。工程化最佳实践是:先读取原文件,处理完毕后先写入带有 .tmp 后缀的临时文件;在验证临时文件大小与格式无误后,再调用 replace() 方法进行原子替换,或将处理结果写入独立的输出目录中并对源文件做备份存档。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









