

Python快速排序是稳定排序吗
深入解答Python快速排序是否为稳定排序。从算法原理、Lomuto分区跨距交换过程追踪、Python内置Timsort底层机制,到代码实测与工程选型决策,全面理清快速排序与稳定性的关系。
核心结论先行:从经典算法理论角度来看,标准的快速排序(QuickSort)是一种不稳定排序;而在 Python 编程实践中,初学者常误以为内置的 list.sort() 和 sorted() 采用的是快速排序,但实际上 Python 自带的底层排序算法是基于归并与插入思想设计的 Timsort(Python 3.11+ 优化为 Powersort),它是一种严格稳定的排序算法。如果开发者在 Python 中手动编写原地快速排序,其表现依然是不稳定的。
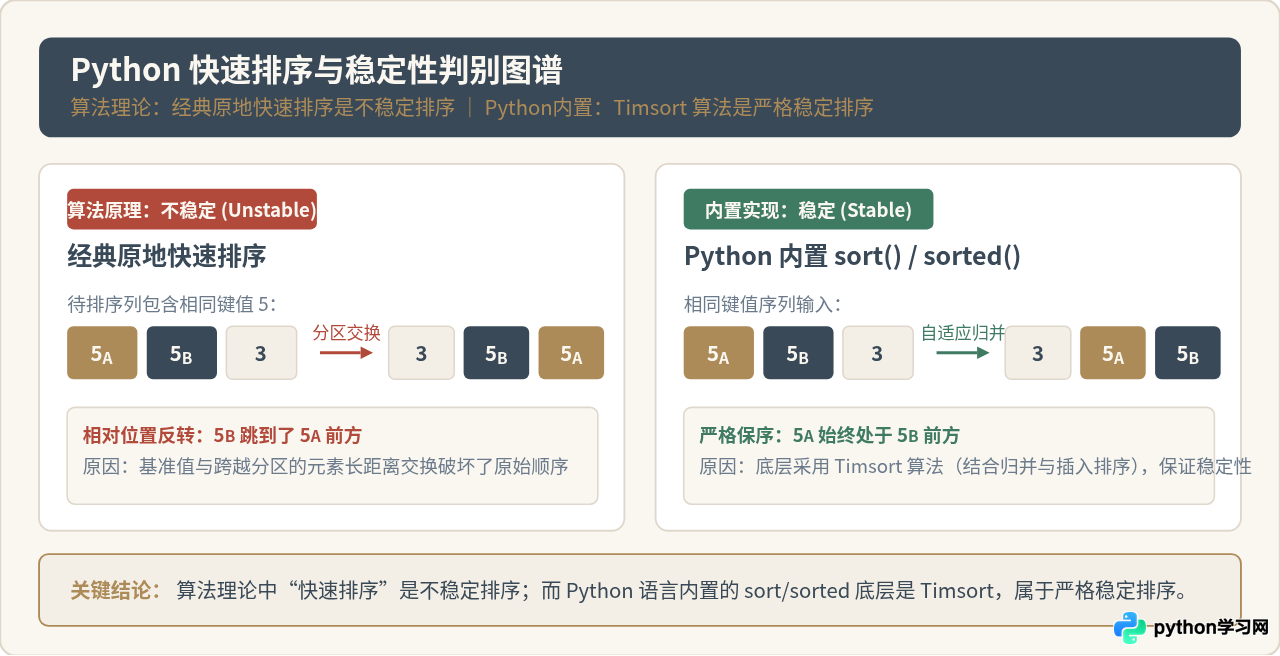 图 0:快速排序的理论属性与 Python 实际内置排序机制全景对照
一、什么是排序的“稳定性”,为什么它很重要?
在数据结构与算法中,排序算法的“稳定性(Stability)”有着严格的数学定义:如果待排序的序列中存在两个或多个键值相等的元素,在排序完成后,这些相同元素之间的相对前后顺序依然保持不变,则该排序算法是稳定的;反之,如果在排序过程中它们原有的相对先后次序可能发生颠倒,则该算法被归类为不稳定排序。
形式化表述为:假设输入序列为 A,其中有两个元素 A[i] 与 A[j]。在排序前有 i < j 且它们对应的排序关键字相等 key(A[i]) == key(A[j])。如果排序算法输出的新序列中,A[i] 必定依然出现在 A[j] 之前,该算法就是稳定的。
在纯数字单一维度的排序任务中,数值 5 无论排在另一个数值 5 的左边还是右边,表面上毫无差别。但在现代软件业务开发中,数据对象往往包含多个属性字段。此时稳定性直接决定了程序逻辑的正确性:
- 多关键字级联排序:例如在电商后台,运营人员希望将订单按“下单时间”升序排列,同时在金额相同的情况下保留先后次序。如果底层算法具备稳定性,只需先按“下单时间”排一次,再按“订单金额”排一次即可;若算法不稳定,第二次排序就会直接冲乱先前排好的时间顺序。
- UI 界面呈现的一致性:用户在网页表格中先按姓名排好序,再点击状态列排序时,稳定的排序能够确保状态相同的行保持原有的字母顺序,避免界面跳动和状态紊乱。
二、经典快速排序为何是不稳定排序?
快速排序之所以被公认为计算机科学中最优雅的算法之一,是因为它采用了分治思想(Divide and Conquer),通过选定一个基准元素(Pivot),并在数组内部通过指针双向或单向扫描,将序列就地划分为“小于基准”与“大于基准”两大部分。
然而,正是快速排序赖以成名的“原地长距离交换(In-place Discontinuous Swap)”机制,直接破坏了等值元素的相对位置。无论是采用 Hoare 原始双向双指针分区方案,还是单向的 Lomuto 分区方案,只要基准值或违规逆序对在数组内部发生跨越多个元素的交换,相同键值项的次序就会被悄然打破。
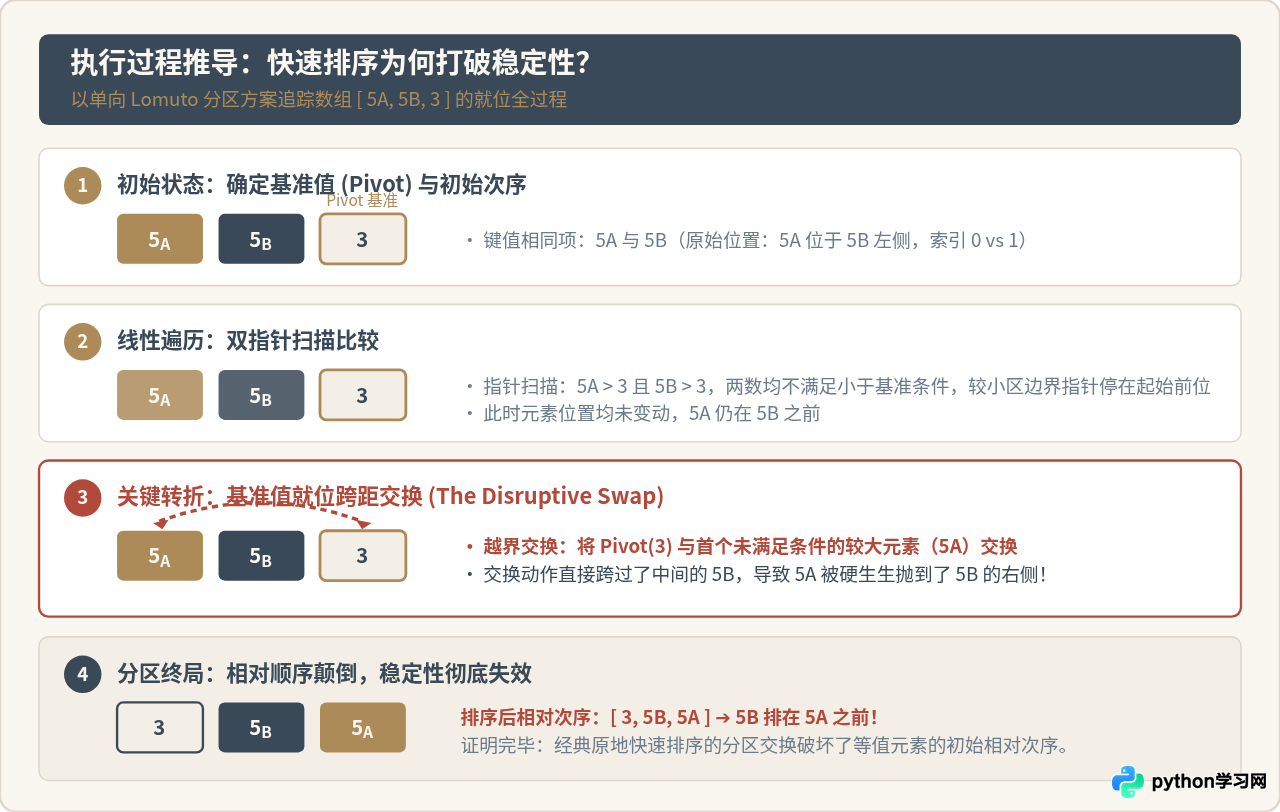 图 1:单向 Lomuto 分区下同值元素发生跨距交换打乱顺序的完整推导步骤
让我们以图 1 所示的极简数组为例进行逐步推导:
设输入待排数组为 [ 5A, 5B, 3 ]。其中 5A 与 5B 的数值大小均为 5,但在初始列表中 5A 处于索引 0,5B 处于索引 1。我们选取末尾元素 3 作为分区基准(Pivot):
-
扫描阶段:遍历指针从左向右依次检查元素。
5A大于基准值 3,不进行扩容;接着检查5B,同样大于基准值 3。此时小于基准的区域边界指针仍停留在数组最左侧的外侧(即索引 -1)。 -
基准就位交换:遍历完成后,需要将基准元素
3放置到它应处的正确边界位置上,算法执行将3与较小区域右侧的第一个元素(即索引 0 处的5A)进行原地交换。 -
交换结果:数组从原本的
[ 5A, 5B, 3 ]变为了[ 3, 5B, 5A ]。
仔细观察最终结果:数值同为 5 的两个元素,原本位于前面的 5A,在经过这次长距离跨越交换之后,被硬生生抛到了 5B 的右侧!相对位置由原来的 5A 在前、5B 在后 变为了 5B 在前、5A 在后。这个简单而确凿的数学推导证实:经典原地快速排序是不稳定排序。
三、Python 代码实测:验证手写快排的不稳定性
为了让读者在实际编程中直观验证这一结论,我们在 Python 中实现一个标准的 Lomuto 原地快速排序算法,并传入一组带有原始输入序号的对象进行测试。
class Item:
    """包装测试对象:带有数值键与原始序号标记"""
    def __init__(self, key: int, tag: str):
        self.key = key
        self.tag = tag

    def __repr__(self):
        return f"{self.key}({self.tag})"

def quicksort_inplace(arr: list, low: int, high: int):
    """标准原地快速排序实现(Lomuto 分区)"""
    if low < high:
        pivot_idx = partition(arr, low, high)
        quicksort_inplace(arr, low, pivot_idx - 1)
        quicksort_inplace(arr, pivot_idx + 1, high)

def partition(arr: list, low: int, high: int) -> int:
    pivot = arr[high].key
    i = low - 1  # 较小元素的边界指针
    for j in range(low, high):
        if arr[j].key <= pivot:
            i += 1
            arr[i], arr[j] = arr[j], arr[i]  # 发生元素交换
    # 将基准值交换至正确分区切分点
    arr[i + 1], arr[high] = arr[high], arr[i + 1]
    return i + 1

# 测试验证
if __name__ == "__main__":
    # 构造包含多个相同键值的测试数据
    data = [Item(5, "A"), Item(5, "B"), Item(3, "C")]
    print("排序前:", data)
    quicksort_inplace(data, 0, len(data) - 1)
    print("排序后:", data)
在终端中运行上述代码,将得到明确的输出:
# 示例输出:
排序前: [5(A), 5(B), 3(C)]
排序后: [3(C), 5(B), 5(A)]
输出结果清晰地证实了理论推导:5(B) 出现在了 5(A) 之前。即使在 partition 的判定条件中将 arr[j].key <= pivot 改为严格小于 <,也仅仅是改变了基准值相等时的分支走向,在双指针相向扫描或基准就位长跨度交换时,依旧存在其他模式导致同值元素位移颠倒。
四、澄清误区:Python 内置的 sort() 是快速排序吗?
在 Python 初学者乃至部分有经验的工程师群体中,存在一个广泛流传的误区:“快速排序那么快,Python 自带的 list.sort() 和 sorted() 肯定是用快速排序写的吧?”
答案是坚决的否定:Python 自带的排序不是快速排序,而是 Timsort。
在 Python 2.3 之前,官方早期的实现确实曾探索过快速排序的变体(Samplesort),但在工程实践中发现,纯粹的快速排序在面对真实业务数据时存在致命痛点:
- 最坏时间复杂度崩溃:一旦基准选取策略失误(如面对近乎有序或完全逆序的数据),快排的时间复杂度会从 O(n log n) 恶化为 O(n²),这在 Web 服务中极易引发拒绝服务攻击(Algorithmic Complexity Attack)。
- 缺乏稳定性:无法满足企业级业务中对数据多维保序的硬性需求。
为了彻底解决这一矛盾,Python 核心开发者 Tim Peters 于 2002 年设计出了著名的 Timsort 算法。Timsort 是一种高度工程化的自适应混合算法:
- 它首先在线性扫描中检测数据中天然存在的连续有序段(称为 Runs,无论是升序还是降序)。
- 对于极短的序列,利用缓存友好度极高且稳定的二分插入排序(Binary Insertion Sort)将其扩充至合适长度。
- 最后借助内存栈,依照严格平衡的约束规则进行两路归并(Merge)。
因为整个合并过程遵循归并排序的单向合并逻辑,Timsort 从算法数学原理上就是严格稳定的。此外,在处理真实世界中往往已经存在局部有序特征的数据时,Timsort 能达到令人惊叹的 O(n) 线性时间复杂度。
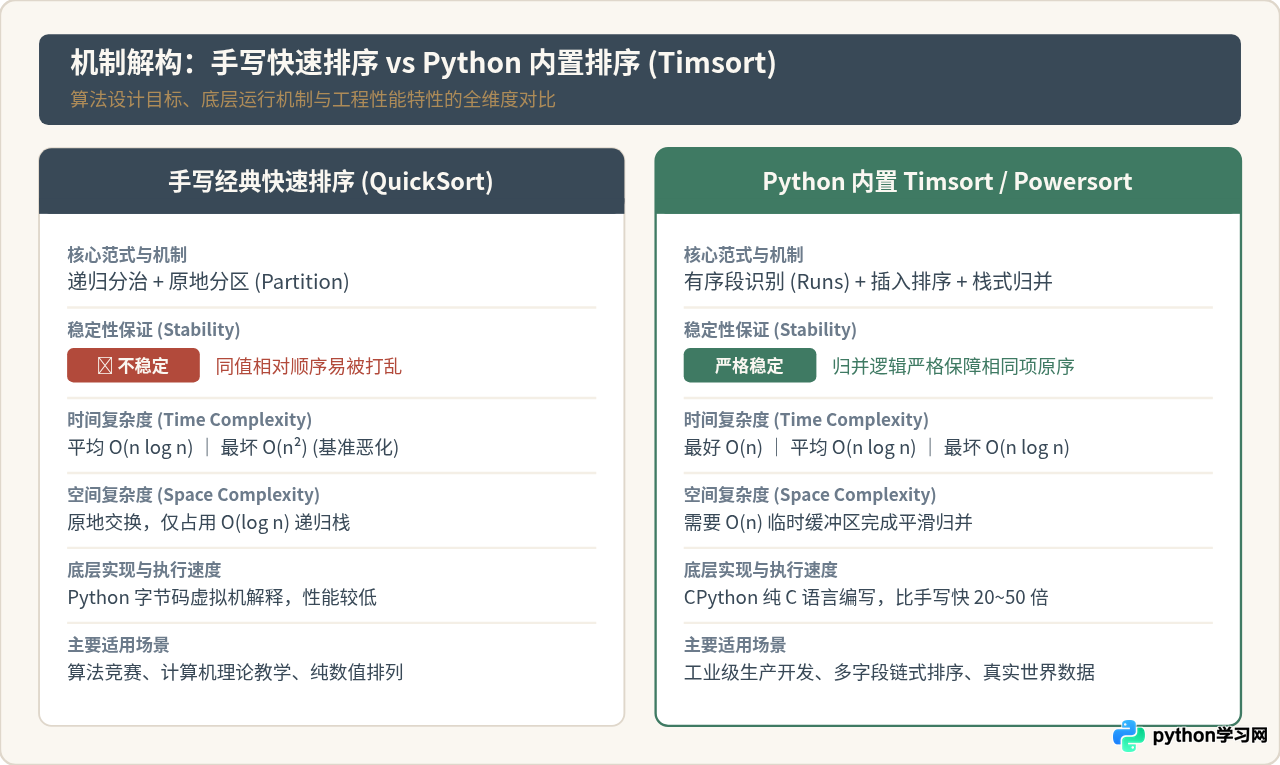 图 2:手写快速排序与 Python 内置 Timsort 算法在设计范式与工程指标上的全方位对比
| 特性对比维度 | 经典快速排序 (QuickSort) | Python 内置排序 (Timsort / Powersort) |
|---|---|---|
| 算法稳定性 | 不稳定 (Unstable) | 严格稳定 (Stable) |
| 平均时间复杂度 | O(n log n) | O(n log n) |
| 最好时间复杂度 | O(n log n) | O(n)(面对已有序数据) |
| 最坏时间复杂度 | O(n²)(基准选择恶化时) | O(n log n)(平衡归并树保证) |
| 辅助空间复杂度 | O(log n)(原地分区,仅调用栈) | O(n)(归并需要辅助缓冲块) |
| CPython 执行效率 | 手写 Python 代码,受限于解释器开销 | CPython 核心底层的纯 C 实现,极度优化 |
五、必须在 Python 中实现稳定快排?两种方案及其代价
如果出于特定教学演示或算法作业的约束,必须在 Python 中让快速排序表现出稳定性,我们能否办到?答案是可以的,但代价往往非常沉重。
方案一:列表推导式分流法(额外空间换取保序)
Python 中最常见、最简洁的非原地快排写法如下:
def quicksort_stable_listcomp(arr: list) -> list:
    """利用列表推导式分流实现的稳定快速排序"""
    if len(arr) <= 1:
        return arr
    pivot = arr[len(arr) // 2]
    # 单向迭代,相同键值的元素依原次序被收集到 mid 列表中
    left = [x for x in arr if x < pivot]
    mid = [x for x in arr if x == pivot]
    right = [x for x in arr if x > pivot]
    return quicksort_stable_listcomp(left) + mid + quicksort_stable_listcomp(right)
为什么它稳定?因为列表推导式从左到右单向遍历原数组,当多个元素等于 pivot 时,它们进入 mid 列表的顺序与在原数组中的顺序完全相同;同样,被划分到 left 和 right 的元素也严格保持了原数组中的先后相对次序。
必须知晓的代价:该方案彻底放弃了快速排序最大的工程王牌——“原地排序(In-place)”。在每一层递归调用中,都开辟了三个全新的 Python 列表,递归树深度为 O(log n) 时,空间复杂度跃升至 O(n log n);一旦数据恶化,空间甚至退化至 O(n²)。频繁的对象创建和垃圾回收(GC)会让性能断崖式下跌。
方案二:索引包装法(Decorate-Sort-Undecorate / DSU)
第二种思路是在执行排序前,为每个元素绑定它在原始数组中的下标索引,将原本的一维元素包装为 (key, original_index, value) 元组:
def quicksort_stable_dsu(arr: list) -> list:
    """使用 DSU 键值索引增强实现稳定性"""
    # 1. Decorate: 绑定原始索引
    decorated = [(val, idx) for idx, val in enumerate(arr)]

    # 2. 对元组执行经典原地快速排序
    # Python 比较元组时:先比较 val;若 val 相等,则比较独一无二的 idx
    quicksort_inplace_tuples(decorated, 0, len(decorated) - 1)

    # 3. Undecorate: 剥离索引还原结果
    return [item[0] for item in decorated]
代价分析:元组的创建和拆包引入了大量的临时对象开销,破坏了底层 CPU 缓存连续性,并且依然额外消耗了 O(n) 的内存空间。
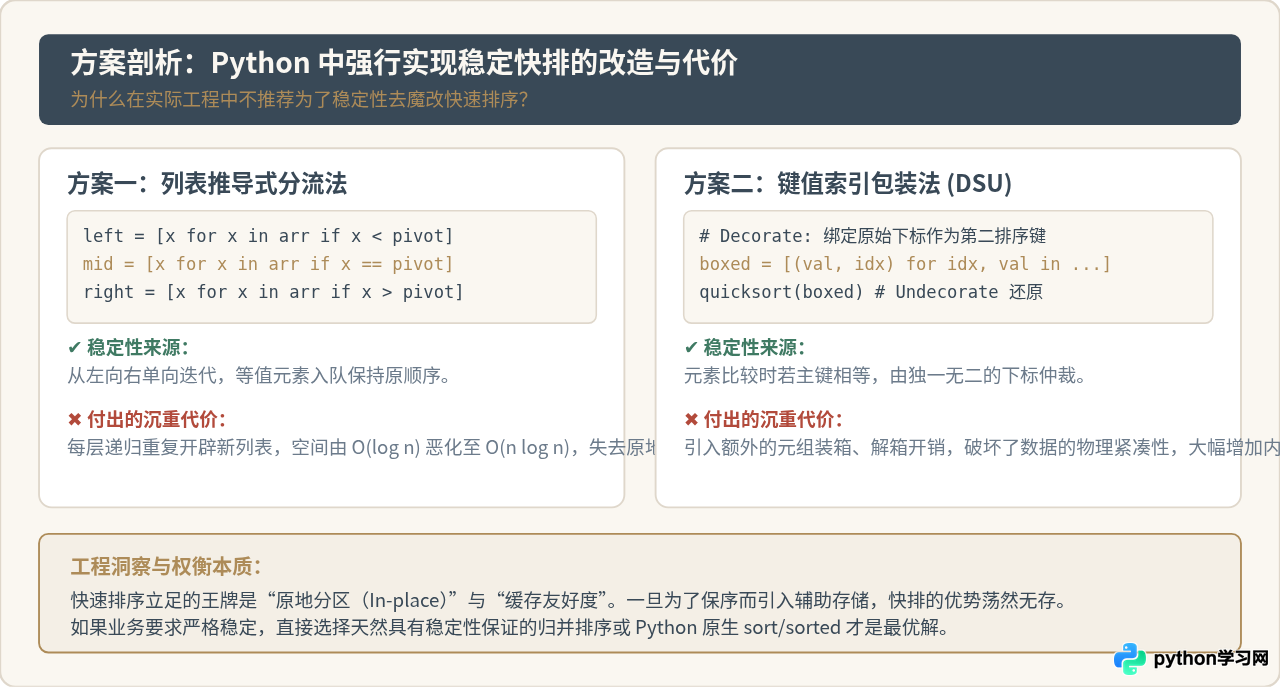 图 3:强行魔改快速排序以实现稳定性的两条技术路径与工程代价分析
核心权衡启示:快速排序之所以经典,精髓就在于其 O(1) 辅助内存开销的原地分区思想。一旦为了保序而引入辅助空间,快排就已经名存实亡——与其花费大代价去魔改快排,不如直接选用天生具备稳定性优势的归并排序(Merge Sort)或直接调用 Python 原生 sort()。
六、技术选型与最佳实践决策流
在面对实际 Python 研发场景时,开发者应当如何正确选型?图 4 总结了清晰的决策路径:
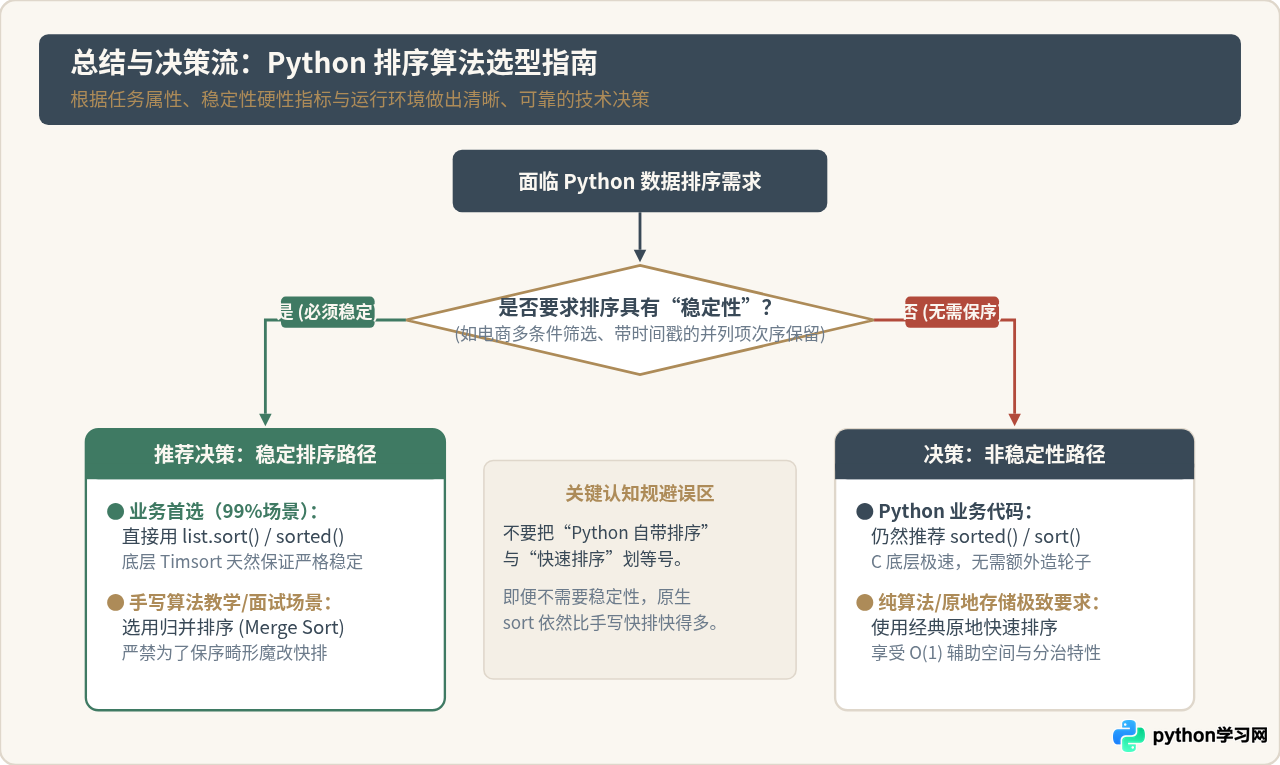 图 4:Python 排序算法选型与实际工程决策指南
-
生产业务开发(99.9% 场景):永远优先选用
list.sort()或sorted()
不要试图自己手写快排来优化业务代码。Python 原生排序底层是由 ANSI C 编写的 Timsort,不仅天然提供严密的算法稳定性保障,而且经过了长达二十余年的极端优化,执行速度比任何纯 Python 编写的快速排序都要快 20 到 50 倍以上。 -
需要多字段排序时:利用稳定的
key参数链式表达
得益于原生排序的稳定性,在 Python 中实现多字段排序极其优雅。例如先按姓名排序,再按部门排序,可以直接写:# 稳定排序保证了:在部门相同的前提下,先前的姓名排序顺序完整保留 employees.sort(key=lambda e: e.name) employees.sort(key=lambda e: e.department) # 或者单次完成元组多字段键值比较: employees.sort(key=lambda e: (e.department, e.name)) -
技术面试与算法理论考核:条理清晰地阐述本质
如果面试官提问“快速排序是稳定排序吗?”,标准且成熟的回答逻辑应当是:- 首先给出直接定性:经典快速排序是不稳定排序;
- 深入阐述原因:在原地分区过程中,指针跨越长距离的交换操作会导致相同键值元素的相对先后顺序被颠倒;
- 顺带补充 Python 生态认知:指出 Python 内置的
sort()/sorted()并非快排,而是基于归并思想的稳定算法 Timsort,展现出扎实的算法底层功底与工程实践经验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









