

Python列表排序的两种核心方法:list.sort()与sorted()

在 Python 中对列表元素进行排序,核心工具主要有两个:列表对象的内置方法 list.sort() 和 Python 全局内置函数 sorted()。两者的核心差异在于对原始数据的处理方式和返回值:list.sort() 执行原地排序,直接修改原列表且返回 None;而 sorted() 不改变原数据,会创建一个排好序的全新列表并返回。理解两者的机制区别,不仅能避免像“重新赋值导致变量变 None”这类高频错误,还能根据内存需求与数据结构做出最佳选择。
一、核心机制对比:原地重排与生成新列表
要掌握这两种排序方式,首先需要看清它们在内存与对象层面的具体运作机制。
1. list.sort():原位操作,无新对象产生
list.sort() 是 list 类自带的实例方法,只能通过列表对象直接调用。它在底层直接调整当前列表内部各元素槽位的引用指针,不会申请一整块新的连续内存来存放新列表。操作完成后,原列表的内容发生了改变,而方法本身的返回值为 None。
# 示例:list.sort() 的基本用法
scores = [85, 92, 78, 64, 99]
scores.sort()

# 查看执行结果
print(scores)  # 输出: [64, 78, 85, 92, 99]
2. sorted():函数调用,创建并返回新列表
sorted() 是一个全局内置函数,它接受一个可迭代对象作为输入参数,在内部读取其中的所有元素,构建一个全新且已排好序的列表并将其返回。最关键的是,输入的原对象在整个过程中完全保持不变。
# 示例:sorted() 的基本用法
original_scores = [85, 92, 78, 64, 99]
sorted_scores = sorted(original_scores)

# 查看原数据与新数据
print(original_scores)  # 输出: [85, 92, 78, 64, 99](保持原样)
print(sorted_scores)    # 输出: [64, 78, 85, 92, 99](全新列表)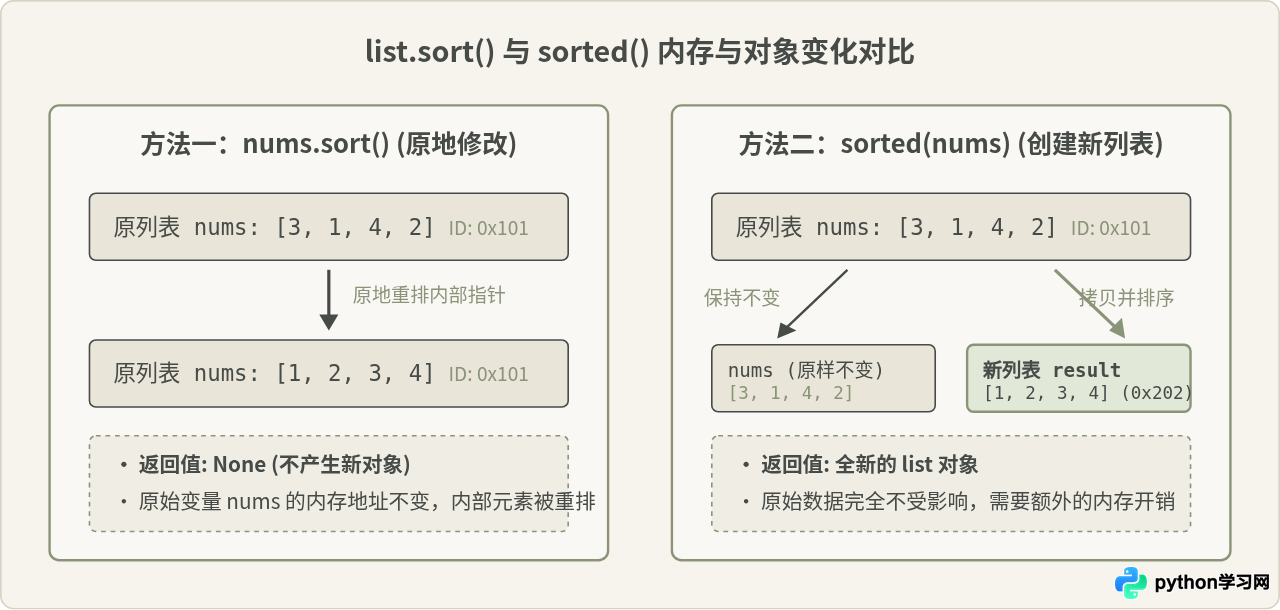
二、操作步骤与常见致命陷阱辨析
在日常编写代码时,关于 list.sort() 最容易踩入的陷阱就是将其执行结果重新赋给原变量。
1. 为什么不能写 data = data.sort()?
许多初学者习惯了像 s = s.strip() 或 s = s.replace(...) 这样的字符串方法链条,潜意识里认为排序后也需要用赋值语句来接收结果。于是写出了如下代码:
# 常见错误写法
items = [4, 2, 9, 1]
items = items.sort()  # 错误!

print(items) # 输出: None此时,原列表不仅没有如愿更新,items 变量反而变成了 None。如果后续代码继续执行 items.append(...) 或 len(items),解释器将立即抛出 AttributeError: 'NoneType' object has no attribute 'append' 或 TypeError。
list.sort()、list.reverse()、list.append() 等)都统一返回 None。这种 API 设计是一种防卫性约束,旨在时刻提醒开发者:该操作具有副作用(Side Effect),正在直接改变调用者本身,绝不能当作纯函数来链式调用或重新赋值。
正确的做法非常纯粹:既然是原地排序,调用即可,无需做任何变量赋值:
# 正确写法一:原地修改
items = [4, 2, 9, 1]
items.sort()  # 执行后 items 内部已变为 [1, 2, 4, 9]

# 正确写法二:需要赋值给变量时,使用 sorted()
items = [4, 2, 9, 1]
sorted_items = sorted(items)  # sorted_items 为新列表,items 保持不变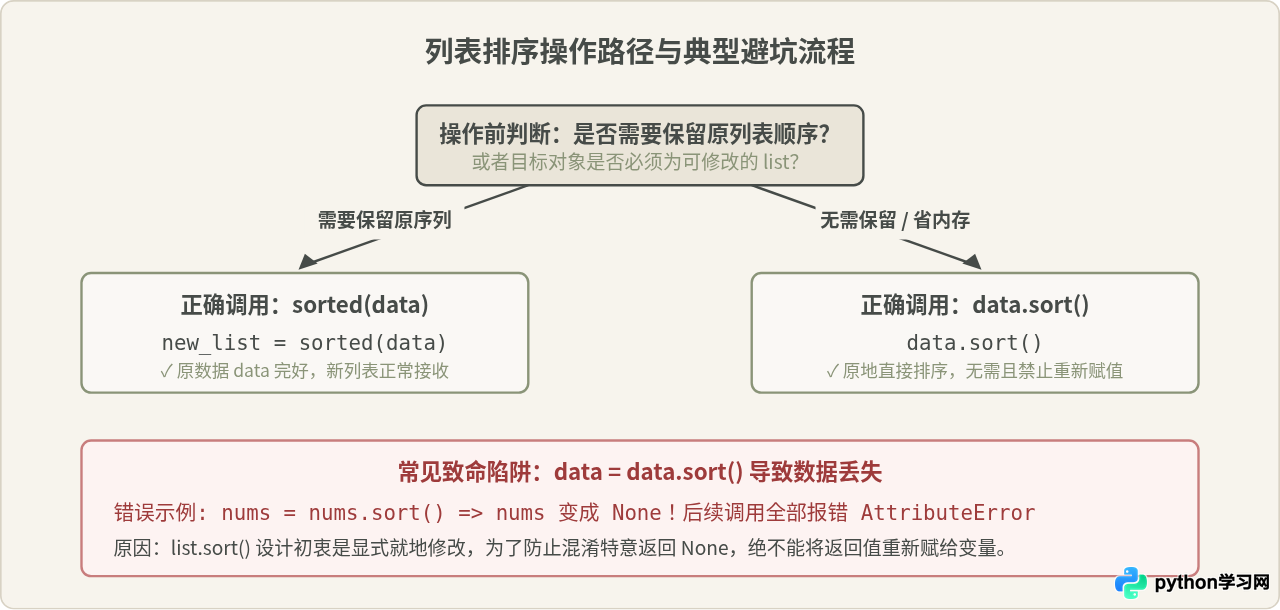
三、核心参数实战:key 与 reverse 的协作逻辑
无论是 list.sort() 还是 sorted(),它们都接受两个完全相同的关键字参数:key 和 reverse。掌握这两个参数是处理复杂业务排序的关键。
1. reverse 参数:控制升序与降序
默认情况下,两者均按升序排列(reverse=False)。若希望从大到小降序排列,只需显式传入 reverse=True:
nums = [5, 2, 8, 1, 9]

# 原地降序
nums.sort(reverse=True)
print(nums)  # 输出: [9, 8, 5, 2, 1]

# 产生新列表降序
desc_nums = sorted(nums, reverse=True)
2. key 参数:映射提取比较依据
key 参数必须接收一个可调用对象(如内置函数、自定义函数或 lambda 表达式)。它在排序算法开始比较前,对每一个元素调用一次,提取出一个“代理键”,底层的排序比较实际上是在这些代理键之间进行的,但排序完成最终返回的依然是原元素本身。
# 示例:根据字符串长度排序
words = ["banana", "pie", "apple"]
words.sort(key=len)
print(words)  # 输出: ['pie', 'apple', 'banana']
利用 key 还可以轻松实现复杂结构排序。例如根据字典中的指定字段、元组的某个索引,或者大小写不敏感排序:
# 忽略大小写排序
text_list = ["banana", "Apple", "cherry"]
sorted_text = sorted(text_list, key=str.lower)
print(sorted_text)  # 输出: ['Apple', 'banana', 'cherry']

# 多字段排序(先按部门升序,再按薪资降序)
employees = [
    {"name": "Alice", "dept": "Tech", "salary": 9000},
    {"name": "Bob", "dept": "Sales", "salary": 7000},
    {"name": "Charlie", "dept": "Tech", "salary": 11000},
]
# 利用元组比较机制:薪资取负数实现局部降序
sorted_emp = sorted(employees, key=lambda x: (x["dept"], -x["salary"]))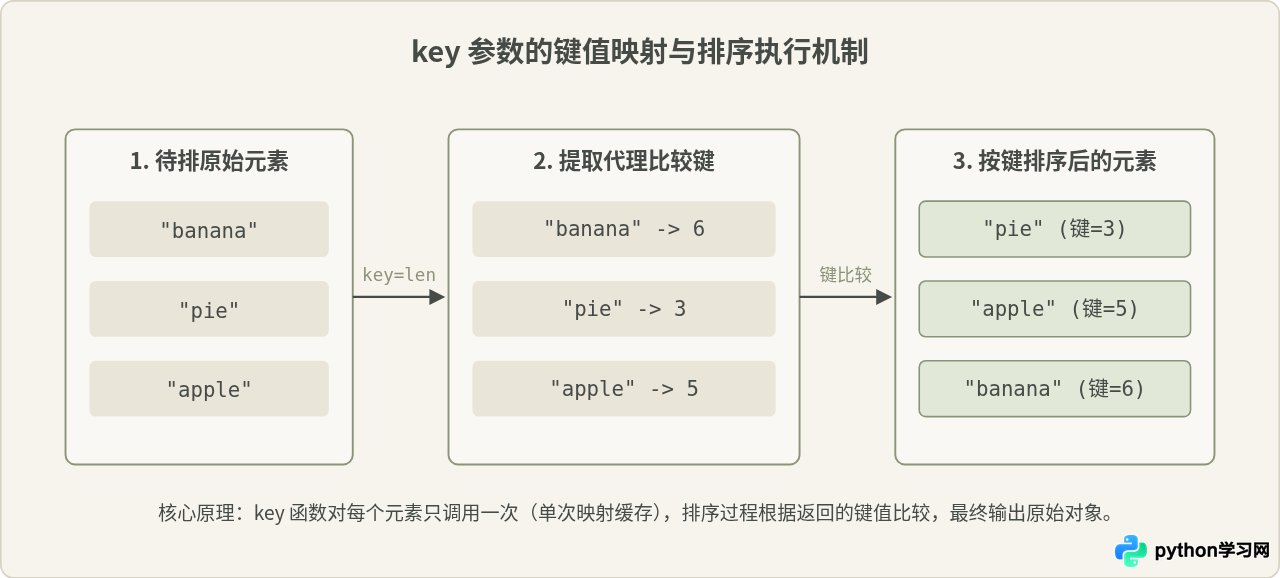
四、深层差异与适用场景选型
在了解了基本用法与参数之后,面对实际业务开发,我们应当基于哪些标准在这两者之间做出抉择?
1. 目标数据类型的差异:专属 vs 通用
list.sort() 只能服务于 list 类型。如果尝试在元组、集合、字典键或生成器上调用 .sort(),解释器会报属性不存在的错误。而 sorted() 具备通用性,可以接收任何迭代器或可迭代容器,且总是返回一个标准 list。
# 对元组排序
tup = (5, 1, 3)
# tup.sort()  => AttributeError: 'tuple' object has no attribute 'sort'
sorted_tup = sorted(tup)  # 输出: [1, 3, 5](返回的是 list)

# 对字典的键排序
user_ages = {"Charlie": 28, "Alice": 25, "Bob": 32}
print(sorted(user_ages))  # 输出: ['Alice', 'Bob', 'Charlie']
2. 性能与内存开销辨析
关于两者的执行速度,社区中偶尔有“sorted() 比 list.sort() 慢很多”的传言。实际上,两者底层采用的都是完全一致的排序算法——Timsort(一种结合了归并排序和插入排序的高效稳定排序算法,时间复杂度均为 \(O(n \log n)\),且具有稳定性)。
两者的细微差异仅来自于内存开销:
list.sort()额外空间复杂度为 \(O(1)\),无需创建新列表对象,在大列表(例如数百万个元素)时能显著节省内存占用,并省去内存分配的时间。sorted()额外空间复杂度为 \(O(n)\),需要分配大小相当的新列表空间并复制引用。但对于中小规模的数据(几万条以内),这种微量差异在实际执行中几乎难以感知。
3. 链式操作与函数式编程支持
因为 sorted() 具有明确的列表返回值,它可以自然地嵌入到各种链式调用、列表推导式或 for 循环头部;而 list.sort() 返回 None,无法作为表达式直接传递。
# sorted() 可以直接融入表达式中
top_three = sorted(scores, reverse=True)[:3]

for item in sorted(category_set):
    process(item)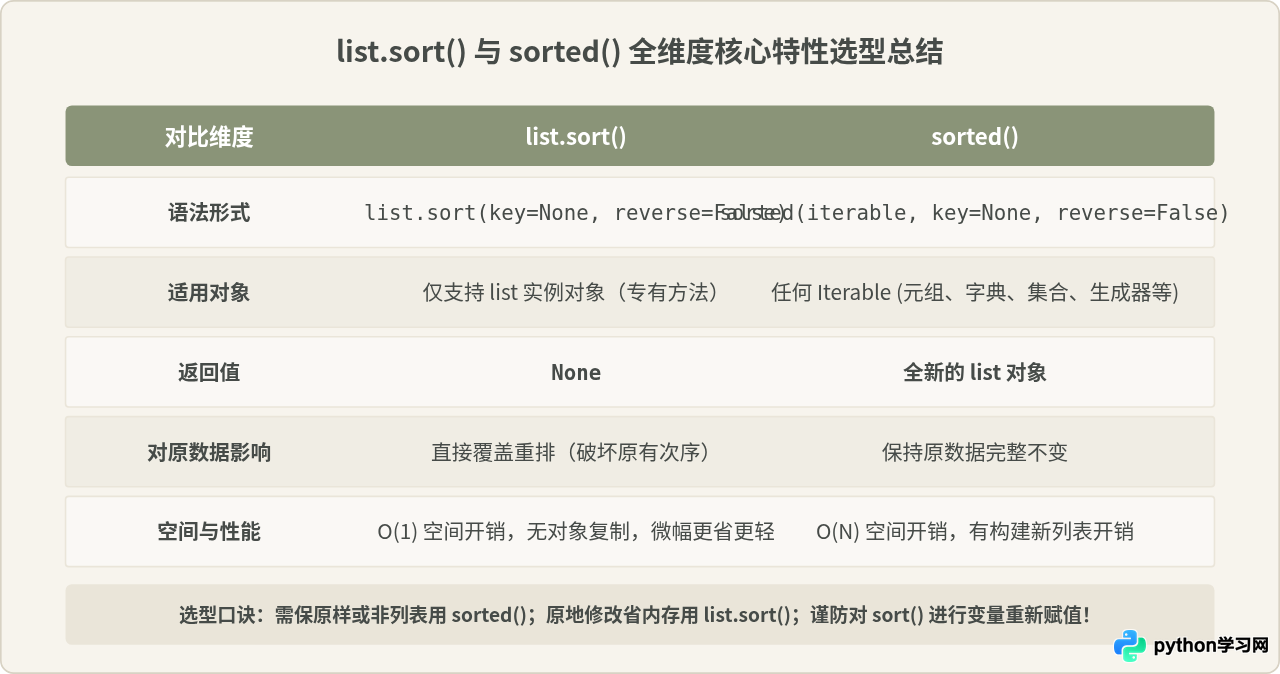
五、总结与快速决策清单
在实际编码中,只要遵循以下规则,便能在各种场景下准确选择:
- 若原列表之后还需要使用原始顺序:必须使用
sorted(),避免原始数据被破坏。 - 处理元组、集合、字典或生成器:只能使用
sorted()。 - 数据量极大且内存敏感,且原顺序不再需要:优先使用
list.sort()降低内存占用。 - 代码书写铁律:牢记
list.sort()原地生效并返回None,调用后切勿做data = data.sort()的二次赋值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









