

Python列表多条件排序:利用key返回元组实现多级优先级
深入讲解Python列表多条件排序机制,通过key参数返回元组实现多级优先级排序,解析元组字典序比较原理、升降序混合处理方案及性能最佳实践。
假设我们正在开发一个学生竞赛成绩统计后台,手头有一份包含学生姓名、笔试总分、提交用时以及年龄的名单列表。当评选最终排名时,主办方制定了这样一条规则:首先按总分从高到低排名;若总分相同,则按提交用时从少到多排名;若用时仍完全相同,则按年龄从小到大排名。面对这类涉及第一优先级、第二优先级乃至第三优先级的复合业务需求,如果写多层嵌套的 if-else 比较函数,代码不仅冗长而且极易出错。而在 Python 中,解决这一问题的经典范式是:直接为 sort() 或 sorted() 的 key 参数提供一个返回元组(tuple)的函数。借助 Python 内置的元组字典序比较机制,仅需一行代码即可精准表达多级优先级的完整排序逻辑。
一、元组比较机制:多级排序的底层驱动力
要想透彻理解为什么 key 返回元组能搞定多条件排序,必须首先搞懂 Python 内部是如何比较两个元组的大小的。
在 Python 中,元组之间的比较遵循字典序规则(Lexicographical Order)。比较从元组的第 0 号索引元素开始:如果两个元素不相等,则它们的大小关系直接决定了整个元组的大小,后续所有的元素将完全被跳过;只有当第 0 号索引元素完全相等时,Python 才会接着比较第 1 号索引元素;依此类推,直到找到第一对不相等的元素或比完所有元素。
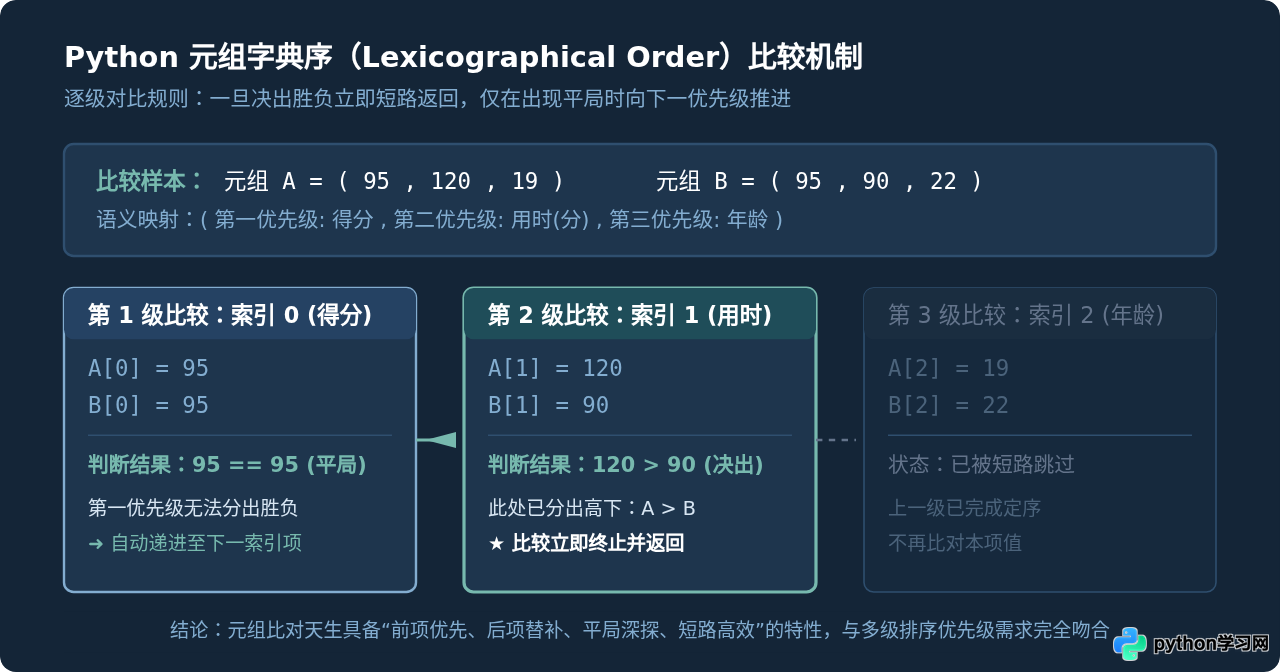
我们可以用一个极为纯粹的交互式代码片段来验证上述规则:
# 索引 0 均为 90,进入索引 1 比较:10 < 20,故前者小
print((90, 10) < (90, 20))  # 输出: True

# 索引 0 即可决出胜负:80 < 90,后续即使是 999 也不会参与比对
print((80, 999) < (90, 1))   # 输出: True

# 只有当索引 0 和 1 均完全相等,才会比对索引 2
print((90, 10, 5) > (90, 10, 2))  # 输出: True
二、核心用法:在 key 中构造并返回排序元组
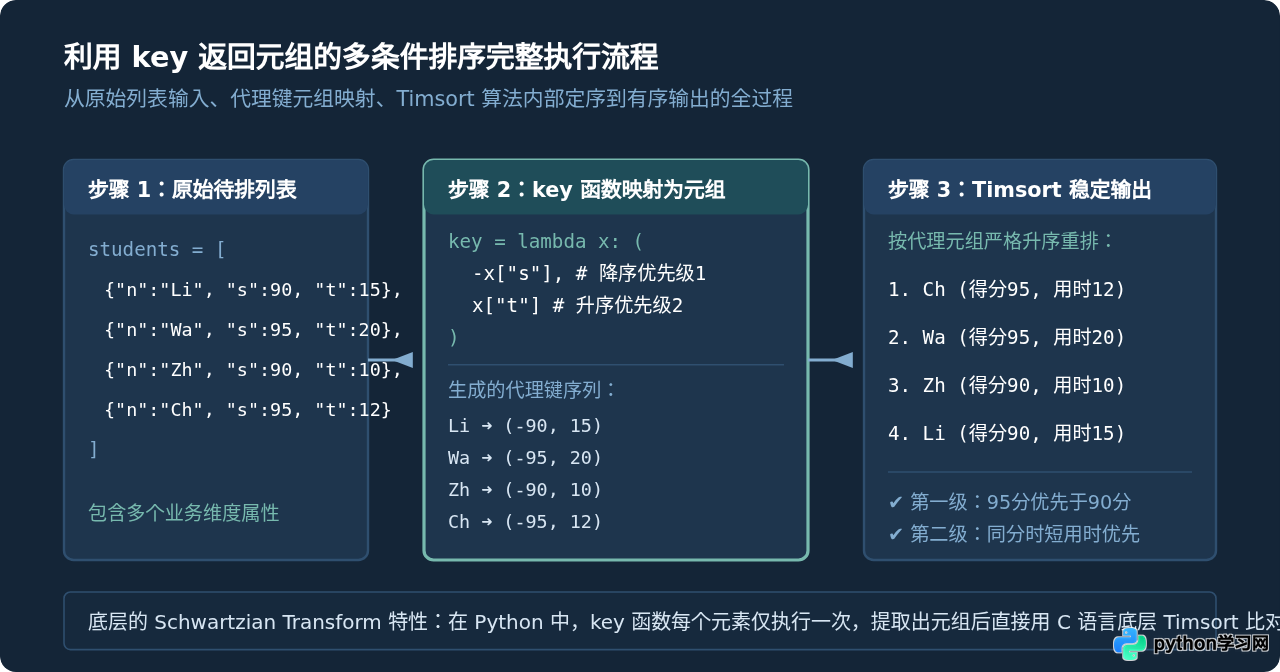
Python 的内置列表排序方法 list.sort() 以及全局内置函数 sorted() 均支持名为 key 的参数。key 接收一个单参函数,该函数会在排序前作用于列表中的每一个元素,提取出一个用于比较的“代理键(Key)”。
当 key 函数返回的是一个包含多个属性的元组时,排序算法在底层直接按照元组的字典序对这些代理键进行排序,从而使原列表元素精准按照元组中属性的顺序排列。
完整代码示例:统一升序情况
先来看所有条件均按正序(从小到大 / 字母序 A-Z)排列的场景。例如:按部门名称升序,同部门按入职年份升序,同年份按姓名拼音升序:
# 员工基础信息:包含姓名、部门和入职年份
employees = [
    {"name": "David", "dept": "Tech", "year": 2021},
    {"name": "Alice", "dept": "HR",   "year": 2019},
    {"name": "Bob",   "dept": "Tech", "year": 2019},
    {"name": "Cindy", "dept": "Tech", "year": 2021},
    {"name": "Eva",   "dept": "HR",   "year": 2019},
]

# 排序需求:
# 1. 第一优先级:部门名称 dept(字母升序)
# 2. 第二优先级:入职年份 year(数字从小到大)
# 3. 第三优先级:员工姓名 name(字母升序)
employees.sort(key=lambda emp: (emp["dept"], emp["year"], emp["name"]))

# 打印排序后结果验证
for emp in employees:
    print(f"{emp['dept']:<6} | {emp['year']} | {emp['name']}")
控制台输出结果如下:
HR     | 2019 | Alice
HR     | 2019 | Eva
Tech   | 2019 | Bob
Tech   | 2021 | Cindy
Tech   | 2021 | David
可以看到,HR 部门排在 Tech 前面;在 HR 内部,年份同为 2019,按姓名排序 Alice 在 Eva 前;在 Tech 内部,2019 年入职的 Bob 排在 2021 年之前,而 2021 年的两人中 Cindy 凭字母序排在 David 之前。三级优先级丝毫不乱。
三、进阶痛点:混合升序与降序的高效方案
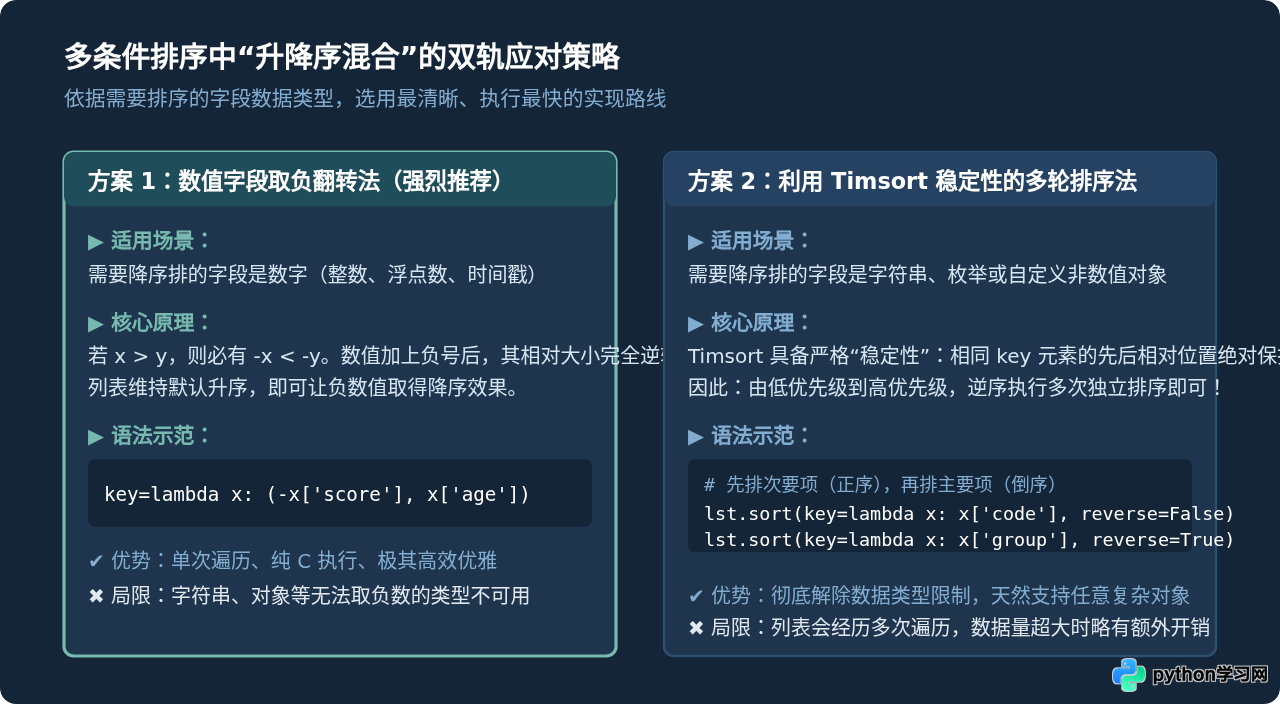
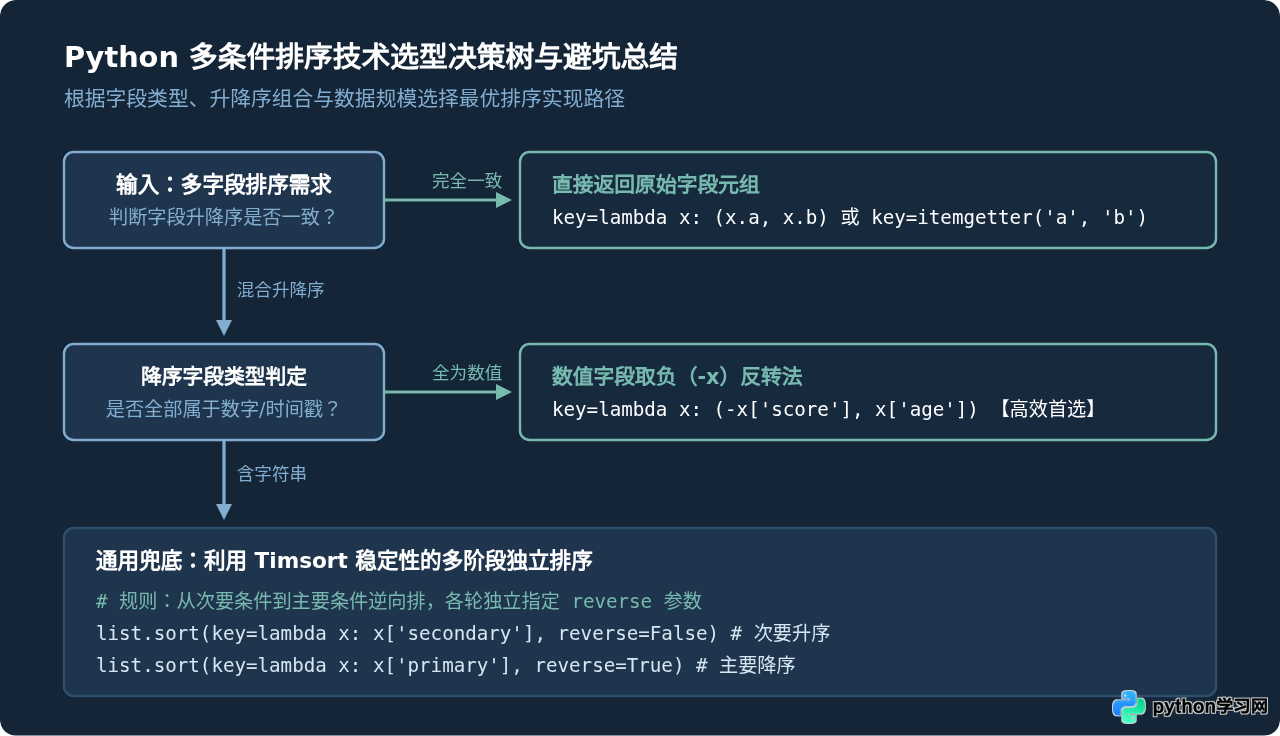
在实际开发中,现实业务往往不是“全升序”或“全降序”。如果直接设置 reverse=True,整个元组的所有字段都会一起倒序排列,无法满足“第一级降序、第二级升序”这种交叉需求。针对混合升降序,通常有两种处理手段。
方案 1:数值字段取负(-x)技巧
如果降序排的字段是数字类型,直接在元组对应位置加上负号 - 是最简单高效的技巧。例如文章开头的学生成绩排序场景:得分从高到低(降序),用时从少到多(升序),年龄从小到大(升序):
students = [
    {"name": "张三", "score": 95, "time": 120, "age": 19},
    {"name": "李四", "score": 98, "time": 110, "age": 20},
    {"name": "王五", "score": 95, "time": 90,  "age": 22},
    {"name": "赵六", "score": 95, "time": 90,  "age": 18},
]

# 得分加负号 (-x["score"]) 实现降序;用时和年龄为正数实现升序
students.sort(key=lambda s: (-s["score"], s["time"], s["age"]))

for s in students:
    print(f"姓名: {s['name']} | 得分: {s['score']} | 用时: {s['time']}m | 年龄: {s['age']}")
控制台输出结果如下:
姓名: 李四 | 得分: 98 | 用时: 110m | 年龄: 20
姓名: 赵六 | 得分: 95 | 用时: 90m  | 年龄: 18
姓名: 王五 | 得分: 95 | 用时: 90m  | 年龄: 22
姓名: 张三 | 得分: 95 | 用时: 120m | 年龄: 19
过程拆解:李四 98 分最高排在第一位;张三、王五、赵六同为 95 分,比对第二项用时,王五与赵六均为 90 分,优于张三的 120 分;最后在王五与赵六之间比对第三项年龄,18 岁的赵六排在 22 岁的王五之前。完全符合预期。
datetime 对象),不能直接加负号,但可以通过 -s["reg_time"].timestamp() 转换为 Unix 时间戳浮点数后再取负。
方案 2:非数值字段的多轮稳定排序(利用 Timsort)
如果需要降序排的字段是字符串(例如按大区降序 Z-A,同大区按城市名升序 A-Z),由于字符串不能加负号 -"East"(会报 TypeError: bad operand type for unary -: 'str'),此时应当利用 Python 排序算法的稳定性(Stability)。
所谓的“稳定”,是指当两个元素的 key 相等时,它们在排序后的相对顺序保持不变。因此,我们可以从最低优先级开始向最高优先级逐轮排序:
data = [
    {"region": "North", "city": "Beijing"},
    {"region": "South", "city": "Shenzhen"},
    {"region": "North", "city": "Tianjin"},
    {"region": "South", "city": "Guangzhou"},
]

# 业务目标:第一优先级 region 降序;第二优先级 city 升序
# 步骤 1:先按次要条件(低优先级:city)升序排
data.sort(key=lambda x: x["city"], reverse=False)

# 步骤 2:再按主要条件(高优先级:region)降序排
data.sort(key=lambda x: x["region"], reverse=True)

for item in data:
    print(f"{item['region']:<6} | {item['city']}")
输出结果如下:
South  | Guangzhou
South  | Shenzhen
North  | Beijing
North  | Tianjin
因为第二步是稳定排序,当 region 同为 "South" 时,第一步排好的 "Guangzhou" 在 "Shenzhen" 之前的相对顺序被原封不动保留了下来,从而完美达成复合排序目的。
四、性能进阶:operator.itemgetter 与 lambda 的抉择
在编写多条件排序时,很多开发者习惯随手写 lambda。但在处理十万级、百万级的大型列表时,函数调用的开销不可忽视。Python 标准库内置的 operator.itemgetter 和 operator.attrgetter 在底层由 C 语言实现,提取元组时速度更为突出。
| 实现方式 | 适用对象 | 是否支持原语取负 (-x) | 执行性能 | 推荐场景 |
|---|---|---|---|---|
lambda x: (x['a'], x['b']) |
任意字典 / 对象 / 表达式 | 支持(如 -x['a']) |
Python 字节码层函数调用 | 规则复杂、升降序混合、字段计算 |
itemgetter('a', 'b') |
字典、元组、列表索引 | 不支持 | 全 C 语言加速,快 20%~40% | 大体量字典、同向全升序排 |
attrgetter('a', 'b') |
自定义类对象实例 | 不支持 | 全 C 语言加速,快 20%~40% | ORM 数据模型、类实例列表同向排 |
itemgetter 传入多个参数时,本身就会直接返回一个包含所有指定属性的元组,天然具备多条件排序能力:
from operator import itemgetter

records = [
    ("Alice", "Engineering", 85),
    ("Bob", "Sales", 92),
    ("Charlie", "Engineering", 90),
]

# 按部门(索引 1)升序,部门相同按分数(索引 2)升序
records.sort(key=itemgetter(1, 2))
五、避坑指南与排查清单
在生产环境中运用多条件排序时,有三个极易引发线上 Bug 的典型陷阱,需要重点防范:
- 元组元素中潜藏的
None值:
在 Python 3 中,None与整数或字符串之间不支持大小比较(会抛出TypeError: '<' not supported between instances of 'NoneType' and 'int')。如果排序字段可能为空,必须在元组中进行兜底转换,例如key=lambda x: (x["score"] is None, x["score"] or 0),利用布尔值False < True将空值稳妥置于开头或末尾。 - 区分就地排序与生成新列表:
list.sort()是列表的原生就地修改方法,直接改变原列表,返回值恒为None;而sorted(iterable)会生成并返回一个全新的排好序的列表,原列表保持不变。千万不要写出my_list = my_list.sort(...)这样的代码,否则原变量将直接沦为None。 - 避免在 key 函数内部执行高耗时逻辑:
虽然 Python 的 Schwartzian 机制对每个元素只调用一次 key 函数,但列表较长时,避免在 key 中执行数据库查询、网络 IO 或正则重编译。元组中只存放预先提取好的扁平标量值。
六、总结
掌握 Python 列表的多条件排序,关键在于建立两个清晰的心智模型:
- 元组的字典序模型:Python 的元组比较本质上就是多级优先级的完美映射,先看第 0 项,平局才看第 1 项,具备先天的短路特性与逻辑自洽性。
- 升降序的转换通道:同向全升/全降优先使用单次元组;数值字段混合方向使用负号
-翻转;非数值字段混合方向则信任并利用好 Timsort 的稳定性进行多轮排序。
在日常开发中,优先推荐通过 key=lambda x: (field1, field2, ...) 保持代码的直观易读;当数据量庞大且全为升序时,可换用 itemgetter 榨干 C 级底层性能。遵循这套成熟模式,无论是面对排行统计、报表导出还是数据清洗,都能游刃有余地写出健壮优雅的高质量 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









