

Python list.sort(reverse=True)原地排序为何返回None?

核心结论:在 Python 中,list.sort(reverse=True) 返回 None 不是程序错误,而是 Python 核心API的刻意设计。该方法属于“就地修改(In-place)”操作,直接重排原列表内存中的元素,不构造任何新列表;返回 None 是为了强制提醒开发者“原列表已被改变”,并防止误用链式赋值导致丢失原列表引用。
一、高频踩坑现场:为何变量变成了 None?
很多 Python 初学者或从其他语言转过来的开发者,在对列表进行降序排列时,经常会写出如下代码:
# 错误示例:误将 sort() 的结果赋值回原变量
scores = [78, 92, 65, 88, 99]
scores = scores.sort(reverse=True)

print(scores)
# 输出结果:None

# 接下来的操作会立刻崩溃
scores.append(100)
# 抛出异常:AttributeError: 'NoneType' object has no attribute 'append'
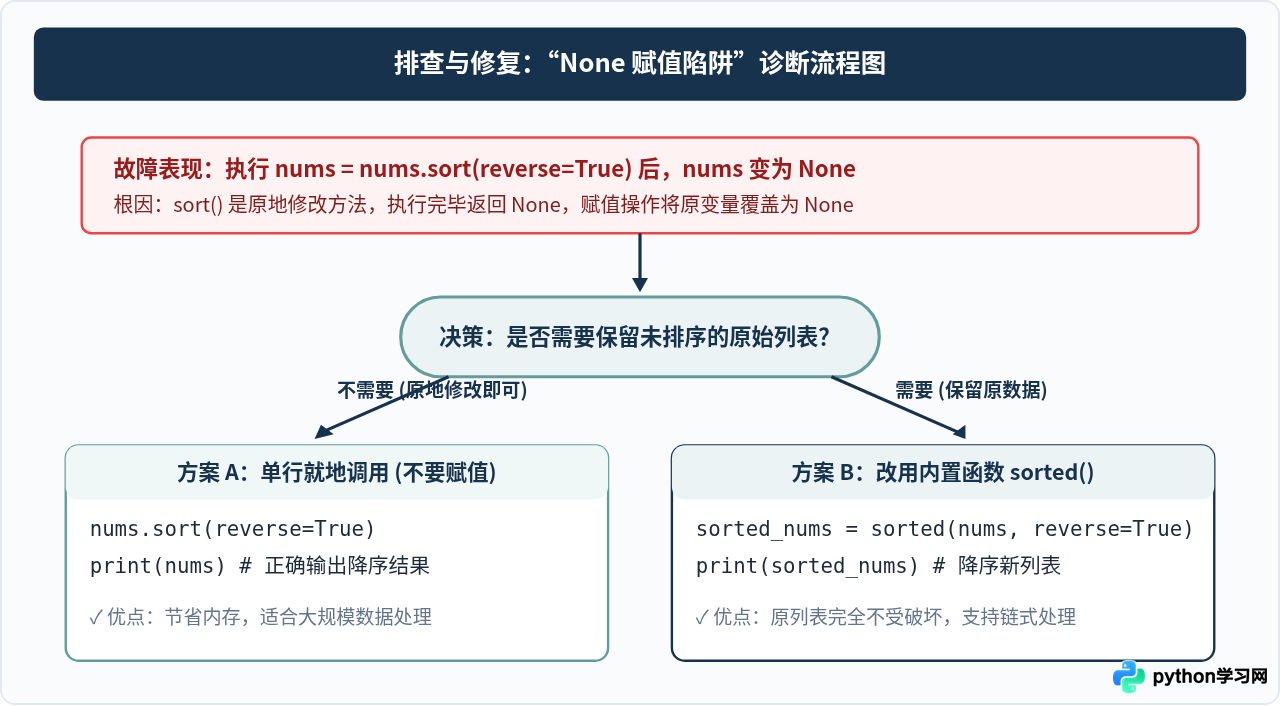
开发者原本希望 scores 保存降序后的列表 [99, 92, 88, 78, 65],但打印出来的结果却是 None。如果紧接着调用 append() 或进行切片,程序就会因操作 NoneType 对象而直接报错退出。
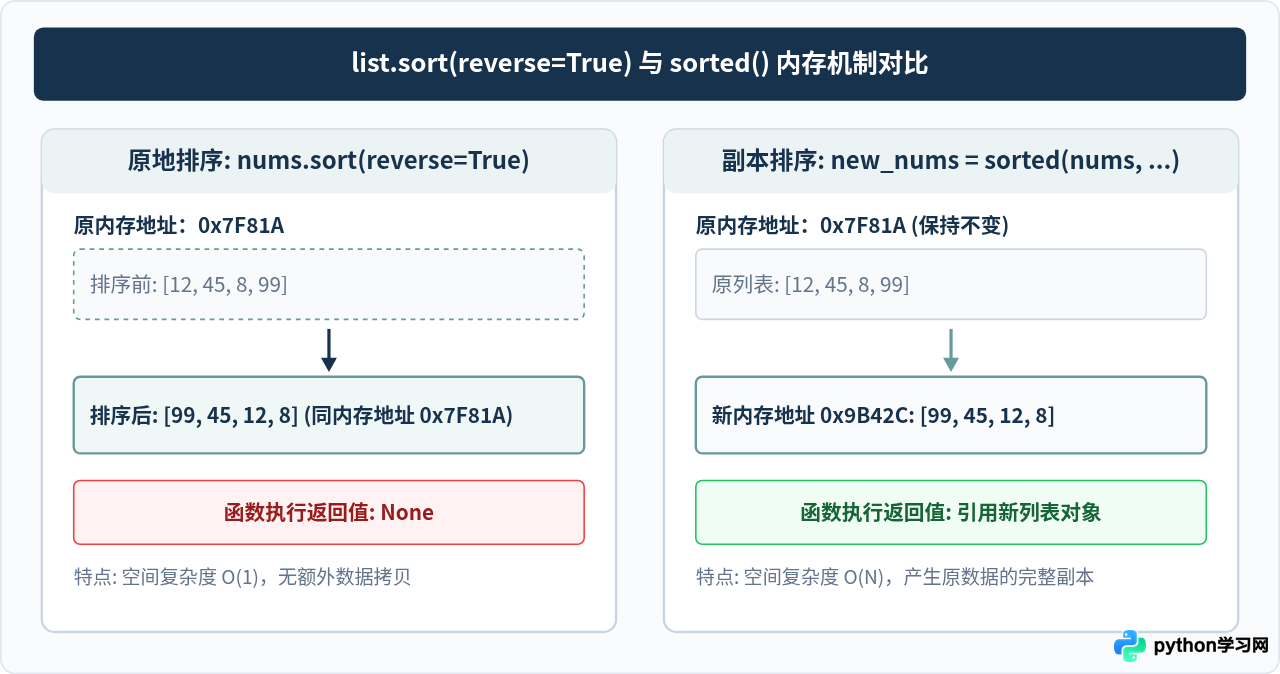
究其原因,正是因为 scores.sort(reverse=True) 执行完成后返回的值就是 None。当执行 scores = scores.sort(...) 时,左侧的变量 scores 接收了右侧的返回值,原有的列表引用瞬间被 None 覆盖,原列表数据也由此丢失。
二、底层设计哲学:为什么 Python 约定返回 None?
很多其他语言的 API(例如 JavaScript 的 Array.prototype.sort())既就地修改数组,又将修改后的数组作为返回值输出。这往往会导致初学者产生混淆,不清楚原数据到底有没有被改动。
Python 语言设计者 Guido van Rossum 提出了极其明确的 API 规范——命令与查询分离原则(Command-Query Separation, CQS):
- 如果是命令(Command/变更操作):只负责改变对象内部状态,不产生返回值(默认返回
None)。 - 如果是查询(Query/获取操作):只负责返回计算结果,不修改底层数据结构。
1. 强制提醒副作用(Side Effect)
如果 sort() 返回了排序后的列表,开发者会很自然地写出 b = a.sort(),并潜意识地认为 b 是一份新的有序副本,而 a 依然保留原样。返回 None 能够强行打断这种误解,明确告知调用者:“目标列表内部结构已经被直接改动了”。
2. 防止内存浪费与性能误区
在处理数百万级元素的巨型列表时,原地排序使用的是 Timsort 算法,空间复杂度为 O(1),无需额外复制整个列表。如果 API 鼓励开发者使用 lst = lst.sort() 这种模式,一旦误用于需要保护原数据的场景,就会引发不可预期的副作用。
3. Python 内部的统一性契约
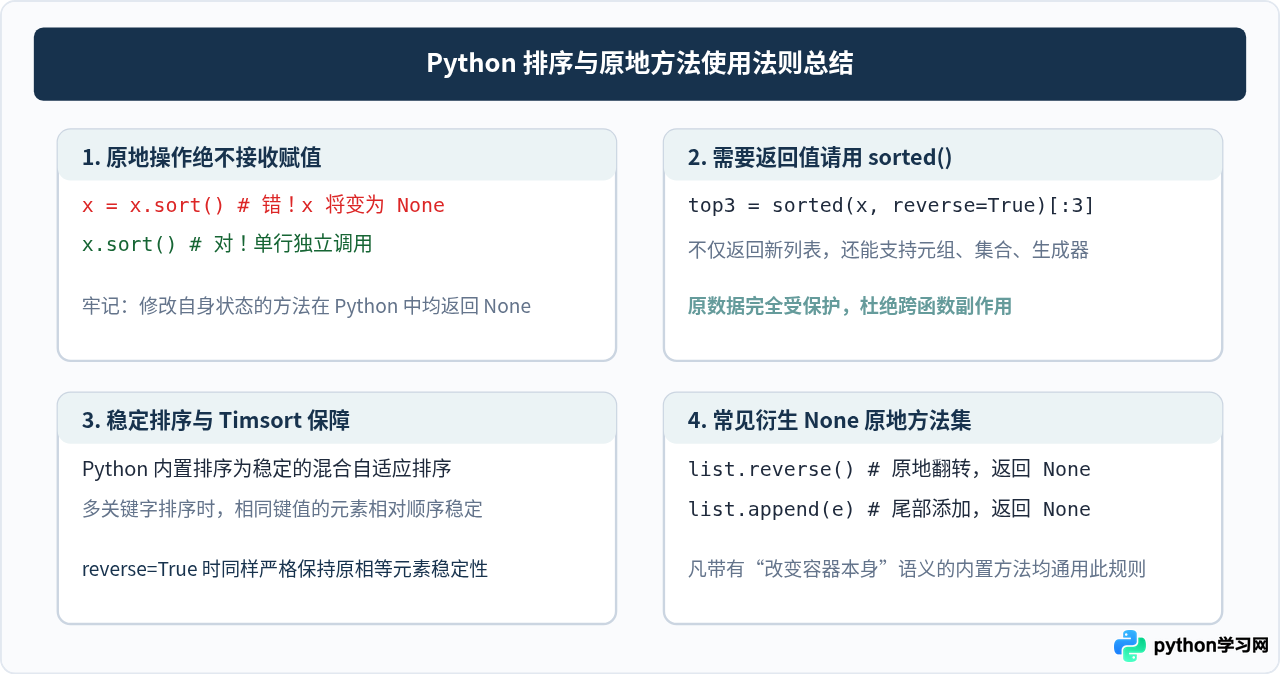
不仅 list.sort(),Python 中所有针对可变对象(Mutable Objects)的原地修改方法,全部遵循返回 None 的设计标准:
list.reverse():原地翻转列表,返回None。list.append(x):尾部追加元素,返回None。list.extend(iterable):批量扩展列表,返回None。dict.update():原地更新字典键值对,返回None。set.add(x):原地向集合添加元素,返回None。
三、两种正确的降序排序操作方法
明确了 list.sort(reverse=True) 返回 None 的设计原因后,解决该问题仅需依据实际需求选择正确的写法。
方案一:直接单行调用,继续使用原变量名
如果不需要保留原先未排序的数据,或者正在处理规模较大的列表以节约内存,应该直接将 .sort(reverse=True) 作为一个独立的语句执行,严禁将其赋值给任何变量:
# 正确写法:单行独立调用
numbers = [42, 17, 89, 5, 63]

# 就地重排列表内容,不要写 numbers = numbers.sort(...)
numbers.sort(reverse=True)

# 此时 numbers 自身已经是降序状态
print(numbers)
# 输出:[89, 63, 42, 17, 5]
方案二:使用内置函数 sorted() 接收新列表
如果需要保留未排序的原始列表(例如后续还要进行其他顺序的统计),或者希望在表达式中直接使用排序后的列表,应该使用内置函数 sorted():
# 正确写法:使用 sorted() 函数
raw_data = [42, 17, 89, 5, 63]

# sorted() 会开辟新内存并返回全新列表,raw_data 保持原样
desc_data = sorted(raw_data, reverse=True)

print("新列表:", desc_data)
# 输出:新列表: [89, 63, 42, 17, 5]

print("原列表:", raw_data)
# 输出:原列表: [42, 17, 89, 5, 63]
方案三:结合 key 参数实现自定义降序排序
无论使用 list.sort() 还是 sorted(),reverse=True 都可以与 key 参数配合使用。例如对包含字典或复杂对象的列表按特定字段降序排列:
users = [
    {"name": "Alice", "score": 85},
    {"name": "Bob", "score": 95},
    {"name": "Charlie", "score": 72}
]

# 按成绩降序排列
users.sort(key=lambda item: item["score"], reverse=True)

for user in users:
    print(user["name"], user["score"])
# 输出:
# Bob 95
# Alice 85
# Charlie 72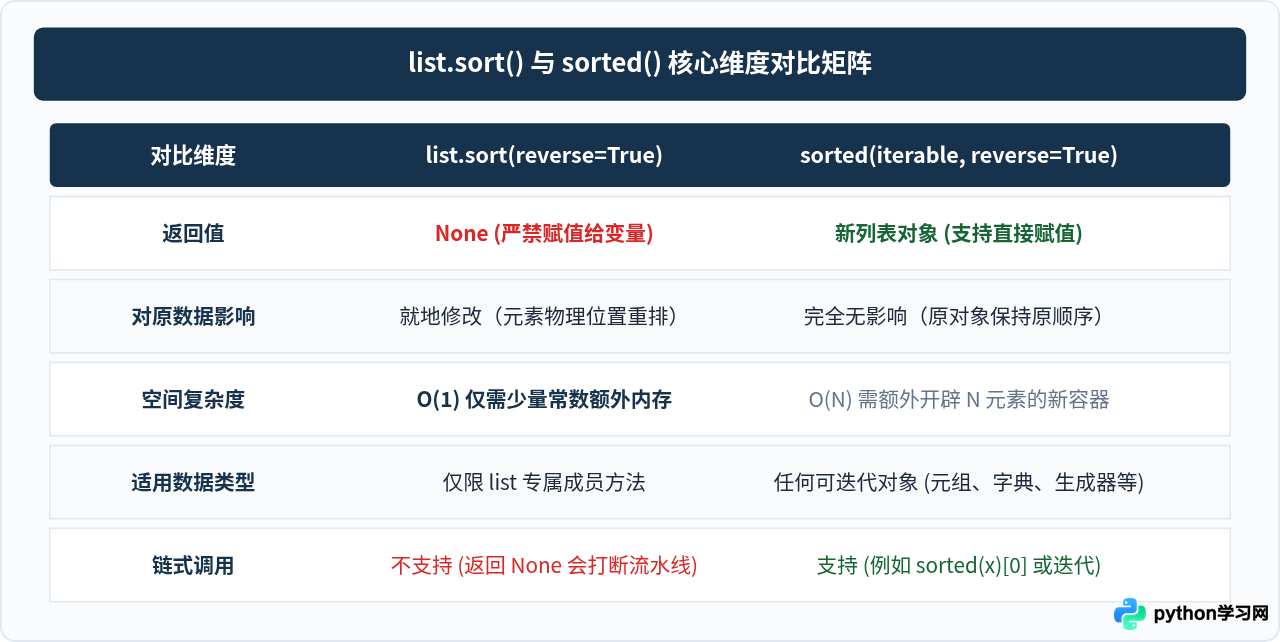
四、深度技术对比:list.sort() 与 sorted() 应该选哪一个?
理解了返回值与行为差异后,在实际项目中如何做出合理的技术选型?我们可以从以下三个核心场景进行判断:
| 业务场景 | 推荐方案 | 选型理由与注意事项 |
|---|---|---|
| 处理海量数据(如百万级整数) | list.sort(reverse=True) |
原地操作能够完全避免由于内存复制导致的瞬间峰值内存消耗(Memory Spike),执行效率更高。 |
| 只读数据或不可变容器(如 tuple) | sorted(iterable, reverse=True) |
tuple、set 或生成器根本没有 .sort() 方法;sorted() 会提取元素并返回新的 list。 |
| 函数式编程或流式处理 | sorted(iterable, reverse=True) |
由于有实际列表返回值,可以直接进行后续链式操作,例如 sorted(nums, reverse=True)[:3] 快速取前三名。 |
五、常见衍生问题与避坑清单
1. 为什么不能写 list.sort().reverse()?
有些开发者试图通过连续点调用完成“升序后反转”,写成 lst.sort().reverse()。这会导致程序立即抛出 AttributeError: 'NoneType' object has no attribute 'reverse'。因为 lst.sort() 执行完返回的是 None,在 None 上不可能存在 reverse() 方法。要进行降序,直接在 sort() 中传入参数 sort(reverse=True) 即可,无需分步反转。
2. 列表元素类型不一致导致的排序报错
在 Python 3 中,排序要求所有元素之间必须支持大于/小于的比较运算(__lt__)。如果列表中混合了字符串与数字(例如 [1, "2", 3]),调用 sort(reverse=True) 会直接抛出 TypeError: '<' not supported between instances of 'str' and 'int'。此时需要配合 key 参数将元素转为一致类型,或者预先过滤数据。
六、总结
list.sort(reverse=True) 返回 None 是 Python “明了胜于晦涩(Explicit is better than implicit)”与“命令-查询分离(CQS)”哲学的生动体现。它通过一个明确的 None 返回值,强行规范了开发者的心智模型:要么单行调用就地重排,要么使用 sorted() 接收新列表。掌握这一底层约定,就能彻底避免 NoneType 赋值陷阱,编写出稳健、高效的 Python 排序逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









