

Python列表排序报错TypeError怎么办

list.sort() 或使用内置函数 sorted() 时,如果控制台抛出形如 TypeError: '<' not supported between instances of... 的异常,其根本原因在于列表中包含了无法在 Python 3 中直接进行大小比较的异构元素(例如数字与字符串混合、列表中混入了 None,或者元素为字典与自定义对象而没有指定比较规则)。解决这一问题的核心路径非常明确:确定业务期望的排序基准,通过 key 参数将列表元素映射为一致的可比较形态,或在排序前通过数据清洗剔除与规范非法值。
一、TypeError 的常见具体报错表现与原因定位
Python 3 是一门强类型语言。与 Python 2 允许在不同类型之间随意比较不同,Python 3 严格禁止无定义的异构数据大小比较。排序算法底层依赖元素之间的 < 操作符(即特殊方法 __lt__)。一旦遇到两两无法比较的情况,执行过程就会立即中断并抛出 TypeError。
在实际开发中,最常遇到的报错信息主要集中在以下四种表现:
- 数值与字符串混合:
TypeError: '<' not supported between instances of 'str' and 'int'。通常发生在从 CSV、Excel 或外部接口读取数据时,部分数字保持了字符串格式,与原生整数或浮点数混存在同一个列表中。 - 列表中混入了空值 None:
TypeError: '<' not supported between instances of 'NoneType' and 'int'。数据库查询或网络爬虫抓取字段缺失时,缺失项常被填充为None,而None无法与数值或字符串比较大小。 - 直接对字典列表排序:
TypeError: '<' not supported between instances of 'dict' and 'dict'。字典在 Python 3 中没有预定义的大小关系,直接调用sort()会导致 Python 不知该比较哪个键。 - 未实现比较逻辑的自定义类:
TypeError: '<' not supported between instances of 'Student' and 'Student'。自定义类的实例如果没有在类内部定义__lt__方法,且排序时没有传入key提取可比属性,便会触发此报错。
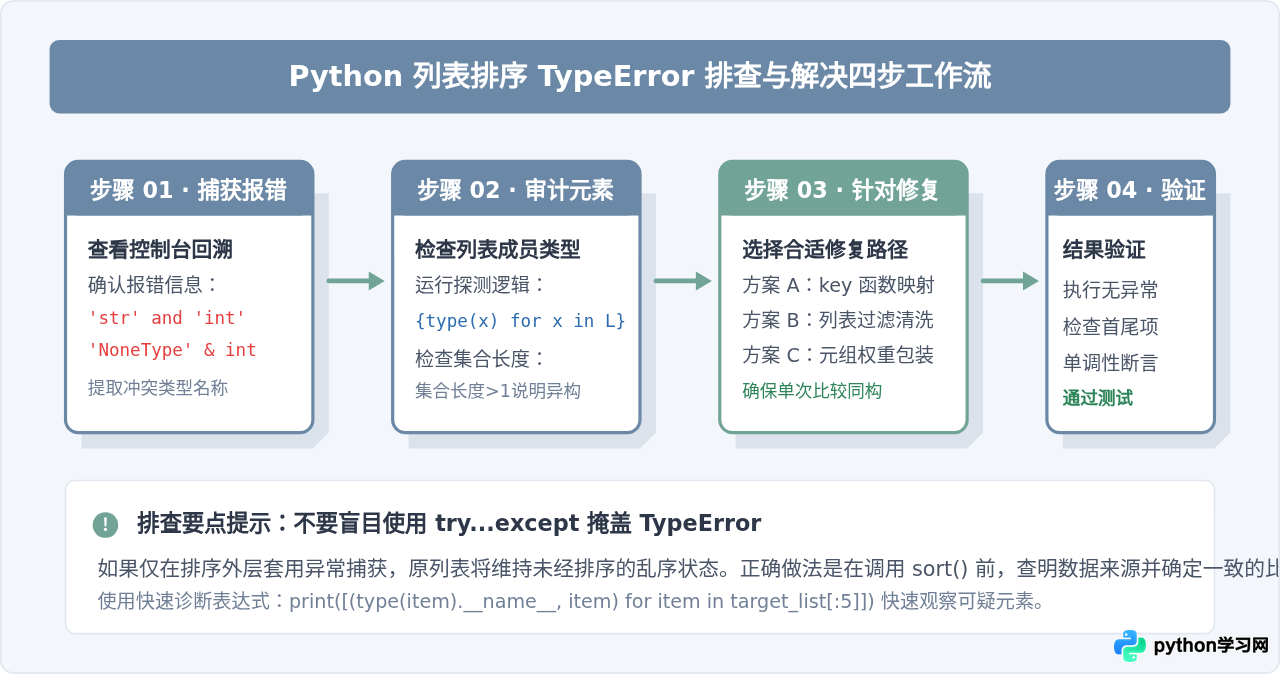
二、核心排查与针对性解决方案
排查的第一步是找出列表中究竟混入了哪些不兼容的类型。你可以通过一行简单的集合推导式完成类型诊断:
# 诊断当前列表中存在的所有数据类型
element_types = {type(x).__name__ for x in raw_list}
print("列表包含的类型:", element_types)
# 若输出包含多个互不兼容的类型(如 {'int', 'str'} 或 {'NoneType', 'float'}),则必然抛出 TypeError
场景一:列表中混合了数字与字符串
当列表中同时存在 10 与 "2" 时,Timsort 算法执行到比较环节时无法确认是按照数值大小还是按照字典序排序,因此抛出异常。
解决方案 A(业务要求按数值大小排序):如果字符串内容全为有效数字,使用 key=float 或 key=int 在比较时临时转换:
mixed_numbers = [10, "2", 30, "4", 1]

# 通过 key 参数临时转换为浮点数参与比较,原列表元素类型保持不变
sorted_by_val = sorted(mixed_numbers, key=float)
print(sorted_by_val)
# 输出示例: [1, '2', 10, '4', 30] (按数值升序)
解决方案 B(业务要求按字符字典序排序):如果列表中包含非纯数字文本,无法转换为数值,则统一按字符串字典序比较:
mixed_texts = [10, "apple", 2, "banana"]

# 统一转换为字符串比较字典序
sorted_by_str = sorted(mixed_texts, key=str)
print(sorted_by_str)
# 输出示例: [10, 2, 'apple', 'banana'] (数字转换为 '10', '2' 后按字符编码排序)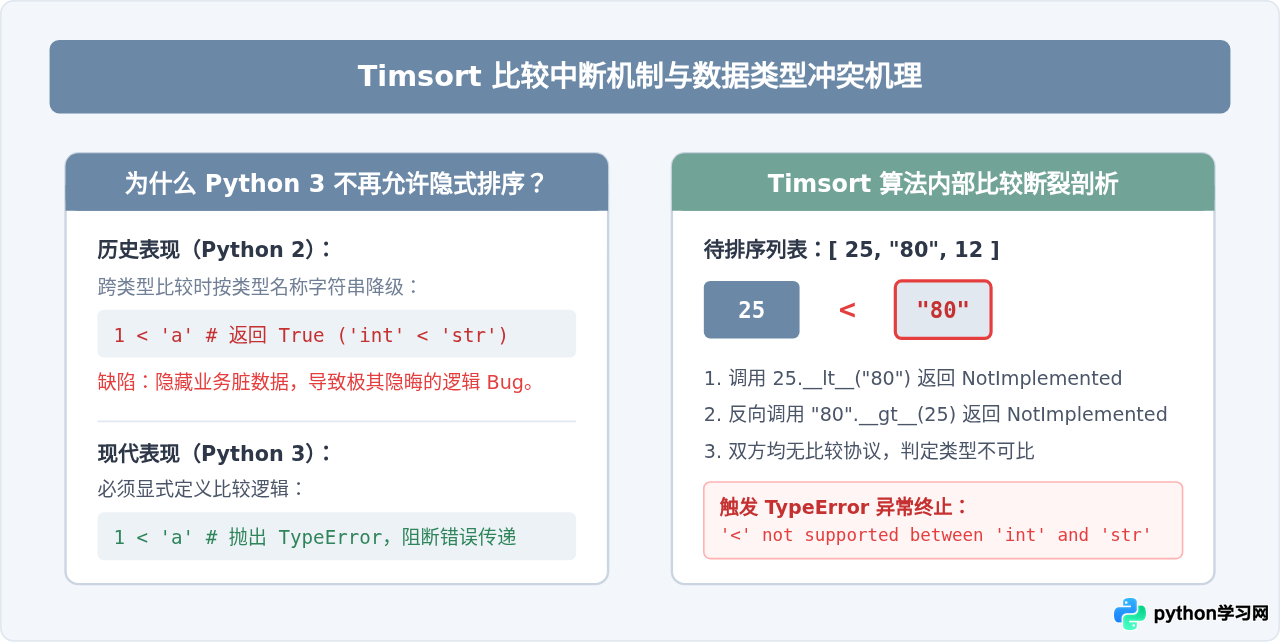
场景二:列表中混入了 None 空值
数据分析中经常遇到包含 None 的序列(例如 [15, None, 8, 32, None])。在排序时直接调用 sort() 会立即抛出 TypeError: '<' not supported between instances of 'NoneType' and 'int'。
对于包含 None 的排序,通常根据业务场景采取两种处理策略:
策略 1:前置清洗,直接丢弃空值
data = [15, None, 8, 32, None]

# 使用列表推导式或 filter 过滤掉 None,再执行安全排序
clean_sorted = sorted([x for x in data if x is not None])
print(clean_sorted)
# 输出示例: [8, 15, 32]
策略 2:保留 None,利用元组键将 None 统一沉底或置顶
Python 支持元组之间的逐项比较。元组在比较时会先对比第一个元素;若第一个元素相同,再对比第二个元素。我们可以利用这一特性,让 key 函数返回一个二元组:
data = [15, None, 8, 32, None]

# 目标:数值升序排列,所有 None 排在最后面
# x is None 为 False (0),当 x 为 None 时为 True (1)。由于 0 < 1,有效数值自然排在 None 前面
sorted_none_last = sorted(data, key=lambda x: (x is None, x))
print(sorted_none_last)
# 输出示例: [8, 15, 32, None, None]

# 若需要将 None 排在最前,只需改为 (x is not None, x)
sorted_none_first = sorted(data, key=lambda x: (x is not None, x))
print(sorted_none_first)
# 输出示例: [None, None, 8, 15, 32]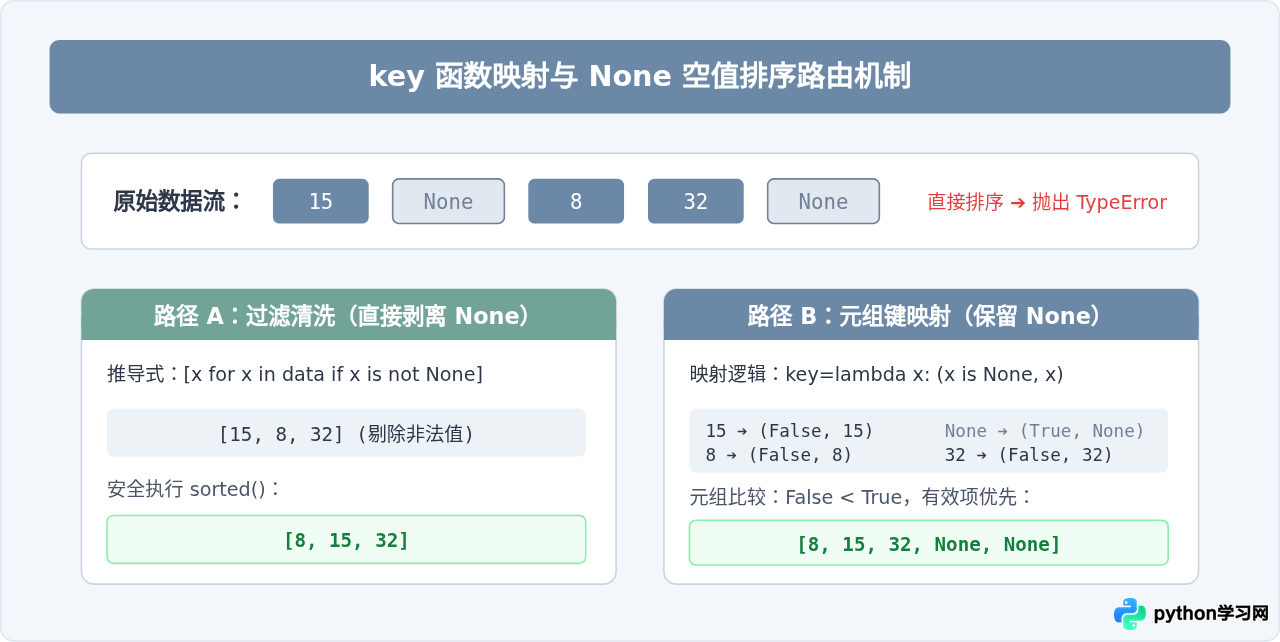
场景三:直接对字典列表执行排序
从数据库或 Web 接口获取的数据通常以字典列表(即若干对象结构)呈现。例如:
users = [
    {"name": "Alice", "score": 85},
    {"name": "Bob", "score": 92},
    {"name": "Charlie", "score": 78}
]

# 错误写法:users.sort() ➔ TypeError: '<' not supported between instances of 'dict' and 'dict'

# 正确做法 1:通过 lambda 明确提取对比的字典字段
users_by_score = sorted(users, key=lambda u: u["score"])
print(users_by_score)

# 正确做法 2:使用标准库 operator.itemgetter(性能比 lambda 略高且更加直观)
from operator import itemgetter
users.sort(key=itemgetter("score"), reverse=True)
print(users)
# 输出已按 score 降序完成原地排序
场景四:自定义类实例没有定义比较规则
如果列表中存放的是自定义类的对象,直接排序同样会失败:
class Student:
    def __init__(self, name, age):
        self.name = name
        self.age = age

students = [Student("Tom", 18), Student("Jerry", 16)]
# 直接执行 students.sort() ➔ TypeError: '<' not supported between instances of 'Student' and 'Student'
对此类问题,有两种标准的解决途径:
- 使用 key 参数提取属性(推荐,轻量无需侵入类结构):
students.sort(key=lambda s: s.age)或使用标准库from operator import attrgetter; students.sort(key=attrgetter('age'))。 - 在类中实现比较魔术方法(适合该类具有全局唯一固定比较标准的场景):
在类中定义__lt__(小于)方法。为了获得完整的比较行为支持,建议配合functools.total_ordering装饰器:
from functools import total_ordering

@total_ordering
class Student:
    def __init__(self, name, age):
        self.name = name
        self.age = age

    def __lt__(self, other):
        if not isinstance(other, Student):
            return NotImplemented
        return self.age < other.age

    def __eq__(self, other):
        if not isinstance(other, Student):
            return NotImplemented
        return self.age == other.age

# 此时 Student 实例已具备原生的大小比较能力,可直接排序
students.sort()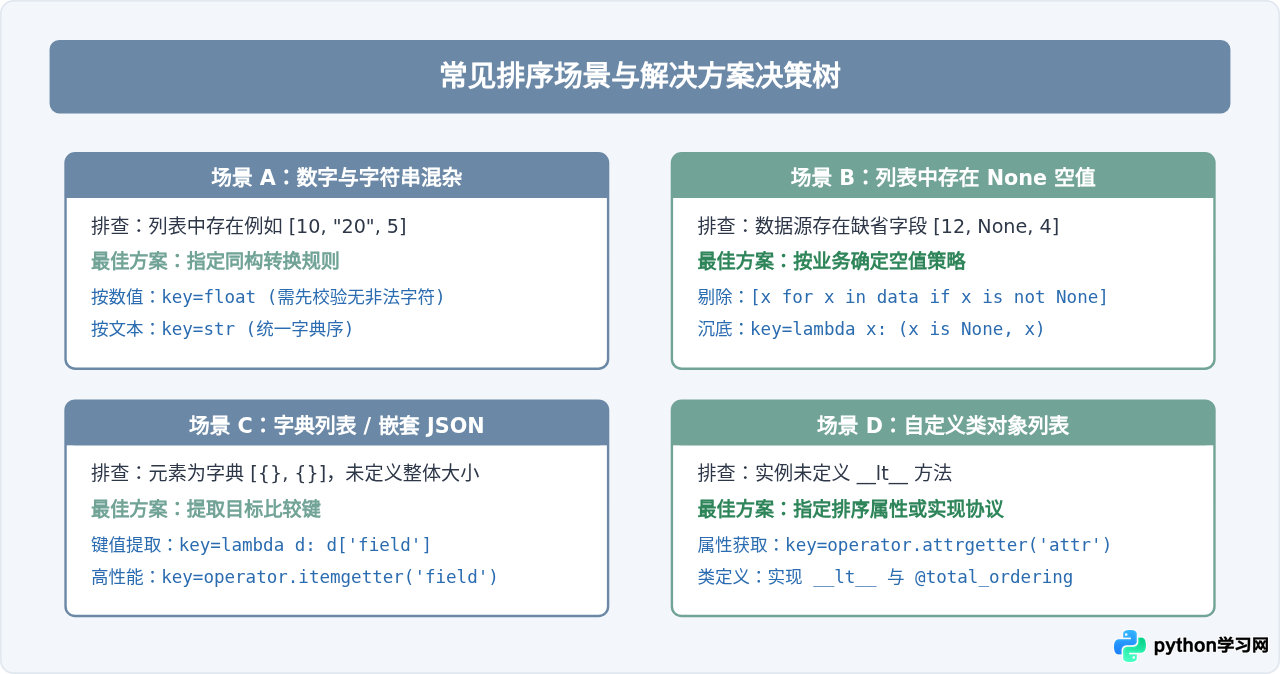
三、避免踩坑:sort() 与 sorted() 的关键误区
在处理排序报错时,除了修复 TypeError 本身,开发者常因对方法机制理解不透彻而引入衍生问题:
1. 误将 list.sort() 的返回值赋给新变量
list.sort() 是列表的原地修改方法,其返回值恒为 None;而 sorted() 则是返回全新排序列表的内置函数。
items = [5, 2, 8]

# 常见错误:将原地排序的结果重新赋值
items = items.sort()
print(items)  # 输出 None!后续代码访问 items 会引发 AttributeError 或新的 TypeError

# 正确做法:要么直接原地调用,要么使用 sorted() 接收新列表
items = [5, 2, 8]
items.sort()  # items 变为 [2, 5, 8]

# 或
items = [5, 2, 8]
new_items = sorted(items)  # new_items 为 [2, 5, 8],原 items 不受影响
2. key 函数执行期间产生新的异常
若在 key 转换中直接调用 int(x) 或 float(x),一旦列表中含有 "abc" 等非纯数字字符串,虽然避免了 TypeError,但会直接抛出 ValueError: invalid literal for int() with base 10。
key 中定义专用转换函数,对可能引发异常的元素提供默认回退值或容错逻辑:
def safe_num_key(val):
    # 将能够转换为数值的元素转为 float,无法转换的转为无穷大或沉底处理
    if val is None:
        return (2, 0.0)  # None 优先级最低
    try:
        return (0, float(val))  # 有效数值优先级最高
    except (ValueError, TypeError):
        return (1, str(val))   # 无法转数值的字符串按字典序排列

dirty_list = [10, "20", "invalid", None, 3.5, "1"]
safe_sorted = sorted(dirty_list, key=safe_num_key)
print(safe_sorted)
# 输出示例: ['1', 3.5, 10, '20', 'invalid', None]
四、验证与防御:如何确认问题已彻底解决
完成修复后,通过以下三步验证确保列表排序稳定且符合预期:
- 边界值验证:确保空列表
[]、单元素列表[x]以及全重复元素列表在调用排序时不抛出任何异常。 - 空值位置验证:检查处理后的输出,确认
None是否稳定停留在业务预期的首部或尾部。 - 单调性校验:对排序输出结果进行断言,确认满足递增或递减条件:
def is_non_decreasing(seq):
    return all(seq[i] <= seq[i + 1] for i in range(len(seq) - 1))

# 验证排好序的纯数字结果
test_result = [1, 2, 5, 8, 10]
assert is_non_decreasing(test_result), "排序结果未满足单调不减规则"
在实际生产环境中,最好的做法是在数据流进入排序前完成清洗和类型校验,杜绝异构脏数据进入核心计算逻辑。利用 key 参数提供的映射能力,既能彻底根治 TypeError,又能保证程序在面对复杂数据时兼具鲁棒性与清晰的逻辑可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









