

除了网页抓取,Python爬虫还能做什么自动化任务
深入解析Python爬虫技术在数据采集之外的自动化应用场景,包括网站接口巡检、日常表单自动填报、事件驱动型阈值监听以及前端业务冒烟测试,并提供落地步骤与防坑指南。
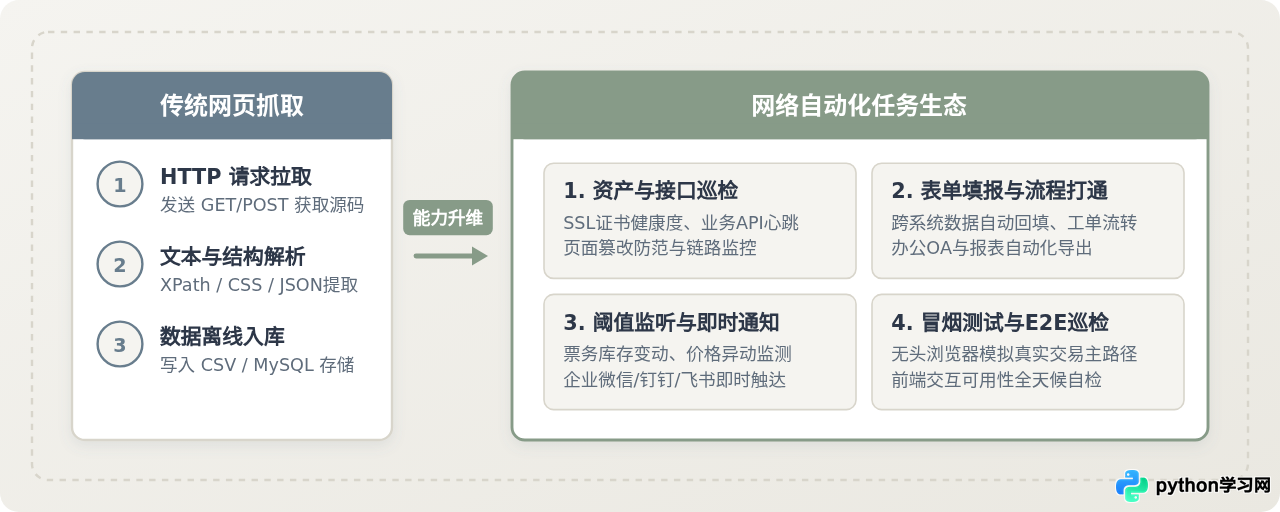
一、能力转变:从“被动数据拉取”到“主动事件驱动”
很多开发者在学习Python爬虫时,习惯将其定义为“批量数据下载器”:通过 requests 发起请求,用 BeautifulSoup 或 XPath 抽取字段,最后将成千上万行记录写入 CSV 文件或 MySQL 数据库。这种模式的本质是被动拉取并单向存储数据。
然而,如果拆解一个成熟爬虫的技术栈,会发现它掌握着 Web 交互中最为关键的几项能力:
- 会话与状态维持:能够通过 Cookie、Header、Token 模拟登录并保持长效鉴权。
- 网络协议精准模拟:能够构造符合服务端约定的任何 GET、POST、PUT 请求,携带合法参数与签名。
- 无头浏览器交互:借助 Playwright、Selenium 驱动真实 Chromium 内核,模拟人工点击、页面滚动、输入框填充与等待。
- 非结构化数据提炼:毫秒级从混乱的 HTML 文档或 JSON 数据包中精准识别目标数值。
一旦将技术链路末端的“保存入库”替换为“状态判定并触发下一个网络行为”,整个程序就从“爬虫”升维为了“业务自动化机器人”。这种转变不仅放大了技术的实用价值,还能直接替人工承接大量枯燥、重复、易出错的网络交互操作。
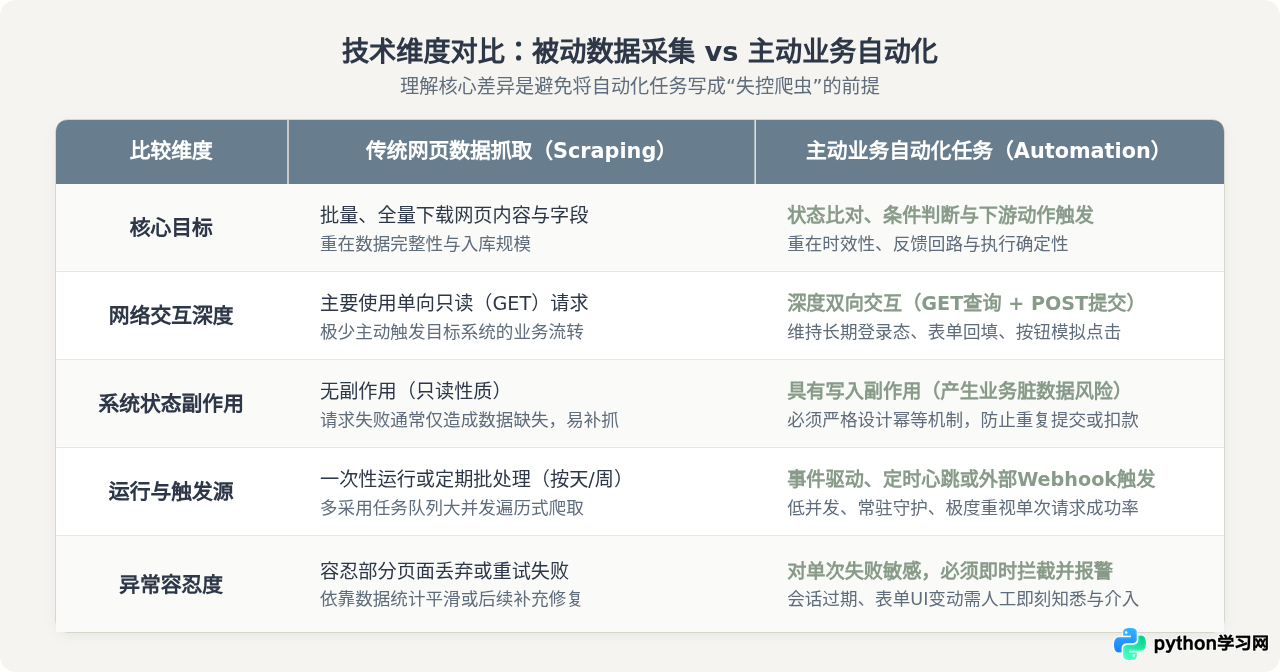
二、四大典型自动化任务场景与落地机制
脱离了单纯的数据采集后,Python爬虫技术在企业日常运营、运维巡检和个人提效中拥有极其广泛的自动化落地空间。以下四种场景代表了当前最成熟的应用形态。
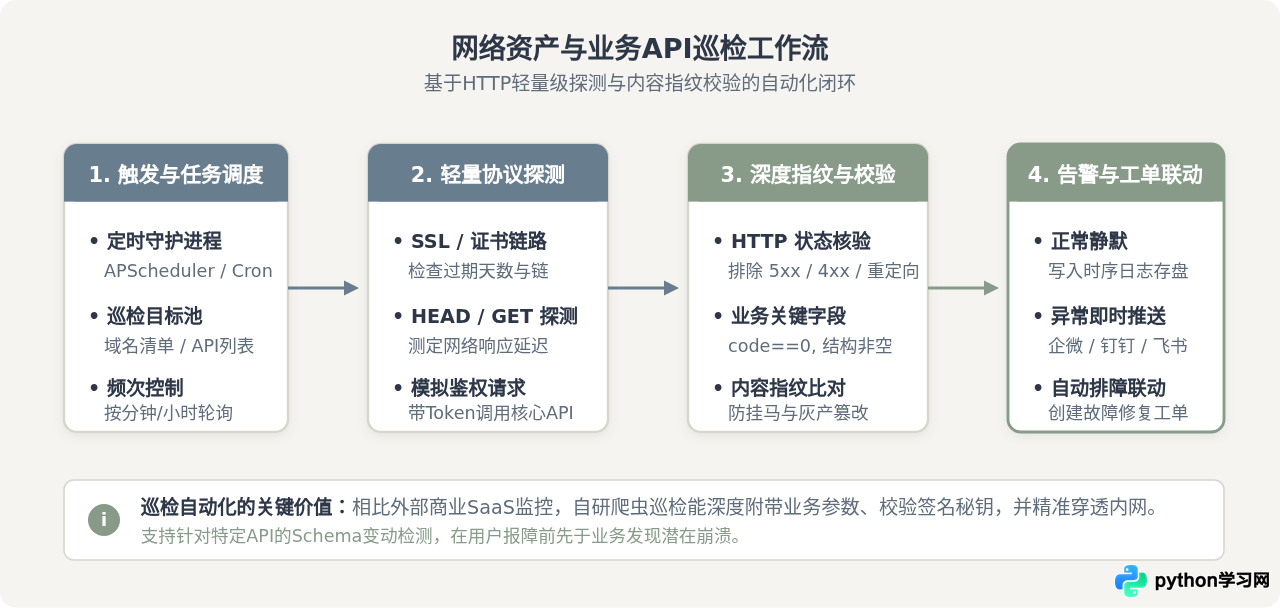
1. 网络资产健康度与业务API心跳巡检
运维人员经常面临一个挑战:通用的网络监控(如 Ping、Zabbix 基础监控)通常只能判断服务器端口是否存活,无法感知深层的业务故障。例如,某个页面虽然返回 HTTP 200,但实际界面展示的是“系统维护中”或“数据库连接池已满”;或者对外提供的第三方 API 响应正常,但内部关键字段 code 已经变成错误码。
利用爬虫构建定制化巡检脚本,可以低成本解决这一痛点:
- 深度业务级心跳验证:爬虫携带真实测试账号的鉴权凭据,定时请求核心接口,不仅校验 HTTP 响应码,更直接校验 JSON 返回结构体中是否包含关键字段与正确的业务标识。
- SSL证书与域名有效期倒计时:利用 Python 的
ssl与socket库定期抓取目标站点的数字证书,计算到期天数,在剩余时间不足 15 天时自动发出告警。 - 网页防篡改指纹核对:对公司官网、关键着陆页的关键 DOM 结构或全局静态文本计算哈希值(Hash)。一旦遭遇恶意篡改或误发布,脚本能在下一轮巡检中立即发现哈希不符并锁定现场。
2. 跨系统表单自动填报与审批流转
在很多企事业单位的日常办公中,存在大量老旧的 OA 系统、财务系统或资产管理平台。这些系统往往建设于早期,没有提供标准开放的 OpenAPI,却需要人工每天把 Excel 表格中的数据逐项录入,或者在固定时间进行健康打卡、考勤核销。
借助爬虫技术,这类“在网页上填表点击”的人力劳动可以被完整自动化:
- 协议级批量回填:通过浏览器开发者工具抓取表单提交(POST)的数据结构,使用
requests.Session()读取本地 Excel,组装表单 Payload 直接发送至服务端。原本需要人工录入半天的上百条数据,脚本几秒即可准确完成。 - UI级无头流转:对于带有复杂前端加密、前端事件依赖或特殊富文本编辑器的表单,可采用 Playwright 打开无头浏览器,定位表单输入框自动填充,并点击“确认提交”与“提交审批”。
3. 稀缺资源与高价值事件的变动监听
某些网络信息的发布具有突发性和高度的时间敏感性,例如:政府招投标网站的项目公告更新、特定资质报名的考位释放、服务器云资源抢占式实例的价格低谷,或是关键开源项目的紧急漏洞安全通报。
传统人工巡查需要频繁刷新网页,极易遗漏。自动化任务的设计方法如下:
- 轻量化轮询与 ETag 嗅探:爬虫以合理的时间间隔请求页面,优先携带
If-None-Match或If-Modified-Since请求头。若服务器返回304 Not Modified,则不消耗额外带宽;若返回全新内容,则解析提取目标列表。 - 差量比对(Diff):本地维护一个轻量级数据库(如 SQLite)或内存集合,只对本次提取到的唯一 ID 或数据哈希进行比对。
- 多通道即时推送:一旦发现新增条目,直接调用飞书机器人、企业微信机器人或钉钉 Webhook,将标题、链接与核心摘要即时投递到运维或业务群聊中。
4. 生产/预发链路的自动化冒烟测试
在持续集成与交付(CI/CD)流程中,研发团队通常会编写单元测试。然而,真实的生产环境往往会受到 CDN 缓存穿透、第三方 SDK 阻断、跨域配置变更等复杂网络因素影响。
使用爬虫工具(特别是 Playwright/Selenium)可以编写全天候的“冒烟机器人”:
机器人每隔半小时模拟一个真实匿名或测试用户,打开电商网站首页,搜索指定商品,加入购物车,进入结算页面并验证价格计算规则,最后在不触发实际扣款的安全边界内完成退出。这种全流程端到端(E2E)模拟验证能够在普通用户报障之前,先于客服团队发现交易主流程的系统故障。
三、两种实现路径对比:接口级自动化 vs 界面级自动化
在实施具体的自动化任务前,开发者必须在两种技术路径中做出清晰选择:基于 HTTP 协议的接口级自动化(以 Requests/Httpx 为代表),以及基于无头浏览器的界面级自动化(以 Playwright 为代表)。两者并非替代关系,而是适用边界各异。
| 比较维度 | 接口级自动化(Requests / Httpx) | 界面级自动化(Playwright / Selenium) |
|---|---|---|
| 实现原理 | 直接构造 TCP/HTTP 请求包,与服务端 API 通信 | 驱动完整浏览器内核,解析 HTML/CSS/JS 并模拟人机交互 |
| 资源消耗 | 极低。单进程可同时处理上百个探测任务,内存占用通常低于 30MB | 较高。单个 Chromium 进程内存占用约 150MB~400MB,并发受限 |
| 执行速度 | 毫秒级。仅受网络往返时延(RTT)影响,通常在 50ms~300ms 完成 | 秒级。需要等待页面加载、静态资源下载及 DOM 渲染,通常需 1s~5s |
| 对抗动态前端 | 较难。面对复杂 WASM、JS 混淆签名加密时,需要耗费大量时间逆向 | 极高。原生执行前端 JS,无视常规数据加密与复杂动态渲染 |
| 稳定性与维护 | 较高。API 接口通常具有版本向后兼容性,不易频繁突变 | 较脆弱。前端页面改版、CSS 类名重命名可能导致元素选择器失效 |
| 推荐场景 | 资产巡检、API 心跳监控、标准 REST 接口批量数据录入 | 跨系统复杂表单录入、包含复杂图形滑块验证的流程、E2E冒烟测试 |
在设计自动化任务时,始终坚持“接口优先”原则。只要能在浏览器开发者工具的“网络(Network)”面板中捕获到纯净的 JSON 接口,就优先使用 Requests 实现;仅当接口遭遇高强度反爬(如动态环境风控指纹)或表单逻辑极度重赖前端交互事件时,才退回使用 Playwright 模拟用户操作。
四、通用自动化任务的四步落地流水线与实战示例
一个健壮的自动化任务程序不能写成一段随意的线性脚本。为了保证长期无人值守运行的稳定性,应当遵循标准化的四步流水线架构。
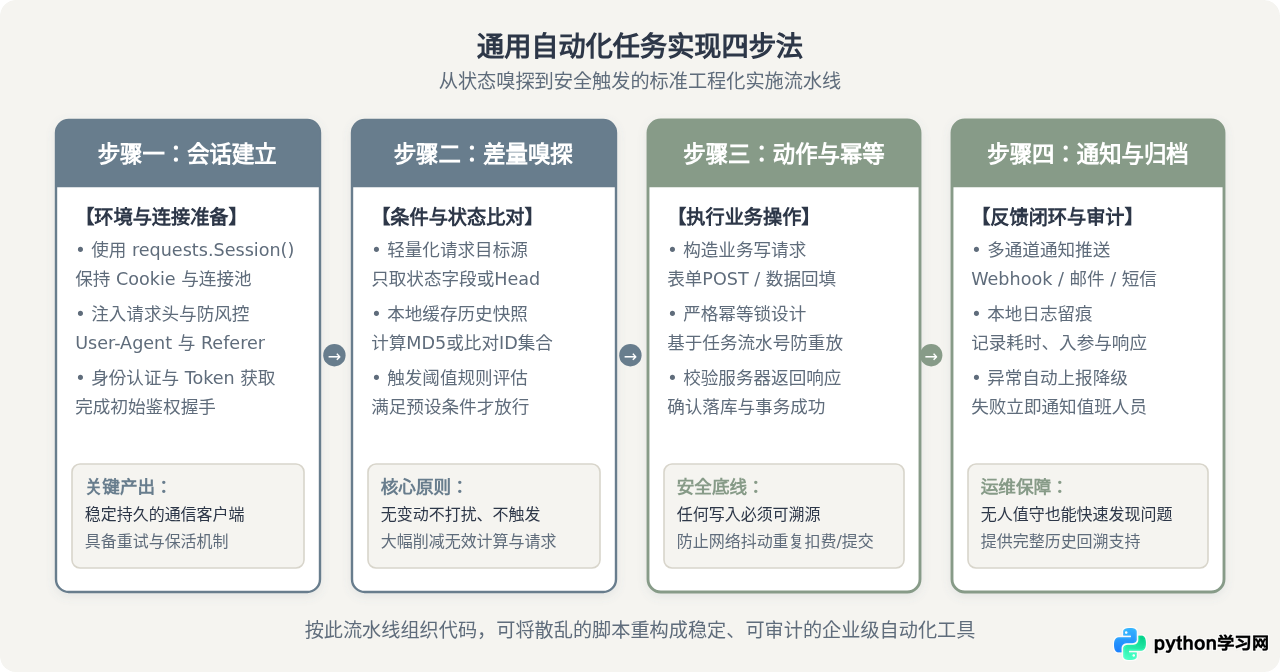
步骤拆解
- 会话初始化与鉴权保持:实例化
requests.Session(),预设带有合理超时(Timeout)与重试策略的适配器,配置标准 User-Agent,完成登录握手并加载 Cookie。 - 轻量嗅探与差量比对:发起探针请求。将获取的数据与本地存储的历史状态(如已处理的公告 ID 列表)进行快速差量比对。若无新增事件,则立即结束本轮执行,避免无意义消耗资源。
- 动作执行与幂等控制:若触发条件满足,执行目标操作(如提交表单、状态变更)。在此处必须设计基于业务流水号的幂等锁,防止因网络重试导致多次提交。
- 结果反馈与告警触达:将操作结果写入结构化日志,并通过企业即时通讯机器人或邮件通知责任人,完成闭环。
可运行实战代码:高危接口巡检与异常自动告警
以下示例演示了一个生产级 API 心跳与数据健康巡检脚本。该脚本定期检测业务系统的核心接口,并在返回异常或响应延迟过大时,通过 Webhook 自动推送预警。
# -*- coding: utf-8 -*-
# 执行环境:Python 3.9+,依赖 requests 库
# 执行位置:可部署于本地定时器、独立云主机或 Linux Crontab

import time
import logging
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)

class ApiHealthMonitor:
    def __init__(self, target_url, webhook_url, timeout_sec=3.0):
        self.target_url = target_url
        self.webhook_url = webhook_url
        self.timeout_sec = timeout_sec
        self.session = self._init_session()

    def _init_session(self):
        """构建具备自动指数退避重试能力的 Session"""
        session = requests.Session()
        retries = Retry(
            total=2,
            backoff_factor=0.5,
            status_forcelist=[500, 502, 503, 504]
        )
        adapter = HTTPAdapter(max_retries=retries)
        session.mount("http://", adapter)
        session.mount("https://", adapter)
        session.headers.update({
            "User-Agent": "ServiceProbe/1.0 (Automated Health Checker)",
            "Accept": "application/json"
        })
        return session

    def check_health(self):
        """步骤二:发起探测并校验业务语义"""
        start_time = time.time()
        try:
            resp = self.session.get(self.target_url, timeout=self.timeout_sec)
            elapsed_ms = round((time.time() - start_time) * 1000, 2)

            # 1. 基础 HTTP 状态码校验
            if resp.status_code != 200:
                self.notify_alert(f"HTTP状态异常: {resp.status_code}", elapsed_ms)
                return False

            # 2. 深度业务数据结构校验
            payload = resp.json()
            if payload.get("code") != 0:
                err_msg = payload.get("message", "未知业务错误")
                self.notify_alert(f"业务错误码异常: {payload.get('code')}, 原因: {err_msg}", elapsed_ms)
                return False

            logging.info(f"服务正常 - 响应延迟: {elapsed_ms}ms")
            return True

        except requests.exceptions.Timeout:
            self.notify_alert(f"接口响应超时(超过{self.timeout_sec}秒)", elapsed_ms=-1)
            return False
        except Exception as e:
            self.notify_alert(f"网络连接异常: {str(e)}", elapsed_ms=-1)
            return False

    def notify_alert(self, issue_description, elapsed_ms):
        """步骤四:触发多渠道告警通知推送"""
        alert_body = {
            "msg_type": "text",
            "content": {
                "text": (
                    f"【系统巡检告警】
"
                    f"监控目标: {self.target_url}
"
                    f"故障描述: {issue_description}
"
                    f"耗时指标: {elapsed_ms} ms
"
                    f"发现时间: {time.strftime('%Y-%m-%d %H:%M:%S')}"
                )
            }
        }
        try:
            # 发送 Webhook 提醒(示例使用企业微信/飞书通用格式)
            resp = self.session.post(self.webhook_url, json=alert_body, timeout=5.0)
            logging.warning(f"告警已发出: {issue_description}, 回执: {resp.status_code}")
        except Exception as send_err:
            logging.error(f"发送告警失败: {send_err}")

if __name__ == "__main__":
    # 生产环境配置(示例地址)
    MONITOR_API = "https://api.example.com/v1/health/ping"
    WEBHOOK_EP = "https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=demo-token"

    checker = ApiHealthMonitor(target_url=MONITOR_API, webhook_url=WEBHOOK_EP)
checker.check_health()五、生产环境运行的注意事项与安全边界
自动化任务与常规爬虫最大的不同在于:常规爬虫抓取失败最多损失部分分析数据,而自动化任务一旦失控,可能直接向生产库写入脏数据、被上游防火墙永久拉黑,甚至引发重复扣款或表单泛滥。
1. 严格设计写操作的幂等性
任何包含 POST、PUT、DELETE 的自动化动作,必须在本地或共享缓存(如 Redis)中记录状态标识键(Idempotency Key)。例如,在自动回填审批表单时,以 业务单号 + 日期 计算唯一 MD5 并存储。脚本在每次执行前检查该 MD5 是否已处于“已完成”状态,杜绝由于网络超时重试引发的二次提交。
2. 会话过期与静默失效应对
自动化脚本通常需要长期守护运行,而登录态(Cookie / Token)大多具有生命周期(如 2 小时或 7 天)。不可假设登录态永远有效。脚本必须具备“先校验登录态,若 401/403 则自动触发重新认证或短信/扫码报警”的兜底逻辑,避免因鉴权静默失效导致后续的自动化流程全线挂起。
3. 频率限制与上游系统保护
无论巡检内部系统还是监听外部站点,必须设置理性的时间间隔(例如巡检任务 1~5 分钟一次,资源监听 30~60 秒一次)。短时间内无节制的高并发轮询既不符合自动化任务的设计初衷,还会增加目标服务器负载,极易触发安全风控系统的 IP 封禁与验证码拦截。
六、知识总结与技术选型指南
Python爬虫远非只有“爬取数据入库”这单一维度。从本质上看,爬虫技术是开发者与开放网络(以及缺乏标准API的封闭系统)进行程序化对话的通用钥匙。只要将数据输入与逻辑分支、反馈触达相互结合,它就能在日常工程中演化为高效、省时且低成本的自动化中枢。
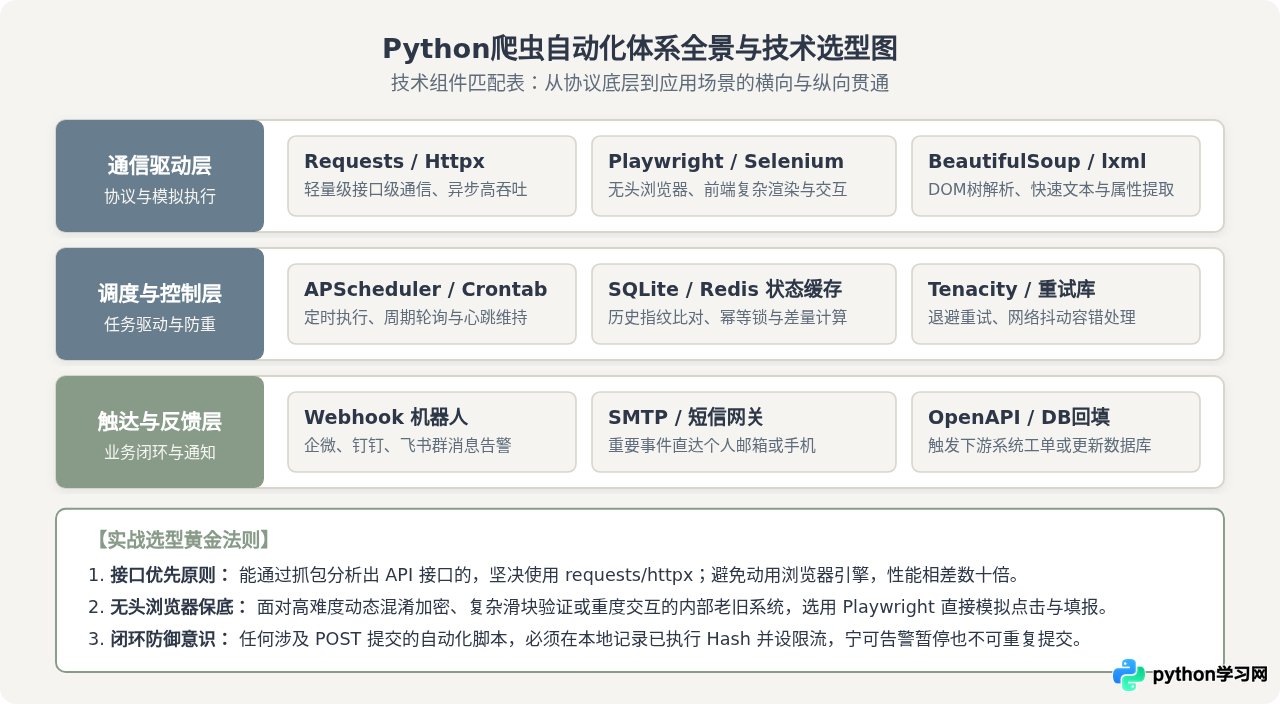
在规划具体的自动化方案时,可参考以下原则:
- 轻量级监控与接口交互:选用
Requests+APScheduler+企业微信/飞书 Webhook,构建轻巧稳定的常驻守护进程。 - 复杂前端人机模拟:选用
Playwright(采用headless=True模式),结合系统级选择器,稳定搞定跨系统表单录入与主链路冒烟测试。 - 闭环审计与容错:始终配备本地持久化状态缓存(SQLite/Redis)与结构化日志输出,确保任何自动化变更均可追溯、可审计。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









