

Python爬虫技术栈全景:从请求、解析到存储的常用库推荐
全面梳理Python爬虫技术栈,从网络请求、网页解析到数据持久化存储,结合实际代码和对比分析,提供清晰的技术选型指南。
编写爬虫本质上是在模拟客户端与服务器的交互流程。一个标准的爬虫程序通常由三个核心环节构成:首先通过网络请求库获取目标网页或接口数据,接着借助解析库从原始文本中精确提取所需字段,最后使用适合的数据持久化库将结果结构化存储到本地文件或数据库中。理清各阶段常用库的特点与适用边界,能够帮助我们在面对静态页面、动态渲染接口以及大规模抓取任务时迅速做出合理的技术选型。
一、请求层:如何高效获取目标内容
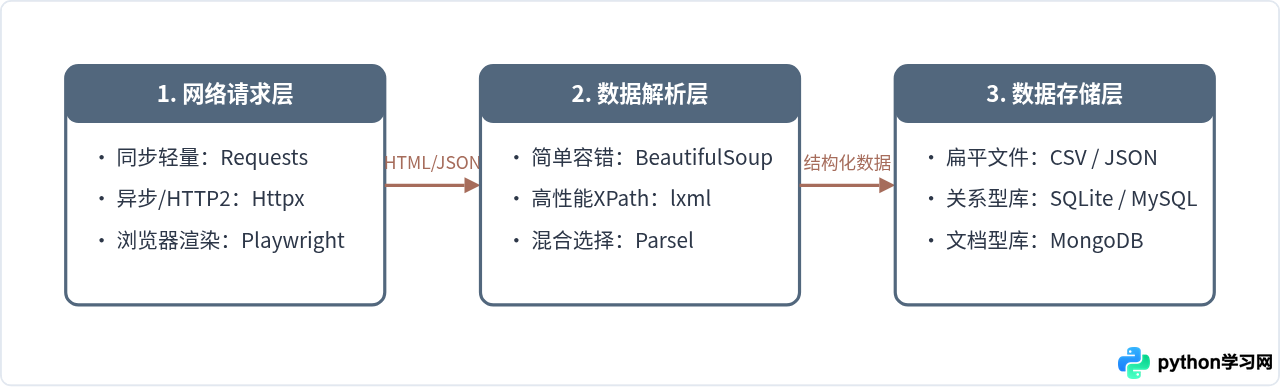
网络请求是爬虫的第一道关卡。根据目标站点的内容渲染模式(服务端静态直出 vs 客户端JavaScript动态渲染)以及采集并发量,可选的方案在复杂度与资源开销上有显著不同。
1. Requests:同步阻塞场景的首选
对于大部分直接返回 HTML 或标准 JSON 数据的站点,requests 依然是开发体验最直观的库。其简洁的 API 封装省去了繁琐的底层网络细节,适合中小型采集脚本与快速验证原型。
import requests

url = "https://api.github.com/events"
headers = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"
}

response = requests.get(url, headers=headers, timeout=10)
if response.status_code == 200:
    data = response.json()
    print(f"成功获取 {len(data)} 条数据")
2. Httpx 与 Aiohttp:高并发与现代协议支持
当目标页面数量达到数万级,或者需要通过代理池发起密集请求时,基于多线程的 requests 往往会消耗过多系统资源。此时基于 asyncio 的 httpx 或 aiohttp 能够提供更高的吞吐效率。其中 httpx 不仅 API 设计与 requests 保持高度兼容,还原生支持 HTTP/2 协议与异步客户端模式。
import asyncio
import httpx

async def fetch(url):
    async with httpx.AsyncClient(http2=True) as client:
        resp = await client.get(url, timeout=10.0)
        return resp.status_code

# asyncio.run(fetch("https://httpbin.org/get"))
3. Playwright 与 Selenium:处理强动态与逆向难题
许多现代前端站点依赖复杂的单页应用框架(如 Vue、React),数据仅在浏览器端执行 JavaScript 后才呈现,或者设置了高难度的前端代码混淆与行为验证。直接逆向接口成本较高时,可以使用自动化浏览器直接捕获完整渲染后的 DOM。目前 playwright 在执行性能、自动等待机制以及多浏览器(Chromium/Firefox/WebKit)支持上相比传统 selenium 具备明显优势。
二、解析层:从HTML与接口文本中精准提取
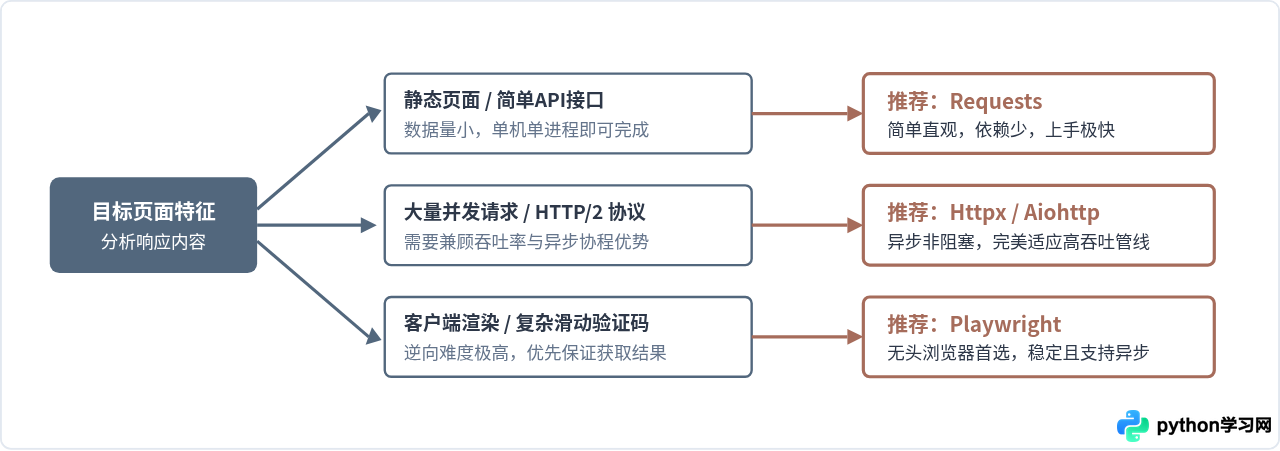
获得页面文本后,我们需要定位目标数据节点。常见的解析方法分为两类:CSS选择器与XPath表达式。根据对解析速度、容错率以及语法支持的要求,主要有以下三个常用库:
1. BeautifulSoup4:宽容度极高的入门利器
许多实际网页存在标签未闭合、嵌套不规范等语法缺陷。beautifulsoup4(通常搭配 lxml 作为解析器)拥有极强的容错修复能力,提供了易读的方法名(如 find、find_all),非常适合编写快速清洗的小脚本。
2. lxml:追求极致性能的C语言底层解析
lxml 底层基于成熟的 libxml2 和 libxslt 库构建,在处理超大体积文档或批量处理数万个网页时,速度往往是纯 Python 实现的数倍至数十倍。它对 XPath 1.0 语法的完整实现,能够利用轴定位与条件过滤快速锁定深层节点。
3. Parsel:结合CSS与XPath的双重优势
作为 Scrapy 内部提取模块的核心独立发行版,parsel 同时支持 CSS 选择器、XPath 以及正则表达式的链式调用。在实际提取中,如果 CSS 选择器无法精准表达“某节点的父级同胞”等逻辑,可以随时无缝衔接 XPath,代码表达力极高。
from parsel import Selector

html_doc = """
<div class="content">
    <h1>文章标题</h1>
    <ul class="item-list">
        <li data-id="101"><a href="/item/101">项目 A</a></li>
        <li data-id="102"><a href="/item/102">项目 B</a></li>
    </ul>
</div>
"""

sel = Selector(text=html_doc)
# 使用 CSS 提取标题文本
title = sel.css("div.content > h1::text").get()
# 使用 XPath 提取所有项目链接
links = sel.xpath("//ul[@class='item-list']//a/@href").getall()

print("Title:", title)
print("Links:", links)
json 模块或 response.json() 直接转为字典,而无需使用 HTML 解析库进行低效的字符正则匹配。
三、存储层:结构化数据的持久化落地
提取出的字段必须持久化保存。选择何种存储方式主要取决于数据的最终消费形式、数据量级以及字段模式(Schema)的变动频率。
| 存储媒介 | 推荐库 | 适用数据形态 | 读写特征与场景建议 |
|---|---|---|---|
| CSV / JSON 文件 | 内置 csv / json, pandas |
结构规则、单次导出 | 文件小、便于人工抽检与交付表格,无需额外数据库服务。 |
| 嵌入式关系库 | 内置 sqlite3 |
本地轻量关系型数据 | 零配置单文件数据库,支持标准 SQL 与事务,适合单机爬虫排重。 |
| 生产级关系库 | PyMySQL, SQLAlchemy |
高并发写入、关系复杂 | 适合多人协作或对接后台管理系统,数据模式固定且要求强一致性。 |
| 文档型非关系库 | pymongo |
字段动态、层级嵌套 | 天然适配 JSON 格式,字段随时可增删,适合多源异构采集清洗。 |
四、实战全流程操作示例
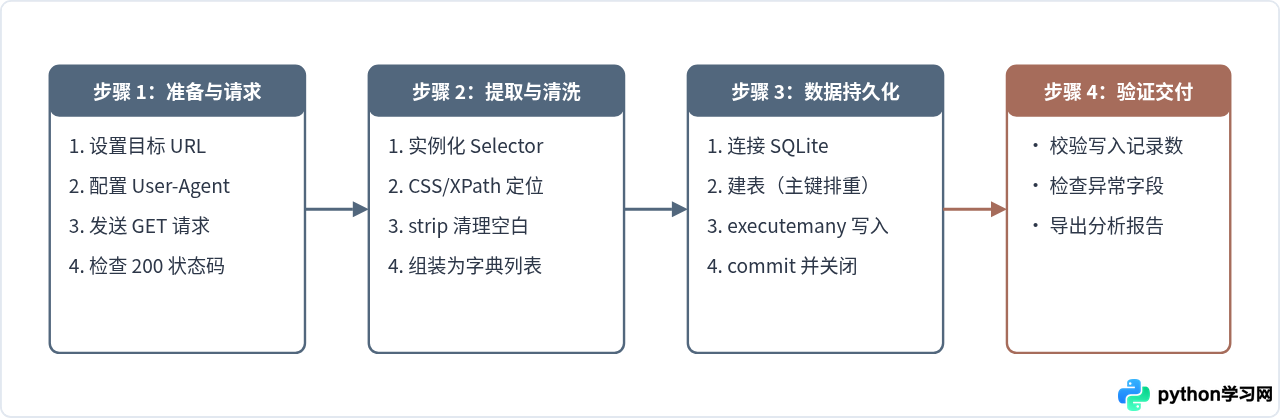
下面通过一个由 requests 请求、parsel 解析以及 sqlite3 存储构成的完整脚本,展示三个环节在实际代码中的有机串联。
import sqlite3
import requests
from parsel import Selector

# 1. 发起网络请求
url = "https://quotes.toscrape.com/"
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}
resp = requests.get(url, headers=headers, timeout=10)

# 2. 页面元素解析
sel = Selector(text=resp.text)
quotes_data = []
for quote in sel.css("div.quote"):
    text = quote.css("span.text::text").get("").strip()
    author = quote.css("small.author::text").get("").strip()
    if text and author:
        quotes_data.append((text, author))

# 3. 数据存入本地 SQLite
conn = sqlite3.connect("quotes.db")
cursor = conn.cursor()
cursor.execute("""
    CREATE TABLE IF NOT EXISTS quotes (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        content TEXT UNIQUE,
        author TEXT
    )
""")

cursor.executemany(
    "INSERT OR IGNORE INTO quotes (content, author) VALUES (?, ?)",
    quotes_data
)
conn.commit()
print(f"成功保存 {len(quotes_data)} 条记录至 SQLite")
conn.close()
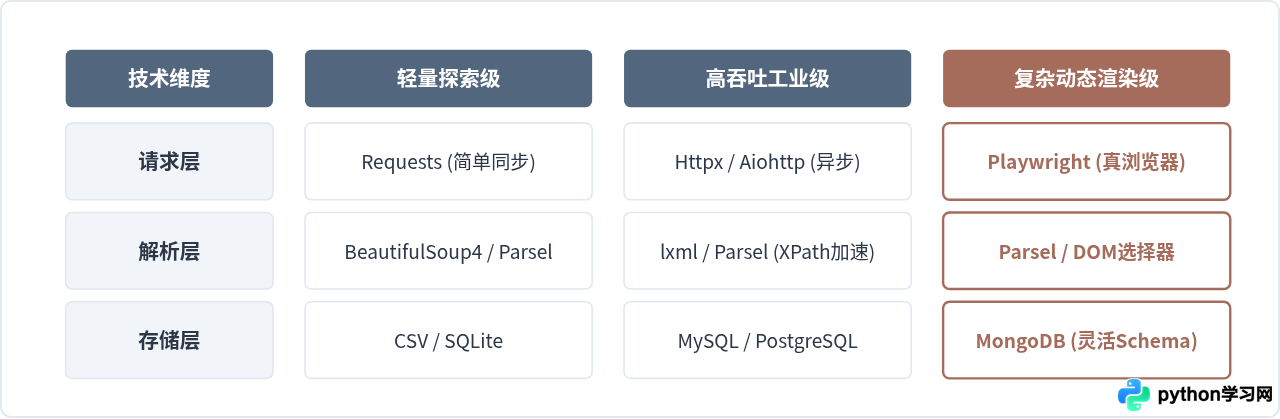
五、全景总结:不同规模下的组合策略
没有放之四海而皆准的组合,只有与需求规模高度契合的架构。根据业务体量与工程复杂度,推荐以下三种经典搭配:
- 轻量级单任务脚本:
Requests + Parsel / BeautifulSoup + SQLite / CSV。无需额外守护进程,几十行代码即可完成几十到数万条数据的单次采集。 - 大规模高并发抓取:
Httpx (Async) + lxml + Redis (队列排重) + MySQL / MongoDB。借助事件循环与异步连接池,充分压榨单机网络带宽。 - 重度动态渲染与反爬体系:
Playwright + Parsel + MongoDB。通过自动化无头浏览器绕过前端代码混淆,配合无模式数据库容纳多变的页面属性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









