

Python中dict[key]与dict.get(key)有什么区别?
深入对比Python字典中dict[key]下标访问与dict.get(key)方法的核心区别,系统解析键缺失行为、默认值机制、None值陷阱、底层字节码执行与实战选型原则。
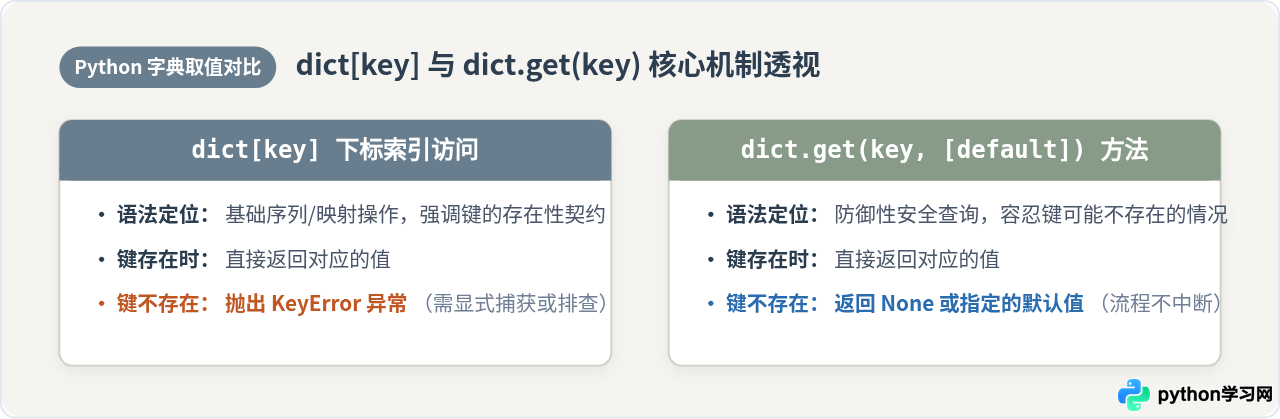
在 Python 中,通过下标索引 dict[key] 与通过内置方法 dict.get(key) 访问字典元素,核心区别在于键不存在时的错误处理机制、默认值支持策略以及底层执行与性能表现。当待查询的键存在于字典中时,两者的行为完全一致,均直接返回与该键绑定的值对象;但当键缺失时,dict[key] 会强制抛出 KeyError 异常中断执行,而 dict.get(key) 则默认返回 None(或指定的备用默认值)以保持控制流的平稳延续。理解两者的设计意图与边界,不仅能帮助我们写出健壮的容错代码,也能避免诸如“None值二义性”等常见隐蔽缺陷。
一、核心行为差异:键存在与缺失时的响应逻辑
字典是 Python 最核心的内置映射类型。在日常开发中,从字典中提取数据的需求几乎无处不在。dict[key] 遵循的是 Python 的通用下标索引协议(即 __getitem__ 机制),它假定所请求的键是业务流程中理应存在的“契约”。一旦这一前置假设被打破,Python 便通过异常机制通知调用方,要求其正视未预期的缺失数据。
相比之下,dict.get(key) 则是一种更宽容的“防御式检索”接口。它接受键可能存在也可能不存在的客观情况,将缺省处理收敛在方法返回值本身,而不是借助异常来扭转控制流。
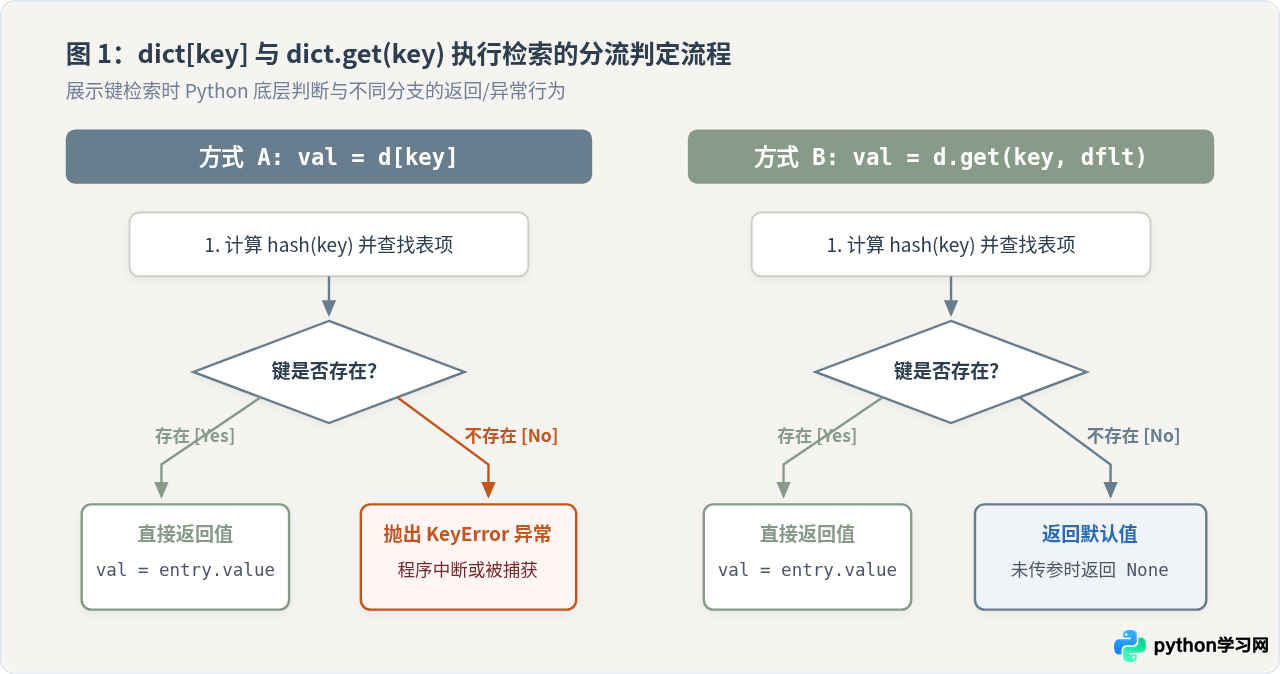
1. 键存在时的表现对比
当目标键存在于字典中时,两种方式的行为完全等价,均直接返回对应的映射值:
# 环境:Python 3.8+
profile = {"name": "Alice", "role": "admin"}

# 两种方式均成功返回字符串 'Alice'
val_index = profile["name"]
val_get = profile.get("name")

print(f"val_index: {val_index}, val_get: {val_get}")
# 示例输出:val_index: Alice, val_get: Alice
2. 键不存在时的行为分流
当查询一个不存在的键时,两种方式的差异立即显现:
profile = {"name": "Alice"}

# 方式一:dict[key] 抛出异常
try:
    email = profile["email"]
except KeyError as e:
    print(f"捕获到异常:KeyError {e}")
# 示例输出:捕获到异常:KeyError 'email'

# 方式二:dict.get(key) 返回预设值,流程不中断
email = profile.get("email")
print(f"获取结果:{email}")
# 示例输出:获取结果:None
如果业务本身要求 email 必须存在,那么抛出 KeyError 能够让逻辑错误在第一时间暴露,避免脏数据流入下游系统;但如果 email 本就是可选配置,抛出异常就会增加捕获代码的冗余,此时 dict.get() 显然更为精炼。
二、默认值机制与“None值”判断陷阱
dict.get() 方法完整的签名是 dict.get(key, default=None)。其中第二个参数 default 允许开发者明确指定当键不存在时返回的替补对象。如果省略该参数,默认回退为 None:
config = {"timeout": 30}

# 未显式传递 default,缺失时返回 None
retry = config.get("retry")
print(f"retry: {retry}")
# 示例输出:retry: None

# 显式传递 default,缺失时返回指定的 3
retry_with_default = config.get("retry", 3)
print(f"retry_with_default: {retry_with_default}")
# 示例输出:retry_with_default: 3在实际项目中,许多开发者习惯通过
if d.get(key) is None: 来推断某个键是否在字典中不存在。这在多数情况下可行,但存在一个严重的逻辑漏洞:当字典中确实存在该键,且该键存储的值恰好就是 None 时,这种判断方式就会产生误判。
请观察以下具体场景:在解析 JSON 配置或数据库结果集时,字段值往往允许为 null(在 Python 中映射为 None)。
# 场景:用户配置中显式关闭了某些字段(值为 None)
user_data = {
    "nickname": "Bob",
    "avatar_url": None  # 键存在,但用户未上传头像,值为 None
}

# 检索存在的键 'avatar_url'
res1 = user_data.get("avatar_url", "default_avatar.png")

# 检索根本不存在的键 'bio'
res2 = user_data.get("bio", "default_avatar.png")

print(f"avatar_url 取值: {res1}")
print(f"bio 取值: {res2}")
# 示例输出:
# avatar_url 取值: None
# bio 取值: default_avatar.png
在上面的示例中,因为 avatar_url 键是存在的,所以 user_data.get("avatar_url", "default_avatar.png") 并不会触发默认值替换,而是如实返回了其存储的 None。反之,对于不存在的 bio,则返回了默认值 "default_avatar.png"。
如果仅仅依靠 d.get(key) is None 来判断“键是否配置”,就会把“配置了但值为None”与“完全未配置”混为一谈。因此,在需要严格验证键存在性的场景中,必须使用 in 操作符或显式检查:
# 严格判断键是否存在
if "avatar_url" in user_data:
    print("键 avatar_url 存在于字典中(即使其值为 None)")
else:
    print("键不存在")
# 示例输出:键 avatar_url 存在于字典中(即使其值为 None)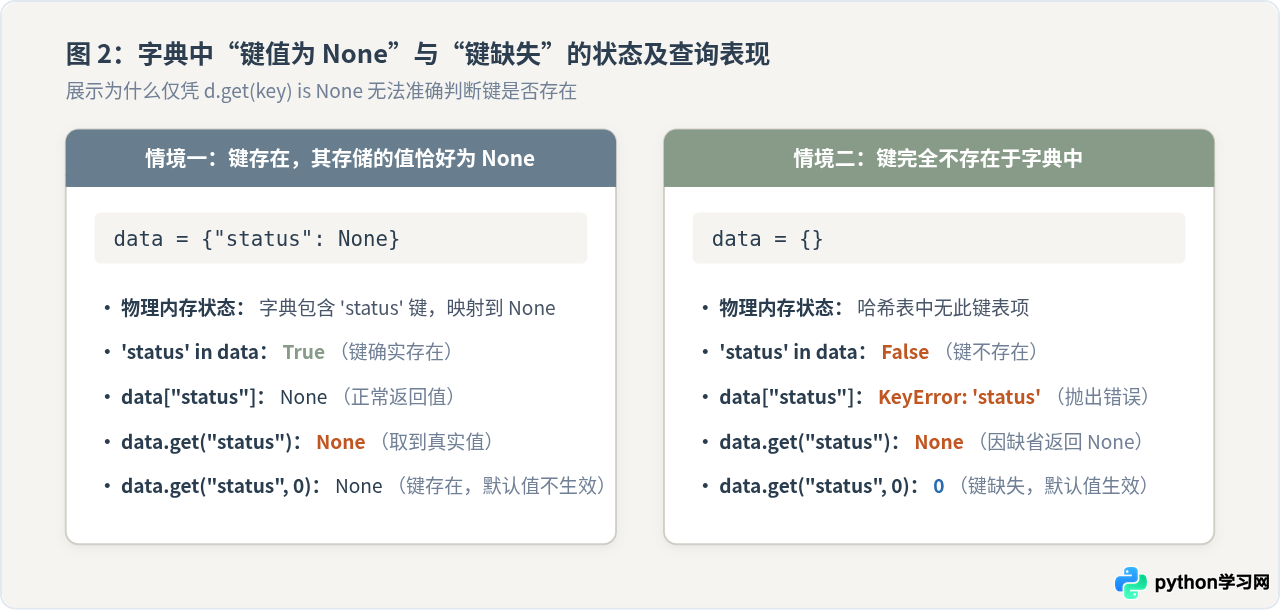
三、底层字节码机制与微观性能剖析
除了语法和逻辑层面的差异外,dict[key] 与 dict.get(key) 在 Python 虚拟机(CPython)内部的运行机制也有所不同。这也是许多高性能框架或基础库在确定键存在时更偏好下标访问的重要原因。
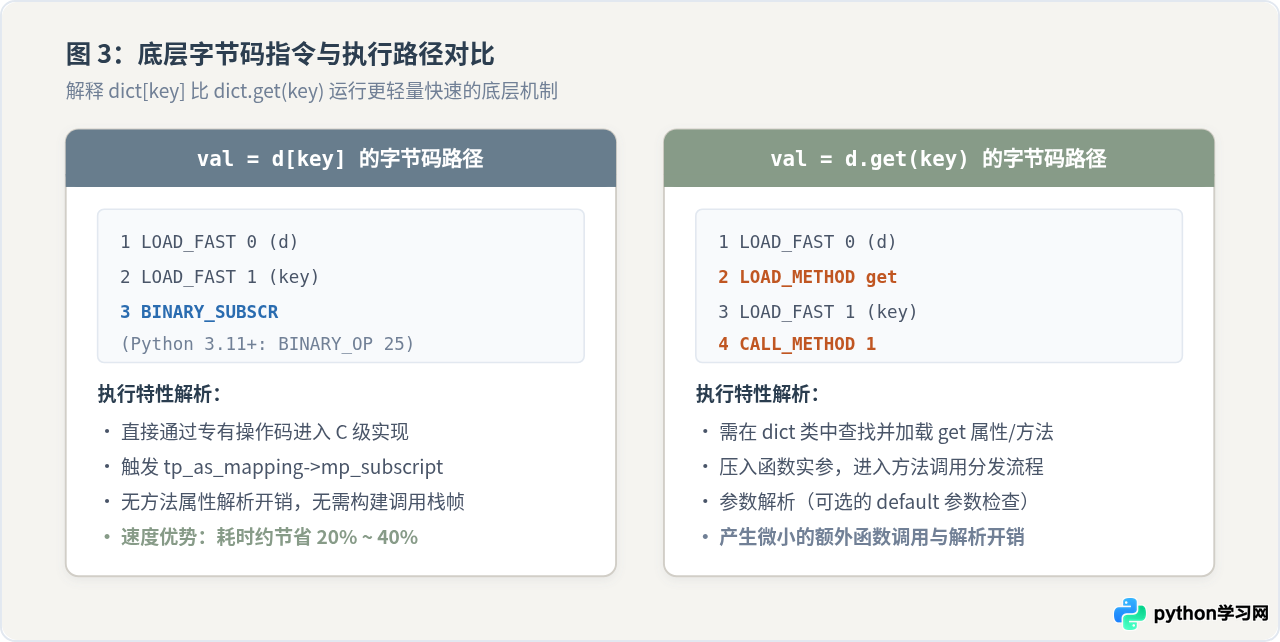
1. 字节码指令对比
借助标准库中的 dis 模块,我们可以直观查看两者的底层操作指令:
import dis

def access_by_index(d, k):
    return d[k]

def access_by_get(d, k):
    return d.get(k)

print("--- access_by_index 字节码 ---")
dis.dis(access_by_index)

print("
--- access_by_get 字节码 ---")
dis.dis(access_by_get)
在 Python 3.10 / 3.11 及更高版本中,两者的字节码输出关键部分如下(示例):
# access_by_index 字节码片段:
#   LOAD_FAST               0 (d)
#   LOAD_FAST               1 (k)
#   BINARY_SUBSCR           # 核心:一条专用的下标索引操作码,直接调用 C 级映射槽
#   RETURN_VALUE

# access_by_get 字节码片段:
#   LOAD_FAST               0 (d)
#   LOAD_METHOD             0 (get)  # 需查找并加载字典对象的 get 方法
#   LOAD_FAST               1 (k)
#   CALL_METHOD             1        # 触发函数调用栈帧与入参规整
#   RETURN_VALUE
从指令层面可以看出:
dict[key]对应专有的BINARY_SUBSCR指令,虚拟机直接进入 C 源码中的PyObject_GetItem及字典特化的dict_subscript,路径极短。dict.get()则是一次标准的方法调用,需要经过属性查找、方法对象解构与函数调用规整过程。即便现代 CPython 引入了快速方法调用优化,其调用链依旧比纯操作码更长。
2. 性能基准与客观评价
在已知键一定存在的基准测试中,使用 dict[key] 通常比 dict.get(key) 快约 20% 到 40%。但是需要明确的是,这种耗时差距属于纳秒(ns)级别(单次查询通常在数十纳秒内)。
在绝大多数业务应用(如 Web 服务、数据加工、脚本工具)中,网络 I/O、数据库查询和序列化耗时远超纳秒级的指令开销,无需为了微小的性能优势而牺牲代码可读性与安全性。只有在处于数百万次以上的严苛高频循环、核心算法内循环或量化高频交易场景中,
dict[key] 的速度红利才具有实质意义。
四、选型原则与实战决策树
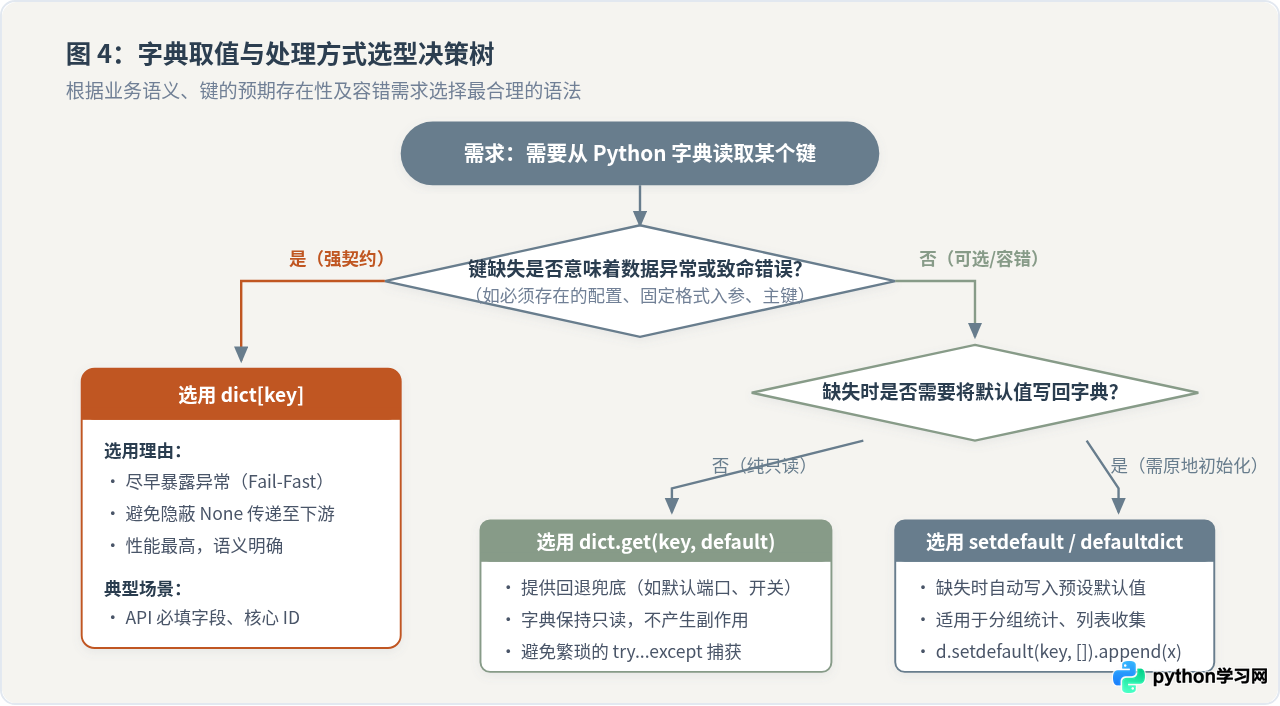
在日常开发中,究竟该选 dict[key] 还是 dict.get(key)?可以通过以下具体条件进行裁定:
1. 必须使用 dict[key] 的情况
- 写入或原地修改操作:
dict[key] = value是字典赋值的唯一合法语法;dict.get(key) = value属于非法语法,解释器会报SyntaxError。 - 严格数据契约校验(Fail-Fast):当某个字段是业务必须具备的核心信息(例如请求头中的
Authorization、数据表记录中的id)。若该字段缺失,说明数据源已受损,应尽早抛出KeyError中断流程,避免错误扩散。 - 在确定存在或已做前置检查的块内:例如已经遍历
for key, val in d.items()或经过结构体校验后,直接使用d[key]清晰且高效。
2. 推荐使用 dict.get(key) 的情况
- 解析非必填的可选配置:例如读取系统配置项时,允许用户不填,未填写时优雅回退到系统内置默认值:
timeout = config.get("timeout", 60)。 - 聚合统计与频次计数:在统计元素出现次数时:
counts[item] = counts.get(item, 0) + 1。这比显式判断if item not in counts: counts[item] = 0更加紧凑整洁。 - 处理不可控的外部第三方响应:调用外部多变 API 时,对于次要展示字段,使用
d.get("desc", "")能够有效避免因对端接口结构微调而导致整个服务崩溃。
五、常见反模式与延伸扩展
1. 常见反模式:检查后再索引(Look Before You Leap 的双重开销)
在初学者代码中,常常能见到如下写法:
# 不推荐写法:产生两次哈希查找
if "status" in data:
    val = data["status"]
else:
    val = "unknown"

# 推荐写法 A:如果只需要取值和默认值,一行搞定且仅一次查找
val = data.get("status", "unknown")

# 推荐写法 B:如果分支内部还要执行复杂逻辑,采用 Pythonic 的 EAFP 风格
try:
    val = data["status"]
    # ... 处理核心业务
except KeyError:
    val = "unknown"
    # ... 处理异常分支
“先 in 检查再 [] 索引”导致虚拟机必须对键进行两次哈希计算与槽位检索。直接使用 get(key, default) 内部只进行一次哈希定位,既简洁又高效。
2. 关联扩展:dict.setdefault 与 collections.defaultdict
在处理缺失键时,除了只读获取默认值外,有时还需要在键缺失时将默认值写入字典本身以供后续使用:
dict.setdefault(key, default):如果键在字典中,返回其值;如果不存在,则先插入key: default,再返回该default。常用于列表嵌套:d.setdefault("tags", []).append("python")。collections.defaultdict:面向整个字典预设工厂函数,任何未初始化的键在访问时都会自动按规则生成默认值。
六、全维度对比速查表
| 对比维度 | dict[key] |
dict.get(key, default) |
|---|---|---|
| 语法类别 | 下标索引(Mapping 协议操作) | 字典内置实例方法 |
| 键存在时的返回值 | 返回对应绑定的值 | 返回对应绑定的值 |
| 键不存在时的表现 | 抛出 KeyError 异常并中断当前栈 |
返回 default(默认为 None),不抛异常 |
| 默认值支持 | 不支持原生默认值(需外层 try/except) | 原生支持第二个参数作为备用默认值 |
| 赋值支持 | 支持:d[k] = v 可用于创建或更新 |
不支持:方法调用结果不能作为赋值左值 |
| 底层核心指令 | BINARY_SUBSCR(原生单指令直通) |
LOAD_METHOD + CALL_METHOD(方法调用链路) |
| 微观执行耗时 | 极快(无方法分发开销) | 稍慢(多一层函数参数装配与调用) |
| 核心设计哲学 | 强契约、快速失败(Fail-Fast) | 防御式编程、容错与安全回退 |
| 典型适用场景 | 必填核心字段、赋值写入、算法内循环 | 可选配置解析、频次计数、不可控外部数据接入 |
总结而言,dict[key] 与 dict.get(key) 并非简单的优劣之分,而是服务于不同的工程语义。当缺少某个键代表着“程序或数据存在错误”时,选择 dict[key] 能够守住系统的数据底线;当缺少某个键代表着“合理的预设与缺省”时,选择 dict.get(key) 能够让业务流程更为优雅和顺畅。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









