

Python map、filter等高阶内置函数使用详解
详细讲解Python中map、filter、reduce、sorted等高阶内置函数的用法、参数含义、返回值特性及实际应用场景,配合完整代码示例帮助理解。
Python 提供了一组接受函数作为参数的内置函数——map()、filter()、reduce()、sorted()、min()/max() 等,它们能用简洁的写法完成对序列的批量变换、筛选和聚合。本文逐一讲解这些高阶函数的参数含义、返回值特性和典型用法,并说明它们与列表推导式的关系,帮助你在合适的场景中做出选择。
什么是高阶函数
在 Python 中,函数是"一等公民",可以赋值给变量、作为参数传递、作为返回值。当一个函数接受另一个函数作为参数,或者返回一个函数时,就称它为高阶函数(higher-order function)。
def apply(func, value):
    return func(value)

result = apply(abs, -7)   # 把 abs 函数作为参数传入
print(result)              # 7
Python 内置的 map、filter、sorted 等都是高阶函数的典型代表——它们接受一个"处理逻辑"(函数)和一个"数据源"(可迭代对象),让你用一行代码表达"对每个元素做某事"的意图。
map():对每个元素做变换
基本语法
map(function, iterable, ...)map() 把 function 依次作用于 iterable 的每个元素,返回一个惰性迭代器(map 对象),不会立即计算全部结果。要获取列表,需要用 list() 包裹。
nums = [1, 2, 3, 4, 5]
squares = list(map(lambda x: x ** 2, nums))
print(squares)
# 示例输出: [1, 4, 9, 16, 25]
传入多个可迭代对象
当传入多个可迭代对象时,function 需要接受对应数量的参数,map 会并行取出各可迭代对象的元素,直到最短的耗尽。
a = [1, 2, 3]
b = [10, 20, 30]
sums = list(map(lambda x, y: x + y, a, b))
print(sums)
# 示例输出: [11, 22, 33]
与列表推导式对比
上面的平方运算等价于列表推导式 [x**2 for x in nums]。两者在性能上差别不大,选择标准通常是:如果变换逻辑已经有一个现成的函数(如 str、int、abs),map 写起来更简短;如果逻辑需要临时写 lambda 或包含条件判断,列表推导式更清晰。
# 把字符串列表转为整数——map 更简洁
data = ['10', '20', '30']
print(list(map(int, data)))        # [10, 20, 30]

# 需要条件过滤时——列表推导式更直观
print([int(s) for s in data if s.isdigit()])  # [10, 20, 30]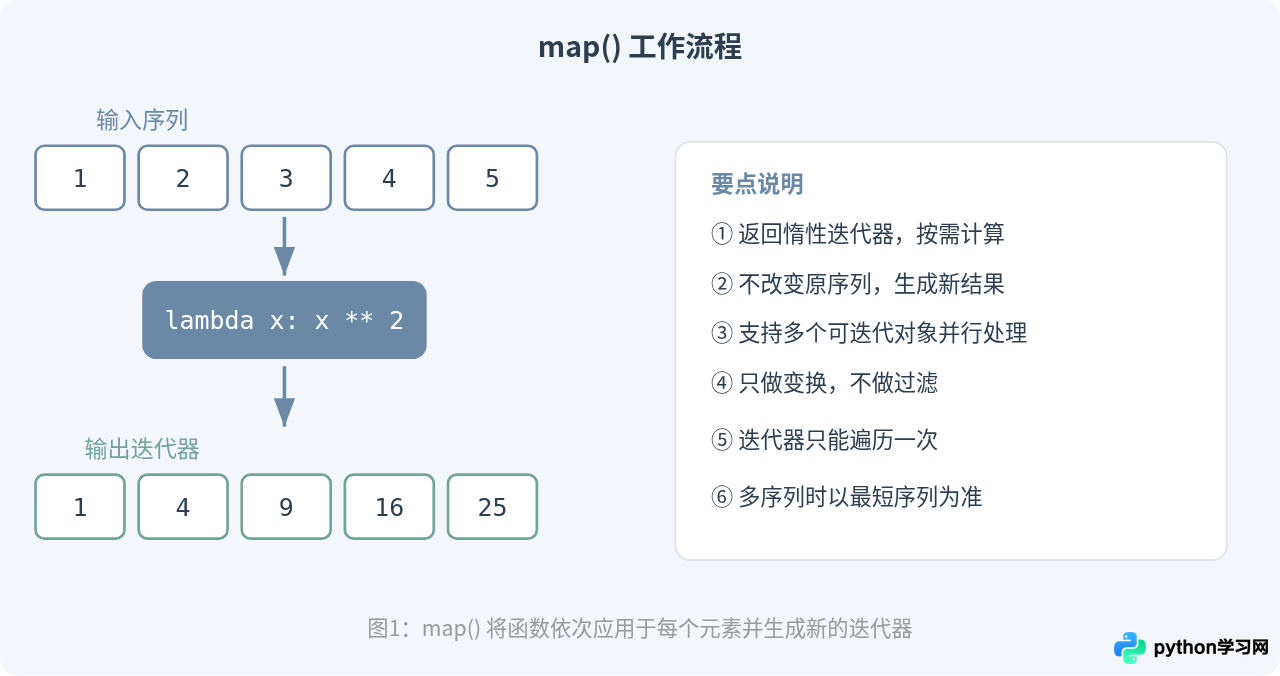
图1:map() 将函数依次应用于每个元素并生成新的迭代器
filter():筛选符合条件的元素
基本语法
filter(function, iterable)filter() 把 function 依次作用于 iterable 的每个元素,保留使函数返回 True(或真值)的元素,同样返回一个惰性迭代器。
nums = [1, -3, 5, -7, 8, 0, 2]
positives = list(filter(lambda x: x > 0, nums))
print(positives)
# 示例输出: [1, 5, 8, 2]
function 为 None 的特殊用法
当 function 传入 None 时,filter 会移除所有布尔值为 False 的元素(包括 0、''、None、[] 等)。
mixed = [0, 1, '', 'hello', None, True, [], [1, 2]]
print(list(filter(None, mixed)))
# 示例输出: [1, 'hello', True, [1, 2]]
filter 与列表推导式
list(filter(lambda x: x > 0, nums)) 等价于 [x for x in nums if x > 0]。如果同时要变换和过滤,列表推导式能在一个表达式中完成,而 filter + map 需要嵌套调用,可读性会下降。
# 同时过滤和变换:列表推导式更直观
result = [x ** 2 for x in nums if x > 0]

# 等价的 map + filter 写法
result = list(map(lambda x: x ** 2, filter(lambda x: x > 0, nums)))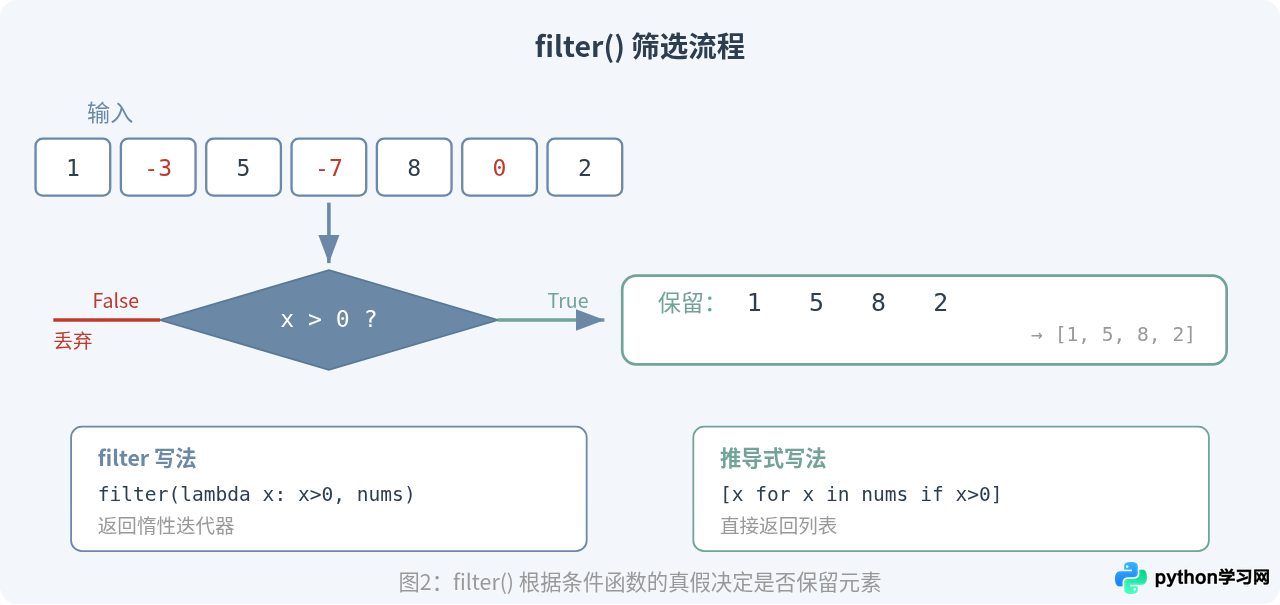
图2:filter() 根据条件函数的真假决定是否保留元素
reduce():累积运算
reduce() 在 Python 3 中移到了 functools 模块,使用前需要导入。它对可迭代对象中的元素进行两两累积运算,最终得到一个单一的值。
from functools import reduce

nums = [1, 2, 3, 4, 5]
total = reduce(lambda acc, x: acc + x, nums)
print(total)
# 示例输出: 15
# 运算过程: ((((1+2)+3)+4)+5)
带初始值的 reduce
reduce 接受第三个可选参数 initial,作为累积的初始值。在处理可能为空的序列时,建议始终传入初始值,否则空序列会抛出 TypeError。
from functools import reduce

# 计算列表中所有数的乘积,初始值为 1
product = reduce(lambda acc, x: acc * x, [2, 3, 4], 1)
print(product)
# 示例输出: 24

# 空列表 + 初始值 → 返回初始值
result = reduce(lambda acc, x: acc + x, [], 0)
print(result) # 0sum()、math.prod() 等更直观的内置函数。reduce 更适合没有对应内置函数的自定义累积逻辑,比如连接嵌套字典的键路径、手动实现扁平化等。
sorted():自定义排序
基本用法
sorted(iterable, *, key=None, reverse=False)sorted() 返回一个新列表(不修改原序列)。key 参数接受一个函数,用于从每个元素中提取比较依据。
words = ['banana', 'apple', 'Cherry', 'date']

# 按字母长度排序
print(sorted(words, key=len))
# 示例输出: ['date', 'apple', 'banana', 'Cherry']

# 不区分大小写排序
print(sorted(words, key=str.lower))
# 示例输出: ['apple', 'banana', 'Cherry', 'date']
对复杂对象排序
当列表元素是字典或元组时,key 参数的价值更明显。
students = [
    {'name': '张三', 'score': 88},
    {'name': '李四', 'score': 95},
    {'name': '王五', 'score': 72},
]

# 按分数从高到低排列
ranked = sorted(students, key=lambda s: s['score'], reverse=True)
for s in ranked:
    print(f"{s['name']}: {s['score']}")
# 示例输出:
# 李四: 95
# 张三: 88
# 王五: 72
如果排序条件有多级(先按分数降序,同分按姓名升序),可以返回元组:
ranked = sorted(students, key=lambda s: (-s['score'], s['name']))sorted() 返回新列表,原序列不变;list.sort() 是就地排序,返回 None,只能用于列表。两者都接受 key 和 reverse 参数。
min() 和 max():带 key 的极值查找
min() 和 max() 也支持 key 参数,这让它们能从复杂数据中直接找出极值元素,而不需要先排序。
students = [
    {'name': '张三', 'score': 88},
    {'name': '李四', 'score': 95},
    {'name': '王五', 'score': 72},
]

top = max(students, key=lambda s: s['score'])
print(f"最高分: {top['name']}, {top['score']}分")
# 示例输出: 最高分: 李四, 95分

bottom = min(students, key=lambda s: s['score'])
print(f"最低分: {bottom['name']}, {bottom['score']}分")
# 示例输出: 最低分: 王五, 72分min/max 在 Python 3.4+ 还支持 default 参数,用于处理空序列:
result = max([], key=lambda x: x, default='无数据')
print(result)   # '无数据'
zip() 与 enumerate():常用搭档
虽然 zip 和 enumerate 不直接接受函数参数,但它们经常与高阶函数配合使用,值得一并了解。
zip:并行遍历多个序列
names = ['张三', '李四', '王五']
scores = [88, 95, 72]

# 配合 dict 构造函数
score_dict = dict(zip(names, scores))
print(score_dict)
# 示例输出: {'张三': 88, '李四': 95, '王五': 72}

# 配合 sorted + key
pairs = list(zip(names, scores))
print(sorted(pairs, key=lambda p: p[1], reverse=True))
# 示例输出: [('李四', 95), ('张三', 88), ('王五', 72)]
enumerate:带索引遍历
items = ['苹果', '香蕉', '橙子']
for i, item in enumerate(items, start=1):
    print(f"{i}. {item}")
# 示例输出:
# 1. 苹果
# 2. 香蕉
# 3. 橙子
lambda 表达式:高阶函数的常见搭档
前面的例子大量使用了 lambda。它是一种匿名函数的简写方式,语法为 lambda 参数: 表达式,只能写一个表达式,自动返回结果。
# 以下两种写法等价
square = lambda x: x ** 2

def square(x):
    return x ** 2
使用 lambda 的原则:如果逻辑简单到一行就能表达,用 lambda 让代码更紧凑;如果逻辑复杂或需要复用,应该定义命名函数。将过于复杂的逻辑塞进 lambda 会严重降低可读性。
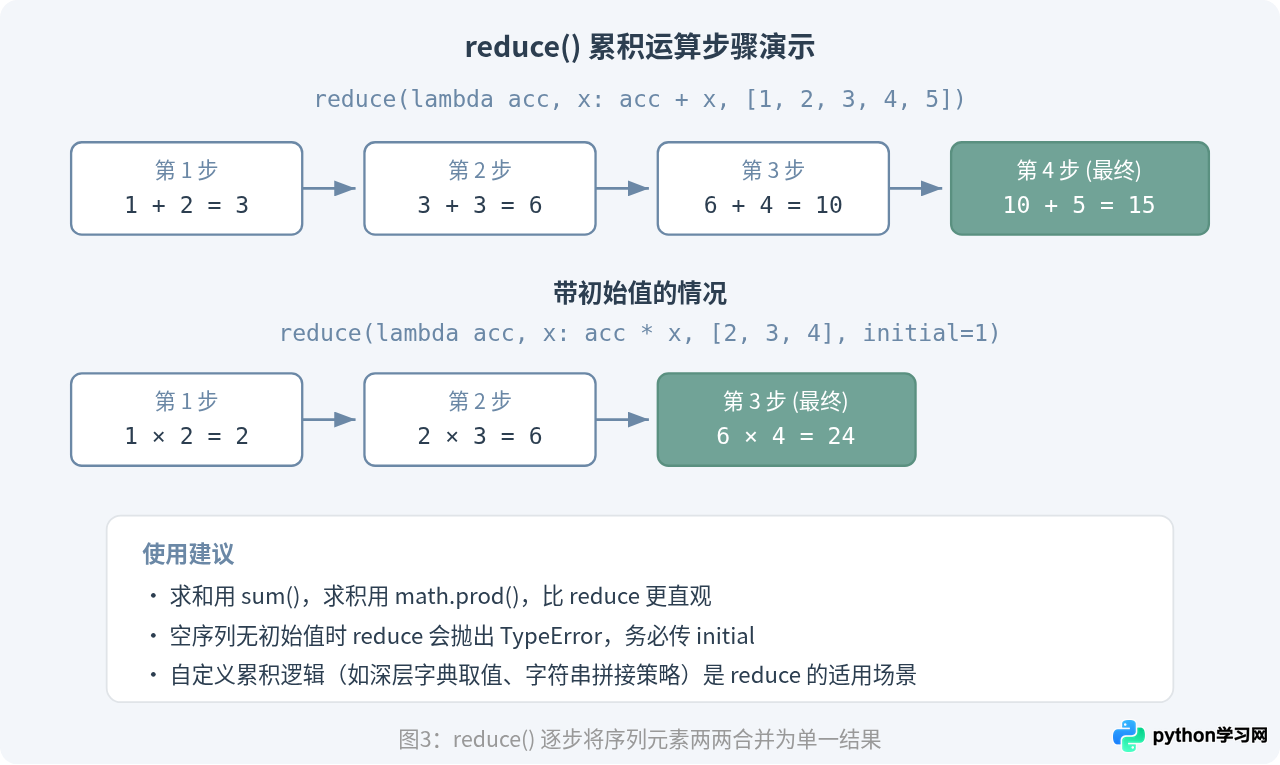
图3:reduce() 逐步将序列元素两两合并为单一结果
实际场景:组合使用高阶函数
在实际开发中,高阶函数经常组合使用。下面看几个典型场景。
场景一:清洗和转换数据
从文件读取的一列字符串,需要去除空白、过滤空行、转为整数:
raw_lines = ['  42\n', '', ' 17 ', '\n', '  99  ', '']

# 链式处理
cleaned = list(map(int, filter(None, map(str.strip, raw_lines))))
print(cleaned)
# 示例输出: [42, 17, 99]

# 等价的推导式写法(可读性更好)
cleaned = [int(line.strip()) for line in raw_lines if line.strip()]
场景二:批量处理文件路径
import os

files = ['report.pdf', 'data.csv', 'notes.txt', 'image.png', 'log.csv']

# 筛选 CSV 文件并构建完整路径
csv_paths = list(map(
    lambda f: os.path.join('/data/exports', f),
    filter(lambda f: f.endswith('.csv'), files)
))
print(csv_paths)
# 示例输出: ['/data/exports/data.csv', '/data/exports/log.csv']
场景三:统计词频 Top N
from collections import Counter

text = "python is great and python is fun and python is powerful"
words = text.split()
counter = Counter(words)

# 按频率降序取前 3 个
top3 = sorted(counter.items(), key=lambda item: item[1], reverse=True)[:3]
print(top3)
# 示例输出: [('python', 3), ('is', 3), ('and', 2)]
惰性求值:理解迭代器的行为
map() 和 filter() 返回的都是惰性迭代器,这意味着元素只在被请求时才计算。这在处理大数据集时有明显的内存优势,但也有几个需要注意的行为。
迭代器只能遍历一次。消耗完毕后再次遍历得到空结果:
result = map(lambda x: x * 2, [1, 2, 3])
print(list(result))   # [2, 4, 6]
print(list(result))   # [] — 已经耗尽
不支持下标和 len()。如果需要随机访问或获取长度,必须先转为列表。
调试时看不到内容。直接打印迭代器只会显示对象地址,需要 list() 才能查看内容。这也是很多初学者困惑的原因——明明调用了 map,打印出来却不是期望的列表。
高阶函数速查表
| 函数 | 作用 | 返回值 | 典型用法 |
|---|---|---|---|
map(f, iter) | 对每个元素应用 f | 惰性迭代器 | 批量类型转换、格式化 |
filter(f, iter) | 保留 f 返回 True 的元素 | 惰性迭代器 | 数据清洗、条件筛选 |
reduce(f, iter) | 两两累积为单一值 | 单个值 | 自定义聚合逻辑 |
sorted(iter, key=f) | 按 f 的返回值排序 | 新列表 | 多条件排序、复杂对象排序 |
min/max(iter, key=f) | 按 f 的返回值取极值 | 单个元素 | 从字典列表中找最值 |
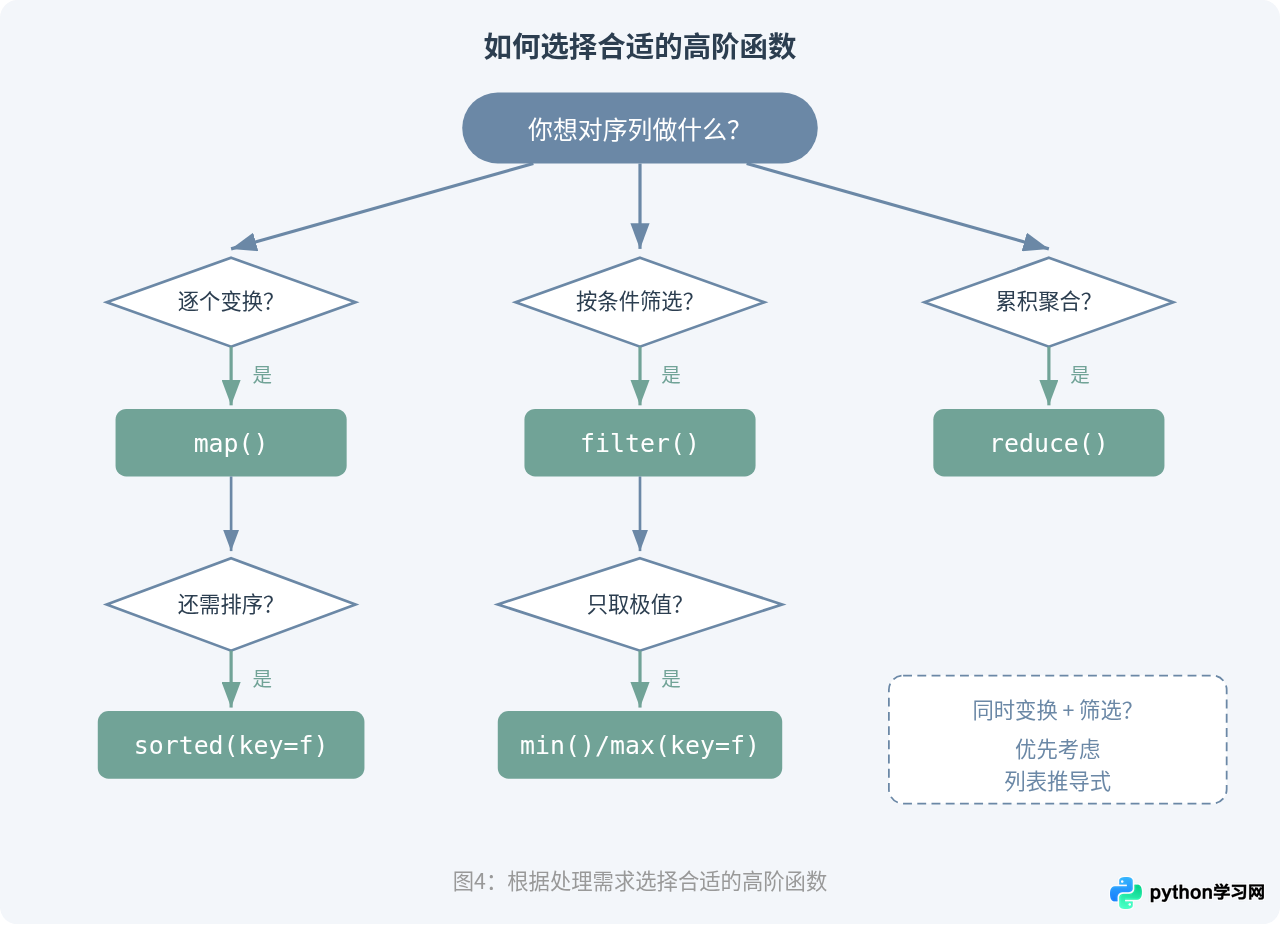
图4:根据处理需求选择合适的高阶函数
常见问题
map 返回的不是列表?
Python 3 中 map() 和 filter() 返回的是迭代器,不是列表。如果需要列表,用 list() 包裹;如果只需要遍历一次(比如在 for 循环中使用),直接用迭代器更节省内存。
reduce 报 NameError?
Python 3 中 reduce 不再是内置函数,需要 from functools import reduce 导入后才能使用。
什么时候不该用高阶函数?
当 lambda 表达式变得又长又难读时,与其勉强写成一行 map/filter,不如用普通 for 循环或列表推导式。代码首先是写给人看的,简洁不等于把所有逻辑压缩到一行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









