

Python 绘制雷达图前怎么进行数据归一化
详细讲解在 Python 中绘制雷达图前的数据归一化方法,涵盖量纲不一致导致的几何畸变原理、Min-Max 线性缩放、逆向指标极性转换、全局极值基准确定与 Matplotlib 极坐标完整闭合绘制代码实践。
一、为什么绘制雷达图前必须进行数据归一化?
雷达图(Radar Chart,又称蜘蛛网图)是一种通过从中心向外辐射的多个径向轴来展示多变量数据的二维图形。在标准的极坐标系统中,所有径向轴共用相同的几何半径长度。这种绘图机制在面对真实业务数据时会产生三个核心矛盾:
- 绝对数量级差异导致的几何遮蔽:以服务器性能评估为例,系统日访问量可能在 100,000 次以上,CPU 使用率在 0% 到 100% 之间,而平均响应耗时在 0.05 秒左右。若共用一个极坐标尺度,100,000 的大数值会撑大整个坐标网格,使以个位数或小数呈现的维度完全缩成靠近圆心的一个点,彻底丧失图形辨识度。
- 度量单位(量纲)不可通约:评分(星级)、比率(百分比)、金额(元)和计数(次)没有物理上的可比性。雷达图的价值在于通过闭合多边形的面积与凹凸形态传达“综合能力画像”,因此必须先消除单位,将所有维度统一转换为无量纲的相对得分。
- 指标优劣方向(极性)冲突:多数业务指标为正向指标(数值越大代表表现越好,如吞吐量、准确率、营业额),但同样存在大量逆向指标(数值越小越好,如接口延迟、缺陷密度、宕机时长)。若直接绘制,高延迟会向外扩张,给阅读者造成“系统表现出众”的严重误判。
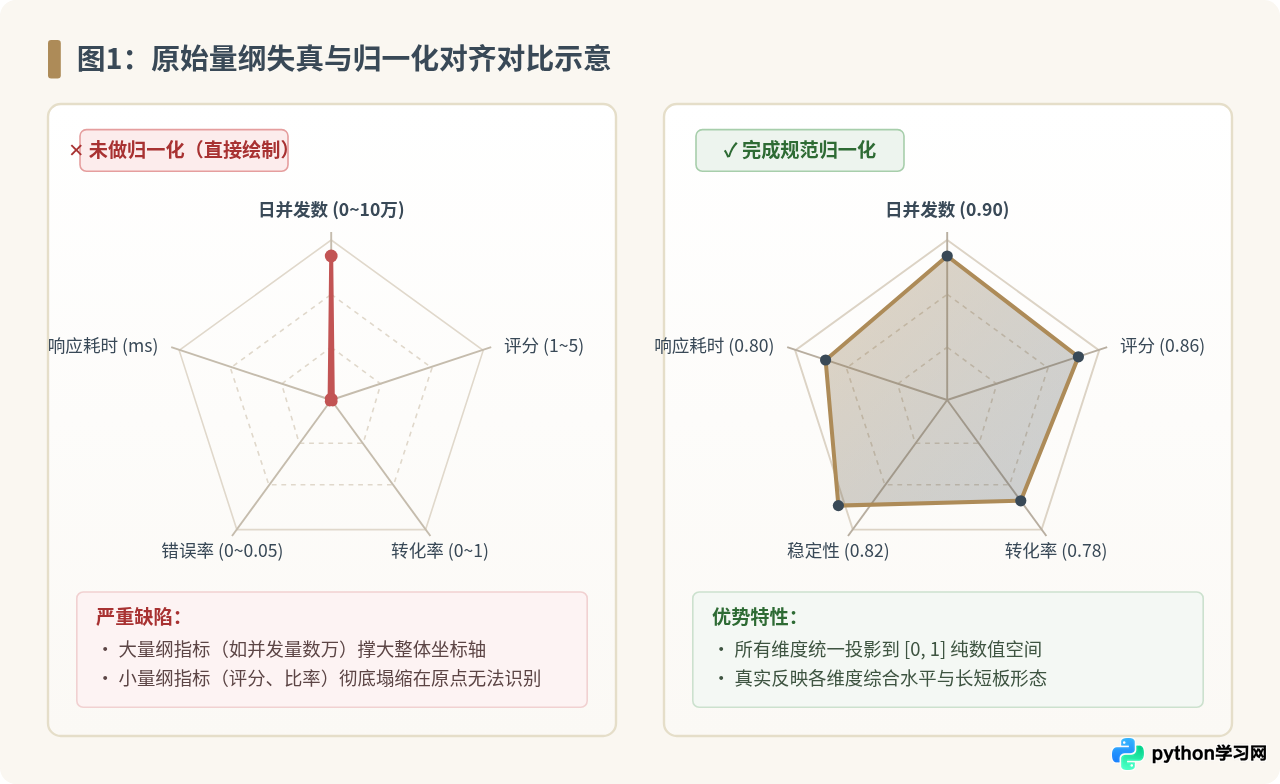
如上图所示,未经归一化的雷达图多边形被极个别庞大数值的轴线完全拉扯成针状,其余维度的信息量完全丢失;而完成规范归一化后,所有轴线均使用统一的无量纲相对刻度,清晰呈现出各个维度的相对优劣与短板所在。
二、核心数学方法:正向、逆向与业务边界归一化
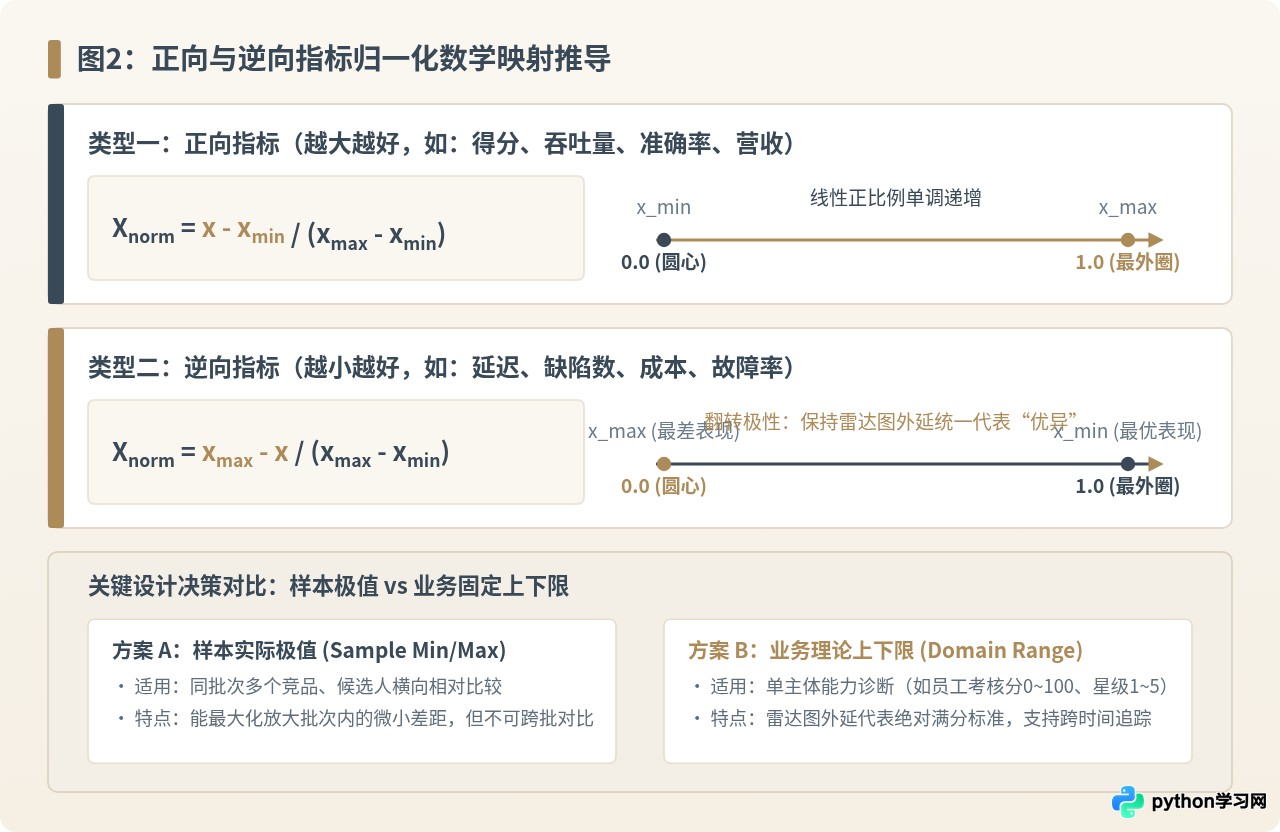
雷达图数据归一化的核心目标是将任意实数区间的输入数据映射到固定的区间(通常为 [0.0, 1.0] 或带有视觉缓冲的 [0.05, 1.0])。针对不同类型的指标,其数学转换公式有所不同。
1. 正向指标:标准 Min-Max 线性缩放
正向指标是指“数值越大越优”的属性。对于指标 x,给定其允许或统计得到的最小值 x_min 与最大值 x_max,其归一化计算公式为:
当实际值达到指标下限时,归一化结果为 0.0(对应雷达图中心);当实际值达到指标上限时,归一化结果为 1.0(对应雷达图最外沿网格)。
2. 逆向指标:极性反转归一化
逆向指标是指“数值越小越优”的属性。为了保证雷达图外延始终代表“更佳性能”,需要对计算结果进行方向翻转:
在该公式下,当实际值达到最优的 x_min 时,输出为满分 1.0;而当实际值恶化到最大容忍值 x_max 时,输出为 0.0。
3. 极值基准确定:样本极值 vs 业务固定上下限
在计算上述公式中的 x_min 与 x_max 时,有两种确定基准的方式,需要根据分析场景严格区分:
| 基准确定方式 | 极值取值来源 | 适用场景 | 优势与局限 |
|---|---|---|---|
| 业务理论边界 (Domain Range) | 由业务规则、行业标准或考核指标设定的绝对常数(如星级 1~5,百分比 0~100) | 单主体能力评估、系统健康度巡检、跨周期历史对比 | 推荐首选。图形具有绝对刻度意义,不同批次生成的图可直接并置对比。 |
| 全局样本极值 (Sample Min/Max) | 从当前待分析的多主体数据集(整列数据)中提取的 df[col].min() 与 df[col].max() |
同批次多个竞品比对、候选人横向相对实力排行 | 能充分拉开批次内微小差异,但若增加新样本导致极值变化,所有图的多边形都会重绘。 |
在机器学习中常用的 Z-score 标准化公式为 Z = (x - μ) / σ。该方法将数据转换为均值为 0、标准差为 1 的分布。但这并不适合雷达图,原因在于:
- Z-score 会产生大量负数,而标准极坐标的径向距离 r 代表物理长度,若存在负值,极坐标会将负数沿反方向延伸穿过圆心,导致图形拓扑结构混乱。
- Z-score 理论上无上下界限制,无法固定统一的最外圈网格刻度。若必须使用 Z-score,仍需额外通过 Sigmoid 函数或 Min-Max 二次压缩到正数区间。
三、Python 实操四步法:从原始数据到归一化矩阵
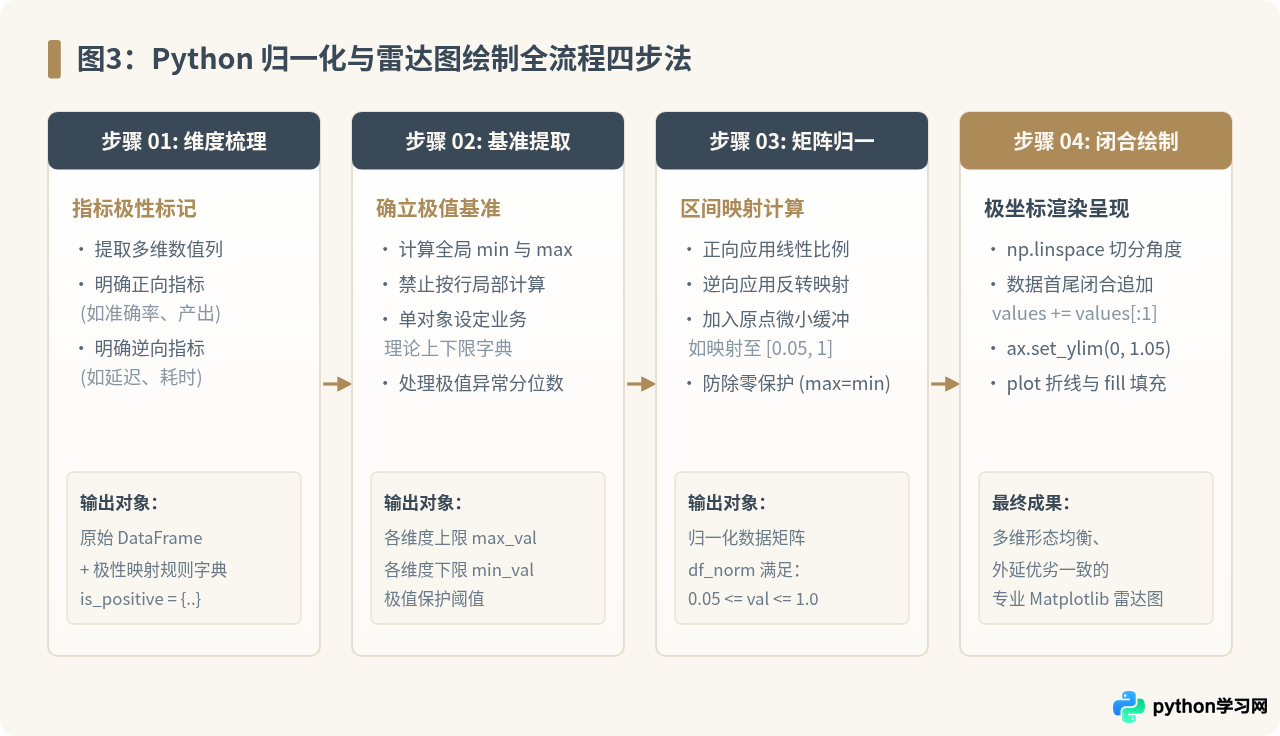
为了使归一化流程稳健可复用,在 Python 代码组织上建议分为 4 个清晰的阶段:维度梳理与极性定义、基准上下限提取、线性区间映射与极值缓冲,以及绘图闭环数据构建。
完整 Python 归一化处理脚本示例
以下提供基于 pandas 和 numpy 的完整示例代码,展示如何处理包含不同量纲、正向指标与逆向指标的混合数据集。
import numpy as np
import pandas as pd

# 1. 准备多指标原始数据集(量纲悬殊、包含正向与逆向维度)
raw_data = {
    '对象名称': ['产品 A', '产品 B', '产品 C'],
    '日并发数(次)': [85000, 120000, 45000],      # 正向指标,量纲数万
    '用户评分(分)': [4.6, 3.8, 4.9],            # 正向指标,量纲 1~5
    '转化率(%)': [12.5, 18.2, 8.4],             # 正向指标,量纲百分比
    '接口延迟(ms)': [45, 120, 28],              # 逆向指标(越小越优),量纲数十
    '异常率(%)': [0.12, 0.85, 0.05]             # 逆向指标(越小越优),量纲零点几
}

df_raw = pd.DataFrame(raw_data)

# 2. 定义各指标的分析维度配置:极性方向(True为正向,False为逆向)与业务固定边界
feature_config = {
    '日并发数(次)': {'is_positive': True,  'bounds': (0, 150000)},
    '用户评分(分)': {'is_positive': True,  'bounds': (1.0, 5.0)},
    '转化率(%)':   {'is_positive': True,  'bounds': (0.0, 25.0)},
    '接口延迟(ms)': {'is_positive': False, 'bounds': (10, 150)},
    '异常率(%)':   {'is_positive': False, 'bounds': (0.0, 1.0)}
}

def normalize_radar_data(df, config, buffer_min=0.05, buffer_max=1.0):
    """
    对雷达图输入数据进行指标归一化

    参数:
        df: 原始 DataFrame
        config: 特征配置字典,包含 is_positive 和可选的 bounds (min, max)
        buffer_min: 映射下限,默认保留 0.05 缓冲避免数据塌陷至极坐标圆心
        buffer_max: 映射上限,默认 1.0

    返回:
        归一化后的 DataFrame,取值严格落在 [buffer_min, buffer_max]
    """
    df_norm = pd.DataFrame(index=df.index)

    for col, cfg in config.items():
        is_pos = cfg.get('is_positive', True)
        bounds = cfg.get('bounds', None)

        # 确定基准上下限
        if bounds is not None:
            col_min, col_max = bounds
        else:
            col_min = df[col].min()
            col_max = df[col].max()

        # 防除零保护:若最大值与最小值相同,直接设为居中中位数
        if np.isclose(col_max, col_min):
            df_norm[col] = (buffer_min + buffer_max) / 2.0
            continue

        # 裁剪超出理论边界的极端离群值
        series_clipped = df[col].clip(lower=col_min, upper=col_max)

        # Min-Max 映射至 [0, 1]
        if is_pos:
            scaled = (series_clipped - col_min) / (col_max - col_min)
        else:
            scaled = (col_max - series_clipped) / (col_max - col_min)

        # 重整化映射至 [buffer_min, buffer_max],提供视觉缓冲
        df_norm[col] = buffer_min + scaled * (buffer_max - buffer_min)

    return df_norm

# 执行归一化运算
df_normalized = normalize_radar_data(df_raw, feature_config)
print("归一化后的数据矩阵(已对齐至 [0.05, 1.0]):")
print(df_normalized.round(3))
代码执行后的标准化矩阵示例输出:
| 样本对象 | 日并发数(次) | 用户评分(分) | 转化率(%) | 接口延迟(ms) | 异常率(%) |
|---|---|---|---|---|---|
| 产品 A | 0.588 | 0.905 | 0.525 | 0.762 | 0.886 |
| 产品 B | 0.810 | 0.715 | 0.741 | 0.254 | 0.193 |
| 产品 C | 0.335 | 0.976 | 0.369 | 0.878 | 0.952 |
由表可见,逆向指标(接口延迟与异常率)经过转换后,延迟仅 28ms、异常率仅 0.05% 的“产品 C”获得了 0.878 和 0.952 的高得分,成功将“表现好”统一映射至接近 1.0 的外圈刻度。
四、结合 Matplotlib 完整绘制雷达图
得到归一化矩阵后,绘制雷达图的最后一步是通过极坐标系(polar=True)渲染图形。极坐标绘图有两个关键技术细节必须在代码中实现:
- 首尾闭合(Cyclic Closure):雷达图是一个封闭多边形。假设有 N 个维度,计算所得的分割角度有 N 个,如果直接传入 N 个数值,折线图只会绘制到第 N 个轴便终止,导致最后一个轴与第一个轴之间存在开口。必须通过
values += values[:1]将第一个维度的数值追加到末尾,同时在角度列表中也追加首个角度。 - 固定径向刻度上限(Lock Radial Lim):调用
ax.set_ylim(0, 1.05)显式锁定极坐标半径范围。若省略此步,Matplotlib 会自适应当前样本的最大值,重新引发多图刻度不一致的问题。
import matplotlib.pyplot as plt

# 设置中文系统回退字体与负号正常显示
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 准备指标标签与维度数量
categories = list(feature_config.keys())
N = len(categories)

# 计算每个轴所对应的弧度角度,并将首尾闭合
angles = np.linspace(0, 2 * np.pi, N, endpoint=False).tolist()
angles += angles[:1]  # 闭合角度序列

# 初始化画布为极坐标投影
fig, ax = plt.subplots(figsize=(7, 7), subplot_kw=dict(polar=True))

# 顺时针旋转,使第一个指标从正上方(90度/北极方向)开始
ax.set_theta_offset(np.pi / 2)
ax.set_theta_direction(-1)

# 设置极坐标多边形背景网格标签
plt.xticks(angles[:-1], categories, size=11, color='#394957', weight='bold')

# 设置径向轴刻度线与标签(从 0 到 1.0,留出 0.05 外延边距)
ax.set_rlabel_position(0)
plt.yticks([0.2, 0.4, 0.6, 0.8, 1.0], ["0.2", "0.4", "0.6", "0.8", "1.0"], color="#6A7A89", size=9)
plt.ylim(0, 1.08)

# 配色方案定义:深灰蓝、暗金、青灰
palette = ['#394957', '#AD8B58', '#4F7D8A']

# 循环绘制每个产品的数据多边形
for idx, row in df_normalized.iterrows():
    values = row.tolist()
    values += values[:1]  # 闭合数据点

    color = palette[idx % len(palette)]
    obj_name = df_raw.loc[idx, '对象名称']

    # 绘制外边框折线与半透明多边形填充
    ax.plot(angles, values, linewidth=2.2, linestyle='solid', label=obj_name, color=color)
    ax.fill(angles, values, color=color, alpha=0.18)

# 添加图例与标题
plt.title("多系统综合性能雷达图(归一化标准视角)", size=15, color='#394957', weight='bold', y=1.08)
plt.legend(loc='upper right', bbox_to_anchor=(1.25, 1.1), frameon=True, facecolor='#FAF7F1')

plt.tight_layout()
plt.show()
五、关键细节与避坑指南
在实际工程与数据分析场景中,归一化操作往往容易陷入几类隐蔽的逻辑陷阱,导致产出的可视化图表结论失真。
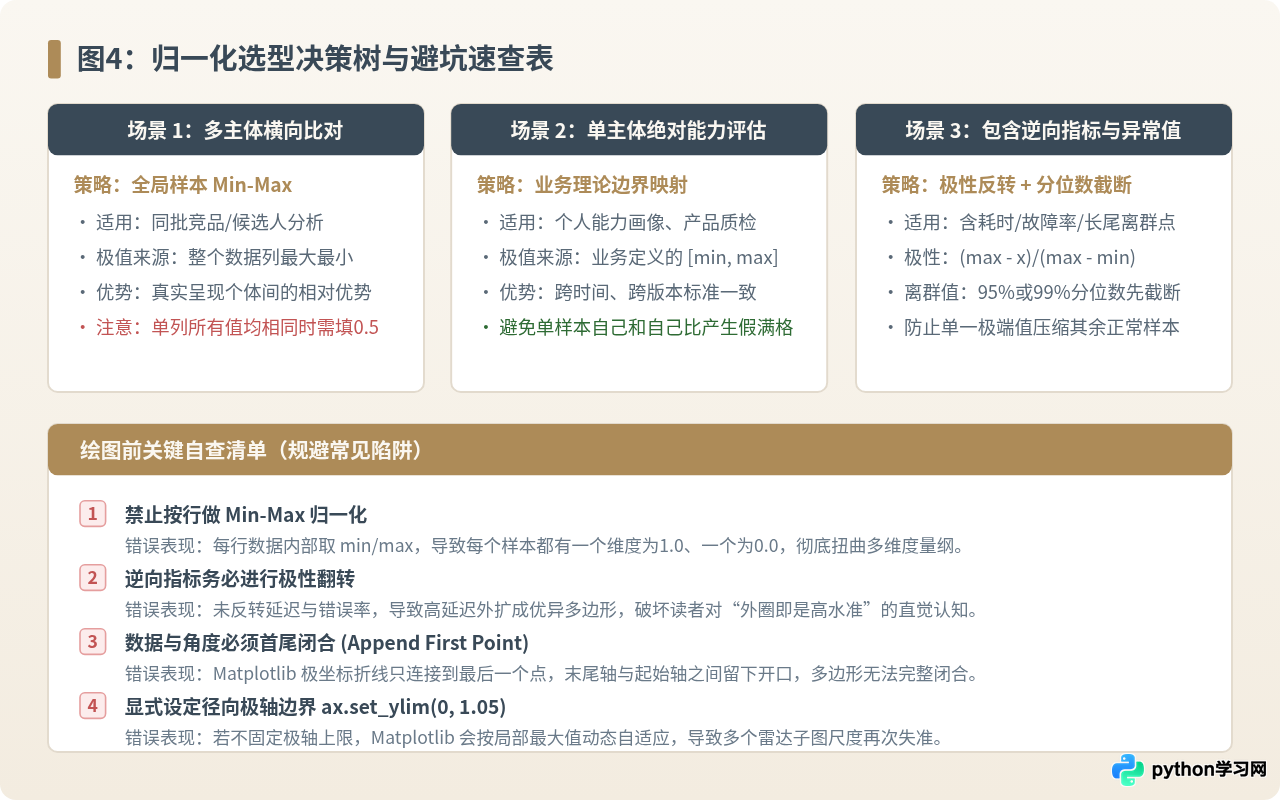
1. 陷阱一:误对单行样本做 Min-Max(行内归一化)
这是最常见且危害最大的错误。部分开发者使用 df.apply(lambda row: (row - row.min()) / (row.max() - row.min()), axis=1)。这意味着将“产品 A”自身的并发量(85000)与自身的延迟(45)进行横向求极值。这种做法在数学上毫无意义,且会强行让每个对象都出现一个满格(1.0)和一个零点(0.0),彻底摧毁跨对象横向对比的价值。归一化必须严格按列(特征维度)纵向进行。
2. 陷阱二:0 值塌陷与原点视觉缓冲
标准的 Min-Max 映射将最小值映射为严格的 0.0。在雷达图中,r = 0 即为极坐标圆心。如果有多个维度恰好达到最小值,这些点全部堆叠重合在圆心位置,会导致多边形内凹成尖锐锐角,掩盖轴线走向。因此,在工业级图表中,通常采用重映射公式 X_buffered = 0.05 + 0.95 * X_norm,使最差表现依然位于围绕圆心的小同心圆外侧,保留清晰的几何轮廓。
3. 陷阱三:极端长尾离群值的空间挤压
若数据集中存在长尾分布(例如某一个异常实例的访问量为平时均值的 100 倍),如果直接使用该极大值作为 x_max,会导致其余所有正常样本的归一化数值被剧烈压缩在 0.01~0.05 的狭窄区间内。应对策略是在归一化前先执行分位数截断(Winsorization):使用 95% 或 99% 分位数作为 x_max,超出部分全部限制在上限值。
六、规范化实施自查清单
在完成 Python 雷达图绘制代码后,建议按照以下检查清单逐项核对:
- 方向对齐自查:检查所有逆向指标(成本、耗时、失效率)是否经过极性转换,确保雷达图最外圈在各维度上统一代表“优异/充足”。
- 基准统一自查:如果绘制多张对比卡片,确认所有子图使用的是同一组全局极值或业务理论上下限。
- 闭合性自查:确认角度数组和数值数组末尾均追加了第一个元素(
len(values) == len(angles) == N + 1)。 - 极轴固定自查:确认已通过
ax.set_ylim()显式指定刻度区间,且刻度标签文字与单位清晰明了。 - 防除零保护:确认数据流中当某维度所有取值完全相同时(x_max == x_min),代码具备默认填充逻辑,不抛出
NaN或ZeroDivisionError。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









