

命令行运行 Python 脚本报错 UnicodeDecodeError 怎么解决
详细讲解在终端或命令行运行 Python 脚本时遇到 UnicodeDecodeError 的根本原因、Traceback 关键特征排查、文件与标准流的编码修复方案,以及跨平台环境配置策略。
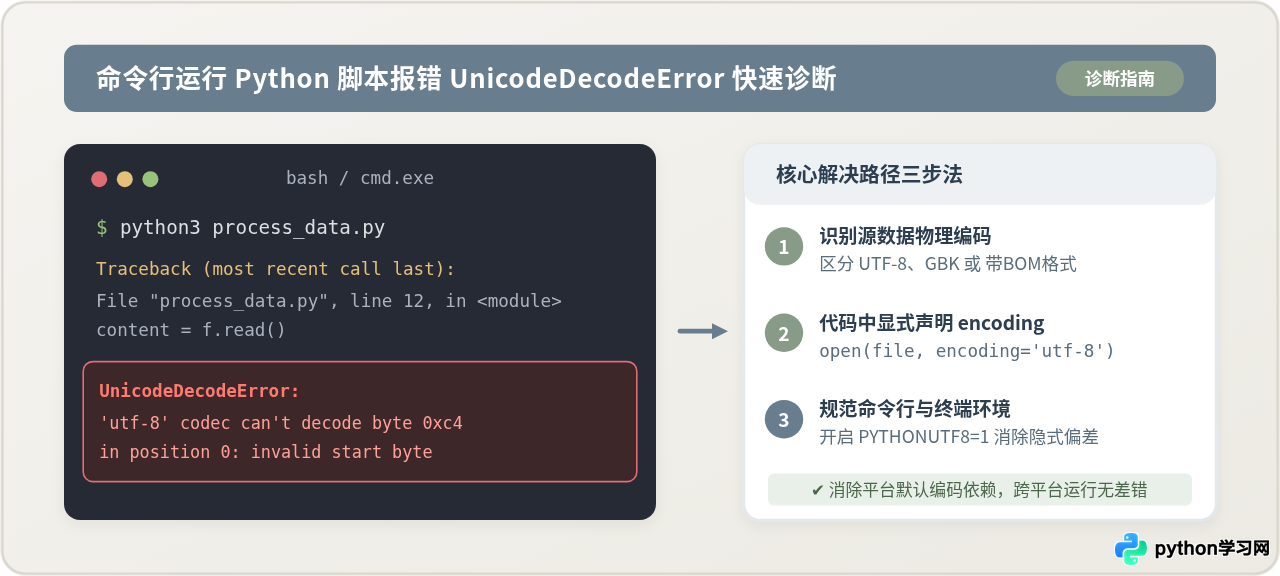
在终端或命令提示符中运行 Python 脚本触发 UnicodeDecodeError,核心原因在于Python 脚本在读取外部二进制字节流(如磁盘文件、标准输入或子进程输出)时所采用的字符编码规则,与数据底层的实际物理编码不相匹配。最根本且标准的解决路径是避免隐式依赖操作系统本地默认编码,在所有数据入口处(如 open() 函数)显式指定正确的 encoding 参数(通常为 utf-8 或源数据对应的编码),并在命令行管道与交互环节合理配置运行环境变量。
一、从 Traceback 提取关键报错信息
当终端抛出异常时,不要跳过报错文本。UnicodeDecodeError 的错误信息结构高度固定,其最后一行直接包含了排查所需的核心三要素:指定的解码器(codec)、发生冲突的字节数值(byte),以及在数据流中的位置偏移量(position)。
常见典型报错示例一:UTF-8 解码器遇到非 UTF-8 字节
Traceback (most recent call last):
  File "process_log.py", line 14, in <module>
    text = f.read()
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc4 in position 0: invalid start byte
此错误表明:代码试图以 UTF-8 规则读取数据,但在第 0 个字节处遇到了 0xc4。在 UTF-8 编码规范中,0xc4 是一个双字节序列的引导字节,但其后跟随的字节不符合 UTF-8 续接规范(通常是因为该文件实际上是 GBK / ANSI 编码保存的中文文本)。
常见典型报错示例二:GBK 解码器遇到 UTF-8 多字节序列
Traceback (most recent call last):
  File "process_log.py", line 14, in <module>
    text = f.read()
UnicodeDecodeError: 'gbk' codec can't decode byte 0xaa in position 18: illegal multibyte sequence
此错误常见于中文 Windows 系统的 CMD 或 PowerShell 命令行中。代码在打开文件时未指明编码,Python 自动采用了 Windows 默认的 gbk(CP936 代码页)去读取一个实际上采用 UTF-8 编码保存的文件,在拼合多字节汉字时遇到了非法字节组合。
二、编码与解码的本质机制
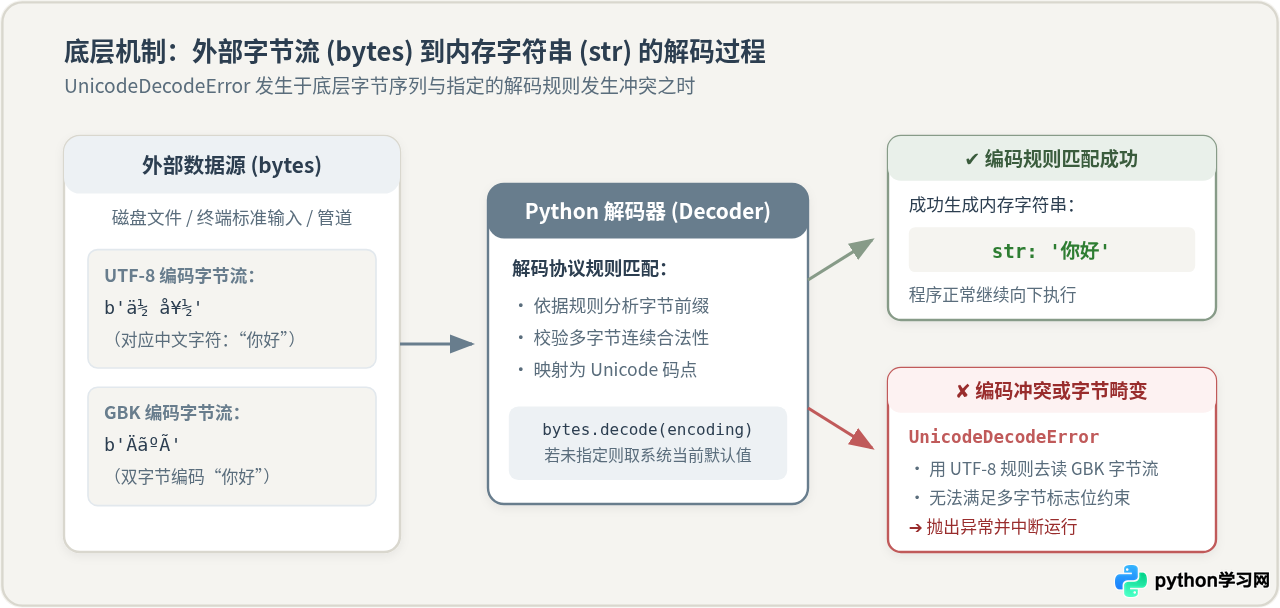
理解该错误需要明确 Python 3 的字符串模型。计算机在硬盘、网络或管道中传输的任何数据都只有二进制形态的字节(bytes)。Python 内存中的文字则是抽象的Unicode 字符对象(str)。
从字节转换为字符的过程称为解码(Decode),从字符转换为字节的过程称为编码(Encode)。解码必须遵循确定的密码本(即编码标准):
- UTF-8 编码:变长编码体系。英文字符占 1 个字节,常用汉字占 3 个字节。每个多字节汉字都有特定的前缀位(如首字节
1110xxxx,后续字节10xxxxxx)。 - GBK / CP936 编码:双字节编码体系。英文占 1 个字节,汉字占固定 2 个字节,且首字节范围通常在
0x81 ~ 0xFE。
当用 GBK 规则去解析 UTF-8 的 3 字节汉字时,前两个字节可能会被误拼成一个生僻字,留下的第三个孤立字节则会破坏后续字符的对齐,最终引发 illegal multibyte sequence;反之,用 UTF-8 规则读取 GBK 字节,只要遇到不合法的首字节或断裂序列,便立即抛出 invalid start byte 或 invalid continuation byte。
三、故障排查与修复的四个具体步骤
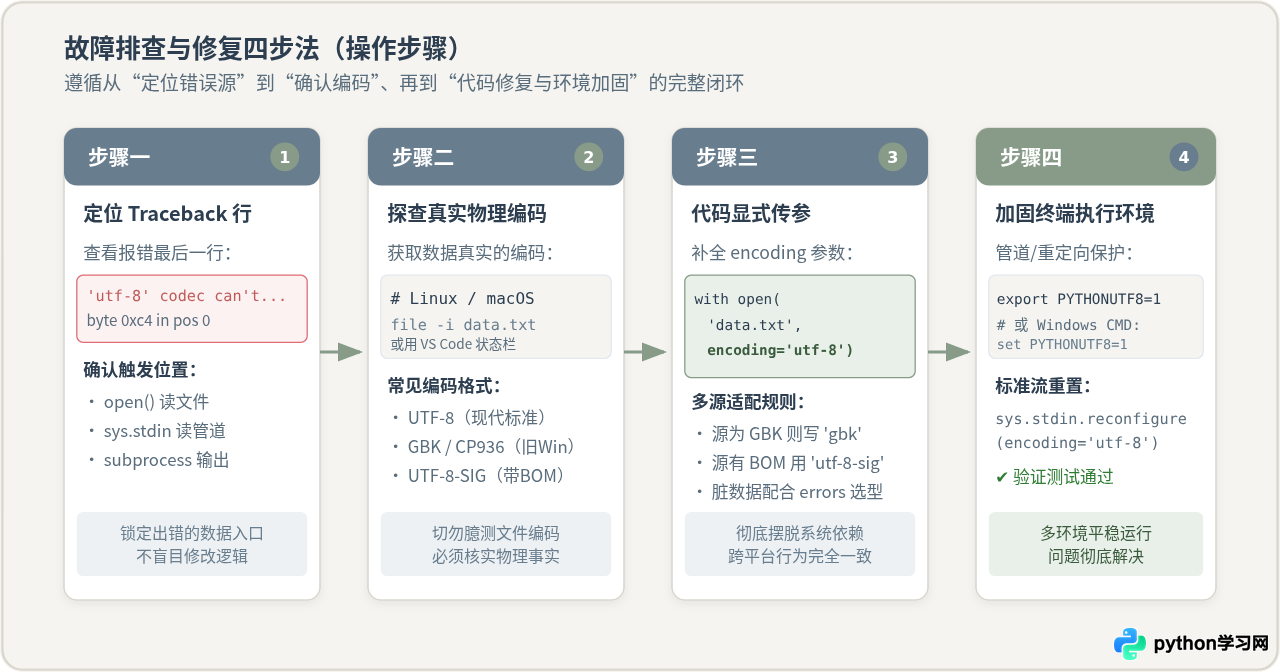
步骤一:定位触发解码的代码行
检查终端输出的 Traceback 调用栈,找到最底部的业务代码文件名及行号。常见的触发点主要分为三类:
- 普通文件读取:调用
open(filename).read()或pathlib.Path.read_text()。 - 标准流与管道输入:通过命令行管道向脚本重定向输入,脚本内执行
sys.stdin.read()。 - 子进程输出捕获:使用
subprocess.check_output(..., text=True)或p.communicate()捕获其他外部工具的执行结果。
步骤二:确认数据源的实际物理编码
切勿在未确认源文件编码的情况下盲目试错。必须通过可靠工具核实源数据的实际编码格式:
- 在 Linux / macOS 终端:使用
file命令查看文件信息:$ file -i data.txt # 示例输出:data.txt: text/plain; charset=utf-8 - 在代码编辑器中查看:使用 VS Code 打开对应文件,窗口右下角状态栏会直接显示当前文件的编码(如
UTF-8或GBK/Windows-1252)。 - 使用 Python 探测(适用于未知大批量文本):
# 借助标准工具或探测库
from pathlib import Path

raw_bytes = Path('data.txt').read_bytes()[:100]
print(f"原始前100字节: {raw_bytes}")
步骤三:在代码中显式补全 encoding 参数
确认为文本文件后,在代码调用中显式传入 encoding 参数,消除任何环境依赖。
情境 A:源文件为标准的 UTF-8 编码(绝大多数现代工程项目)
# 规范写法:显式指定 encoding='utf-8'
with open('data.txt', mode='r', encoding='utf-8') as f:
    content = f.read()
情境 B:源文件为带 BOM 的 UTF-8(Windows 记事本等工具生成)
如果文件开头包含 0xEF, 0xBB, 0xBF 三个字节(Byte Order Mark),直接用 utf-8 读取可能会在文本首字符前引入不可见字符 \ufeff。此时应指定为 utf-8-sig:
with open('data_with_bom.txt', mode='r', encoding='utf-8-sig') as f:
    content = f.read()
情境 C:源文件为国内旧系统导出的 GBK / GB2312 / CP936 文本
with open('legacy_gbk.csv', mode='r', encoding='gbk') as f:
    content = f.read()
情境 D:读取的目标实际是二进制文件(如图片、压缩包、SQLite 数据库等)
若程序本意是处理二进制数据,却使用了默认的文本模式(mode='r'),Python 会强制将其当做字符解码并必然报错。此时应改用二进制模式:
with open('photo.png', mode='rb') as f:
    binary_data = f.read()
步骤四:加固命令行终端与管道执行环境
如果报错发生在 sys.stdin(例如在命令行中使用 cat data.txt | python script.py 或 python script.py < data.txt),或者脚本输出重定向时,可以通过配置终端运行环境解决。
方法 1:开启 Python UTF-8 Mode(推荐,Python 3.7+ 原生支持)
在执行命令前或运行时设置环境变量 PYTHONUTF8=1。这会强制让 Python 在忽略操作系统区域设置的情况下,统一将标准流与文件默认编码设定为 UTF-8:
# Linux / macOS 命令行运行:
export PYTHONUTF8=1
python3 script.py

# Windows CMD 命令行运行:
set PYTHONUTF8=1
python script.py

# Windows PowerShell 命令行运行:
$env:PYTHONUTF8=1
python script.py
方法 2:在 Python 代码内部动态重置标准流
import sys

# 针对 Python 3.7+ 重新配置标准输入流编码
sys.stdin.reconfigure(encoding='utf-8')
sys.stdout.reconfigure(encoding='utf-8')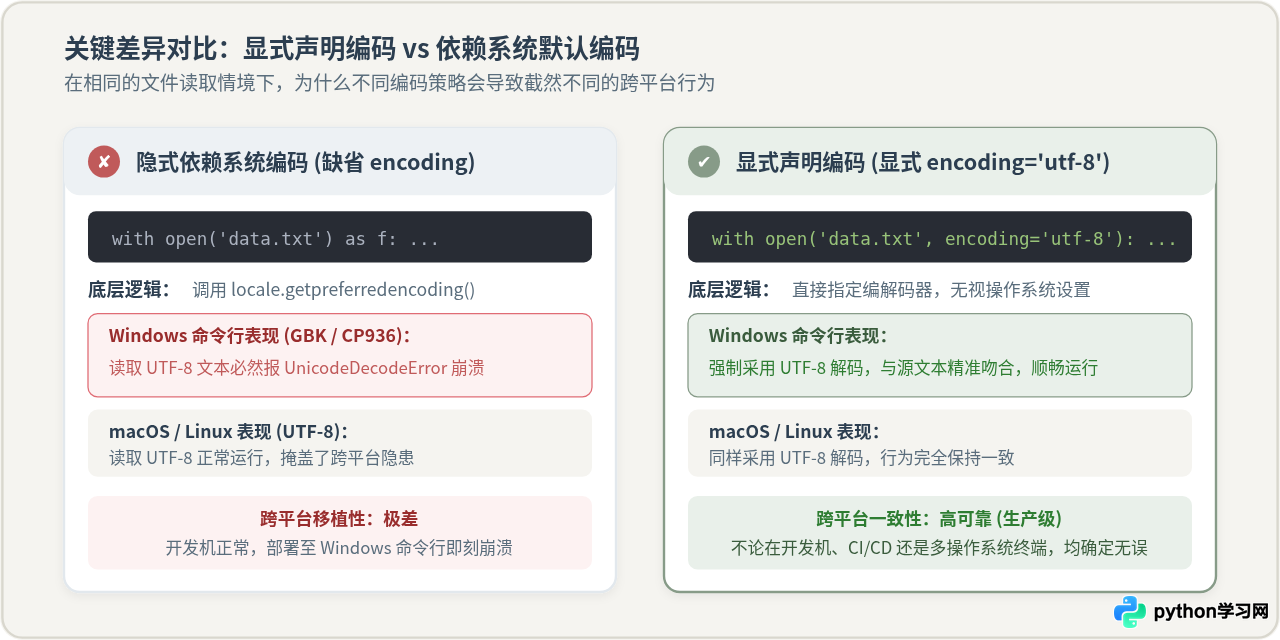
四、关键差异对比:显式声明编码 vs 依赖系统默认编码
许多初学者常有疑问:“为什么同样的 Python 脚本,我在开发机或 IDE 里面运行毫无问题,一放到服务器命令行或别人的 Windows 电脑上就会报 UnicodeDecodeError?”
核心差异在于代码是否将数据解码的决定权让渡给了操作系统环境:
| 对比维度 | 隐式依赖默认(open('file.txt')) |
显式声明(open('file.txt', encoding='utf-8')) |
|---|---|---|
| 底层取值逻辑 | 内部调用 locale.getpreferredencoding() |
固定使用指定的标准化 Codec 解码器 |
| macOS / Linux 表现 | 系统环境通常为 UTF-8,读取 UTF-8 正常 | 正常解码,行为符合预期 |
| Windows 命令行表现 | 默认读取系统活动代码页(如 CP936),读 UTF-8 报错 | 强制以 UTF-8 解码,不受代码页影响,顺畅运行 |
| CI/CD 与容器化表现 | 若容器环境缺少 Locale 配置,会回退为 ASCII 发生崩溃 | 完全不受容器 Minimal 镜像环境影响 |
| 维护成本 | 潜藏不可控隐患,随部署机器变动而随机报错 | 确定性高,代码自包含,具备生产级健壮性 |
encoding 参数的代码属于环境依赖型代码。只要目标机器的区域语言不是 UTF-8(典型如中文版 Windows 桌面环境),隐式读取就会按照本地编码强行解析,导致完全一致的代码在不同终端产生分裂表现。因此,在任何工程代码中显式指定 encoding 是避免此类问题的黄金准则。
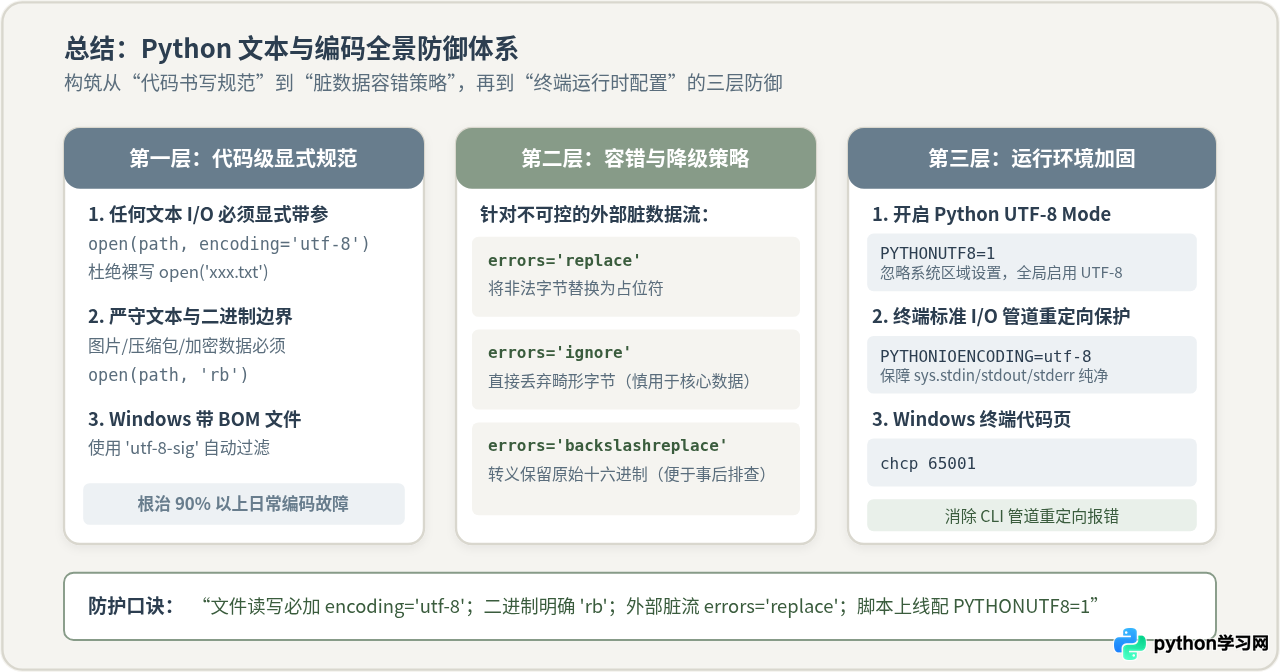
五、非标准数据流的容错降级策略(errors 参数选型)
在抓取第三方网络爬虫数据、处理杂乱的历史服务器系统日志、或对接未知硬件串口通信时,外部数据流中可能夹杂了个别残缺畸变字节。如果直接使用默认的 errors='strict',单个非法字节就会使整个脚本完全崩溃。
Python 的 open() 和 bytes.decode() 提供了 errors 参数来定义容错机制:
1. 替换非法字符:errors='replace'
将无法识别的字节序列替换为 Unicode 官方替换字符 �(U+FFFD),保证流程不中断:
with open('messy_logs.txt', 'r', encoding='utf-8', errors='replace') as f:
log_data = f.read()适用场景:日志分析、大文本语料清洗。虽然个别乱码字符会被替换,但整体文本的绝大部分信息得以保留。
2. 静默丢弃非法字节:errors='ignore'
直接忽略并跳过所有无法识别的非法字节:
with open('messy_logs.txt', 'r', encoding='utf-8', errors='ignore') as f:
log_data = f.read()注意事项:此方法会丢失数据且不留下任何痕迹,若用于金融数据、配置文件或源代码分析,可能会导致数据静默损坏,应谨慎使用。
3. 转义保留原始字节:errors='backslashreplace'
将无法解码的字节转换为形如 \xNN 的十六进制转义字符串保留下来:
with open('raw_stream.bin', 'r', encoding='utf-8', errors='backslashreplace') as f:
debug_text = f.read()适用场景:调试排错与审计阶段。既避免了脚本中断,又能清楚查看出问题的具体原始字节数值。
六、验证与长期防护实践清单
修复代码后,应当在部署上线前进行完整验证。验证清单如下:
-
多操作系统环境验证:如果在 macOS 或 Linux 开发,尝试在 Windows 命令提示符(CMD)下执行
python script.py,确保其在不借助任何 IDE 辅助时能够独立通过。 -
管道重定向验证:在命令行中通过管道传递测试数据,测试标准输入的鲁棒性:
# 测试管道输入是否平稳运行 type data.txt | python script.py # Windows CMD cat data.txt | python3 script.py # Linux / macOS -
使用 pathlib 现代化 API:在现代 Python 代码中,推荐使用
pathlib.Path处理文件读写,同样保持显式传递编码:from pathlib import Path # 现代 Python 推荐的标准读取范式 data_path = Path('data.txt') text_content = data_path.read_text(encoding='utf-8') -
生产部署环境配置:在 Dockerfile、Kubernetes Pod 启动模板或 CI/CD 构建脚本中,固化环境变量
ENV PYTHONUTF8=1,从底层彻底根除因系统区域差异引发的解码报错。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









