

Python中open函数的r和rb模式有什么区别
深入对比Python中open函数的r模式与rb模式的核心差异,涵盖返回值类型(str与bytes)、字符编码解码机制、跨平台换行符自动转换、文件指针跳转限制及具体业务场景选择指南。
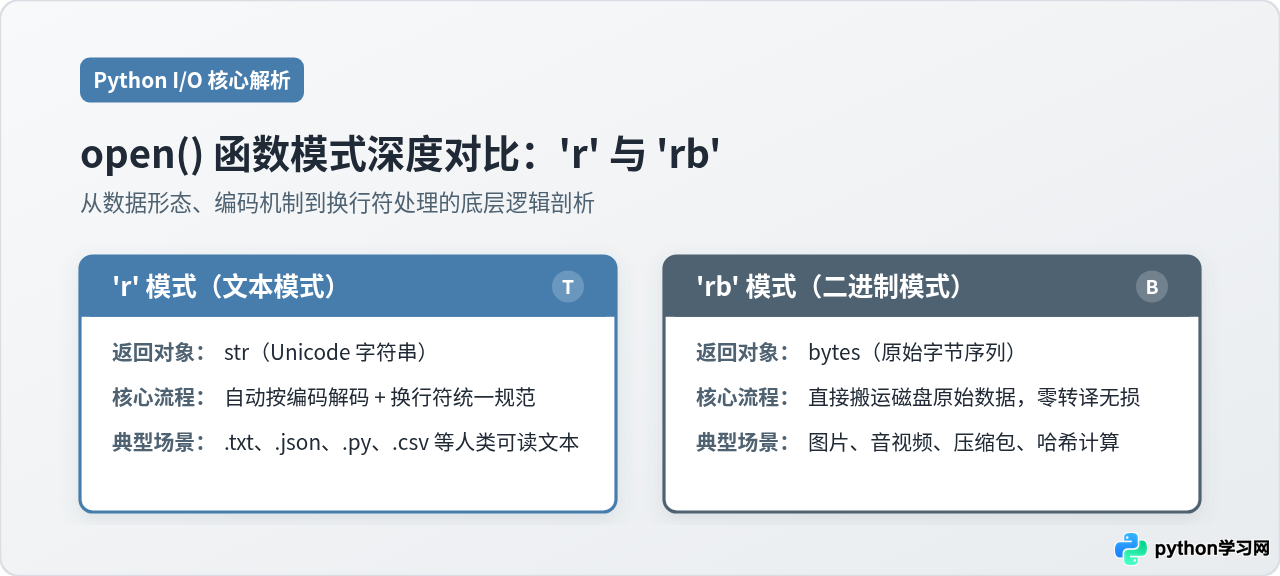
在 Python 中使用内置的 open() 函数读取文件时,'r'(只读文本模式)和 'rb'(只读二进制模式)的核心区别在于数据处理层级:'r' 模式以字符(str)为单位,读取时会自动依据指定编码将磁盘字节解码为 Unicode 文本,并对跨平台换行符进行统一归一化转换;而 'rb' 模式以字节(bytes)为单位,直接原封不动地搬运磁盘上的原始二进制数据,不介入任何编码解码或字符转换。理解这两者的差异,是编写稳定文件读写代码、规避乱码和数据损坏的关键基础。
一、核心区别概览:文本流与字节流的处理链路
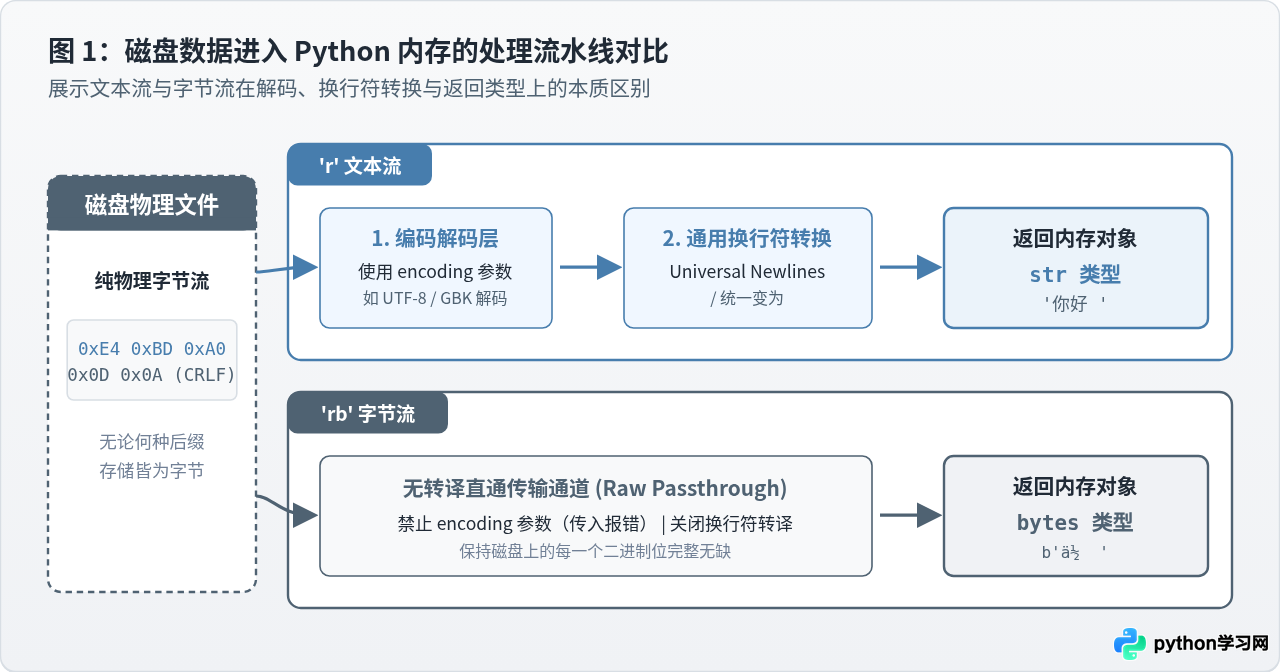
计算机磁盘物理存储的所有文件,本质上都是一段由 0 和 1 构成的原始字节流。操作系统并不知道也不关心文件里写的是一篇中文小说还是一张 PNG 图片。真正的分水岭发生在 Python 运行时如何读取这批字节:
- 'r' 模式(Read Text):Python 在底层构建了一个
io.TextIOWrapper文本流对象。从底层读取原始字节后,必须经过两个处理中间层:首先通过编码解码器(Decoder)转换成字符,随后通过通用换行符转换器(Universal Newlines)将不同操作系统的换行符折叠为标准的 - 'rb' 模式(Read Binary):Python 构建的是
io.BufferedReader二进制缓冲流对象。它绕过字符解码与换行符处理模块,直接将磁盘原始字节填充到内存中,提供纯粹的原生访问。
二、返回值类型与编码机制的差异
两种模式最直接的外在表现是 read() 方法返回的数据类型不同:
- 使用
'r'模式读取时,返回的是不可变的str(字符串) 对象。 - 使用
'rb'模式读取时,返回的是不可变的bytes(字节序列) 对象。
在 'r' 模式下,因为涉及字节到字符的转换,open() 函数允许且强烈要求传入 encoding 参数(例如 encoding='utf-8')。如果在 'r' 模式下省略 encoding,Python 会调用 locale.getpreferredencoding(False) 获取操作系统的默认编码。在 Windows 上这通常是 cp936(GBK),若读取 UTF-8 编码的文件便会抛出经典的 UnicodeDecodeError。
相反,在 'rb' 模式下,由于根本不执行解码操作,禁止传入 encoding 参数。若向 'rb' 模式传入该参数,Python 会立即报错。
# 示例代码:分别以 'r' 与 'rb' 模式读取同一文本文件
file_path = "example.txt"

# 1. 以 'r' 模式读取
with open(file_path, mode="r", encoding="utf-8") as f:
    text_data = f.read()
    print("模式 'r' 返回类型:", type(text_data))
    print("模式 'r' 返回内容:", repr(text_data))

# 2. 以 'rb' 模式读取
with open(file_path, mode="rb") as f:
    binary_data = f.read()
    print("模式 'rb' 返回类型:", type(binary_data))
    print("模式 'rb' 返回内容:", repr(binary_data))
模式 'r' 返回类型: <class 'str'>模式 'r' 返回内容: 'Python编程
'模式 'rb' 返回类型: <class 'bytes'>模式 'rb' 返回内容: b'Pythonç¼ç¨
'
open("data.bin", mode="rb", encoding="utf-8"),Python 会在启动时直接抛出:ValueError: binary mode doesn't take an encoding argument。牢记:只有需要解码为字符串的文本模式才接受
encoding 与 errors 参数。
三、跨平台换行符转换机制(Universal Newlines)
不同操作系统在历史上定义了不同的文本换行符约定:
- Windows:采用回车符与换行符组合
0x0D 0x0A,共 2 字节)。 - Linux 与现代 macOS:采用单独的换行符
0x0A,1 字节)。 - 早期 Mac(OS 9 以前):采用单独的回车符
0x0D,1 字节)。
为了让开发者无需针对不同平台编写繁琐的换行兼容逻辑,Python 在 'r' 文本模式下默认启用了通用换行符转换功能。无论文件是在 Windows 还是 Linux 下创建的,读取到 Python 内存中时,所有的
或 都会被默默转换为标准的单一
字符。
而在 'rb' 二进制模式下,换行符转换被完全禁用。磁盘上存储的如果是 0x0D 0x0A,读取到内存中的 bytes 就是 b'
',字节长度严格等于 2。
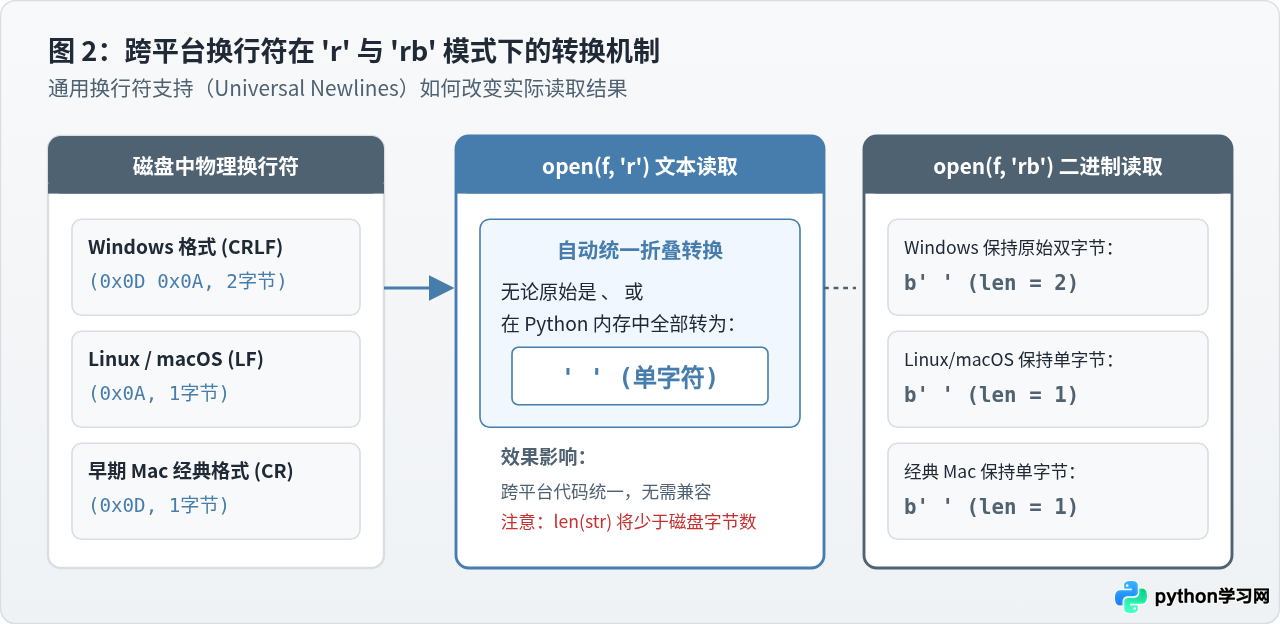
这种差异会导致一个非常经典的反直觉现象:在 Windows 下保存的文本,使用 'r' 模式读取得到的字符数(len(str)),会小于文件的实际字节大小(len(bytes))。因为每个 Windows 换行符的两个字节
被合成为了一个单字符
。
# 示例代码:验证换行符对读取长度的影响
windows_file = "crlf_demo.txt"

# 写入含有 Windows 换行符的数据
with open(windows_file, "wb") as f:
    f.write(b"Line1
Line2
")

# 以 'r' 模式读取
with open(windows_file, "r", encoding="utf-8") as f:
    content_text = f.read()
    print("文本模式长度 (len(str)):", len(content_text))
    print("文本模式内容:", repr(content_text))

# 以 'rb' 模式读取
with open(windows_file, "rb") as f:
    content_bytes = f.read()
    print("二进制模式长度 (len(bytes)):", len(content_bytes))
    print("二进制模式内容:", repr(content_bytes))
文本模式长度 (len(str)): 12文本模式内容: 'Line1
Line2
'二进制模式长度 (len(bytes)): 14二进制模式内容: b'Line1
Line2
'
四、文件指针定位(seek 与 tell)的行为限制
在处理大文件或需要随机读取时,经常需要配合使用 seek(offset, whence) 移动文件读取指针,以及使用 tell() 查看当前位置。两种模式在此处的规范极其严格:
- 在 'rb' 模式下:偏移量代表绝对字节数。
whence参数可以为0(从文件开头)、1(从当前位置)或2(从文件末尾)。例如seek(-10, 2)表示跳到文件末尾倒数第 10 个字节处,行为完全符合低阶字节定位。 - 在 'r' 模式下:由于 UTF-8 编码下中文占 3 个字节、换行符会被折叠,字符位置与底层字节偏移之间不存在简单的线性换算关系。因此在文本模式下,禁止随意指定非零字节偏移,且
whence只能为0(除非使用seek(0, 2)移到末尾)。若试图随意跳转(例如seek(4)),一旦切在多字节字符的中间,下一次读取便会直接导致UnicodeDecodeError。在文本模式下,合法的偏移量通常只能是先前通过tell()获取的不透明数值(Opaque Cookie)。
五、模式选择决策路径与标准操作步骤
在日常开发中,究竟应当选择 'r' 还是 'rb'?可以通过以下清晰的决策逻辑进行判断:
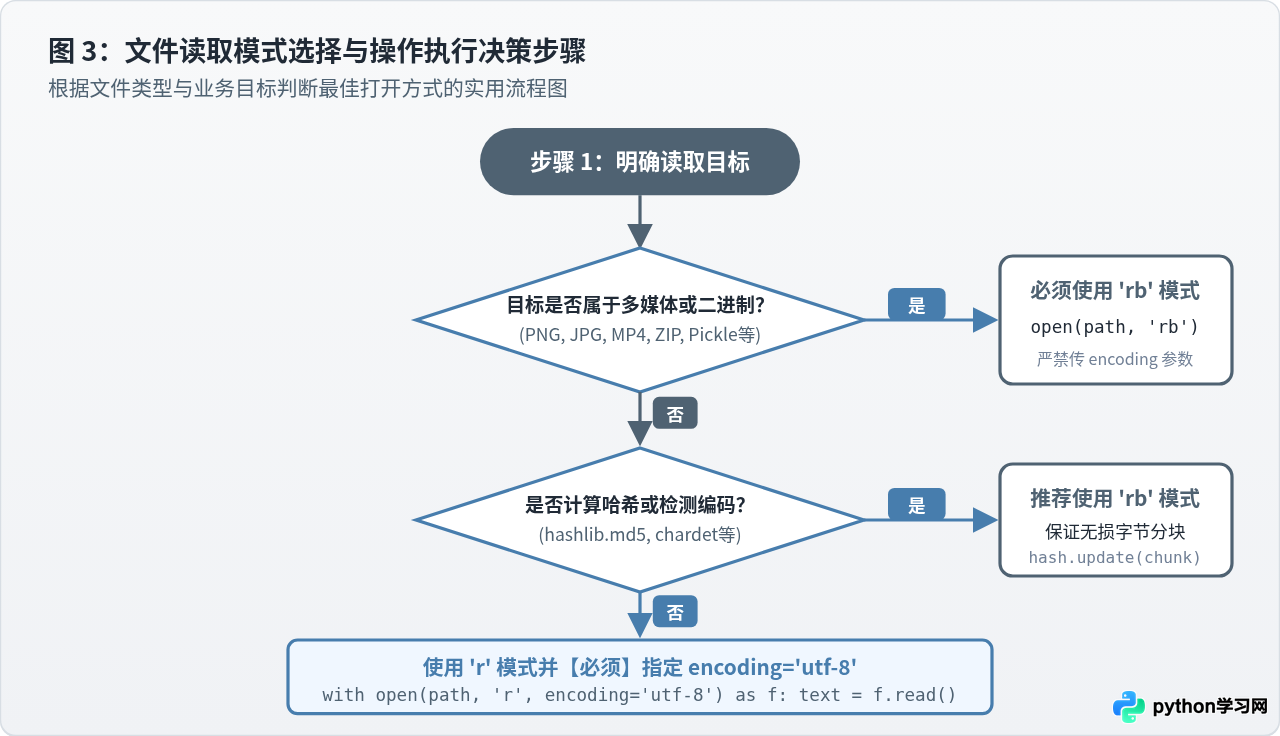
场景 1:读取并解析常规文本文件(选择 'r' 模式)
当文件内容是人类可阅读的自然语言文本、配置文件或由字符构成的结构化数据(如 .txt、.json、.csv、.md、.ini)时,应当选择 'r' 模式,并且必须显式传入 encoding="utf-8":
import json

# 正确示范:显式指定 utf-8 编码读取 JSON 文本
with open("config.json", mode="r", encoding="utf-8") as f:
    config = json.load(f)
    print("应用配置名称:", config.get("app_name"))
场景 2:处理多媒体、压缩包或序列化数据(必须选择 'rb' 模式)
当处理图片(PNG、JPEG)、音频(MP3、WAV)、视频(MP4)、压缩文件(ZIP、GZ)以及 Python 对象的持久化(Pickle、Protobuf)时,绝不能使用 'r' 模式。这些格式中包含大量随机分布的十六进制字节(包括 0x0D、0x0A、0xFF 等),如果用文本模式打开,换行符会被篡改、非文本字节解码失败,导致文件遭到破坏。
# 正确示范:以 'rb' 模式读取图片并检查头部魔数 (Magic Number)
with open("avatar.png", mode="rb") as f:
header = f.read(8)
# PNG 文件标准头部固定为 8 个字节
is_png = (header == b"PNG
")
print("是否为合法 PNG 文件:", is_png)
场景 3:计算文件哈希摘要或逐块传输(推荐选择 'rb' 模式)
即使是纯文本文件,如果当前任务是计算文件的 MD5/SHA256 校验和、进行网络断点续传或统计文件的精确字节大小,也应当采用 'rb' 模式。因为哈希计算要求的是磁盘上的原始物理字节,使用 'r' 模式会因为换行符归一化导致 Windows 与 Linux 下算出的哈希值不一致。
import hashlib

def calculate_file_sha256(filepath):
    sha256_hash = hashlib.sha256()
    # 使用 'rb' 模式分块读取,内存开销恒定且避免换行符篡改
    with open(filepath, "rb") as f:
        for chunk in iter(lambda: f.read(65536), b""):
            sha256_hash.update(chunk)
    return sha256_hash.hexdigest()

# 示例输出真实字节摘要
print("SHA256:", calculate_file_sha256("example.txt"))
六、常见误区与避坑指南
- 误区 1:在文本模式下省略 encoding 参数
许多初学者直接写open("data.txt", "r"),在 macOS/Linux 开发测试一切正常,部署到客户的 Windows 服务器后立刻报UnicodeDecodeError: 'gbk' codec can't decode byte...。无论何时,处理文本都要养成显式声明encoding="utf-8"的习惯。 - 误区 2:尝试在 'rb' 模式读出的结果上调用字符串方法
'rb'读取得到的是bytes,虽然部分方法名与str类似(如split()、replace()),但其入参必须也是字节字面量(如b","而非",")。若需进行复杂正则或字符串拼接,必须先通过.decode("utf-8")显式解码。 - 误区 3:以为读写同一文件用不用 'b' 都无所谓
在 Unix 系统上,历史上换行符本身就是'r'与'rb'经常“巧合”地表现一致,这极具迷惑性。一旦跨平台到 Windows,或者遇到非 ASCII 字符(如中文、Emoji),隐患便会集中爆发。
七、核心特性对比与速查矩阵
为了便于日常查阅与记忆,下表及图示汇总了 'r' 与 'rb' 模式在各个维度的严格技术边界:
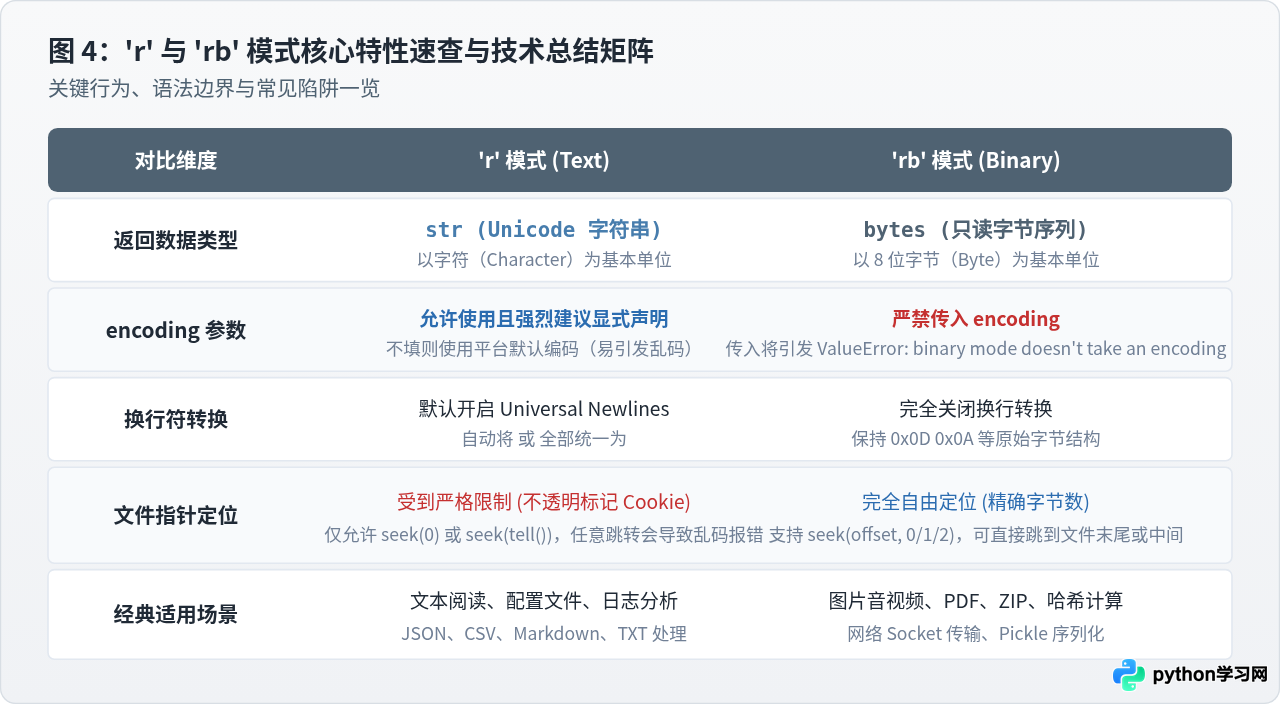
| 特性维度 | 'r' 模式(文本) | 'rb' 模式(二进制) |
|---|---|---|
| 返回类型 | str(Unicode 字符) |
bytes(原始字节序列) |
| 解码过程 | 自动解码(依赖 encoding) |
不解码(原始物理数据直通) |
| 换行符转换 |
与 默认自动转为
|
保持原始 0x0D、0x0A,不作任何修改 |
| encoding 参数 | 允许且强烈推荐显式传入 | 禁止传入,传入抛出 ValueError |
| 文件指针 seek | 仅限 0 偏移或 tell() 记录的标记 |
支持从文件头/当前/文件尾的任意绝对字节跳转 |
| 适用对象 | TXT、JSON、CSV、Markdown、Python源码等 | 图像、视频、音频、压缩包、哈希计算、网络传输 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









