

Python字符编码转码之GBK,UTF8互转

本文详细解析Python中字符编码转换的原理与操作。重点对比Python 2与Python 3在字符串处理上的差异,通过具体代码示例演示GBK与UTF-8编码的互转过程。文章涵盖encode与decode的使用场景,以及不同版本中字符串类型的变化,帮助开发者解决乱码问题。
Python字符编码基础
理解字符编码转换,首先需要明确不同Python版本对字符串的处理机制。Python 2的默认编码为ASCII,而Python 3则默认使用Unicode。Unicode是一个包含全球所有字符编码的标准,其内部实现形式包括UTF-32、UTF-16和UTF-8。其中,UTF-16占用两个字节,而UTF-8是一种可变长编码,占用1到4个字节。为了节省存储空间,文件通常以UTF-8格式存储。
在Python 3中,字符串(string)与字节(bytes)的概念被严格区分。`encode`方法用于将字符串转换为字节序列,而`decode`方法则用于将字节序列还原为字符串。例如,一个英文字符通常占用1个字节,而一个中文字符在UTF-8编码下通常占用3个字节。由于ASCII编码无法存储中文字符,因此在处理中文时,必须使用支持多字节的编码格式,如UTF-8或GBK。
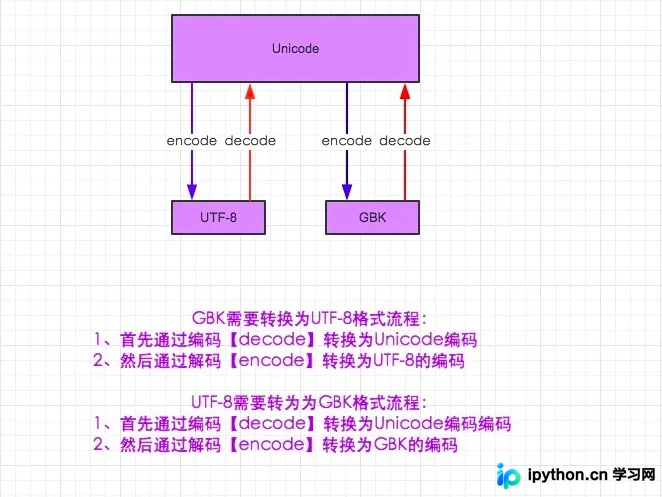
字符编码转换原理
不同编码格式之间的转换,通常需要通过Unicode作为中间桥梁。在Python 2中,非Unicode编码的字符串必须先解码(decode)为Unicode,然后再编码(encode)为目标编码格式。如果在文件开头不指定编码格式,解释器将使用系统默认编码。当系统编码为ASCII时,尝试打印中文字符会引发错误。因此,在Python 2文件中指定编码(如`# -*- coding:utf-8 -*-`)是打印中文字符的必要步骤。
相比之下,Python 3的默认编码即为Unicode。这意味着在Python 3中,字符串字面量已经是Unicode对象,因此进行编码转换时,无需先执行decode操作,可以直接调用encode方法。需要注意的是,文件开头的编码声明仅告知解释器文件的存储编码,Python 3中的字符串变量在内存中依然保持为Unicode类型。`encode`的结果始终是bytes类型,即二进制字节码。
Python 2中的编码转换实战
在Python 2环境下,字符串处理需要显式地进行解码和编码操作。以下代码演示了如何将UTF-8编码的字符串转换为GBK,再转换回UTF-8。
#! /usr/bin/env python
# -*- coding:utf-8 -*-
# __auther__ == luoahong

s = "我是学员"
#utf-8解码成unicode编码
s_to_unicode = s.decode("utf-8")
print("--------s_to_unicode-----")
print(s_to_unicode)
#然后unicode再编码成gbk
s_to_gbk = s_to_unicode.encode("gbk")
print("-----s_to_gbk------")
print(s_to_gbk)
#gbk解码成unicode再编码成utf-8
gbk_to_utf8 = s_to_gbk.decode("gbk").encode("utf-8")
print("------gbk_to_utf8-----")
print(gbk_to_utf8)

#输出
--------s_to_unicode-----
我是学员
-----s_to_gbk------
�����˧
------gbk_to_utf8-----
我是学员
上述代码首先将UTF-8字符串解码为Unicode,然后编码为GBK。由于GBK编码对某些字符的支持有限,转换后的字节序列在直接打印时可能显示为乱码(如�)。最后,通过再次解码为Unicode并编码为UTF-8,成功还原了原始字符串。另一个示例展示了以Unicode前缀`u`声明的字符串,其本质已是Unicode,因此可以直接编码为GBK:
#! /usr/bin/env python
# -*- coding:utf-8 -*-
# __auther__ == luoahong

#u代码字符编码是unicode
s = u'你好'
#已经是unicode,所以这边直接是编码成gbk
s_to_gbk = s.encode("gbk")
print("----s_to_gbk----")
print(s_to_gbk)
#这边再解码成unicode然后再编码成utf-8
gbk_to_utf8 = s_to_gbk.decode("gbk").encode("utf-8")
print("-----gbk_to_utf8---")
print(gbk_to_utf8)
#输出
----s_to_gbk----
���
-----gbk_to_utf8---
你好
Python 3中的编码转换实战
在Python 3中,字符串默认即为Unicode,因此无需声明字符编码前缀,也无需先进行decode操作。以下代码演示了Python 3中GBK与UTF-8的互转过程:
#! /usr/bin/env python
# __auther__ == luoahong
#无需声明字符编码,当然你声明也不会报错

s = '你好'
# 字符串s已经是unicode编码,无需decode,直接encode
s_to_gbk = s.encode("gbk")
print("----s_to_gbk----")
print(s_to_gbk)
#这边还是一样,gbk需要先解码成unicode,再编码成utf-8
gbk_to_utf8 = s_to_gbk.decode("gbk").encode("utf-8")
print("-----gbk_to_utf8---")
print(gbk_to_utf8)
#解码成unicode字符编码
utf8_decode = gbk_to_utf8.decode("utf-8")
print("-------utf8_decode----")
print(utf8_decode)

#输出
----s_to_gbk----
b'\xc4\xe3\xba\xc3'
-----gbk_to_utf8---
b'\xe4\xbd\xa0\xe5\xa5\xbd'
-------utf8_decode----
你好
运行结果显示,`encode`后的字符串类型为bytes,例如`b'\xc4\xe3\xba\xc3'`。通过`decode`方法,可以将bytes还原为Unicode字符串,从而正确显示中文。这一过程清晰地展示了Python 3中字符串与字节的转换逻辑。
总结
Unicode能够识别所有字符编码的字符串,是不同编码格式转换的核心。在Python 2中,编码转换必须通过Unicode进行,且文件开头需指定编码以处理中文。Python 2未严格区分字符和字节,导致编码处理较为繁琐。而在Python 3中,通过Unicode识别字符,字符串直接转换为bytes格式。理解bytes即二进制字节码的概念,并通过decode将bytes还原为Unicode,是解决Python 3编码问题的关键。
以上就是Python字符编码转换之GBK与UTF-8互转的详细内容,更多关于Python编码处理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









