

Python bisect模块用法指南:高效实现二分查找与插入定位
系统讲解Python标准库bisect模块的核心机制,深入剖析bisect_left、bisect_right与insort的区别,结合Python 3.10+的key参数与区间分段实战,实现高效二分查找与插入定位。
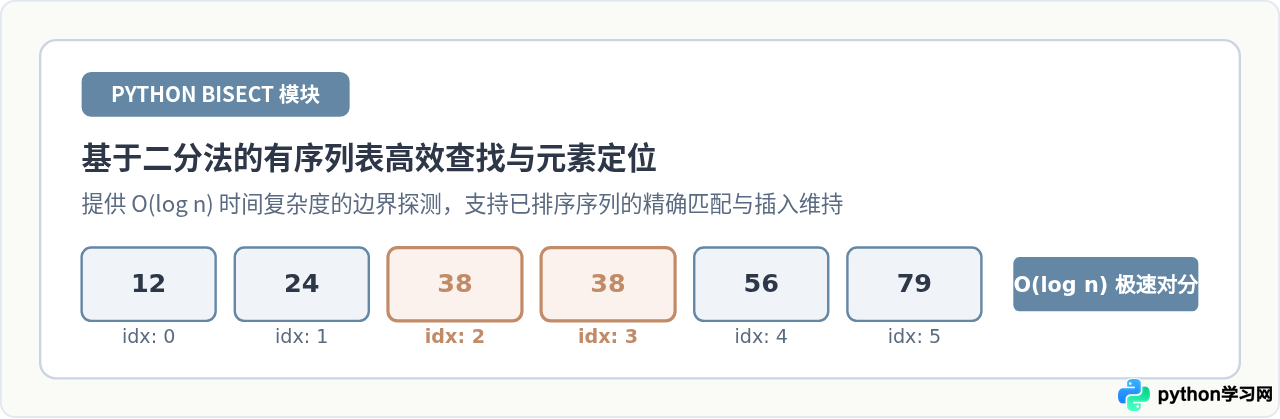
在 Python 中检索数据时,最常用的 list.index() 采用从头到尾的线性遍历方式,时间复杂度为 O(n)。当列表规模达到十万或百万级且内部元素已经有序时,线性扫描会带来明显的性能开销。Python 标准库自带的 bisect 模块基于经过充分优化的二分查找(Binary Search)算法,能够在 O(log n) 时间内准确计算出指定元素在有序序列中的插入索引,同时支持在保持排序的前提下就地插入元素。
一、使用 bisect 的核心前置条件
bisect 模块的所有函数都有一个绝不能忽视的前提:被操作的序列必须是升序排列的。二分查找算法的核心思想是每次选取当前区间的中间元素与目标值比较,若中间值大于目标值,则说明目标值只能位于左半区间;反之则位于右半区间。这种通过单次比较排除一半搜索范围的高效特性,完全建立在数据具有严格单调性的基础之上。
注意:bisect 函数内部不会主动校验序列是否已有序,因为全面检查序列有序性本身需要 O(n) 的时间,这会违背二分查找 O(log n) 的设计初衷。如果在一个无序列表上调用 bisect,代码不会抛出异常,但会返回完全不可预测的错误索引。
二、核心函数解析:bisect_left 与 bisect_right 的区别
在 bisect 模块中,最基础且最频繁使用的两个查找定位函数是 bisect_left 和 bisect_right。它们的函数签名完全一致,核心区别仅在于当序列中存在与目标值相等的元素时,返回的插入定位点不同。
bisect_left(a, x, lo=0, hi=len(a)):若序列a中已存在与x相同的元素,返回最左侧该元素的索引位置。新元素插入后,原有相同元素全部位于其右侧。bisect_right(a, x, lo=0, hi=len(a)):若序列a中已存在与x相同的元素,返回最右侧该元素的下一个索引位置。新元素插入后,排在所有相同元素的右侧。模块中的同名函数bisect()就是bisect_right()的完整别名。
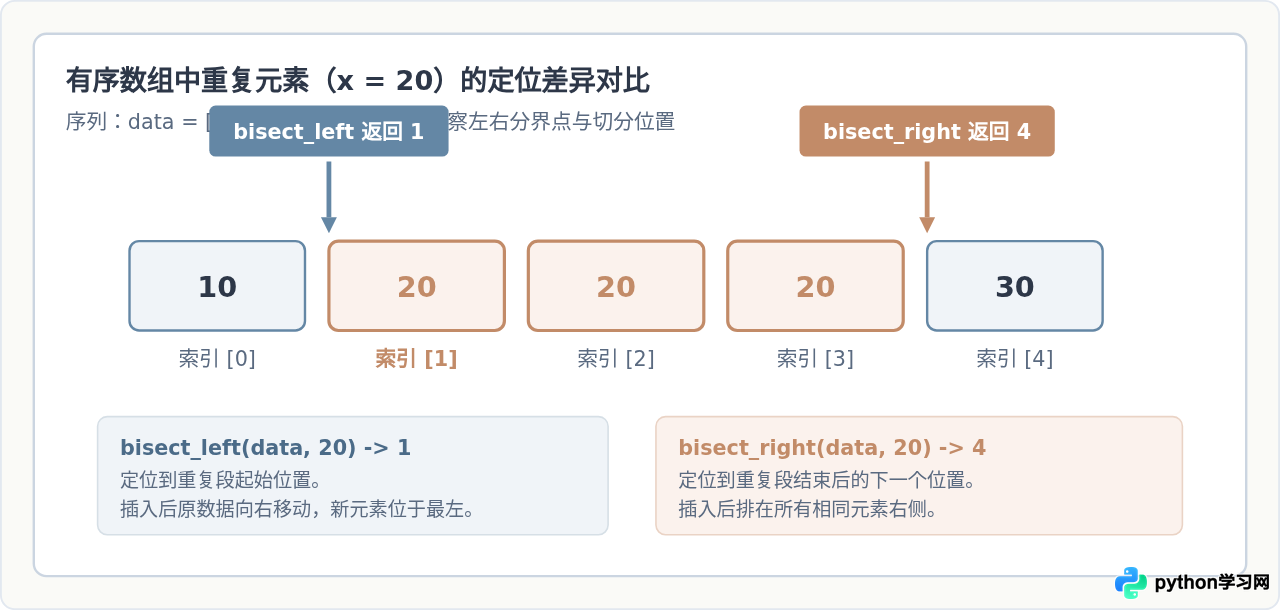
通过具体的 Python 代码可以直观验证两者的运行结果:
import bisect

numbers = [10, 20, 20, 20, 30]

# 寻找元素 20 的插入位置
idx_left = bisect.bisect_left(numbers, 20)
idx_right = bisect.bisect_right(numbers, 20)

print(f"bisect_left 结果: {idx_left}")   # 输出示例: 1
print(f"bisect_right 结果: {idx_right}") # 输出示例: 4

# 如果目标元素在列表中不存在(例如 25)
idx_not_exist = bisect.bisect_left(numbers, 25)
print(f"元素25的插入位置: {idx_not_exist}") # 输出示例: 4(无论left还是right均返回4)当列表中不存在目标值时,bisect_left 和 bisect_right 的返回结果完全相同,均指向首个大于目标值的元素所在索引(若目标值大于列表中所有元素,则返回列表长度 len(a))。
三、精准二分查找的实现方式
很多初学者容易产生误解,以为调用 bisect 会像普通查找函数一样直接返回元素是否存在。实际上,bisect 只负责计算插入位置。要实现标准的二分查找(即“如果存在返回其索引,不存在返回 -1 或 None”),我们需要结合边界校验与值比较:
import bisect

def binary_search_exact(sorted_list, target):
    """
    在有序列表中精准查找 target
    若找到返回对应索引,未找到返回 -1
    """
    index = bisect.bisect_left(sorted_list, target)
    # 步骤1:检查索引是否越界
    # 步骤2:检查对应索引处的值是否等于目标值
    if index < len(sorted_list) and sorted_list[index] == target:
        return index
    return -1

# 验证测试
data = [5, 12, 18, 24, 31, 45, 60]
print(binary_search_exact(data, 24))  # 输出示例: 3
print(binary_search_exact(data, 20))  # 输出示例: -1
这里必须先判断 index < len(sorted_list),否则当目标值大于列表中所有元素时,index 将等于列表长度,直接访问 sorted_list[index] 会触发 IndexError 异常。
四、操作决策步骤:如何选择合适的 bisect 工具
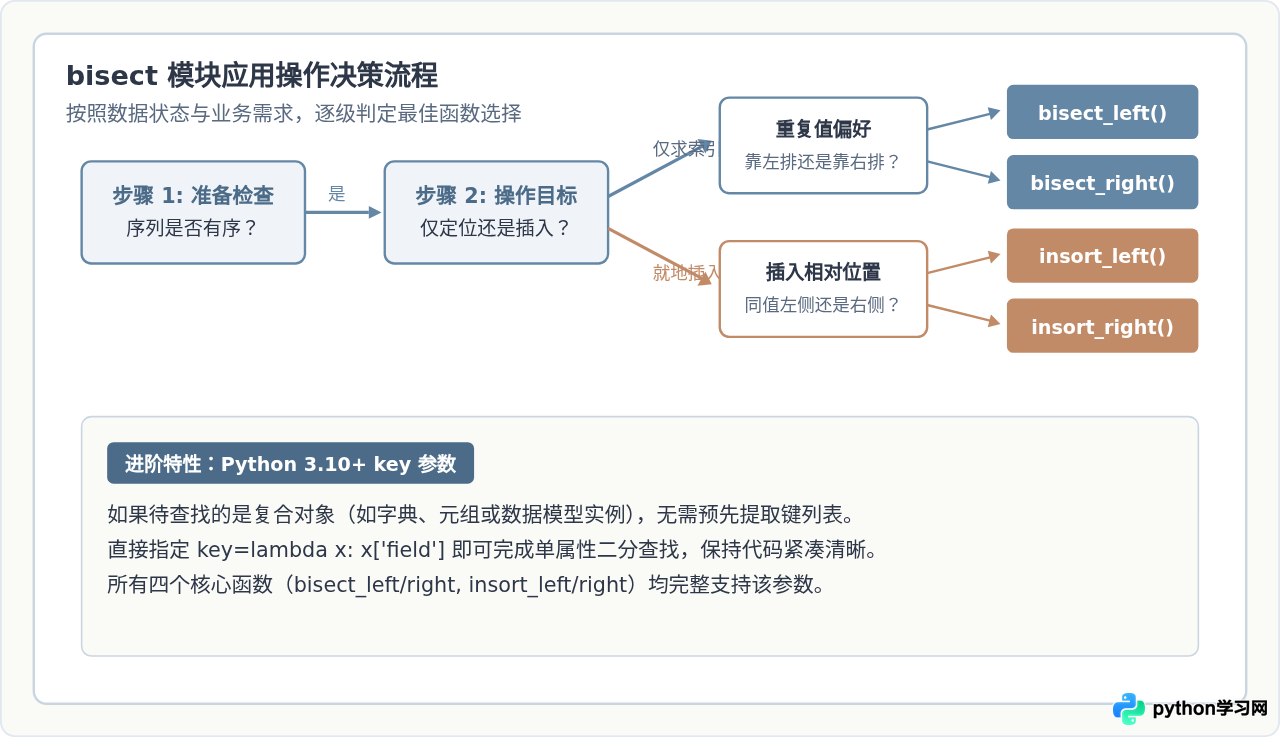
在编写实际程序时,面对查找、插入、区间匹配等不同诉求,可以通过下图所示的标准化流程快速确定需要调用的函数:
五、维持列表有序:insort_left 与 insort_right
如果需要在查找到合适位置后立即完成插入,可以使用 insort_left 和 insort_right(别名 insort)。它们本质上等价于执行 bisect 定位后再调用 list.insert(index, item),但封装成了单一步骤:
import bisect

stream_data = [10, 30, 50, 70]

# 使用 insort 插入新元素 40
bisect.insort(stream_data, 40)
print(stream_data)  # 输出示例: [10, 30, 40, 50, 70]

# 插入与已有元素相等的数值 30
bisect.insort_left(stream_data, 30)
print(stream_data) # 输出示例: [10, 30, 30, 40, 50, 70]底层性能警示:二分查找定位位置的耗时仅为 O(log n),但 Python 内置的 list 是连续动态数组,在指定位置插入元素后,其后的所有元素都必须在内存中向后移动一个位置,这一内存搬迁操作的时间复杂度是 O(n)。因此,insort 系列函数的整体时间复杂度仍然是 O(n)。如果有高并发、大规模的动态插入需求,应考虑使用平衡二叉树结构、跳表或 collections.deque 等更适合频繁插入的数据结构。
六、Python 3.10+ 增强:key 参数的高效应用
在 Python 3.10 之前,如果列表里存储的是字典、自定义类实例或二元组,想要根据某个字段进行二分查找,往往必须先构造一个辅助键列表,或者自定义对象的比较运算符。Python 3.10 为 bisect 模块的所有主要函数引入了 key 参数(类似于 sort(key=...)),大大简化了复合数据的检索逻辑:
import bisect

# 包含学生姓名与成绩的元组列表(必须按成绩升序排好)
students = [
    ("Alice", 68),
    ("Bob", 75),
    ("Charlie", 82),
    ("David", 91),
    ("Eva", 98)
]

# 提取分数的 key 函数
score_key = lambda s: s[1]

# 查找分数达到 80 分的第一个学生插入点
target_score = 80
idx = bisect.bisect_left(students, target_score, key=score_key)

print(f"插入索引: {idx}")  # 输出示例: 2
print(f"该位置当前学生: {students[idx]}")  # 输出示例: ('Charlie', 82)
需要特别留意的是:当指定了 key 参数时,传入的目标值 x 是与 key(item) 返回的值进行比较的,而不是直接与 item 比较。例如上例中 target_score 直接传入整数 80 即可。
七、典型实战场景:数值分段与区间映射
除了标准的元素检索外,bisect_right 最经典的用法之一是替代繁琐的 if-elif-else 阶梯条件判断,实现高效的分数评级、税率阶梯计算或分段计费逻辑。
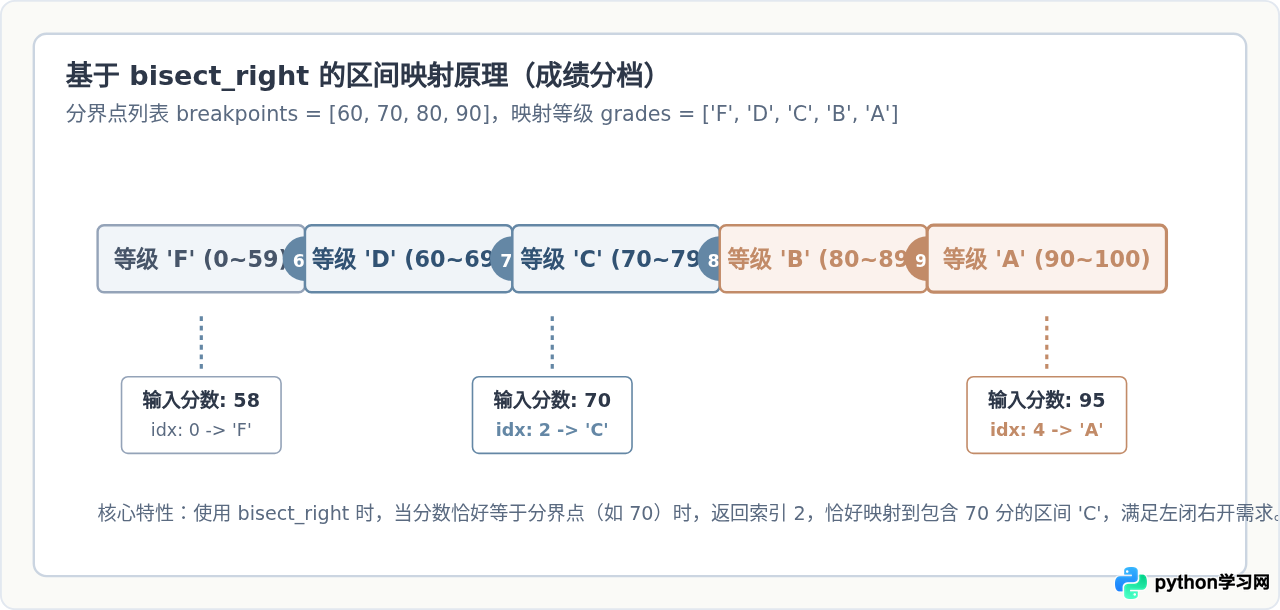
这种模式的代码不仅极其简洁,而且具备极佳的可读性与扩展性:
import bisect

def get_grade(score):
    # 分割阈值(严格升序排列)
    breakpoints = [60, 70, 80, 90]
    # 对应的评级标签(长度比 breakpoints 多 1)
    grades = ['F', 'D', 'C', 'B', 'A']

    # 查找右侧插入点
    index = bisect.bisect_right(breakpoints, score)
    return grades[index]

# 测试不同分数的映射情况
test_scores = [55, 60, 69, 70, 85, 90, 98]
results = [get_grade(s) for s in test_scores]
print(results)  # 输出示例: ['F', 'D', 'D', 'C', 'B', 'A', 'A']
为什么这里必须用 bisect_right 而不是 bisect_left?假设我们传入边界分数 60:
- 如果使用
bisect_left:面对[60, ...],它会返回索引0,导致 60 分被错误评为grades[0](即 'F',挂科)。 - 使用
bisect_right:面对60时,会跳过该分界点返回索引1,正确映射到grades[1](即 'D',及格)。这完美契合了“满分阈值向上入段”的实际业务规则。
八、总结与速查清单
bisect 是 Python 标准库中轻量但性能极佳的基础工具。在日常开发中,只要涉及静态有序集合的查找或轻量级的有序插入,优先选用标准库的 bisect 能够极大提升算法效率并降低代码维护成本。
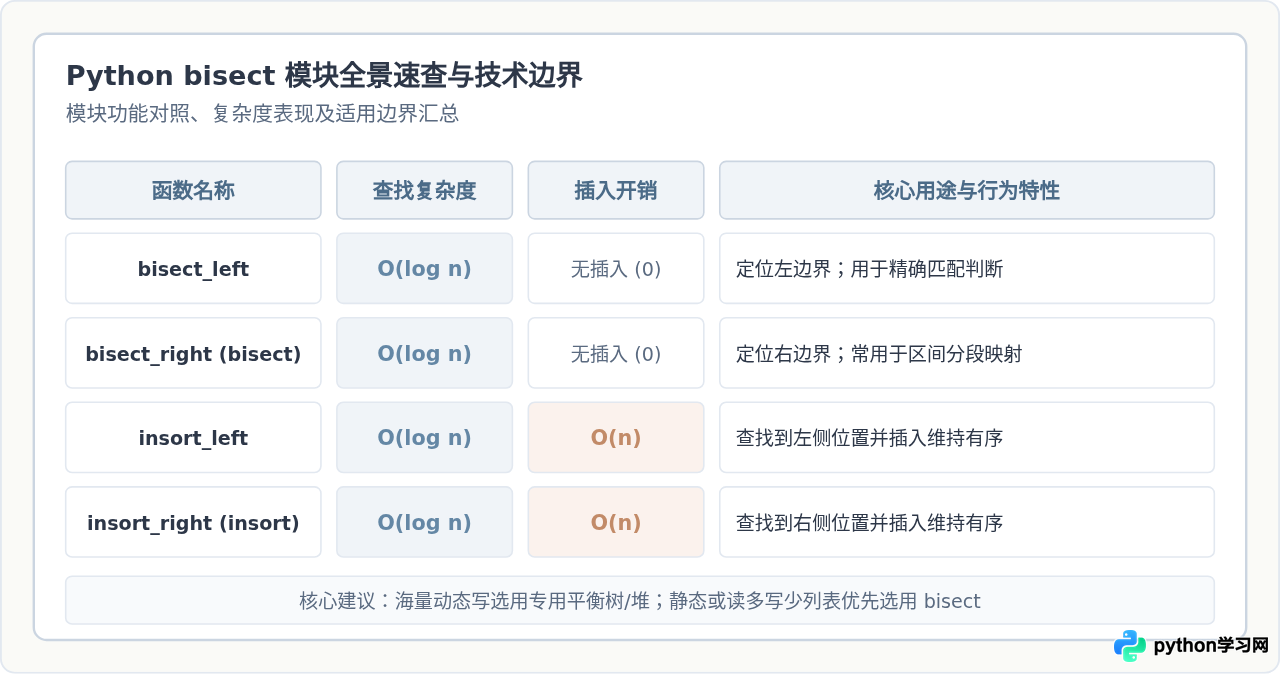
总结归纳为以下三点黄金法则:
- 输入必须保证升序:调用前务必保证列表单调递增,避免无序输入带来的静默逻辑错误。
- 明确边界语义:做精确匹配时选择
bisect_left,做阶梯阈值映射时选择bisect_right。 - 看清内存搬迁成本:
bisect的查询非常快(O(log n)),但insort的底层list.insert在大型列表上的内存移动是O(n),需根据数据吞吐量合理选型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









