

Python在线环境与本地IDE相比有哪些局限性
深入剖析Python在线运行环境(如Google Colab、Replit等)相比本地集成开发环境(如VS Code、PyCharm)的核心局限性,涵盖运行生命周期、硬件外设直通、深层调试排错、大型工程化与数据隐私等维度,并提供标准的本地迁移操作指南。
一、计算生命周期与存储的非持久性
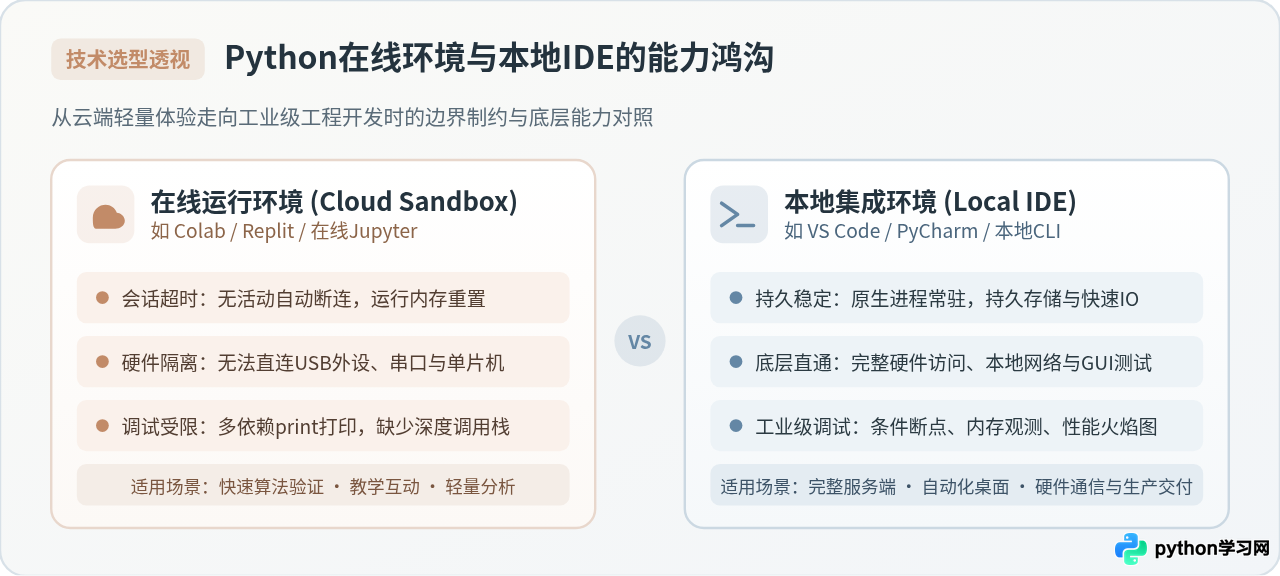
在线运行环境的本质是运行在云端集群上的无状态或临时状态容器。平台为了保障公有计算资源的利用效率,普遍设计了严格的生命周期控制策略,这直接带来了以下三项硬性约束:
- 会话闲置超时(Idle Timeout)与意外断连:大多数免费或标准在线环境会在用户无操作 30 到 90 分钟后自动断开内核连接。一旦会话断开,分配给该实例的内存、显存和临时运算变量将被彻底清空。对于耗时数小时的爬虫任务、长周期模型训练或持续监听的数据通道,在线环境极易因网络抖动或闲置判定而半途夭折。
- 存储生命周期的非持久化:在线环境提供的本地磁盘空间属于临时挂载卷(Ephemeral Storage)。容器重启或配额重置后,存放在当前工作区的文件均会被抹除。虽然可以通过挂载云盘(如 Google Drive)实现持久化,但网络文件系统的挂载会引入显著的 I/O 延迟,当涉及海量小图片、大文本清洗等高频小文件读写时,吞吐性能往往比本地 NVMe 固态硬盘慢一个数量级。
- 算力调度的不可预测性:在线平台分配的 GPU/TPU 与 CPU 资源属于共享资源池。用户无法保证每次启动都能分配到相同架构的算力单元,在高负载高峰期,常会遭遇排队等待、实例强制降级为单核 CPU 或每日免费配额耗尽等不可控情况。
二、硬件底层、操作系统与本地接口的天然屏障
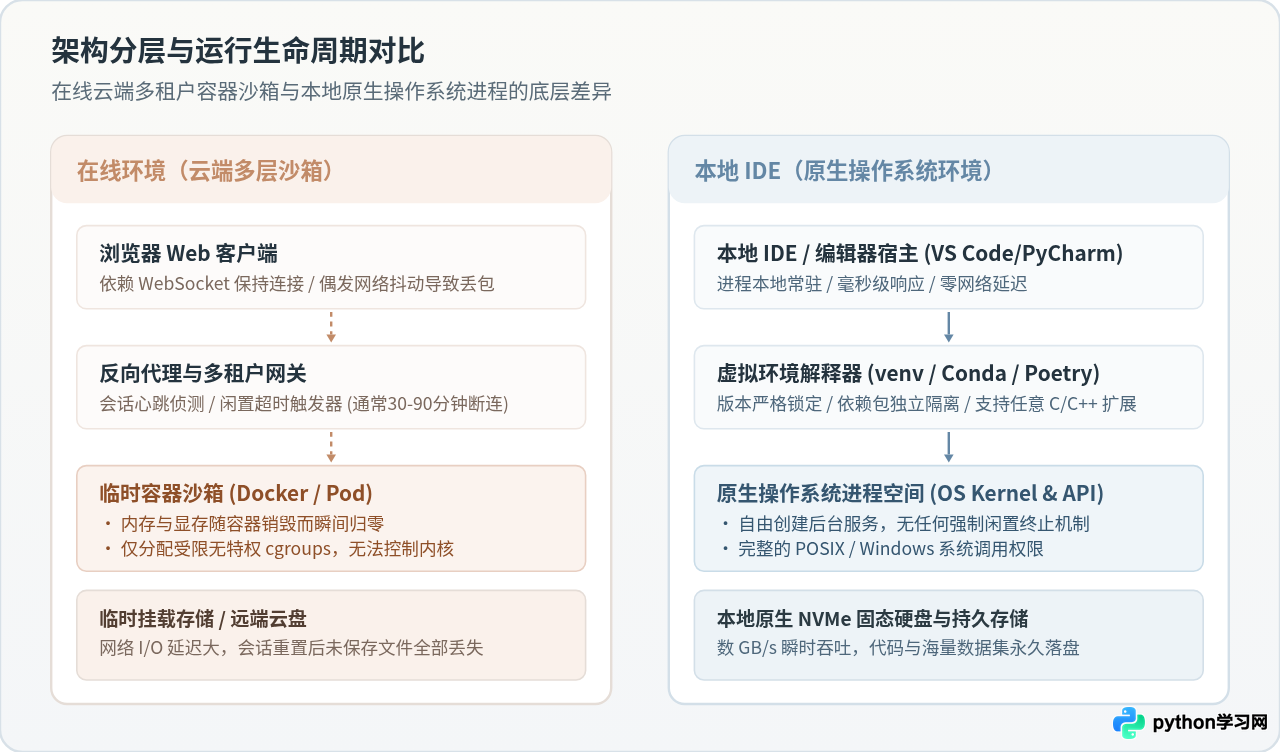
本地 IDE(如 VS Code、PyCharm、CLion 等)直接运行在宿主操作系统上,享有完整的进程权限与系统 API 访问能力。相反,在线环境被严格封装在 Linux 容器(Docker/cgroups)沙箱内,这导致所有涉及本地物理实体的操作均无法直接生效。
1. 物理外设与串行总线直连失效
在嵌入式开发、物联网(IoT)或硬件联调场景中,Python 经常需要通过 pyserial 库读写串口设备(COM 口或 /dev/ttyUSB),或通过 USB 接口烧录固件到 Arduino、ESP32、STM32 等开发板。在线环境运行在千里之外的云端数据中心,无法识别插在开发者电脑上的物理设备,底层接口调用直接抛出 SerialException: [Errno 2] could not open port 错误。
2. 桌面自动化与原生图形界面(GUI)渲染阻隔
如果开发依赖屏幕像素捕捉、鼠标按键模拟(如使用 pyautogui、pynput),或者构建桌面客户端应用(如 PyQt、PySide、Tkinter、wxPython),在线环境由于缺失真实的 X11/Wayland 桌面显示服务器或物理屏幕缓冲区,默认无法直接弹出窗口。即使配置了虚拟帧缓冲(Xvfb)或 Web VNC 转发,其刷新率、操作延迟和事件同步也无法满足高精度的交互式开发需求。
3. 自由端口绑定与局域网服务调试障碍
在本地开发 Web 服务(如 FastAPI、Django、Flask)或基于 Socket 的自定义网络协议时,本地环境可以任意监听 127.0.0.1:8000 或局域网广播地址,手机与局域网内其他设备可以直接连接联调。在线环境中,容器处于多层 NAT 与反向代理之后,外部无法直接访问其私有端口,开发者必须额外配置第三方内网穿透工具,不仅配置繁琐,且受制于传输带宽与连接稳定性。
三、调试排错深度与大型工程化支持的代差
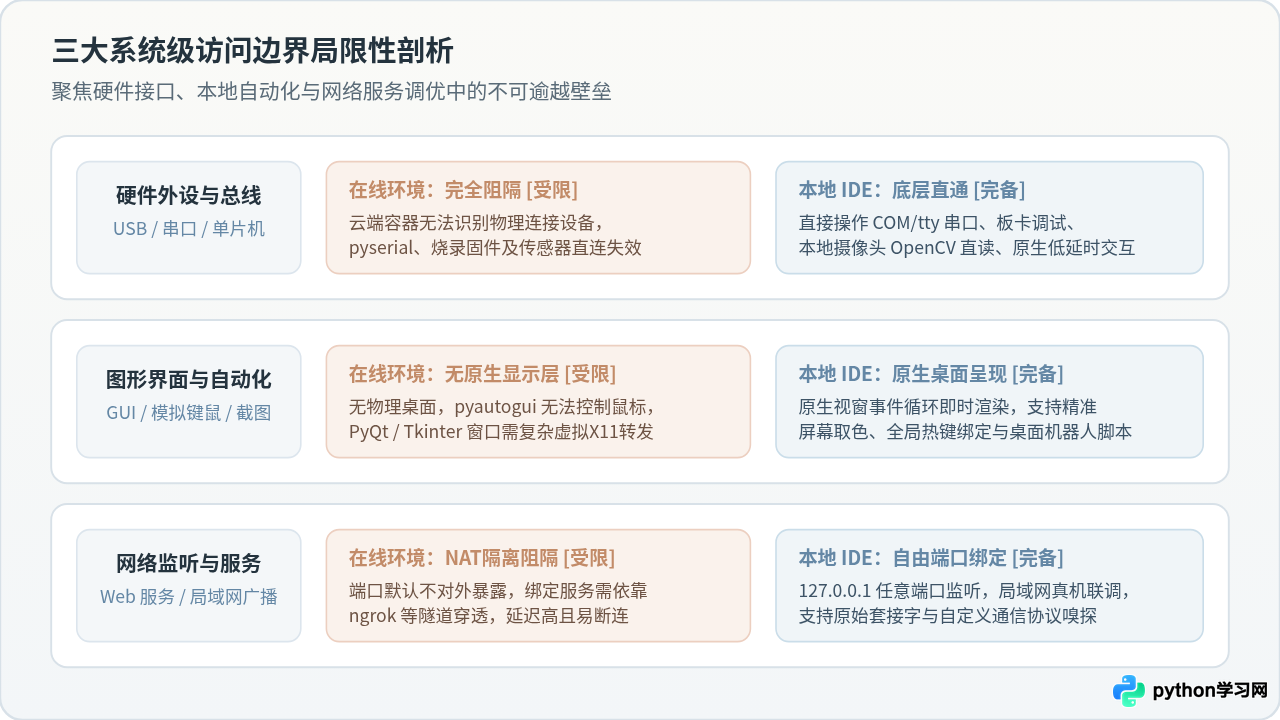
代码规模一旦从单文件几十行脚本增长到数万行、跨越数十个子模块的工程项目,开发体验的核心就从“编写代码”转变为“组织代码”与“排错定位”。在此阶段,在线环境与本地 IDE 呈现出显著的工具链代差。
1. 交互式断点与深层内存堆栈观测
在线 Notebook 普遍依赖 print() 逐段输出,或使用命令行式的简易 pdb。而在复杂的异步并发、多线程任务或大型框架调用中,本地 IDE 提供了全功能的图形化调试器:
- 条件断点与命中计数:仅在变量满足特定边界条件或循环执行到指定次数时中断执行,避免手动打印数万行日志。
- 调用栈回溯(Call Stack):在异常抛出瞬间,自由上下跳转查看每一层函数调用上下文中的局部与全局变量状态。
- 内存对象实时监视(Watch Window):直接展开复杂嵌套字典、自定义对象树,并在断点悬停时就地评估表达式。
2. 多文件包管理与大规模重构能力
在线环境大多以单个 .ipynb 文件为中心。当尝试构建包含 __init__.py 的标准 Python 包、组织分层的 services/、models/、utils/ 目录结构时,在线环境往往缺少准确的跨文件符号索引、函数调用层次查找(Call Hierarchy)以及全局重命名安全重构。而在 PyCharm 或配有 Pylance 的 VS Code 中,修改一个类名或函数签名即可自动同步更新整个工程的所有引用,并给出静态类型检查(Mypy/Pyright)告警。
四、离线可用性与数据隐私合规边界
除了功能与性能,开发载体的安全合规性往往是商业项目与敏感科研中不可忽视的底线问题:
- 零网络状态下的完全离线工作:在高铁、航班、野外勘探或涉密内网等无网弱网环境下,在线环境完全不可用;本地 IDE 配合本地已安装的虚拟环境,可以在脱网状态下毫无阻碍地进行编码、运行、单元测试与日志分析。
- 企业核心资产与数据合规风险:在线环境要求将源码、训练数据集、数据库密钥或业务日志上传至第三方云服务商。对于医疗健康数据、金融核心代码、军工与涉密企业系统,这种数据外流行为往往直接违反数据安全合规要求。本地环境则允许所有代码和敏感资产完全留存在企业内部私有设备或离线局域网中。
五、突破局限:从在线原型向本地 IDE 迁移的标准化操作步骤
当一个算法或功能在在线环境中完成轻量可行性验证后,规范的工程实践应当尽快将其迁移至本地开发环境。以下是标准化的四步迁移实施路径:
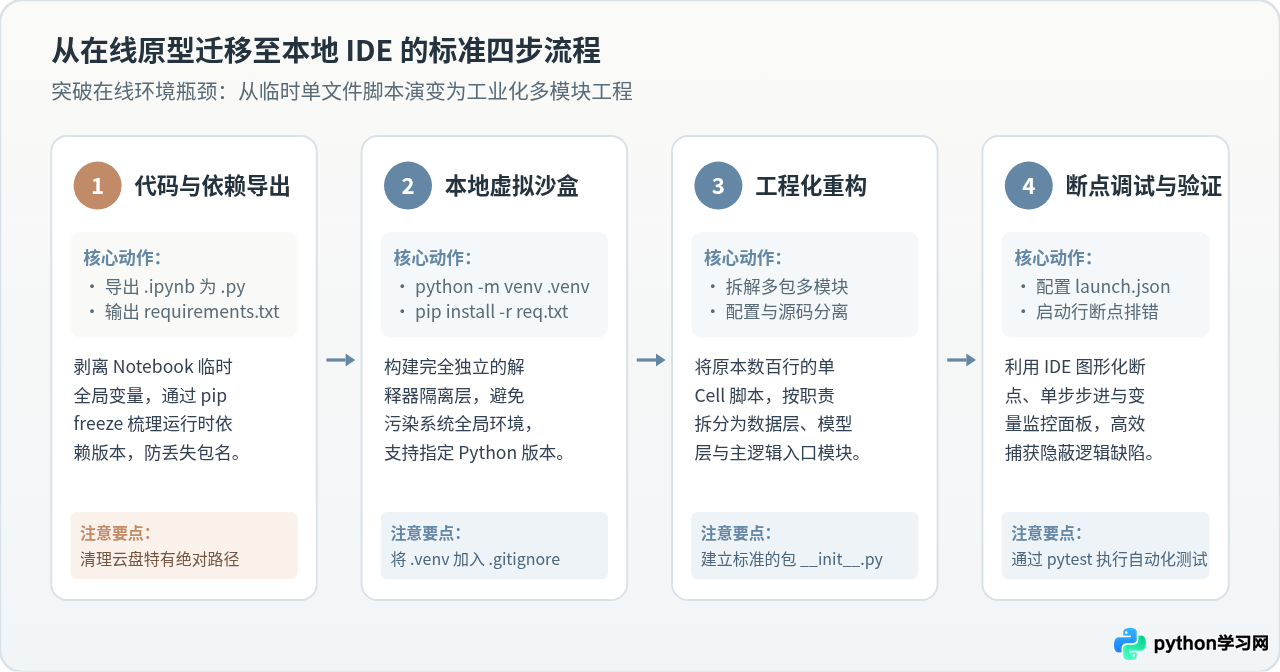
步骤 1:导出代码与清理云端依赖
在在线 Notebook 界面中,选择 File -> Download -> Download .py 将代码导出为纯 Python 脚本,或者使用命令行提取当前会话的精确包版本:
# 在在线环境终端执行,提取当前环境精确包版本
pip freeze > requirements.txt注意:导出的代码中通常混杂有在线环境特有的魔法命令(如 !pip install、%matplotlib inline)或类似 /content/drive/My Drive 的绝对路径,必须清理或重构为标准相对路径。
步骤 2:构建本地独立虚拟环境
在本地终端打开项目工作区目录,创建专属的隔离虚拟环境,避免与系统全局 Python 包发生冲突:
# 创建隔离的虚拟环境
python3 -m venv .venv

# 激活虚拟环境 (macOS/Linux)
source .venv/bin/activate
# Windows 命令提示符使用: .venv\Scripts\activate.bat

# 安装依赖清单
pip install --upgrade pip
pip install -r requirements.txt
步骤 3:进行工程化分层重构
将单个庞大的 .py 脚本拆解为清晰的工程目录结构。例如:
my_project/
├── .venv/               # 本地独立解释器(已加入 .gitignore)
├── config/              # 运行参数与环境配置
│   └── settings.py
├── src/                 # 核心业务逻辑
│   ├── __init__.py
│   ├── data_loader.py   # 数据加载与预处理
│   └── processor.py     # 核心计算模块
├── tests/               # 自动化单元测试
│   └── test_processor.py
├── main.py              # 统一主入口
└── requirements.txt     # 依赖声明清单
步骤 4:配置 IDE 断点调试与运行验证
以 VS Code 为例,在项目根目录下创建 .vscode/launch.json 文件,指定使用当前虚拟环境的解释器进行断点调试:
{
  "version": "0.2.0",
  "configurations": [
    {
      "name": "Python: 当前模块单步调试",
      "type": "debugpy",
      "request": "launch",
      "program": "${workspaceFolder}/main.py",
      "console": "integratedTerminal",
      "justMyCode": true
    }
  ]
}
在 main.py 的关键执行函数行号左侧单击打上红点(断点),按 F5 启动调试。程序运行到断点处将即时挂起,左侧面板将实时呈现调用堆栈、局部变量内存树与监视列表,至此完成了向本地专业开发体系的完整跃升。
六、选型决策指南与适用边界
在线运行环境与本地 IDE 并非替代关系,而是分工互补的工具。理性的选型应基于项目的生命周期、外部交互需求与安全级别来综合裁决:
| 决策维度 | Python 在线运行环境 | 本地专业 IDE |
|---|---|---|
| 配置成本 | 零门槛,浏览器即开即用,无需配置 Python 解释器与编译器 | 需要本地下载安装解释器、配置环境变量与编辑器插件 |
| 调试能力 | 单元格输出、print 打印、轻量 pdb | 条件断点、多线程监控、调用堆栈回溯、实时内存表达式计算 |
| 底层硬件 | 完全隔离,无法访问 USB/串口、本地摄像头、物理显示器 | 原生驱动直通,支持串口通信、单片机调试与 GUI 事件循环 |
| 持续运行 | 受限制,存在会话闲置断开机制,不适合常驻后台守护服务 | 无时间限制,原生守护进程持久常驻,断网持续运行 |
| 工程规模 | 适合单文件快速验证与几十至几百行的轻量代码片段 | 适合多包、多模块的大型仓库,具备全工程符号重构与 Git 流水线 |
| 数据安全 | 代码与数据需托管上传至云端公有基础设施,存在合规限制 | 代码与敏感数据纯本地离线留存,满足企业严格保密要求 |
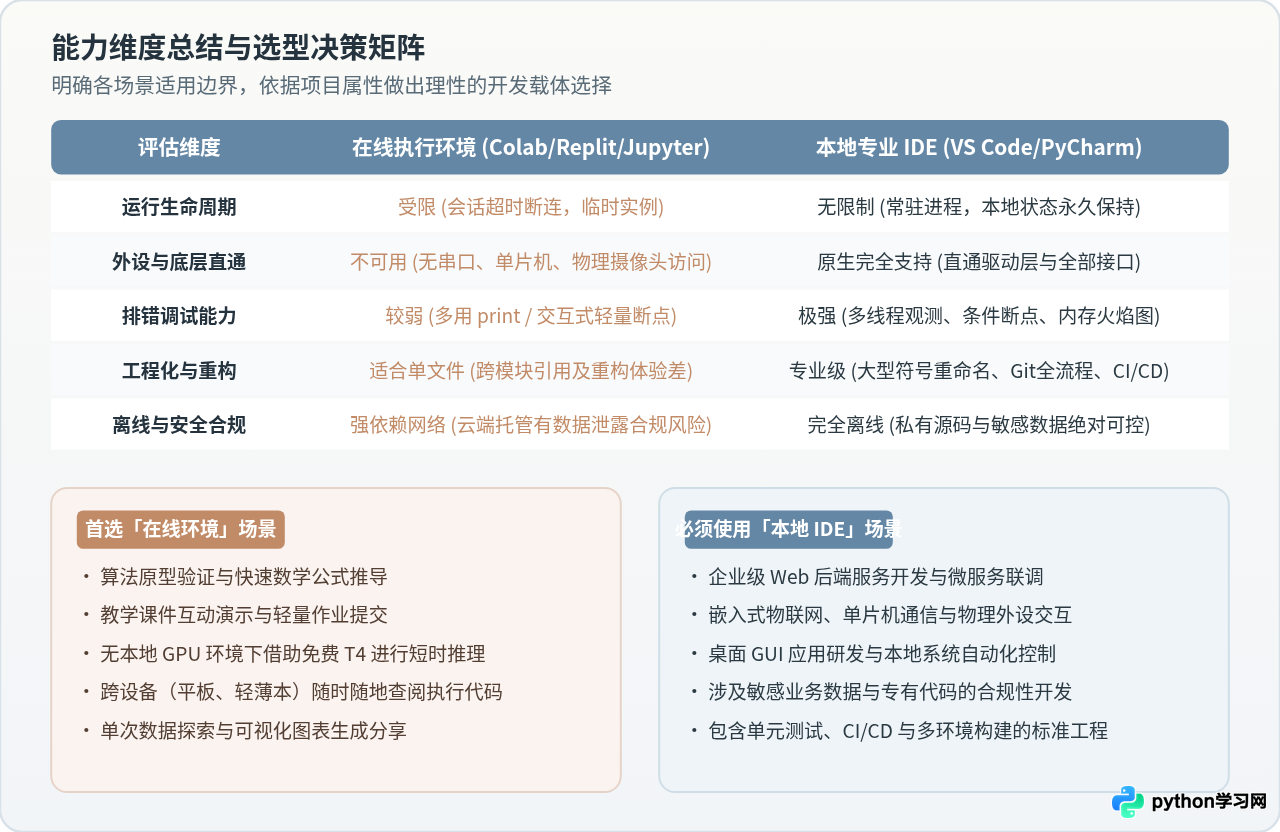
总结
Python 在线环境将环境配置与跨设备协作的摩擦成本降至最低,非常适合探索性数据分析、深度学习公开算法复现、教学演示以及随时随地的轻量尝试。但当面对真实的工业级软件交付——例如复杂的桌面 GUI、嵌入式硬件交互、长周期后台服务、精密单步排错与敏感数据保护时,本地 IDE 凭借其底层直通、全栈工具链支持与绝对掌控力,依然是专业开发者不可替代的坚固基石。在实际工作中,善用在线环境的“轻与快”做原型验证,借助本地 IDE 的“深与稳”做工程交付,才是最高效的研发工作流。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









