

Python自动化脚本代码示例:批量重命名与Excel读取
提供实用的Python自动化脚本示例,讲解使用pathlib进行安全批量文件重命名与使用openpyxl读取Excel数据的实现逻辑、异常处理及联合实战。
在日常办公与数据整理过程中,手动逐个修改文件名称和逐行翻阅表格记录不仅耗时费力,而且极易出现遗漏或格式不统一的错误。本文通过两段轻量级且具备工业健壮性的 Python 脚本,分别解决“按规范批量安全重命名文件”与“高效读取并解析 Excel 数据”两大核心任务,并在最后展示如何将两者结合实现“按表格清单自动批量重命名”,帮助读者掌握从文件系统操作到结构化数据处理的自动化核心技能。
一、自动化架构与核心模块分工
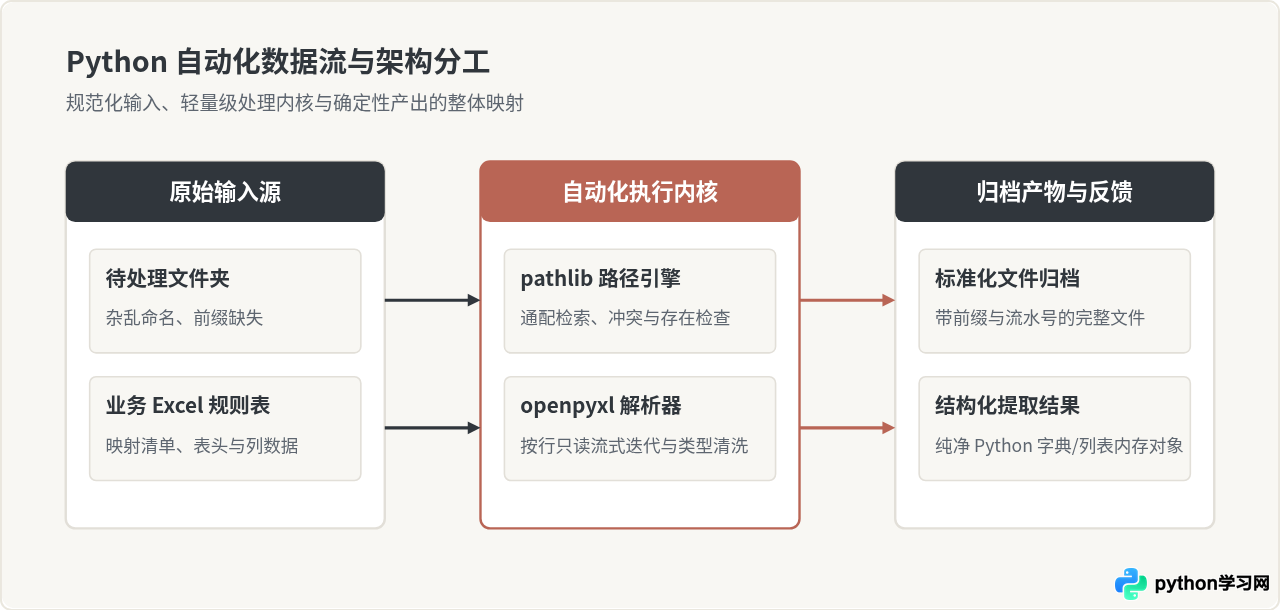
在设计自动化脚本时,合理选择工具库能够大幅降低开发复杂度并提高跨平台稳定性。对于本地文件操作,推荐使用 Python 3 标准库中的 pathlib 模块,它以面向对象的方式抽象路径,天然兼容 Windows 的反斜杠与 macOS/Linux 的正斜杠,免去了拼接字符串容易漏掉分隔符的隐患。对于表格读取,推荐选用纯 Python 编写的 openpyxl 库,它专用于读写现代 .xlsx 文件,不需要安装庞大的数据科学依赖,执行速度快且内存开销轻量。
二、任务一:使用 pathlib 实现安全批量重命名
编写批量重命名脚本时,核心风险不在于“如何改名”,而在于“如何避免误操作”。例如,如果目标文件名已经存在,直接重命名会在无提示的情况下覆盖原有文件导致数据丢失。此外,不同操作系统的扩展名大小写(如 .PNG 与 .png)以及隐藏文件也是常见干扰源。
以下代码展示了一个工业级重命名脚本。它通过设定格式模板,自动扫描指定目录中指定扩展名的文件,并在执行真正的改名动作前严格检测目标文件是否存在,确保操作的原子性与安全性:
from pathlib import Path

def batch_rename_files(directory_path: str, pattern: str, prefix: str, dry_run: bool = True) -> int:
    """
    批量规范重命名指定目录下的文件
    :param directory_path: 目标文件夹路径
    :param pattern: 文件匹配通配符,例如 "*.txt" 或 "*.jpg"
    :param prefix: 新文件名前缀
    :param dry_run: 是否为预演模式(True 时仅打印改名计划,不真正写盘)
    :return: 成功处理的文件数量
    """
    target_dir = Path(directory_path)
    if not target_dir.exists() or not target_dir.is_dir():
        print(f"[错误] 目标目录不存在或非文件夹: {target_dir}")
        return 0

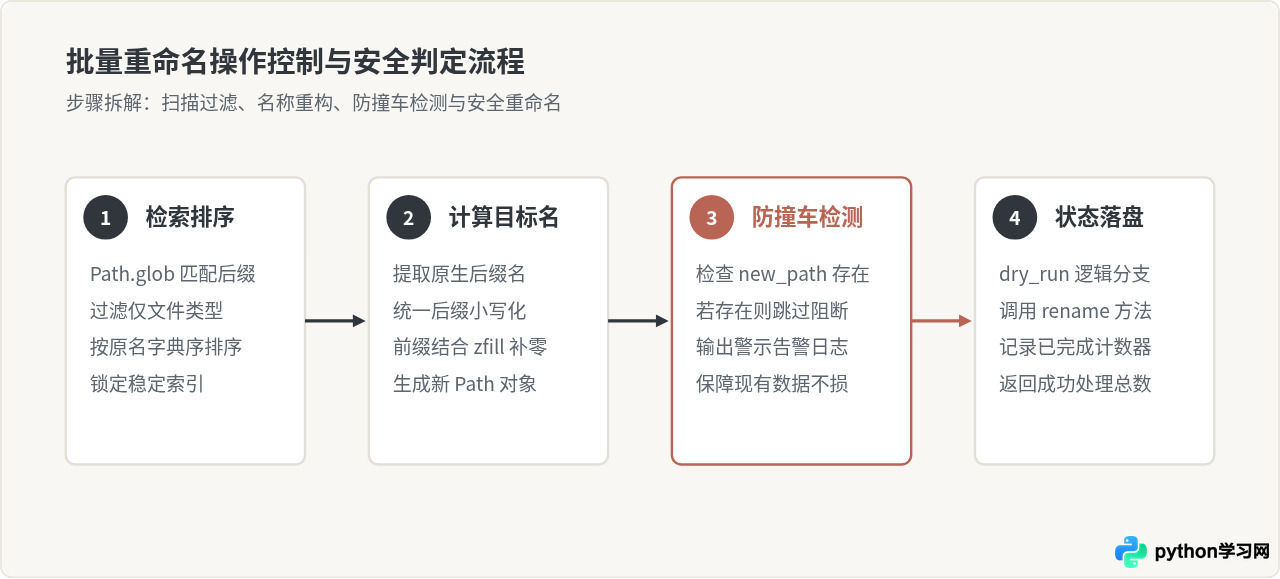
    # 检索匹配项并按原始名称字母排序,保证流水号稳定性
    matched_files = sorted([f for f in target_dir.glob(pattern) if f.is_file()])
    if not matched_files:
        print(f"[提示] 未找到匹配 '{pattern}' 的文件")
        return 0

    processed_count = 0
    total_digits = len(str(len(matched_files)))  # 动态计算序号补零位数

    print(f"--- {'[预演模拟]' if dry_run else '[正式执行]'} 批量重命名开始 ---")
    for index, file_path in enumerate(matched_files, start=1):
        # 保持原后缀不变,拼接格式化序号
        extension = file_path.suffix.lower()
        new_name = f"{prefix}_{str(index).zfill(max(3, total_digits))}{extension}"
        new_path = file_path.with_name(new_name)

        if new_path == file_path:
            print(f"[跳过] 名称已符合要求: {file_path.name}")
            continue

        if new_path.exists():
            print(f"[警告] 目标文件已存在,跳过防覆盖: {new_name}")
            continue

        if dry_run:
            print(f"[预演] {file_path.name} -> {new_name}")
        else:
            file_path.rename(new_path)
            print(f"[成功] {file_path.name} -> {new_name}")
        processed_count += 1

    print(f"--- 处理完成,共处理 {processed_count} 个文件 ---")
    return processed_count

if __name__ == "__main__":
    # 执行前建议先使用 dry_run=True 查看改名日志,核对无误后再切换为 False
    batch_rename_files(directory_path="./data_folder", pattern="*.png", prefix="report_img", dry_run=True)
三、任务二:读取并提取 Excel 表格关键数据
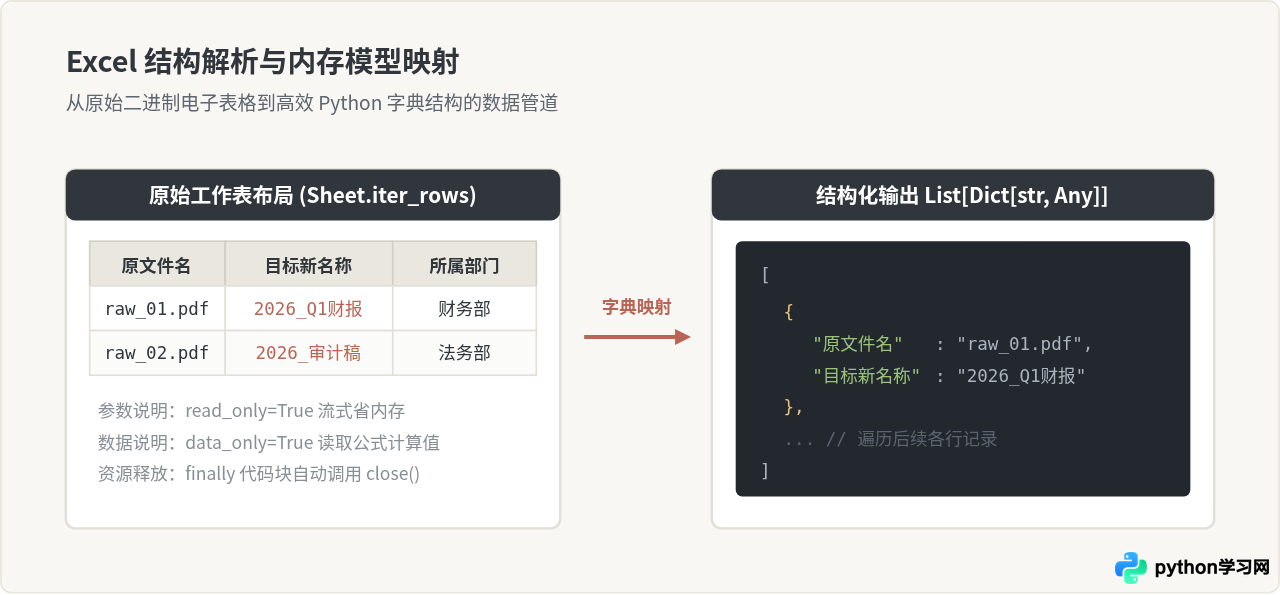
Excel 读取最常见的需求是将表头作为字典键(Key),将每行对应数据封装为字典,最终输出一个易于后续遍历和检索的字典列表。在处理 Excel 时,有两个关键细节直接决定脚本能否稳定运行:
- 只读模式开启:调用
load_workbook(filename, read_only=True)时,openpyxl 会以流式读取而不将全量单元格样式与复杂对象加载进内存,无论文件几百行还是几十万行都能保持极低内存占用。 - 空行与公式值处理:调用参数
data_only=True保证读取到的为公式计算后的实际值而非原始公式字符串(例如读取到计算出的数值而不是=SUM(A1:A10)),并剔除整行全为None的多余空行。
from pathlib import Path
from typing import List, Dict, Any
from openpyxl import load_workbook

def read_excel_records(excel_path: str, sheet_name: str = None) -> List[Dict[str, Any]]:
    """
    轻量且安全地读取 Excel 数据,以表头为键封装为字典列表返回
    :param excel_path: Excel 文件路径 (.xlsx)
    :param sheet_name: 目标工作表名称,若为 None 则默认读取首个活动工作表
    :return: 包含每行数据的字典列表
    """
    file_path = Path(excel_path)
    if not file_path.exists():
        raise FileNotFoundError(f"找不到指定的 Excel 文件: {file_path}")

    # read_only=True 启用流式加载节约内存,data_only=True 提取计算后真实值
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)

    try:
        sheet = wb[sheet_name] if sheet_name else wb.active
        rows_iterator = sheet.iter_rows(values_only=True)

        # 1. 提取首行作为表头
        header_row = next(rows_iterator, None)
        if not header_row:
            return []

        # 净化表头:转为去除前后空格的纯文本,忽略尾部无意义的空列
        headers = [str(col).strip() if col is not None else f"col_{idx}"
                   for idx, col in enumerate(header_row)]

        records: List[Dict[str, Any]] = []

        # 2. 逐行提取数据记录
        for row_idx, row in enumerate(rows_iterator, start=2):
            # 若整行全为 None,则视为表格结束或无效空行,直接跳过
            if all(cell is None for cell in row):
                continue

            # 将列头与对应单元格组合为字典
            row_dict = {}
            for col_idx, header in enumerate(headers):
                val = row[col_idx] if col_idx < len(row) else None
                # 清理字符串类型的头尾空白
                if isinstance(val, str):
                    val = val.strip()
                row_dict[header] = val

            records.append(row_dict)

        return records
    finally:
        # 在只读流式模式下必须显式关闭工作簿以释放系统文件句柄
        wb.close()

# 示例调用
if __name__ == "__main__":
    data = read_excel_records("sample_tasks.xlsx")
    print(f"成功读取 {len(data)} 条数据记录。")
    if data:
        print("第一条记录预览:", data[0])
四、进阶整合:基于 Excel 规则驱动的精准批量重命名
当业务规则较为复杂时(例如根据员工姓名、工号、日期等多维度字段定义文件名),单纯依靠通配符自增序号已经无法满足需求。此时的最佳方案是将任务二读取出的 Excel 表格记录作为规则源,驱动任务一中的文件系统重命名。
以下示例展示了完整的协同流程:读取 Excel 提取“原文件名”与“新文件名”,在重命名时严格保留文件本身的文件类型后缀,并输出操作结果对账清单:
from pathlib import Path
from openpyxl import load_workbook

def rename_by_excel_map(folder_path: str, excel_file: str, old_col: str, new_col: str):
    """
    根据 Excel 文件中的对照关系,将指定目录下的文件批量重命名
    :param folder_path: 目标文件所在目录
    :param excel_file: 存储映射关系的 Excel 文件路径
    :param old_col: 对应旧文件名的列名
    :param new_col: 对应新文件名的列名
    """
    directory = Path(folder_path)
    wb = load_workbook(excel_file, read_only=True, data_only=True)
    sheet = wb.active
    rows = list(sheet.iter_rows(values_only=True))
    wb.close()

    if not rows:
        print("[错误] Excel 表格为空")
        return

    # 获取列索引映射
    header = [str(c).strip() if c else "" for c in rows[0]]
    if old_col not in header or new_col not in header:
        print(f"[错误] Excel 表头中未找到对应列: {old_col} 或 {new_col}")
        return

    old_idx = header.index(old_col)
    new_idx = header.index(new_col)

    success_count = 0
    fail_count = 0

    print("--- 开始依据 Excel 清单执行重命名 ---")
    for row in rows[1:]:
        raw_old = str(row[old_idx]).strip() if row[old_idx] is not None else ""
        raw_new = str(row[new_idx]).strip() if row[new_idx] is not None else ""

        if not raw_old or not raw_new:
            continue

        src_file = directory / raw_old
        if not src_file.exists():
            print(f"[未找到源文件] {raw_old} 不存在,跳过该项")
            fail_count += 1
            continue

        # 如果新文件名未包含扩展名,自动继承源文件扩展名
        dest_name = raw_new if Path(raw_new).suffix else f"{raw_new}{src_file.suffix}"
        dest_file = directory / dest_name

        if dest_file.exists() and dest_file != src_file:
            print(f"[目标重名跳过] 目标文件已存在: {dest_name}")
            fail_count += 1
            continue

        src_file.rename(dest_file)
        print(f"[完成] {raw_old} -> {dest_name}")
        success_count += 1

    print(f"--- 处理结束:成功 {success_count} 项,失败/跳过 {fail_count} 项 ---")
dest_name 生成逻辑中,代码主动检测了新名称是否自带扩展名。如果业务人员在 Excel 中只填入了纯标题(如 合同审查报告),脚本会自动拼接上源文件的后缀(如 .pdf 或 .docx),避免文件失去关联程序。
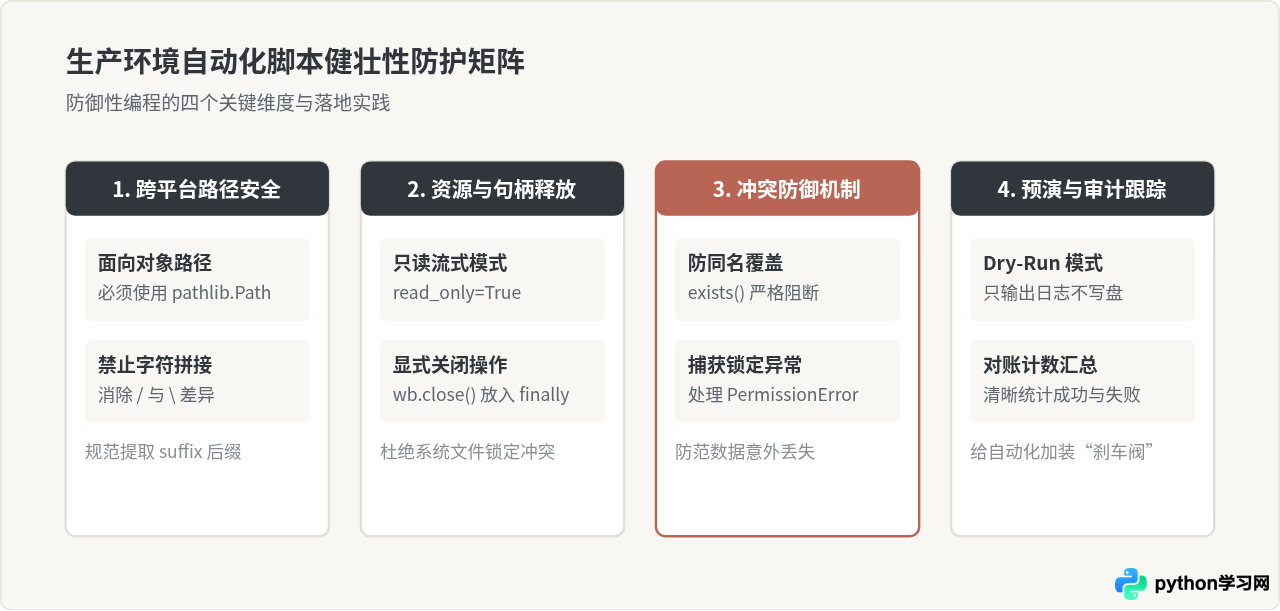
五、生产环境避坑指南与健壮性总结
在实际环境运行自动化脚本时,除了核心逻辑正确外,还需要防御各类操作系统级与应用级的异常:
- 文件占用锁定(PermissionError):在 Windows 系统上,如果某个 Excel 文件或目标文件正被 Microsoft Office 或 WPS 打开,操作系统会添加排他写锁,此时调用
rename()会抛出PermissionError。建议在执行脚本前关闭所有相关办公软件。 - 只读模式下的 close() 闭包:使用
openpyxl的read_only=True会建立底层文件流,必须在finally块中或者使用上下文管理器调用wb.close(),否则在后续循环中该文件将一直被当前 Python 进程占用。 - 预演机制(Dry-Run)的必要性:涉及文件系统批量变更时,不可逆的操作极易造成不可挽回的损失。务必遵循“先只打印不修改、人工肉眼校验前5条与后5条、最后切入写盘执行”的标准流程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









