

Python常用代码片段汇总:文件操作、字符串处理与日期计算

日常编写自动化脚本与后端逻辑时,频繁涉及的三项基本任务是磁盘文件的存取遍历、文本字符串的清洗提炼,以及各类时间戳与周期的计算。本文汇总了这三个方向上最常用、健壮性最高的高频代码模式,去除冗长铺垫,直击工业实践中的常见问题与标准写法。
一、文件操作:安全读写与路径遍历
文件处理的核心原则是两点:确保资源在任何异常状态下都能被显式释放,以及避免硬编码路径分隔符带来的跨平台兼容问题。现代 Python 编程中推荐使用标准库 pathlib 替代旧式的 os.path,它提供面向对象的路径控制,语义更为清晰。
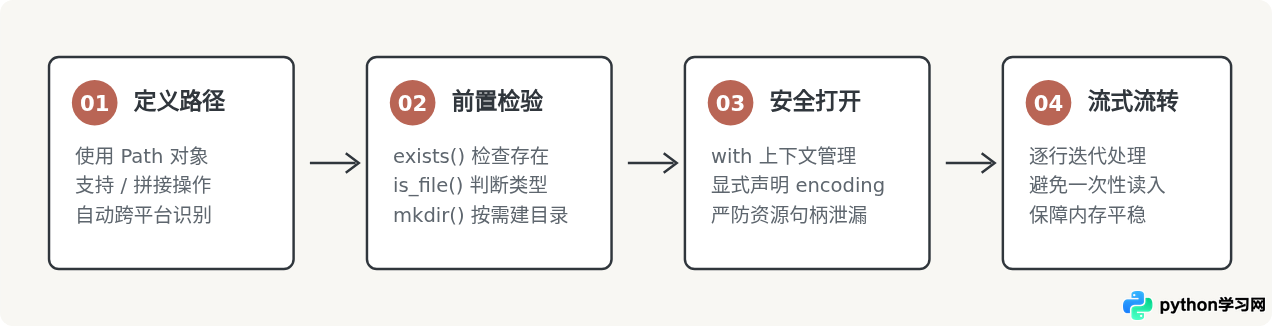
1. 稳健的文本读写(防止编码报错与句柄泄漏)
在 Windows 环境下,默认编码通常是本地代码页(如 GBK),若未声明编码,读取 UTF-8 格式的文件时会直接抛出 UnicodeDecodeError。因此,无论读写,务必指定 encoding="utf-8"。
from pathlib import Path

# 使用 pathlib 声明路径,自动适应各操作系统的斜杠格式
data_dir = Path("storage") / "logs"
data_dir.mkdir(parents=True, exist_ok=True)  # 若目录不存在则递归创建

file_path = data_dir / "app.log"

# 写入文件
lines_to_write = ["2026-03-24 INFO 系统初始化完成\n", "2026-03-24 WARN 内存占用偏高\n"]
with open(file_path, mode="w", encoding="utf-8") as f:
    f.writelines(lines_to_write)

# 逐行读取(流式读取,适合大文件,不占用过量内存)
with open(file_path, mode="r", encoding="utf-8") as f:
    for line in f:
        print(line.strip())
2. 递归遍历指定格式文件
获取某个目录及其所有子目录下特定扩展名的文件,推荐使用 rglob(),它比手写 os.walk() 更加直观。
from pathlib import Path

source_dir = Path("./docs")

# 递归匹配所有 .txt 结尾的文件
txt_files = list(source_dir.rglob("*.txt"))

for item in txt_files:
    # item 为 Path 对象,提供便捷的属性访问
    file_name = item.name          # 文件名(包含后缀)
    pure_stem = item.stem          # 文件名(不含后缀)
    file_size_kb = item.stat().st_size / 1024
    print(f"路径: {item} | 大小: {file_size_kb:.2f} KB")
open 函数中配置 errors="ignore" 或 errors="replace",避免整个遍历进程因单个字符编码错误而中断。
二、字符串处理:清洗、提取与格式化
处理文本数据时,单纯依靠原生 str 的方法无法应对复杂的变体输入,而过度依赖复杂的正则表达式又会导致维护困难。在实际业务中,我们通常采用“基础方法去杂质、正则匹配定格式、f-string输出结果”的组合架构。
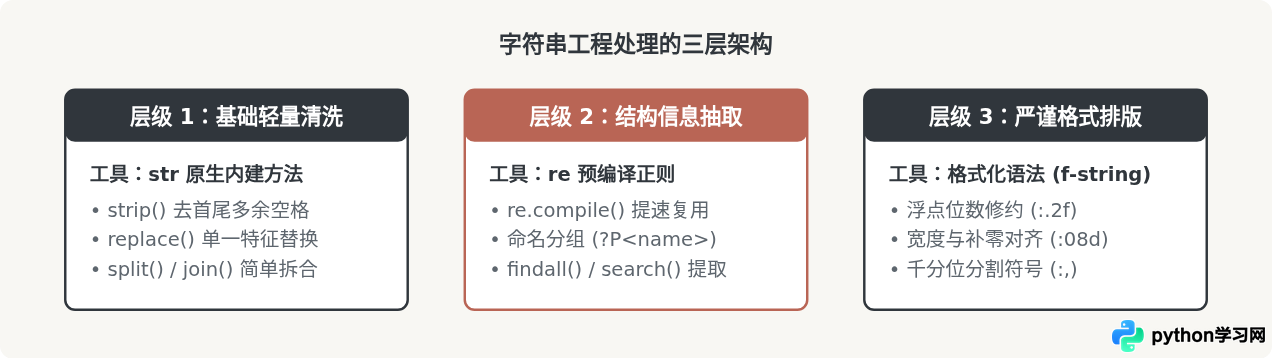
1. 复杂杂质文本的规范清洗
从外部网页或接口抓取的文本常包含连续不规则的空格、制表符及首尾脏数据,使用 str.split() 不传参数时,会自动将任意连续的空白字符(包括 \t、\n、全角/半角空格)统一按单个空格切分并剔除,这是最高效的空白清理手段。
dirty_text = "   用户:   张三 \t\t 状态: [有效]   \n  "

# 方案:清除不可见字符并重组
clean_text = " ".join(dirty_text.split())
print(clean_text)
# 示例输出:用户: 张三 状态: [有效]
2. 结构化信息的高效提取(正则表达式预编译)
在循环中直接使用 re.search() 会导致重复解析模式串。正确做法是使用 re.compile() 生成正则对象,利用“命名捕获组”提取字段,既提升执行效率,又避免依据数组下标取值带来的逻辑混乱。
import re

log_row = "ERROR 2026-03-24 14:32:01 [Server-Node-01] Connection timeout"

# 使用 (?P<组名>表达式) 显式赋予提取字段语义
pattern = re.compile(
    r"^(?P<level>[A-Z]+)\s+"
    r"(?P<timestamp>\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2})\s+"
    r"\[(?P<node>[^\]]+)\]\s+"
    r"(?P<msg>.*)$"
)

match = pattern.search(log_row)
if match:
    data = match.groupdict()
    print(f"日志级别: {data['level']}")
    print(f"记录节点: {data['node']}")
    print(f"错误内容: {data['msg']}")
3. 字符串与序列的批量格式化输出
Python 3.6+ 引入的 f-string 不仅可用于变量插值,还支持强大的格式化控制协议:
val = 1234567.891
uid = 42

# 格式说明:
# :, 表示千分位分隔
# .2f 表示保留两位小数
# 06d 表示总宽6位,不足在左侧补0
report = f"ID: {uid:06d} | 交易额: {val:,.2f} 元"
print(report)
# 示例输出:ID: 000042 | 交易额: 1,234,567.89 元
三、日期计算:解析、推移与时区处理
Python 标准库的 datetime 模块涵盖了常规需求。在日常开发中,主要工作流围绕三种形式转换:字符串、datetime 对象 以及 Unix 时间戳(秒级浮点数)。理解这三者之间的拓扑关系,能够避免绝大多数逻辑混乱。
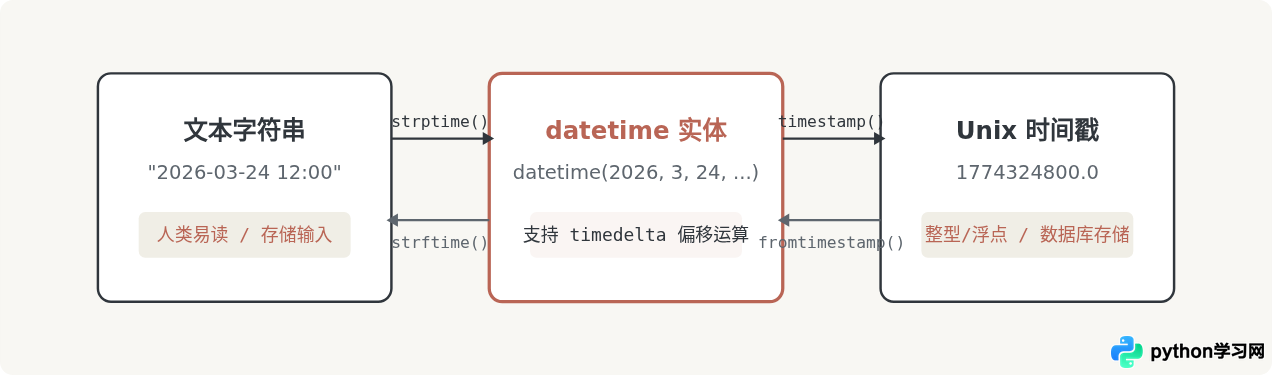
1. 字符串与日期的双向互转
解析输入字符串为时间对象用 strptime(p 代表 parse),将时间对象格式化输出用 strftime(f 代表 format)。
from datetime import datetime

date_str = "2026-03-24 15:30:00"
fmt = "%Y-%m-%d %H:%M:%S"

# 1. 字符串 -> datetime 对象
dt_obj = datetime.strptime(date_str, fmt)

# 2. datetime 对象 -> 结构化自定义输出
clean_display = dt_obj.strftime("%Y年%m月%d日")
print(clean_display)
# 示例输出:2026年03月24日

# 3. datetime 对象 -> Unix 时间戳 (秒)
ts = dt_obj.timestamp()
print(ts)
# 示例输出:1774337400.0
2. 时间间隔推移与差异计算
计算历史时间、未来截止日或两个时间节点相隔的具体天数、秒数,使用 timedelta。注意:timedelta 最大支持单位为“周(weeks)”和“天(days)”,不能直接设置 months 或 years,因为月和年的天数并不恒定。
from datetime import datetime, timedelta

now = datetime.now()

# 往后推移 3 天 4 小时
target_future = now + timedelta(days=3, hours=4)

# 计算两个日期相隔差距
past_date = datetime(2026, 1, 1, 0, 0, 0)
difference = now - past_date

print(f"相隔总天数: {difference.days} 天")
print(f"相隔总秒数: {difference.total_seconds():.0f} 秒")
3. 处理带有时区的标准时间(UTC 与本地时区)
在分布式系统与现代 API 交互中,应尽量避免使用没有时区概念的“天真对象(naive datetime)”。Python 3.9+ 提供了标准的 zoneinfo 模块:
from datetime import datetime, timezone
from zoneinfo import ZoneInfo

# 获取当前带 UTC 时区的感知对象
utc_now = datetime.now(timezone.utc)

# 转换为亚洲上海时区 (UTC+8)
shanghai_tz = ZoneInfo("Asia/Shanghai")
local_now = utc_now.astimezone(shanghai_tz)

print(f"UTC 时间:   {utc_now.isoformat()}")
print(f"本地时间:   {local_now.isoformat()}")
# 示例输出包含时区偏移标识:2026-03-24T...:...+08:00
四、核心模式速查与常见避坑要点
为了在实际编码过程中快速建立检查清单,下表梳理了三项任务中最容易被忽略的操作边界:
| 场景分类 | 推荐实践 | 常见隐患与反例 |
|---|---|---|
| 文件操作 | 优先选用 pathlib.Path,所有文本读写强制标明 encoding="utf-8"。 |
使用字符串通过 + "\\" 拼接路径;忽略 with 导致并发下打开文件过多(Too many open files)。 |
| 字符串处理 | 多变空白用 " ".join(s.split());多次复用的正则务必使用 re.compile()。 |
在巨量迭代循环中直接调用 re.findall() 导致模式重复编译;使用 + 进行超长循环字符串拼接。 |
| 日期计算 | 网络传输统一使用 ISO 格式或时间戳;跨时区业务显式指定 timezone.utc。 |
混用“有时区信息”与“无时区信息”的 datetime 对象直接进行加减运算(抛出 TypeError 异常)。 |
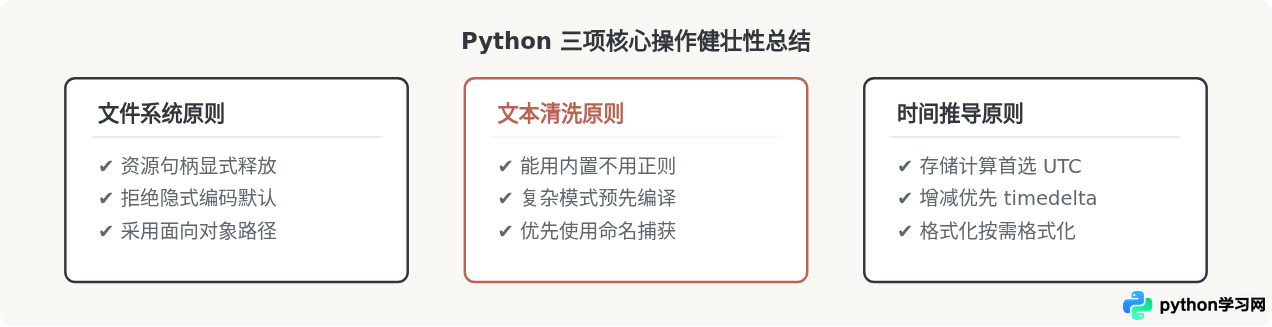
掌握以上这套标准片段与处理流程,足以覆盖日常数据清洗、接口开发以及定时批处理中绝大多数基础工作。在实际编写代码时,优先选用标准库提供的新特性能大幅精简代码量,同时减少平台兼容性缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









