

Python动态生成带日期或序号的文件名变量
详细讲解在Python中如何动态生成带日期时间或递增序号的文件名变量,涵盖f-string格式化、datetime模块、定长补零、防覆盖自增检测及跨平台路径管理。
在数据处理、日志采集与批处理任务中,固定文件名极易造成数据覆盖或历史版本丢失。动态生成文件名的核心方案是利用 Python 标准库中的 datetime 模块获取时间切片,或使用格式化填充符号 :04d 生成定长对齐序号,再结合 f-string 与 pathlib.Path 组装出语义清晰、不重名的文件路径变量。
一、动态文件名的结构解构与装配原理
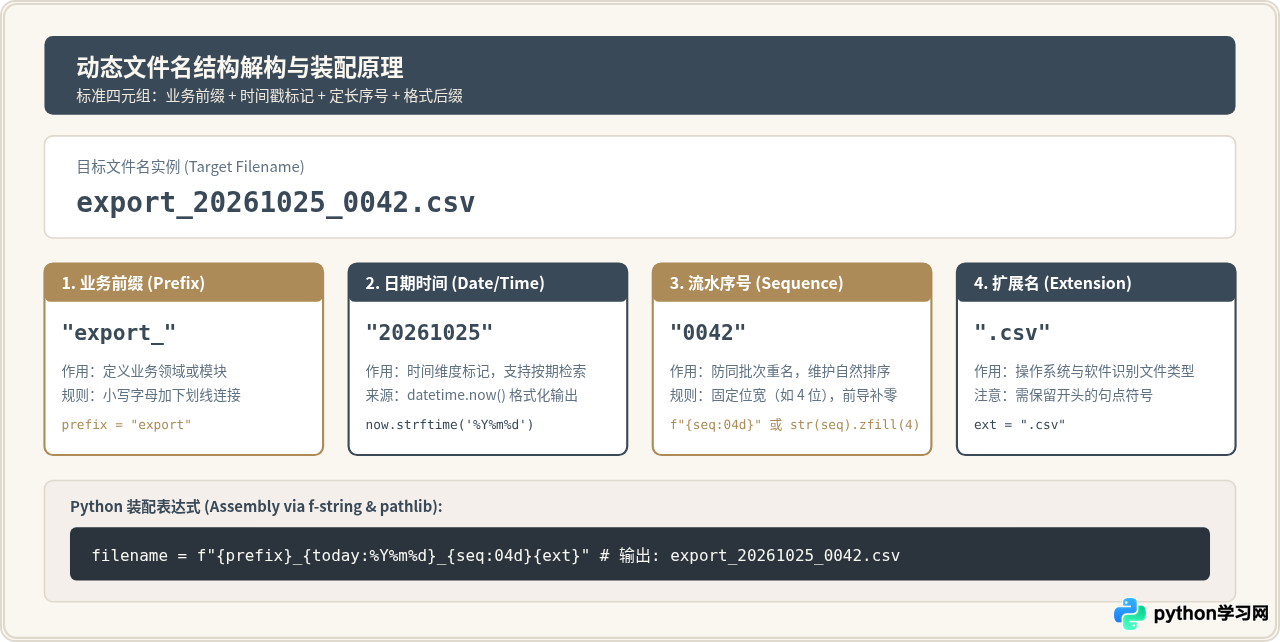
一个健壮的文件名通常由四个独立部分拼接而成:明确数据含义的业务前缀、体现时间维度的日期时间戳、保障批量导出顺序的流水序号,以及规范格式的扩展名。在 Python 中,硬编码字符串拼接不仅繁琐,还容易在缺少对齐符号时导致文件列表排序错乱。现代 Python 开发推荐直接使用 f-string(格式化字符串字面量)进行变量组装。
二、方案一:动态生成带日期的文件名变量
在生成按日或按秒归档的数据时,Python 的 datetime 标准库是最直接的工具。获取当前系统时间后,可以通过两种常见方式进行格式化:
- 使用
strftime()方法:通过格式指令将时间对象转换为指定格式的字符串。 - 在
f-string中内联格式化:直接在花括号内通过冒号引用时间格式符,写法更为紧凑。
常用时间占位符及其对应含义如下:
%Y:四位年份,例如2026%m:两位月份(01-12),例如10%d:两位日期(01-31),例如25%H:24小时制小时数(00-23)%M:两位分钟数(00-59)%S:两位秒数(00-59)
from datetime import datetime
from pathlib import Path

# 获取当前本地时间
now = datetime.now()

# 方式 1:利用 strftime 显式格式化
date_str = now.strftime("%Y%m%d")
filename_daily = f"report_{date_str}.csv"
# 结果示例: report_20261025.csv

# 方式 2:在 f-string 中直接内联格式化(精确到秒)
filename_exact = f"task_{now:%Y%m%d_%H%M%S}.log"
# 结果示例: task_20261025_183015.log

# 结合 pathlib 进行跨平台安全路径组装
output_dir = Path("output_data")
output_dir.mkdir(parents=True, exist_ok=True)
full_file_path = output_dir / filename_exact

print("生成的目标文件变量:", full_file_path)
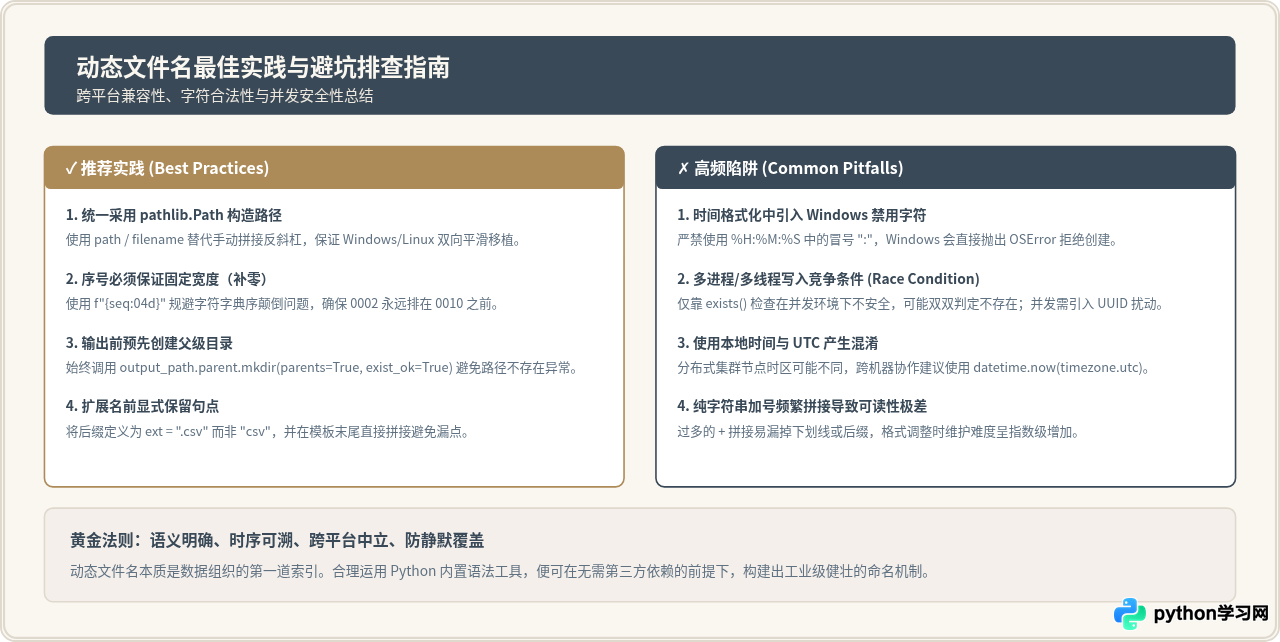
:)、斜杠(/、\)、问号(?)等特殊字符。因此在格式化时间戳时,切忌使用 %H:%M:%S,应当使用下划线或连字符代替,例如 %H%M%S 或 %H-%M-%S。
三、方案二:动态生成带序号的文件名变量
当批处理程序在同一时间生成多个切片文件,或者在循环中迭代输出时,递增序号是确保文件唯一性的关键手段。如果直接使用未经格式化的数字(如 file_1.txt、file_2.txt ... file_10.txt),在操作系统的文件浏览器中按文件名排序时,file_10.txt 会排在 file_2.txt 之前。
为解决排序错乱问题,必须采用前导零对齐(Zero-padding)。在 Python 中实现对齐有两种优雅的方式:
- f-string 格式说明符
:04d:表示数字最小宽度为 4 位,不足部分在左侧用0补齐。 - 字符串方法
str.zfill(width):将数字转为字符串后在左侧补充零。
# 循环生成定长对齐的文件名列表
base_name = "data_chunk"
extension = ".parquet"

generated_files = []
for index in range(1, 6):
    # 使用 :04d 格式化序号,得到 0001, 0002 等
    filename = f"{base_name}_{index:04d}{extension}"
    generated_files.append(filename)

# 打印生成的文件名
for name in generated_files:
    print(name)
# 输出:
# data_chunk_0001.parquet
# data_chunk_0002.parquet
# data_chunk_0003.parquet
# data_chunk_0004.parquet
# data_chunk_0005.parquet
四、关键实战:防覆盖的动态自增序号机制
在自动化脚本反复触发的场景中,若每次都从序号 1 开始,已存在的文件就会面临被静默覆盖的风险。此时需要引入存在性检测逻辑:在写入前检查目标文件是否存在,若已存在则自增序号,直至找到一个尚未被占用的文件名。
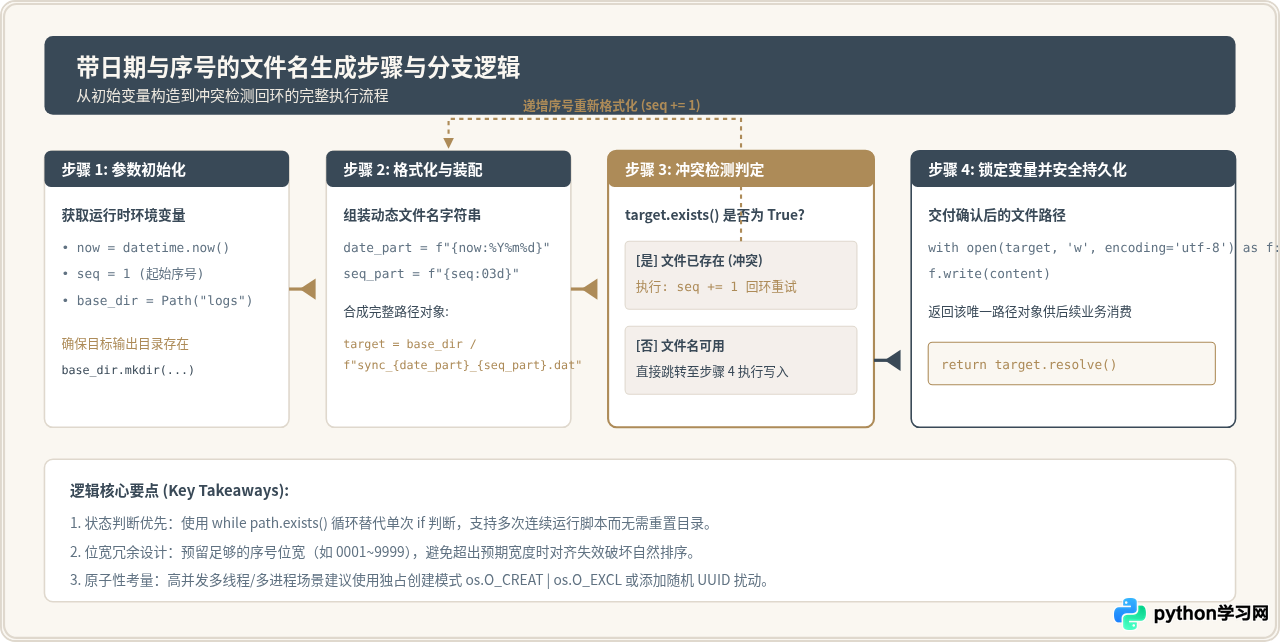
下面是一个封装好的实用函数,展示了如何同时融合“当天日期”与“自动防覆盖自增序号”:
from datetime import datetime
from pathlib import Path

def generate_unique_filepath(directory: str, prefix: str, ext: str) -> Path:
    """
    生成一个包含当前日期且序号自增的唯一文件路径对象。
    若目标文件已存在,则自动递增序号,直到获得可用路径。
    """
    dir_path = Path(directory)
    dir_path.mkdir(parents=True, exist_ok=True)

    date_str = datetime.now().strftime("%Y%m%d")
    seq = 1

    while True:
        # 组装格式如: backup_20261025_001.json
        candidate_name = f"{prefix}_{date_str}_{seq:03d}{ext}"
        candidate_path = dir_path / candidate_name

        if not candidate_path.exists():
            return candidate_path

        seq += 1

# 示例调用
target_file = generate_unique_filepath(
    directory="./exports",
    prefix="sales_data",
    ext=".json"
)

print("当前分配的可用文件路径:", target_file)
# 首次运行输出: exports/sales_data_20261025_001.json
# 若该文件已存在,二次运行自动输出: exports/sales_data_20261025_002.json
五、常见命名模式与应用场景对比
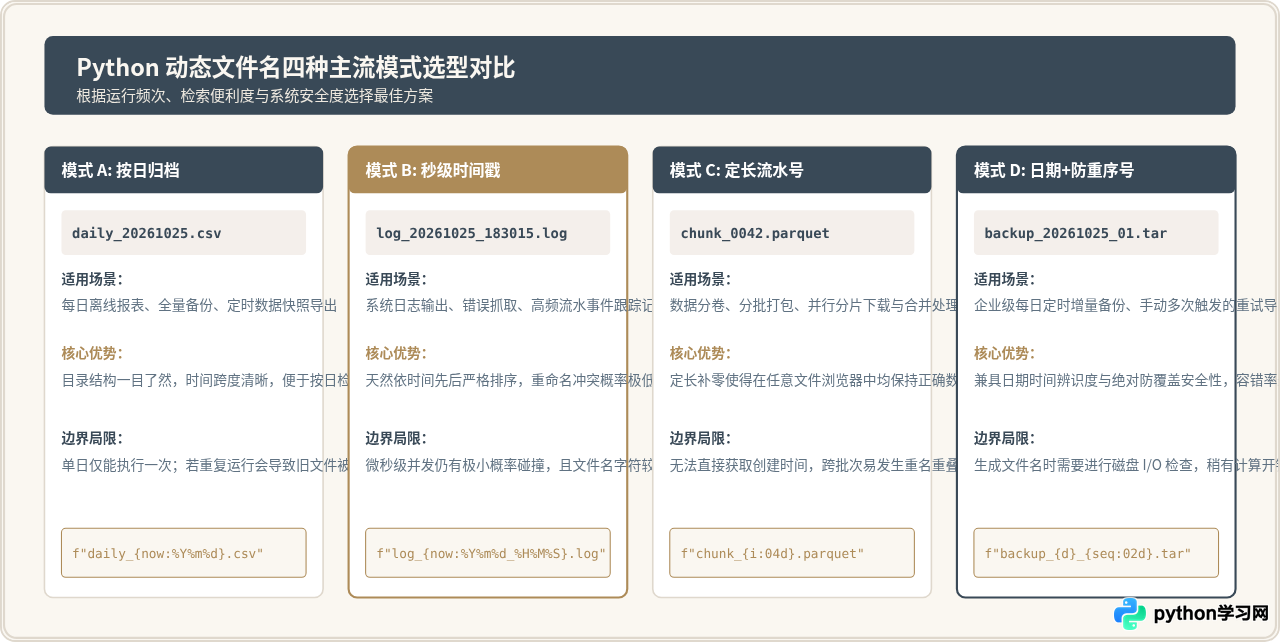
不同的业务场景对文件名的要求差异显著。例如离线日终统计关注归档日期的直观性,系统底层日志关注纳秒/秒级的严格时序,而分布式批量数据切片则强调序号规整。
六、防御性设计与避坑指南
动态生成文件名看似简单,但在真实生产运行环境中,容易因跨平台路径差异、操作系统保留字或多进程并发而产生隐蔽故障。遵循以下防御性规范能够确保代码在任何环境下均能稳定运行:
七、总结
在 Python 中动态生成带日期或序号的文件名变量,并不需要依赖复杂的外部库。核心总结为三句话:
- 时间戳需求:通过
datetime.now()配合%Y%m%d_%H%M%S格式,并在f-string中直接内嵌,避免冒号非法字符。 - 序号需求:始终为序号指定格式化宽度(如
{seq:04d}),保持字符序与数字序一致。 - 防重与路径安全:使用
pathlib.Path维护目录结构,并通过while path.exists(): seq += 1构造出天然防覆盖的闭环机制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









