

Scrapy框架入门:构建结构化Python爬虫项目的步骤
从零构建标准化Scrapy Python爬虫项目的完整实操指南,详解脚手架创建、Item建模、Spider编写、数据管道清洗与配置调优步骤。
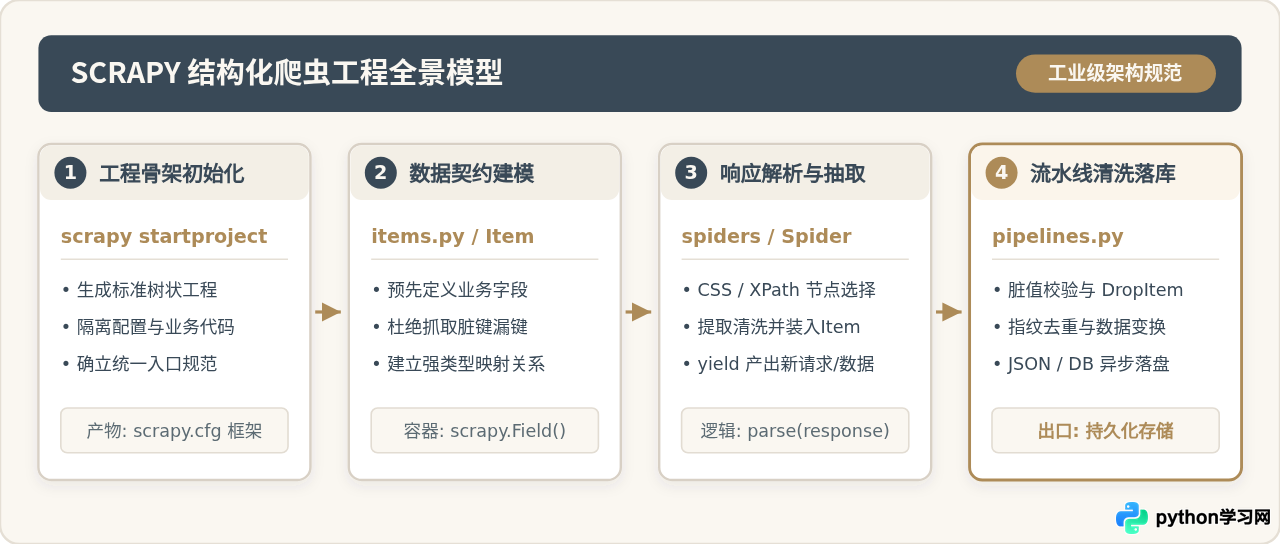
一、Scrapy 核心工作机制与工程目录解构
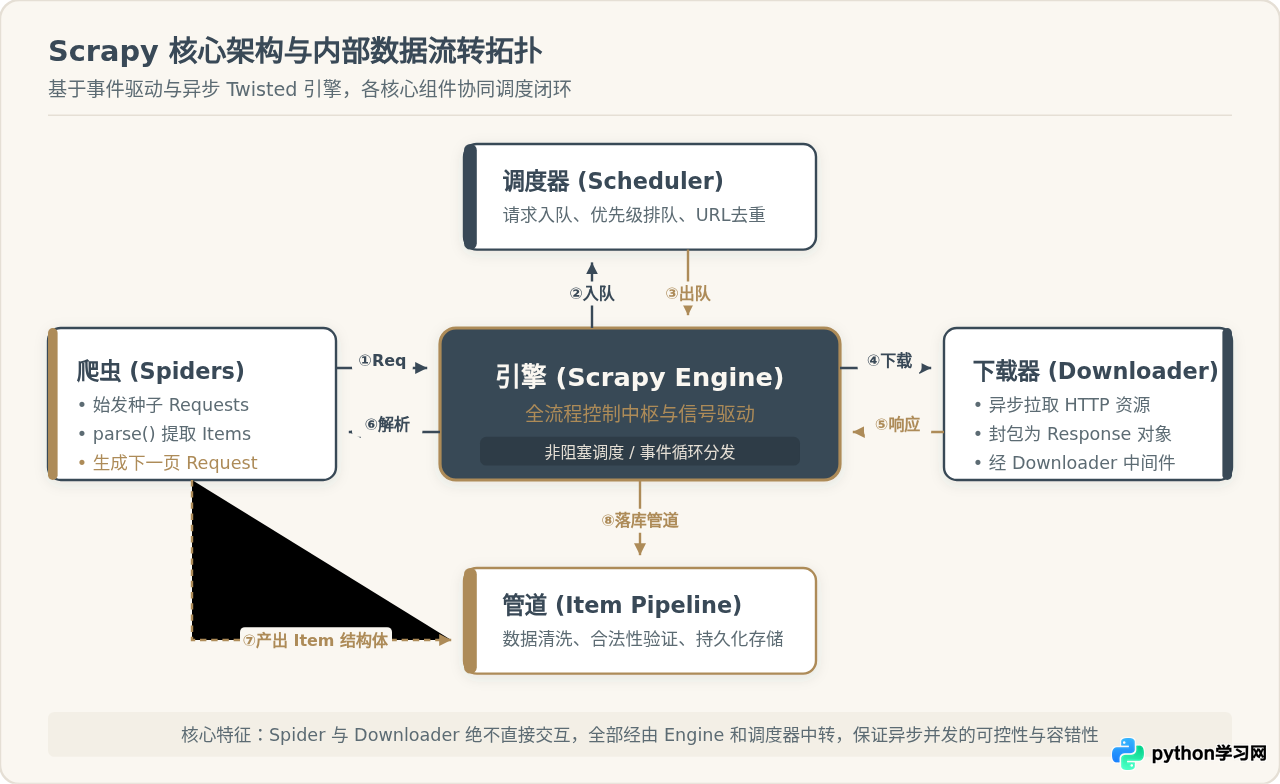
在直接运行命令行工具之前,必须清晰理解 Scrapy 内部组件的职责分工。许多新手将爬虫视为单个脚本循环发送 HTTP 请求,但在面对数万级网页抓取时,这种方式容易遇到网络阻塞、数据格式紊乱和去重困难等问题。Scrapy 采用 Twisted 异步网络库,所有请求以非阻塞方式在引擎内流转。
整个框架包含五个核心组件:引擎(Engine)负责控制各模块之间的数据信号调度;调度器(Scheduler)负责接收请求并按优先级排队与去重;下载器(Downloader)负责高效拉取网络响应;爬虫(Spider)负责编写页面解析规则并生成结构化数据;数据管道(Item Pipeline)负责后续的过滤、清洗与持久化落盘。
当执行工程创建命令后,Scrapy 会自动生成统一规范的文件目录树。理解这些文件的定位是编写模块化代码的前提:
| 文件 / 目录 | 核心职责 | 典型工作内容 |
|---|---|---|
scrapy.cfg |
项目配置文件 | 定义项目设置模块路径及 scrapyd 部署配置信息 |
items.py |
数据契约定义 | 声明目标抓取字段,类似于 ORM 实体类,规范输出格式 |
spiders/ |
爬虫逻辑目录 | 存放具体的 Spider 实现类,编写定位抽取规则与翻页逻辑 |
pipelines.py |
数据处理管道 | 接收爬虫产出的 Item,完成去重、数据类型转换与数据库写入 |
settings.py |
全局运行配置 | 配置并发数、下载延迟、请求头、激活的中间件与管道优先级 |
middlewares.py |
扩展中间件 | 定制下载器中间件(如动态代理、随机 UA)和爬虫中间件 |
二、构建结构化爬虫的标准操作流程
构建一个标准的 Scrapy 爬虫项目,通常遵循“环境搭建 → 初始化工程 → 定义数据模型 → 编写解析规则 → 管道清洗存储 → 运行与调试”六个严密的阶段。
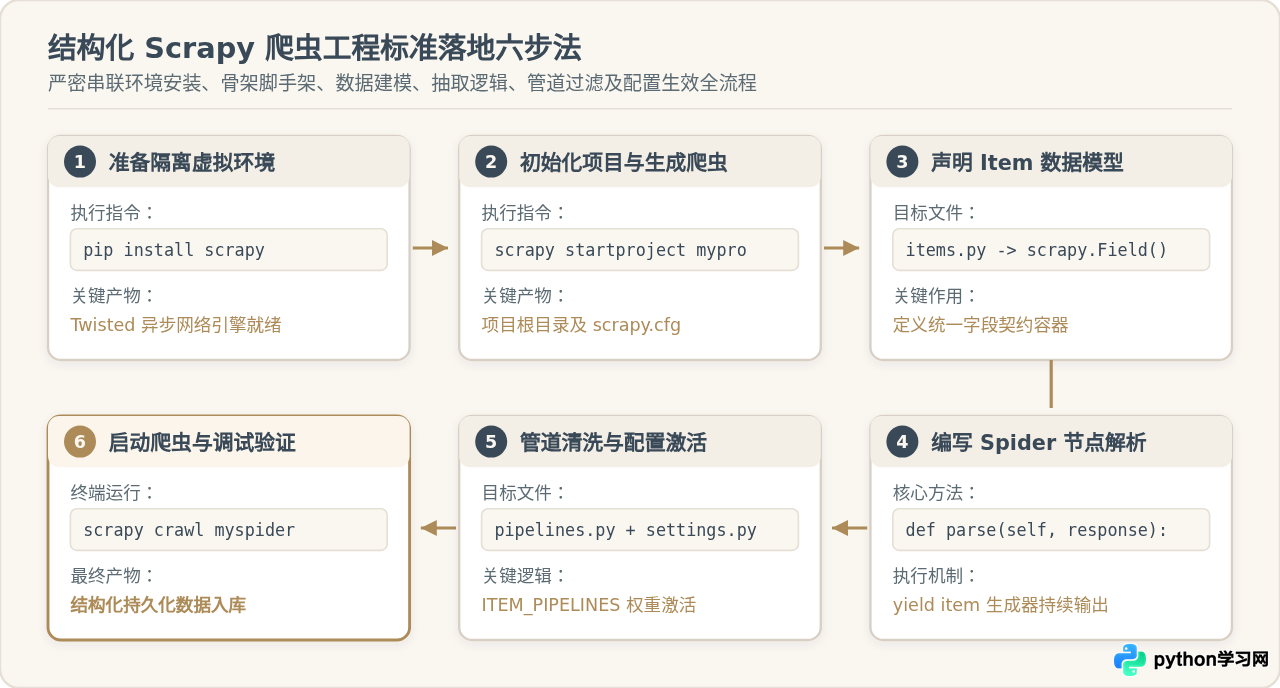
步骤 1:准备隔离虚拟环境并安装 Scrapy
Scrapy 依赖底层的 Twisted 异步引擎、Cryptography 安全库与 lxml 解析库。为避免全局 Python 环境版本冲突,应首先在终端中创建独立的虚拟环境:
# 1. 创建名为 venv-spider 的虚拟环境
python3 -m venv venv-spider

# 2. 激活虚拟环境 (macOS/Linux)
source venv-spider/bin/activate
# Windows 环境请使用: venv-spider\Scripts\activate

# 3. 安装 Scrapy
pip install scrapy
安装完成后,在终端执行 scrapy version。若正常输出如 Scrapy 2.x.x 的版本信息,即说明基础依赖均已正确就绪。
步骤 2:初始化工程骨架与生成 Spider 模板
在工作目录下执行 scrapy startproject 命令创建项目。以抓取图书网站示例数据为例,项目命名为 book_crawler:
# 创建项目骨架
scrapy startproject book_crawler

# 进入工程目录
cd book_crawler

# 利用 genspider 快速生成爬虫模板 (指定爬虫名与目标域名)
scrapy genspider books toscrape.com
此时 Scrapy 会在 book_crawler/spiders/ 目录下自动生成 books.py 代码文件,提供了标准的爬虫类骨架。
步骤 3:在 items.py 中定义结构化数据模型
传统单脚本爬虫经常使用无规则的 Python 字典存储数据,一旦字段名拼写错误(如 price 误写为 prcie)在运行时极难察觉。在 Scrapy 中,必须在 items.py 中显式声明数据字段,形成强类型的字段契约:
import scrapy

class BookItem(scrapy.Item):
    # 明确声明爬虫需要收集的业务字段
    title = scrapy.Field()       # 图书标题
    price = scrapy.Field()       # 价格文本
    rating = scrapy.Field()      # 评分等级
    stock = scrapy.Field()       # 库存状态
    url = scrapy.Field()         # 详情页URL
步骤 4:编写 Spider 数据提取逻辑与生成器
打开 book_crawler/spiders/books.py,编写页面节点的遍历与抽取代码。Scrapy 提供了 response.css() 与 response.xpath() 两套选择器引擎。在提取到每个数据单元后,实例化 BookItem 并通过 yield 返回:
import scrapy
from book_crawler.items import BookItem

class BooksSpider(scrapy.Spider):
    name = "books"
    allowed_domains = ["toscrape.com"]
    start_urls = ["http://books.toscrape.com/catalogue/page-1.html"]

    def parse(self, response):
        # 1. 遍历图书卡片列表
        cards = response.css("article.product_pod")
        for card in cards:
            item = BookItem()
            item["title"] = card.css("h3 a::attr(title)").get()
            item["price"] = card.css(".price_color::text").get()
            item["rating"] = card.css("p.star-rating::attr(class)").re_first(r"star-rating\s+(\w+)")
            item["stock"] = card.css(".instock.availability::text").getall()[-1].strip()
            item["url"] = response.urljoin(card.css("h3 a::attr(href)").get())

            # 将填充好的 Item 交给引擎进入管道
            yield item

        # 2. 自动捕获下一页链接并生成新请求
        next_page = response.css("li.next a::attr(href)").get()
        if next_page:
            next_url = response.urljoin(next_page)
            # 发起下一页请求并指定同一个解析方法
            yield scrapy.Request(url=next_url, callback=self.parse)
三、数据抽取到持久化的关键环节与管道实现
Spider 的职责仅限于从 HTML 中解析数据,它不应承担复杂的数据清洗、类型转换或数据库写操作。所有业务数据的净化与持久化均应在 Item Pipeline 中完成。
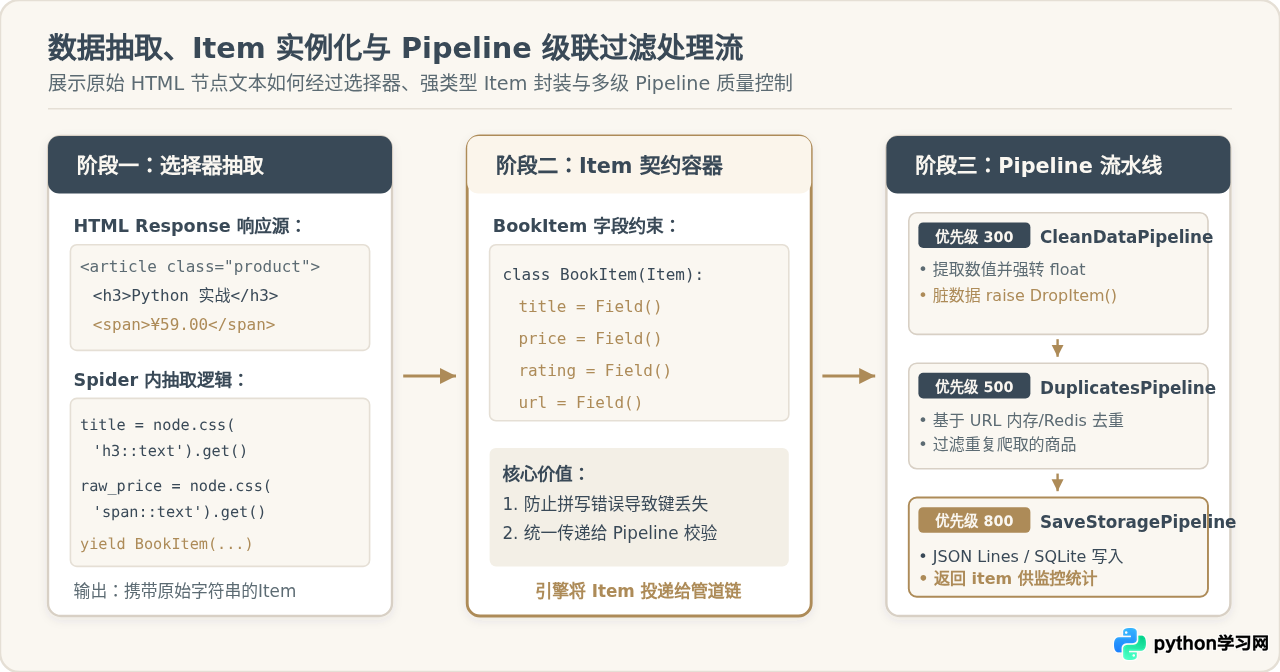
1. 编写清洗与校验 Pipeline
打开 book_crawler/pipelines.py。一个标准的 Pipeline 类通常包含 process_item(self, item, spider) 方法。若需要过滤不合格的记录,导入 DropItem 异常类并抛出即可丢弃该条数据:
import json
from scrapy.exceptions import DropItem

class CleanBookDataPipeline:
    """负责字段清洗、去除无效符号与类型转换"""
    def process_item(self, item, spider):
        # 价格清洗:去除英镑符号并转为浮点数
        price_raw = item.get("price")
        if price_raw:
            try:
                # 剔除可能存在的货币符号(如 £51.77)
                clean_num = "".join(ch for ch in price_raw if ch.isdigit() or ch == '.')
                item["price"] = float(clean_num)
            except ValueError:
                raise DropItem(f"价格数据异常,丢弃条目: {item.get('title')}")
        else:
            raise DropItem(f"缺少价格字段,丢弃条目: {item.get('title')}")

        # 校验标题有效性
        if not item.get("title"):
            raise DropItem("缺少商品标题,丢弃无效数据")

        # 处理完成后必须返回 item,供后续管道继续使用
        return item


class JsonLineStoragePipeline:
    """负责将清洗后的结构化数据追加写入本地 JSON 文件"""
    def open_spider(self, spider):
        # 爬虫启动时打开文件句柄
        self.file = open("cleaned_books.jsonl", "w", encoding="utf-8")

    def process_item(self, item, spider):
        line = json.dumps(dict(item), ensure_ascii=False) + "\n"
        self.file.write(line)
        return item

    def close_spider(self, spider):
        # 爬虫结束时安全关闭文件句柄
self.file.close()process_item 方法时,无论是修改了字段还是保持原样,都必须在方法末尾显式 return item。如果遗漏了 return,Scrapy 引擎会认为该 Item 返回了 None,导致后续的所有管道直接断流。
2. 在 settings.py 中激活管道与调优配置
Pipeline 编写完成后并不会默认生效,必须在项目的 settings.py 中通过字典显式注册。字典的键为 Pipeline 类的导入路径,值为介于 1 到 1000 之间的整数权重,数值越小执行顺序越靠前:
# book_crawler/settings.py

# 激活数据管道并设定执行顺序
ITEM_PIPELINES = {
    "book_crawler.pipelines.CleanBookDataPipeline": 300,
    "book_crawler.pipelines.JsonLineStoragePipeline": 800,
}

# 遵守站点 robots 协议(测试时可观察目标站点实际限制)
ROBOTSTXT_OBEY = True

# 设置礼貌下载延迟(单位:秒),降低目标服务器负载
DOWNLOAD_DELAY = 1.0

# 配置合理的单域名最大并发数
CONCURRENT_REQUESTS_PER_DOMAIN = 8

# 设置默认请求头,模拟真实浏览器访问
DEFAULT_REQUEST_HEADERS = {
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
}
3. 启动爬虫与执行结果验证
在包含 scrapy.cfg 的项目根目录终端中执行以下命令,即可启动爬虫:
# 启动指定的爬虫
scrapy crawl books
此时终端会持续输出 Scrapy 的引擎统计与抓取日志。执行完毕后,检查当前目录下生成的 cleaned_books.jsonl 文件,确认数据的完整性与清洗效果:
{"title": "A Light in the Attic", "price": 51.77, "rating": "Three", "stock": "In stock", "url": "http://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html"}
{"title": "Tipping the Velvet", "price": 53.74, "rating": "One", "stock": "In stock", "url": "http://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html"}
四、生产配置避坑指南与项目调优总结
初学者在构建结构化爬虫项目时,常因忽略网络异常处理、日志冗余或反爬限制而遇到各种非预期报错。掌握以下几项核心控制策略,能显著提高工程的稳健性。
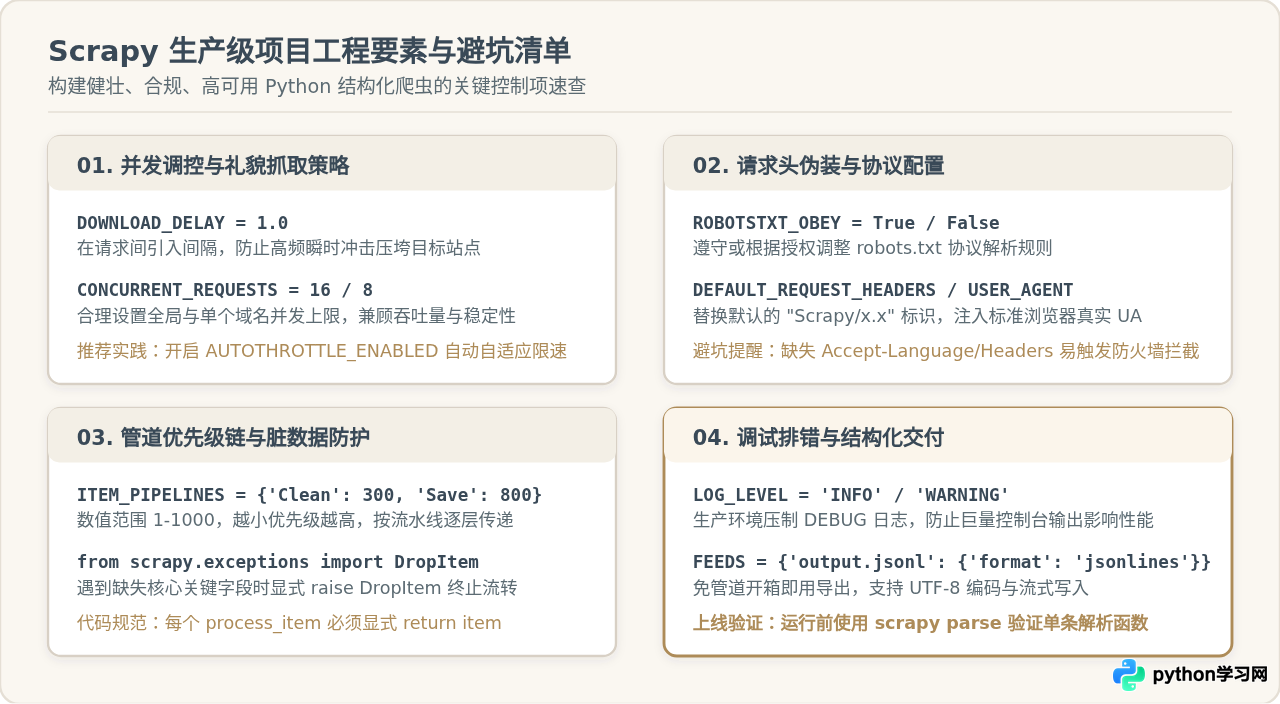
核心排查与优化总结:
-
关于 robots.txt 导致的请求被忽略:Scrapy 默认开启
ROBOTSTXT_OBEY = True。如果目标网站在/robots.txt中禁止了通用 User-Agent,终端会输出[scrapy.downloadermiddlewares.robotstxt] Forbidden by robots.txt。若在合规授权前提下进行数据采集,需将该项设为False。 -
避免滥用粗暴的高并发:虽然 Scrapy 支持极高的并发数(如
CONCURRENT_REQUESTS = 64),但未经节制的抓取不仅会触发目标网站的 WAF 防火墙封禁 IP,还可能对其服务器带来过大负载。推荐开启AUTOTHROTTLE_ENABLED = True,让 Scrapy 根据目标服务器的响应时间自动动态调节爬取速度。 -
善用 Scrapy Shell 进行交互式选择器调试:在正式编写
parse抽取逻辑前,无需反复运行整个爬虫。可在终端直接执行scrapy shell "http://books.toscrape.com/catalogue/page-1.html",在交互式命令行中实时测试response.css(...)的返回值,极大提升提取规则的编写效率。 -
生产日志分级管理:Scrapy 默认的
LOG_LEVEL为DEBUG,抓取海量页面时控制台日志会占用巨大磁盘 I/O。在生产环境部署时,建议在settings.py中指定LOG_LEVEL = 'INFO'或'WARNING'。
按照上述规范搭建的 Scrapy 项目,具备高可读性、高扩展性与稳定的模块解耦特征。当抓取规则或数据存储介质(如切换为 MongoDB 或 MySQL)发生变动时,开发者只需针对性修改对应的 Spider 或 Pipeline 类,无需重构整套爬虫网络流,这正是现代 Python 结构化抓取工程的核心优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









