

Python怎么批量读取文件夹下的所有CSV文件?
系统介绍使用 Python 批量读取文件夹下所有 CSV 文件的实用方法。涵盖 pathlib 与 glob 路径匹配、pandas 内存高效合并、标准库 csv 流式处理、编码兼容及空文件防御策略。
pathlib.Path.glob() 检索文件,配合 pandas.read_csv() 生成 DataFrame 列表,最后使用 pandas.concat() 一次性合并。该方案兼具跨平台稳定性、清晰的语法与高效的内存分配机制。
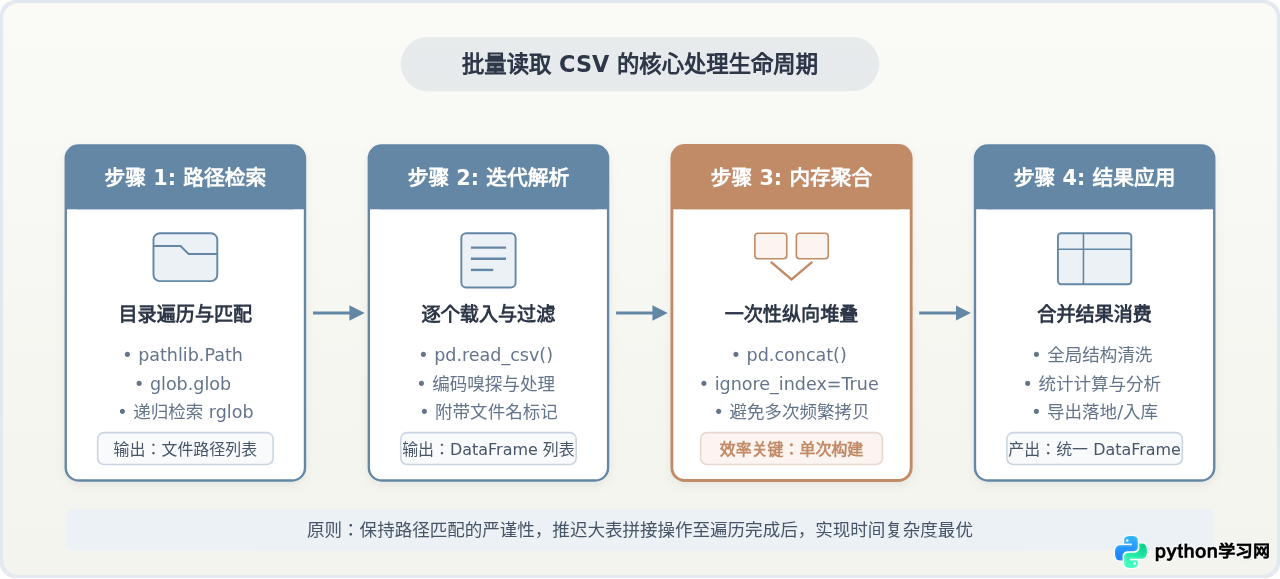
一、推荐解法:pathlib + pandas 现代标准方案
在日常数据分析和生产脚本中,绝大多数批量读取任务都可以用 pathlib(负责安全的文件定位)与 pandas(负责高速数据解析与规整)配合解决。
1. 为什么优先选用 pathlib?
Python 3.4 引入的 pathlib 提供了面向对象的路径操作方式,相较于早期的 os.path.join 和纯字符串拼接,它能自动处理 Windows 反斜杠(\)与 Linux/macOS 正斜杠(/)的差异,同时其 .glob() 方法可直接生成路径对象,代码更加健壮。
2. 核心完整代码
from pathlib import Path
import pandas as pd

# 1. 指定存放 CSV 的目标文件夹
data_dir = Path("./data_folder")

# 2. 匹配文件夹下所有的 .csv 文件(生成 Path 迭代对象)
csv_files = list(data_dir.glob("*.csv"))

# 3. 列表推导式:读取每个 CSV 并装入列表
# 提示:在此处通过 assign 添加来源文件名,是生产排查问题的黄金实践
df_list = [
    pd.read_csv(file).assign(_source_file=file.name)
    for file in csv_files
]

# 4. 防御性检查并执行一次性合并
if df_list:
    combined_df = pd.concat(df_list, ignore_index=True)
    print(f"成功读取并合并 {len(csv_files)} 个文件,总行数: {len(combined_df)}")
else:
    print("未在该文件夹中找到任何 CSV 文件。")
3. 两个极易忽略的代码参数解释
-
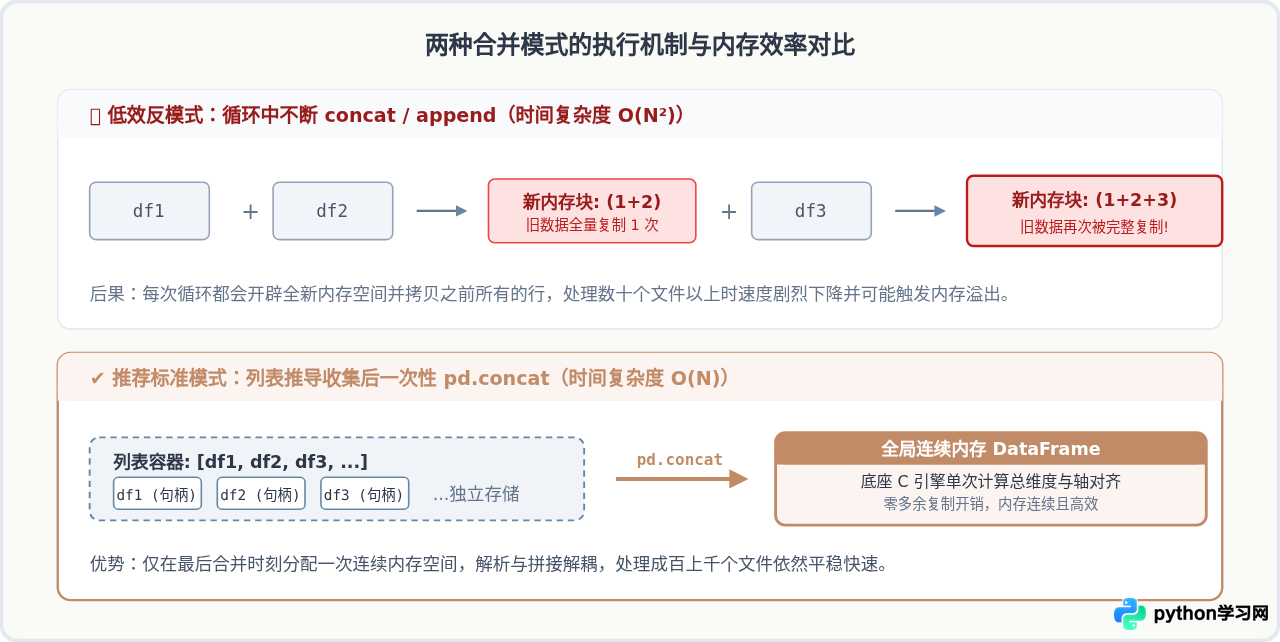
ignore_index=True的必要性: 每个 CSV 文件在单独读取时,默认索引通常都是从0到N-1。如果在合并时不重置索引,合并后就会出现大量重复的数字索引(例如多个 0、多个 1),后续按索引定位切片时将产生逻辑错误。设置ignore_index=True会直接废弃旧索引并生成从 0 到总行数减 1 的连续新索引。 -
为什么在推导式中追加
.assign(_source_file=file.name)? 当读取几十个结构相同但记录不同日期或门店的 CSV 时,一旦合并为单一大表,各行数据的归属文件信息就会丢失。使用assign能在读取瞬间无缝附加一列溯源文件名,方便后期核对异常数据。
二、场景进阶:递归读取各级子文件夹下的 CSV
现实业务中,文件往往按层级归类存放,例如 data/2026/01/sales.csv、data/2026/02/sales.csv。如果只使用 data_dir.glob("*.csv"),只会查找当前目录的第一层,而无法触达子目录。
1. 递归检索写法:rglob
from pathlib import Path
import pandas as pd

data_dir = Path("./data")

# 使用 rglob 递归遍历所有层级的子目录
all_csv_files = list(data_dir.rglob("*.csv"))

# 在添加来源时,甚至可以提取父级目录名作为业务字段(如年份、月份)
dfs = [
    pd.read_csv(f).assign(
        sub_folder=f.parent.name,   # 例如 "01" 或 "2026"
        file_name=f.name
    )
    for f in all_csv_files
]

if dfs:
    merged_data = pd.concat(dfs, ignore_index=True)
    print(f"递归扫描完成,检索到 {len(all_csv_files)} 个分层文件")
如果你使用的是内置模块 glob,则可以通过设置 recursive=True 实现等效效果:
import glob

# 注意 ** 通配符必须配合 recursive=True
files = glob.glob("./data/**/*.csv", recursive=True)
三、轻量选择:无第三方依赖(Python 内置 csv 模块)
当代码需要运行在受限的服务器环境(无法安装 pandas)、轻量运维脚手架中,或单个文件并不需要进行复杂的列运算时,使用标准库内置的 csv.DictReader 能够以零依赖的形式完成任务。
import csv
from pathlib import Path

folder = Path("./data_folder")
all_records = []

for file_path in folder.glob("*.csv"):
    with open(file_path, mode="r", encoding="utf-8-sig") as f:
        reader = csv.DictReader(f)
        for row in reader:
            row["_source"] = file_path.name
            all_records.append(row)

print(f"内置 csv 读取完成,共汇总 {len(all_records)} 条记录")
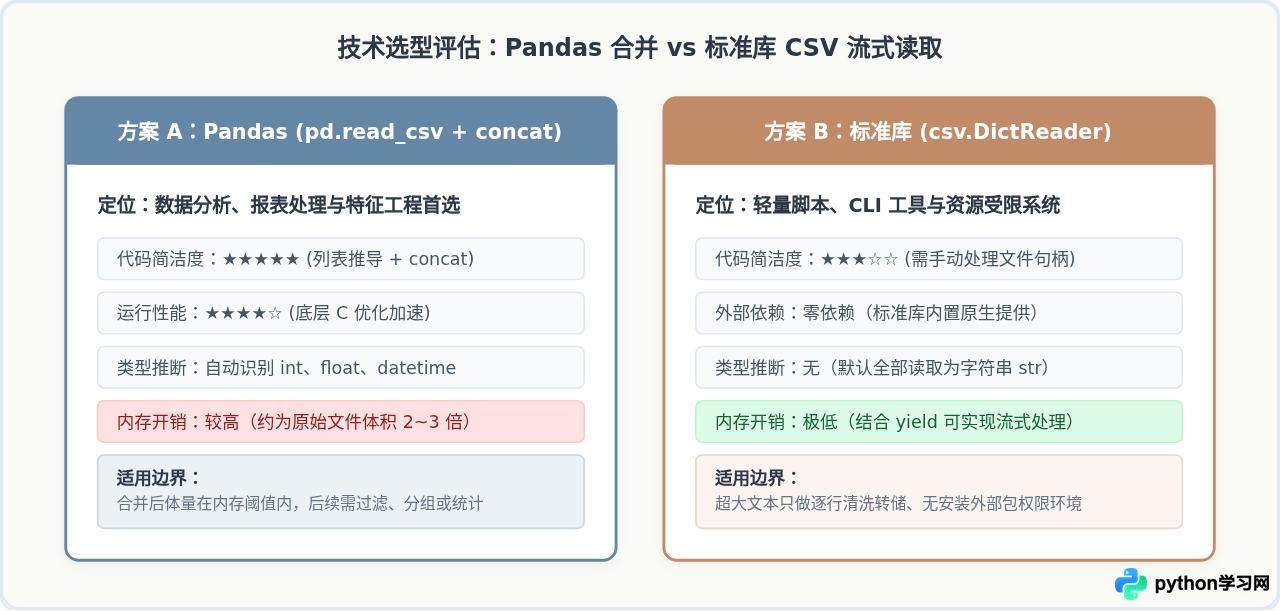
四、工程实战必须防御的 4 大陷阱
批量读取往往不是理想状态,真实文件目录常常掺杂不同编码、大小为 0 字节的坏文件、或者由于历史版本差异导致列名不一致。
1. 中文编码识别策略
最常见的崩溃是 UnicodeDecodeError: 'utf-8' codec can't decode byte...。国内常见的数据源(特别是经由 Windows 本地 Excel 导出的 CSV)通常采用 GBK 或 GB18030 编码,部分现代系统生成的文件则可能带有 UTF-8-SIG(BOM 头)。
稳妥的做法是优先尝试 utf-8-sig,如抛出编码异常则自动退回至 gb18030(它完全兼容 GBK 与 GB2312 且收录字符更广):
def safe_read_csv(file_path):
    try:
        return pd.read_csv(file_path, encoding="utf-8-sig")
    except UnicodeDecodeError:
        return pd.read_csv(file_path, encoding="gb18030")
2. 空文件防御
如果文件夹内存在 0 字节的文件,pd.read_csv 会直接抛出 EmptyDataError: No columns to parse from file。
在调用读取前检查 file.stat().st_size > 0 可以零开销规避该问题。
3. 列不一致与只读指定列
如果每个 CSV 包含数十列,而业务只需要其中 3 列,无差别全量加载将成倍浪费内存与时间。通过 usecols 参数可以在解析阶段直接跳过无用字段:
df = pd.read_csv(file, usecols=["订单号", "交易金额", "支付时间"])
五、高复用封装:工业级批量读取函数模板
综合上述的路径处理、编码兼容、错误捕获与性能合并要求,可以直接复用以下生产级通用函数:
from pathlib import Path
import pandas as pd
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s - %(levelname)s - %(message)s")

def batch_read_csv(
    folder_dir: str,
    pattern: str = "*.csv",
    recursive: bool = False,
    add_source: bool = True
) -> pd.DataFrame:
    """
    安全、批量读取指定文件夹下的所有 CSV 文件并合并为一个 DataFrame。

    :param folder_dir: 目标文件夹路径
    :param pattern: 文件匹配通配符,默认为 "*.csv"
    :param recursive: 是否递归子目录,默认 False
    :param add_source: 是否新增一列记录来源文件名,默认 True
    :return: 聚合后的 pandas.DataFrame
    """
    base_path = Path(folder_dir)
    if not base_path.exists() or not base_path.is_dir():
        raise FileNotFoundError(f"指定的文件夹不存在: {folder_dir}")

    matcher = base_path.rglob(pattern) if recursive else base_path.glob(pattern)
    matched_files = [f for f in matcher if f.is_file() and f.stat().st_size > 0]

    if not matched_files:
        logging.warning(f"在 {folder_dir} 中未匹配到有效的 CSV 文件。")
        return pd.DataFrame()

    dfs = []
    for file in matched_files:
        # 编码自适应读取
        df = None
        for enc in ("utf-8-sig", "gb18030"):
            try:
                df = pd.read_csv(file, encoding=enc)
                break
            except (UnicodeDecodeError, pd.errors.EmptyDataError):
                continue

        if df is not None:
            if add_source:
                df["_source_file"] = file.name
            dfs.append(df)
        else:
            logging.error(f"跳过解析失败的文件: {file}")

    if not dfs:
        return pd.DataFrame()

    # 一次性快速构建
    merged_result = pd.concat(dfs, ignore_index=True)
    logging.info(f"成功合并 {len(dfs)} 个文件,总计 {len(merged_result)} 行数据。")
    return merged_result

# --- 调用示例(示例输出标明) ---
if __name__ == "__main__":
    # 示例调用
    result = batch_read_csv("./data_folder", recursive=False)
    # [示例输出] 2026-11-01 14:26:00 - INFO - 成功合并 12 个文件,总计 148500 行数据。
六、总结
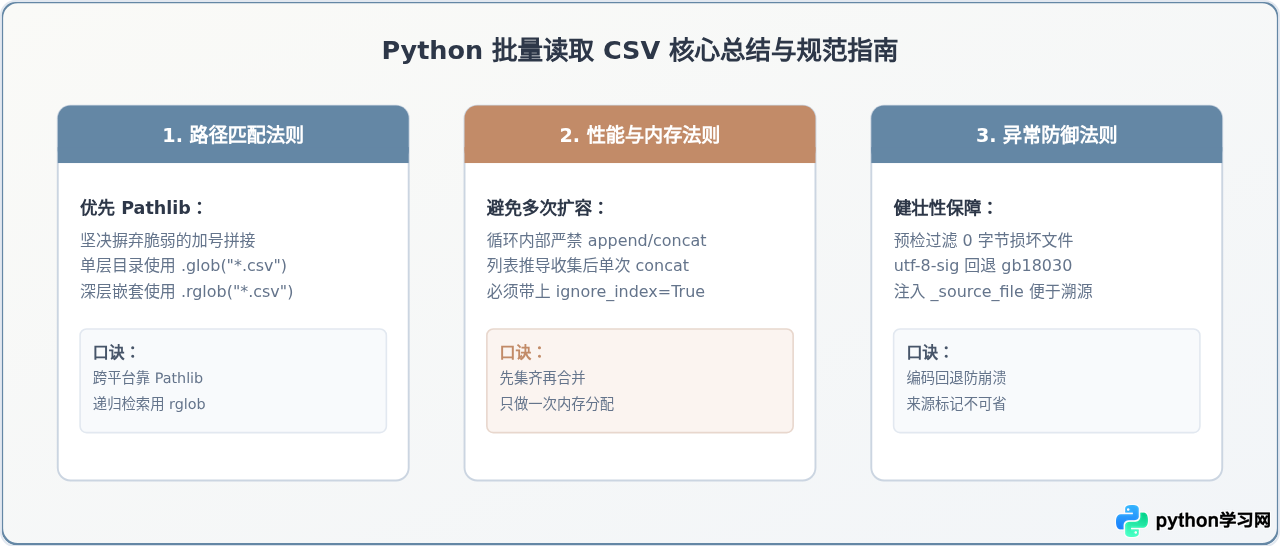
批量读取文件夹下的 CSV 文件是数据处理中最基础的高频操作。掌握这一任务的本质在于建立良好的管道意识:
- 定位阶段:优先使用
pathlib.Path,单层用glob,嵌套子目录用rglob。 - 解析阶段:使用
pd.read_csv()逐个加载,同时结合try-except做好utf-8-sig与gb18030的双编码兼容,并通过assign记录文件名。 - 合并阶段:坚决避免在
for循环中频繁调用concat或append;务必采用列表推导集齐 DataFrame 后,通过pd.concat(dfs, ignore_index=True)执行单次聚合。
遵循这套规范,不仅代码行数少、可读性高,而且能稳定从容地应对从几十个到成百上千个 CSV 文件的批量数据处理任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









