

解决Python multiprocessing报错:Can't pickle local object的原因与修复
深入解析Python使用multiprocessing多进程时出现“Can't pickle local object”报错的底层机理、根本原因与排查步骤,并提供模块顶层重构、状态类封装、参数绑定与第三方序列化等完整修复方案。
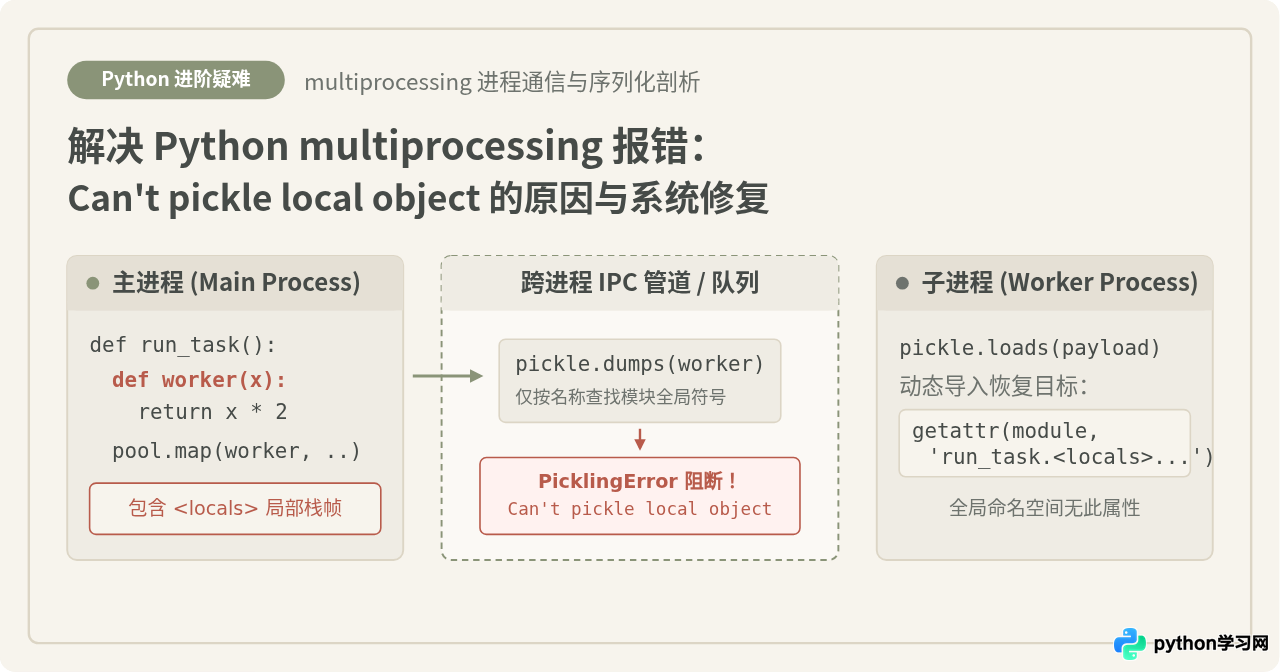
multiprocessing 在多进程间分发任务时依赖标准库 pickle 进行序列化;而 pickle 对函数和类只保存“模块名 + 限定名”的寻址引用,无法序列化位于局部作用域(函数内部嵌套函数、匿名 lambda 或局部类)的对象。修复的核心方案是将目标函数或类提升至模块顶层,确保其在全局命名空间中可被动态导入;若需携带动态上下文,使用 functools.partial 绑定参数或设计顶层可调用类;在交互式环境或高度动态闭包场景下,则可引入支持字节码序列化的第三方库(如 pathos / multiprocess)。
一、报错复现与典型错误日志
在编写数据处理脚本、模型评估或爬虫并发程序时,很多开发者习惯在某个管理函数内部定义辅助工作函数(Worker),并直接将其传递给 multiprocessing.Pool 或 Process。代码在同步执行时一切正常,一旦投入多进程池,就会立即抛出异常。
1. 典型报错复现代码
以下是一段极具代表性的错误代码示例:
import multiprocessing as mp

def run_pipeline(data_list):
    multiplier = 10

    # 局部嵌套函数(捕获了外部的局部变量或处于函数命名空间内)
    def process_item(x):
        return x * multiplier

    # 试图将局部函数提交至多进程池
    with mp.Pool(processes=2) as pool:
        results = pool.map(process_item, data_list)
    return results

if __name__ == '__main__':
    data = [1, 2, 3, 4]
    print(run_pipeline(data))
2. 终端错误输出(Traceback 示例)
执行上述代码时,解释器会产生如下调用栈(在不同操作系统与 Python 版本中可能表现为 PicklingError 或 AttributeError):
Traceback (most recent call last):
  File "pipeline.py", line 16, in <module>
    print(run_pipeline(data))
  File "pipeline.py", line 11, in run_pipeline
    results = pool.map(process_item, data_list)
  File "/usr/lib/python3.10/multiprocessing/pool.py", line 367, in map
    return self._map_async(func, iterable, mapstar, chunksize).get()
  File "/usr/lib/python3.10/multiprocessing/pool.py", line 774, in get
    raise self._value
  File "/usr/lib/python3.10/multiprocessing/pool.py", line 540, in _handle_tasks
    put(task)
  File "/usr/lib/python3.10/multiprocessing/connection.py", line 206, in send
    self._send_bytes(_ForkingPickler.dumps(obj))
_pickle.PicklingError: Can't pickle local object 'run_pipeline.<locals>.process_item'
如果在 pool.map 中传递的是匿名函数 lambda x: x * 10,报错信息则变为:
_pickle.PicklingError: Can't pickle local object 'run_pipeline.<locals>.<lambda>'。
二、深入底层原理:为什么 pickle 无法序列化局部对象?
要彻底掌握并避免该问题,必须理解 Python 进程间通信(IPC)的工作边界以及标准库 pickle 的序列化机制。
多进程与多线程存在本质差异:线程之间共享同一份进程虚拟内存,传递函数指针只需传递内存地址;而操作系统中的多个进程拥有彼此完全隔离的地址空间。当主进程要把任务对象 func 及其参数通过管道(Pipe)或队列(Queue)分发给工作子进程时,必须先将对象“扁平化”为字节序列,在子进程中再反序列化还原。
1. pickle 序列化函数的“按名索引”原则
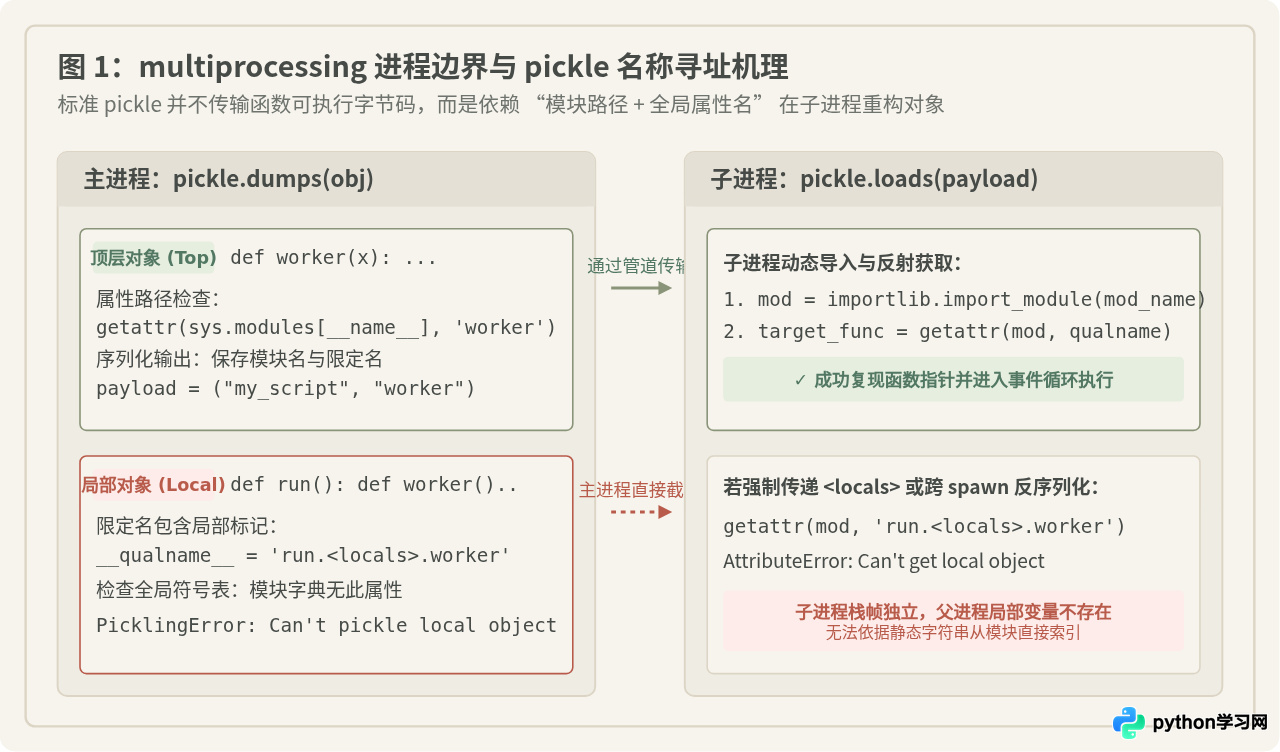
与许多开发者的直觉相反,Python 内置的 pickle 模块在序列化函数和类时,默认不会打包函数的底层字节码(Bytecode)或 AST 抽象语法树。
pickle 采取的是轻量化的“引用寻址”策略:对于一个顶层函数 def foo(): pass,pickle.dumps(foo) 存储的仅是元数据元组 (模块全路径, 函数限定名),例如 ('__main__', 'foo')。
当子进程收到这个元组时,执行的反序列化逻辑等价于:
import importlib
mod = importlib.import_module(module_name)
func = getattr(mod, qualname)  # 在模块的顶层字典中查找同名符号
2. 局部对象与 <locals> 的致命冲突
根据 Python PEP 3155(规范对象的 __qualname__ 属性),任何在函数内部定义的嵌套函数或类,其限定名都会被解释器标记为包含 <locals>,例如 run_pipeline.<locals>.process_item。
局部函数是外层函数调用时在当前栈帧(Stack Frame)中临时创建的动态对象。在模块的全局符号表(sys.modules[__name__].__dict__)中,根本不存在名为 run_pipeline.<locals>.process_item 的属性。
因此,当 pickle 检查并发现目标函数的限定名包含 <locals> 时,为了防止子进程通过 getattr() 反序列化必然失败,它会在主进程打包阶段主动拦截并抛出:
PicklingError: Can't pickle local object。
三、常见触发场景与特征归纳
在日常工程实践中,以下四种代码模式最容易诱发此报错:
-
场景一:嵌套定义的辅助工作函数。
开发者为了保持代码的封装性,将数据处理子逻辑def worker():放在主函数或类方法内部,并传给进程池。 -
场景二:匿名函数(lambda 表达式)。
使用pool.map(lambda x: x['score'] > 60, records)。所有lambda均被解释器视作定义在当前作用域的匿名局部对象,无法被顶层寻址。 -
场景三:闭包(Closure)捕获了外部环境变量。
内部函数引用了外部函数的局部变量,形成了依赖栈帧的闭包 cell 对象,不仅限定名无法查找,其闭包上下文也无法被标准 pickle 处理。 -
场景四:在函数内部动态定义的类或其方法。
在方法内即时声明class TaskHandler: ...,并将其作为任务实例化传递。
四、报错排查与决策路径
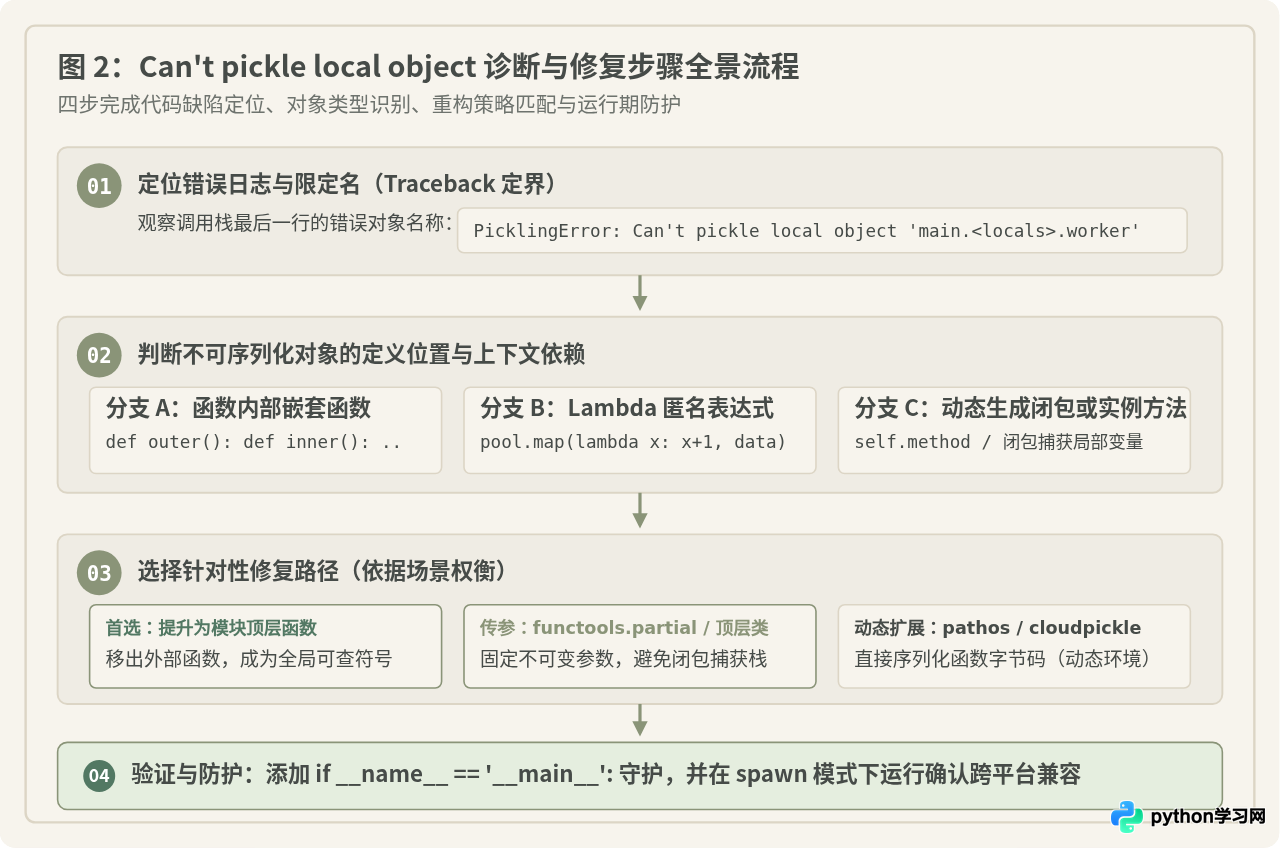
当遇到该错误时,建议遵循系统化的诊断流程,从日志分析到代码重构,快速定位并选择适宜的修复手段。
-
步骤 1:分析 Traceback 定位对象名称。
查看异常信息中引号内的名称。例如'train_epoch.<locals>.batch_eval',即可直接定位到问题函数是位于train_epoch内部的batch_eval。 -
步骤 2:分析该对象是否依赖外层局部变量。
检查该函数是纯粹的代码组织(不依赖外层局部变量),还是依赖了外层传入的配置参数。 -
步骤 3:依据业务场景选取修复策略。
若不依赖局部状态,直接提升至顶层;若依赖不可变状态,改用functools.partial绑定;若依赖复杂状态,使用顶层可调用类;若代码运行在只读环境或交互式 Notebook,选用第三方序列化器。 -
步骤 4:确认主进程入口保护。
确保多进程派生代码严格位于if __name__ == '__main__':之后,防止不同启动模式下的级联崩溃。
五、四种系统修复方案与实战代码
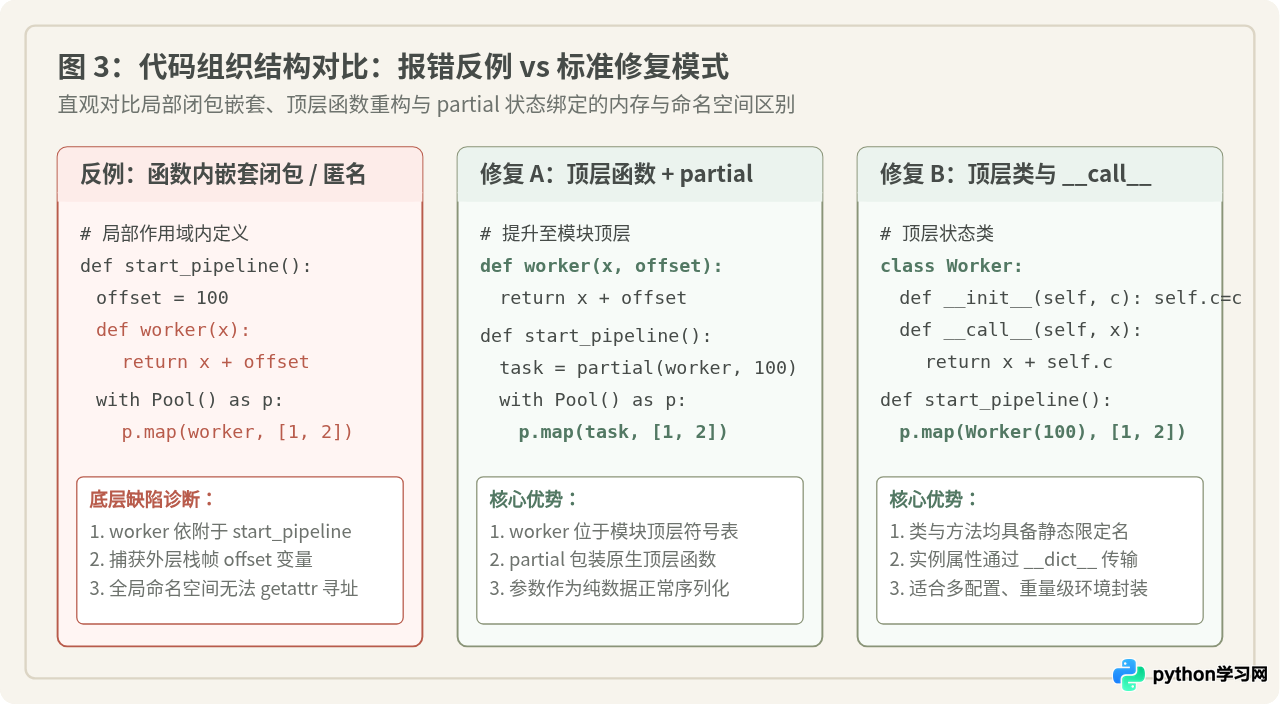
方案一:提升至模块顶层(最标准、推荐的首选方案)
如果辅助函数只是为了处理数据,并不强依赖当前函数的局部栈,最规范、性能最高的做法是将该函数移到模块的最外层,成为顶层函数(Top-level Function)。
import multiprocessing as mp

# 1. 提升至模块顶层,具有全局静态命名空间
def process_item(x):
    return x * 10

def run_pipeline(data_list):
    # 2. 传递顶层函数引用
    with mp.Pool(processes=2) as pool:
        results = pool.map(process_item, data_list)
    return results

if __name__ == '__main__':
    data = [1, 2, 3, 4]
    print(run_pipeline(data))  # 正常输出:[10, 20, 30, 40]
方案二:使用 functools.partial 替代闭包传参
当子进程任务必须依赖主函数中的某个配置参数(例如 multiplier 或模型权重)时,以往很多开发者会直接写内部闭包。正确的替代方案是将函数提升至顶层,并使用 functools.partial 提前冻结该参数。
由于 partial 对象及其包装的顶层函数均支持标准 pickle,这是兼顾封装性与序列化兼容性的最佳实践。
import multiprocessing as mp
from functools import partial

# 1. 顶层函数,显式接收额外配置参数
def process_with_factor(x, factor):
    return x * factor

def run_pipeline(data_list, dynamic_factor):
    # 2. 使用 partial 绑定配置参数,生成可序列化的一元可调用对象
    bound_worker = partial(process_with_factor, factor=dynamic_factor)

    with mp.Pool(processes=2) as pool:
        results = pool.map(bound_worker, data_list)
    return results

if __name__ == '__main__':
    data = [1, 2, 3, 4]
print(run_pipeline(data, dynamic_factor=25)) # 正常输出:[25, 50, 75, 100]multiprocessing.Pool.starmap 也是传递多参数的利器。如果参数是一组元组序列 [(x1, factor), (x2, factor), ...],直接调用 pool.starmap(process_with_factor, iterable) 同样完全避免闭包报错。
方案三:编写顶层可调用类(__call__ 封装状态)
当任务逻辑需要持有复杂的内部状态(例如数据库连接配置、阈值字典、缓存表)时,将状态与操作封装在一个顶层类中是最优雅的面向对象方案。
import multiprocessing as mp

# 1. 顶层类:类名在模块全局可查,其实例具备完整的 __dict__
class TaskProcessor:
    def __init__(self, factor, offset):
        self.factor = factor
        self.offset = offset

    # 实现 __call__ 魔法方法,使实例可直接作为函数调用
    def __call__(self, x):
        return x * self.factor + self.offset

def run_pipeline(data_list):
    # 2. 创建实例并传递给进程池
    worker_instance = TaskProcessor(factor=5, offset=2)
    with mp.Pool(processes=2) as pool:
        results = pool.map(worker_instance, data_list)
    return results

if __name__ == '__main__':
    data = [1, 2, 3]
    print(run_pipeline(data))  # 正常输出:[7, 12, 17]
方案四:引入增强序列化库 pathos / multiprocess
在某些特定场景下(例如 Jupyter Notebook 交互式教学、动态生成的数学闭包、第三方插件回调函数),重构代码为顶层结构可能成本极高或受到平台限制。此时可以引入使用 dill 或 cloudpickle 替代标准 pickle 的高级进程库。
cloudpickle 具备直接提取并打包 Python 函数字节码与外层闭包变量的能力,无需依赖顶层命名空间索引。
# 依赖安装示例:pip install pathos
from pathos.multiprocessing import ProcessingPool as Pool

def run_interactive_pipeline(data_list):
    dynamic_offset = 100

    # 在 pathos 中,直接传递内部嵌套闭包或 lambda 完全合法!
    with Pool(nodes=2) as pool:
        results = pool.map(lambda x: x + dynamic_offset, data_list)
    return results

if __name__ == '__main__':
    data = [1, 2, 3]
    print(run_interactive_pipeline(data))  # 正常输出:[101, 102, 103]
六、容易混淆的认知误区与深度辨析
| 常见说法与直觉 | 真实结论 | 底层原因与条件辨析 |
|---|---|---|
| “这段嵌套函数在 Linux 上运行毫无问题,报错肯定是 Windows 或 macOS 的 Bug。” | 错误(平台启动机制差异) | Linux 默认长期采用 fork 启动模式,子进程直接通过内存写时复制(COW)获取了父进程栈,未触发管道 IPC 序列化;而 Windows 和 macOS(Python 3.8+)采用 spawn 模式,无论如何都会完整 pickle。依赖 fork 掩盖了不规范代码。 |
“只要用 functools.partial 包装一下,任何闭包就能被序列化。” |
错误(包装对象必须本身可序列化) | partial 本身是一个顶层类,但它序列化时会递归序列化其内部包裹的 func。如果包裹的是局部嵌套函数,依然会触发 Can't pickle local object。 |
| “pickle 不序列化函数字节码是设计缺陷,不如 cloudpickle 好用。” | 部分合理但需修正 | 标准库出于跨 Python 小版本兼容性、C 扩展对象安全性及传输体积考量,有意坚持按名称引用。字节码序列化存在反序列化执行任意代码的安全隐患与版本脆弱性。 |
1. 深入剖析:fork 与 spawn 启动方式的陷阱
很多开发者在 Linux 服务器上测试代码一切正常,移到本地 macOS 或 Windows 工作站时突然崩溃。这是因为:
-
fork模式(POSIX 传统):子进程通过复制父进程的整个内存空间被创建。如果调用Process(target=local_func),子进程从内存直接继承了local_func的上下文,可能在未经过管道 pickle 的情况下执行完成。然而在multiprocessing.Pool中,任务调度队列(Task Queue)依然会尝试序列化任务,且fork在多线程混合环境中极易发生死锁(Deadlock)。 -
spawn模式(安全跨平台标准):子进程启动一个全新的干净 Python 解释器,重新导入目标入口模块,所有参数与目标函数必须经由pickle严格检验。Python 3.8 起已将 macOS 默认模式切换为spawn,Python 3.14 更是正式将fork标记为弃用。因此,遵循spawn规范编写顶层代码是唯一保证长期跨平台可靠性的做法。
2. 辨析:functools.partial 的序列化边界
考虑以下反例:
def run():
    # 局部函数
    def inner(a, b): return a + b
    # 试图通过 partial "洗白" 局部函数
    task = partial(inner, b=10)
    # 依然会抛出:Can't pickle local object 'run.<locals>.inner'
partial 只是将参数与函数指针绑定并封装,它并不能凭空抹除被包装对象的 <locals> 标记。使用 partial 的前提是:被包装的基础函数本身必须是合法的顶层函数。
七、核心总结与工程避坑指南
在 Python 多进程架构设计中,尊重进程间的物理隔离边界是写出健壮代码的关键基石。以下四条规则可作为日常开发自查清单:
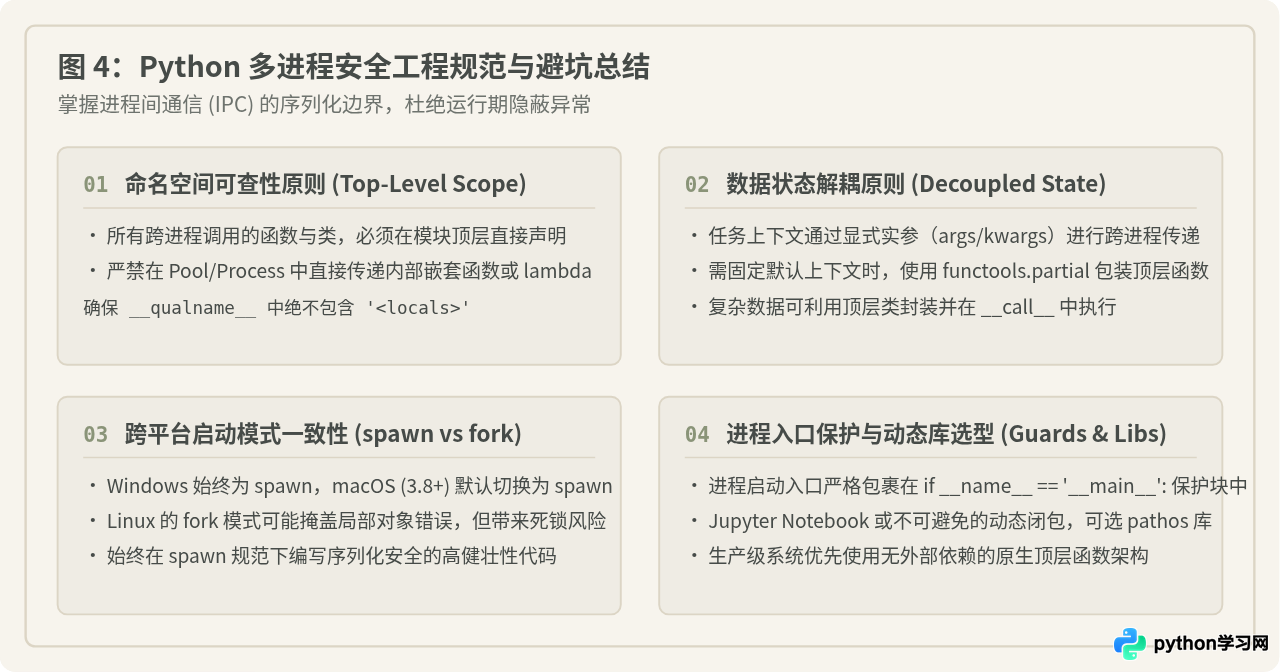
- 强制顶层原则:所有提交给
Pool、Process或concurrent.futures.ProcessPoolExecutor的target函数与class,必须位于模块最外层。 - 拒绝内部匿名:避免在
pool.map、apply_async中使用任何lambda或局部定义的函数。 - 状态显式流动:需要携带运行期配置或变量时,优先采用
functools.partial或定义包含__call__的顶层状态类,严禁通过闭包作用域隐式穿透。 - 严格入口守护:所有实例化多进程的代码,必须始终置于
if __name__ == '__main__':之后,并在开发阶段显式使用mp.set_start_method('spawn')进行跨平台健壮性压测。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









