

pandas求两个表格不相交的集合方法

本文介绍在Python中使用pandas库求两个DataFrame不相交部分(对称差集)的方法。核心思路是将两个数据框合并后,利用drop_duplicates函数并设置keep=False参数,直接删除所有重复出现的行,从而保留仅存在于其中一个数据框中的唯一记录。该方法简洁高效,适用于无重复内容的集合运算场景。
大家好,好久不见。在处理数据时,如果需要计算两个表格的不相交部分(即对称差集),我经过尝试发现并没有直接提供现成的函数。这里分享一种我自己常用的实现思路,希望能对读者有所帮助。
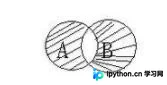
如示意图所示,阴影区域代表我们需要求取的不相交部分。需要注意的是,这种方法的前提是参与运算的集合A和B内部均不包含重复元素。
首先,我们构建两个示例DataFrame来进行演示。
import pandas as pd
a0={"number":range(10),"letter":["a","a","b","b","c","f","f","e","h","w"]}
a=pd.DataFrame(a0)
b0={"number":range(15),"letter":["b","a","t","b","r","f","g","e","j","w","t","h","i","y","u"]}
b=pd.DataFrame(b0)
查看这两个DataFrame的具体内容如下。
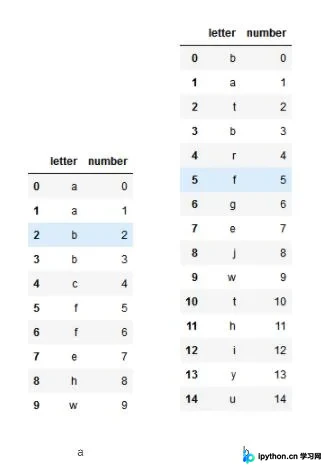
关于差集的计算,本质上是去除两个DataFrame中共同存在的部分。我的实现思路如下:
第一步,将两个DataFrame合并为一个新的DataFrame;
第二步,去除合并后数据中的公共部分(利用drop_duplicates进行去重处理)。
具体代码实现如下:
c=a.append(b)
c.drop_duplicates(keep=False,inplace=True)
c.reset_index()
这里需要特别说明的是,drop_duplicates方法中的keep参数设置为False时,表示将所有重复项全部删除。该参数还支持keep="first"(保留重复项中的第一条)和keep="last"(保留重复项中的最后一条)。更多详细信息可参考官方文档。
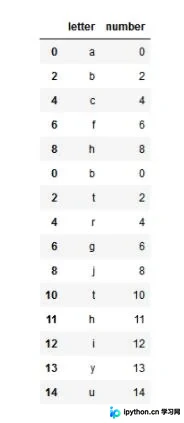
执行上述代码后,得到的结果如下所示。虽然逻辑简单,但实际效果非常实用。
基于同样的原理,该方法也可用于求取常规的差集,此处不再赘述。
以上关于pandas求两个表格不相交集合的方法就是本文分享的全部内容,希望能为大家提供参考。如果有帮助,欢迎支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









