

Python标准库常用模块命令:os、sys与datetime核心函数指南
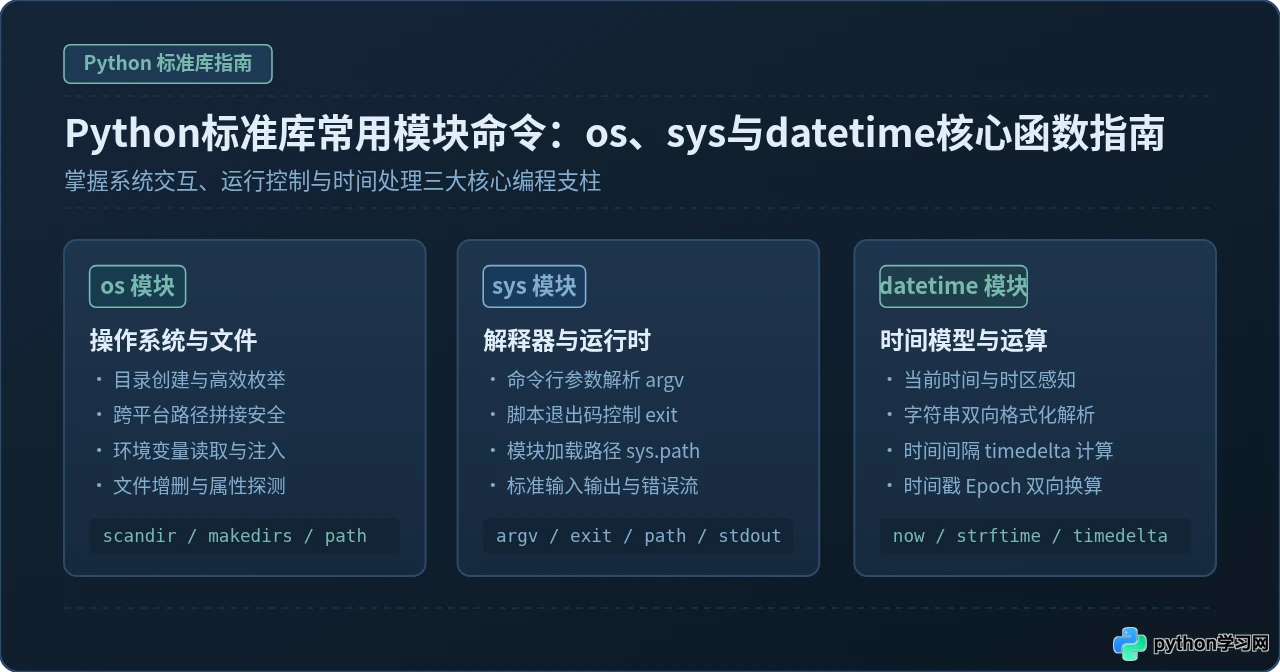
深入解析Python标准库中最核心的三大基础模块:os、sys与datetime。通过具体场景、高频核心函数详解、清晰示意图与完整实战示例,系统掌握文件操作、解释器交互与时间计算。
os、sys 与 datetime 三大模块就提供了全部的核心能力。本文将直接梳理这三个模块的关键命令与核心函数,拆解各自的职责边界与协同工作方式。
一、核心定位与职责边界
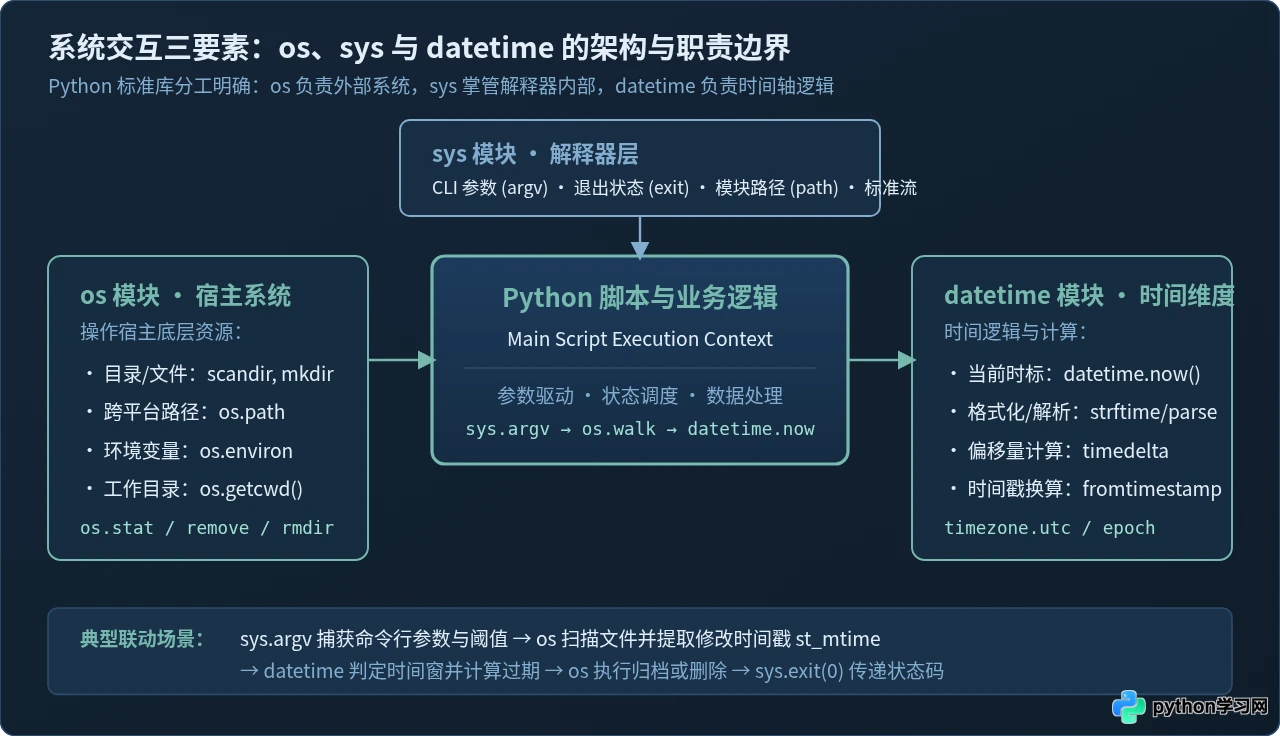
初学者在编写脚本时,常会将文件查找、参数读取和时间计算混杂在一起,甚至分不清为什么路径处理有时用 os 有时又需要调用 sys。明确三者的核心职责是写出清晰、稳定脚本的前提:
- os(操作系统交互):专注于与当前运行的底层操作系统交互,负责文件路径拼接、目录创建与枚举、文件删除与重命名、环境变量读取以及进程环境感知。
- sys(解释器与运行时):专注于 Python 解释器本身的运行时环境,负责捕获命令行传入的参数列表(
sys.argv)、控制脚本正常或异常退出(sys.exit)、维护模块导入检索路径(sys.path)以及接管标准输入输出流(sys.stdin/stdout/stderr)。 - datetime(时间模型与计算):专注于日历时间与时钟时间的量化表示,提供时间戳与结构化日期的双向换算、时间差值(
timedelta)加减、时区转换以及符合人类可读要求的字符串格式化(strftime/strptime)。
二、os 模块:文件系统与操作系统交互
os 模块是 Python 脚本连接宿主操作系统的桥梁。日常编写脚本时,最常用的操作集中在工作目录控制、目录文件枚举、跨平台路径运算和环境变量读取上。
1. 工作目录与目录创建
脚本在执行文件读写前,经常需要获取当前工作目录或确保目标输出目录存在:
os.getcwd():返回当前工作目录的绝对路径字符串。os.chdir(path):改变当前工作目录至指定的path。os.makedirs(name, exist_ok=False):递归创建多级目录。在实际项目中,必须显式指定exist_ok=True,这样当目录已存在时不会抛出FileExistsError,保障脚本幂等执行。
2. 目录枚举:os.scandir 与 os.listdir 的选型
遍历目录下的文件时,常见的方法有 os.listdir() 和 os.scandir()。
os.listdir(path):返回指定目录下所有文件和子目录的名称列表(纯字符串)。若需进一步判断是文件还是目录,必须再对每个条目调用os.path.isfile()或os.stat(),这会在底层产生多次额外的系统调用。os.scandir(path):Python 3.5 引入的迭代器,返回包含os.DirEntry对象的迭代器。每个DirEntry对象在枚举过程中已经由系统内核缓存了文件类型和基本元数据,直接调用entry.is_file()、entry.is_dir()或entry.stat()性能比listdir高出数倍至数十倍,特别适合包含上万文件的大型目录。
3. os.path 路径操作核心方法
处理文件路径时,切忌使用字符串直接拼接斜杠(如 base_dir + "/" + file),不同操作系统对分隔符的处理方式不同(Windows 采用反斜杠 \,Unix/Linux 采用正斜杠 /)。应统一使用 os.path:
os.path.join(path, *paths):跨平台智能拼接路径片段。os.path.exists(path):判断路径是否存在。os.path.isfile(path)/os.path.isdir(path):判断是否为常规文件或目录。os.path.abspath(path):获取标准化绝对路径。os.path.splitext(path):分离文件名与文件扩展名,返回元组(root, ext)。
4. 环境变量读取:os.environ
os.environ 是一个映射当前系统环境变量的对象。读取配置时建议使用 os.environ.get("ENV_NAME", default_val),若直接使用下标 os.environ["ENV_NAME"],在环境变量未设置时会抛出 KeyError 异常。
import os

# 1. 安全读取环境变量配置
backup_root = os.environ.get("BACKUP_DIR", "./backups")

# 2. 跨平台拼接完整路径并自动递归创建
target_dir = os.path.join(backup_root, "logs", "2026")
os.makedirs(target_dir, exist_ok=True)
print(f"目标目录已就绪: {os.path.abspath(target_dir)}")

# 3. 使用 os.scandir() 高效扫描文件
print("扫描当前工作目录文件:")
with os.scandir(".") as entries:
    for entry in entries:
        if entry.is_file():
            # 直接获取文件大小(字节)与最后修改时间戳
            stat_info = entry.stat()
            print(f"  [文件] {entry.name} | 大小: {stat_info.st_size} 字节")
扫描当前工作目录文件:
[文件] input.json | 大小: 7992 字节
[文件] app.py | 大小: 1420 字节
os.scandir() 返回的是一个上下文管理器与迭代器。在读取非常密集的目录时,推荐将其放入 with os.scandir(...) as entries: 块中,确保扫描完毕后由系统及时释放底层的文件描述符句柄。
三、sys 模块:解释器运行状态与 CLI 控制
如果说 os 关心的是 Python 外部的世界,那么 sys 则掌控着解释器内部的脉搏。通过 sys,脚本能够解析调用者传入的指令、返回标准的执行状态码,以及调整模块的检索范围。
1. 命令行入参:sys.argv
当我们在终端执行 python script.py --env prod /var/log 时,参数会原样封装进 sys.argv 列表:
sys.argv[0]永远是当前执行的脚本文件名或绝对路径。sys.argv[1:]是传递给脚本的位置参数与选项。所有元素均为字符串类型,若需要整数或布尔值必须自行转换。- 使用
sys.argv时务必先检查len(sys.argv),避免因缺少入参导致IndexError。
2. 规范退出程序:sys.exit()
在脚本执行完成或遇到无法恢复的错误时,使用 sys.exit([arg]) 终止进程:
sys.exit(0):向调用者(如 Bash、CI/CD 流水线)返回状态码0,代表正常顺利完成。sys.exit(1)或其他非零正整数:代表发生错误,流水线可根据非零退出码触发告警或阻断流程。- 若传递字符串(如
sys.exit("错误: 找不到目录")),该字符串会被直接打印到标准错误输出sys.stderr,并返回状态码1。
sys.exit() 并非立即杀死操作系统底层进程,而是通过抛出 SystemExit 异常来实现退出的。这意味着外层的 try...finally 块中的清理代码(如关闭连接、清理临时文件)仍会被正常执行。需要特别警惕的是:如果代码中存在宽泛捕获所有异常的空 except: 或 except BaseException:,会导致 SystemExit 被意外捕获而使程序未能退出;标准的异常捕获应使用 except Exception:(因为 SystemExit 继承自 BaseException,不会被 Exception 捕获)。
3. 标准输入输出流与模块路径
sys.stdout.write()与sys.stderr.write():底层标准输出流与标准错误流。与print()相比,它们不会自动在末尾追加换行符,且在构建 Linux 命令行管道(Pipeline)工具时,将诊断日志重定向至sys.stderr能够避免污染sys.stdout的有效业务数据。sys.path:模块导入检索路径列表。在大型项目或插件加载场景中,可通过sys.path.append("/path/to/plugins")动态扩充 Python 的模块加载路径。
import sys

# 验证必须的入参数量
if len(sys.argv) < 3:
    sys.stderr.write("使用说明: python script.py <目标目录> <保留天数>\n")
    sys.stderr.write("示例: python script.py /var/log/nginx 7\n")
    sys.exit(1)

target_path = sys.argv[1]
try:
    retention_days = int(sys.argv[2])
    if retention_days <= 0:
        raise ValueError("天数必须为正整数")
except ValueError as err:
    sys.stderr.write(f"参数错误: {err}\n")
    sys.exit(2)

sys.stdout.write(f"成功加载配置: 目标='{target_path}', 阈值={retention_days}天\n")
# 正常执行完毕返回退出码 0
sys.exit(0)
示例: python script.py /var/log/nginx 7
(进程退出码: 1)
四、datetime 模块:时间度量、换算与时区
运维与数据处理中绝大多数逻辑都带有时间属性:日志按天归档、数据按小时聚合、历史缓存定时淘汰。Python 的 datetime 模块提供了高精度的面向对象时间抽象。
1. 常用核心类与其用途
datetime.date:表示年月日日期的对象(如2026-11-01)。datetime.time:表示时分秒及微秒的时间对象(如14:30:00)。datetime.datetime:整合了日期与时间的组合对象,也是使用频率最高的对象。datetime.timedelta:表示两个日期时间之间的时间间隔(持续时长),支持按天、秒、微秒、毫秒、分钟、小时任意组合。datetime.timezone:时区表示类,如timezone.utc。
2. 时间对象与字符串的相互转换
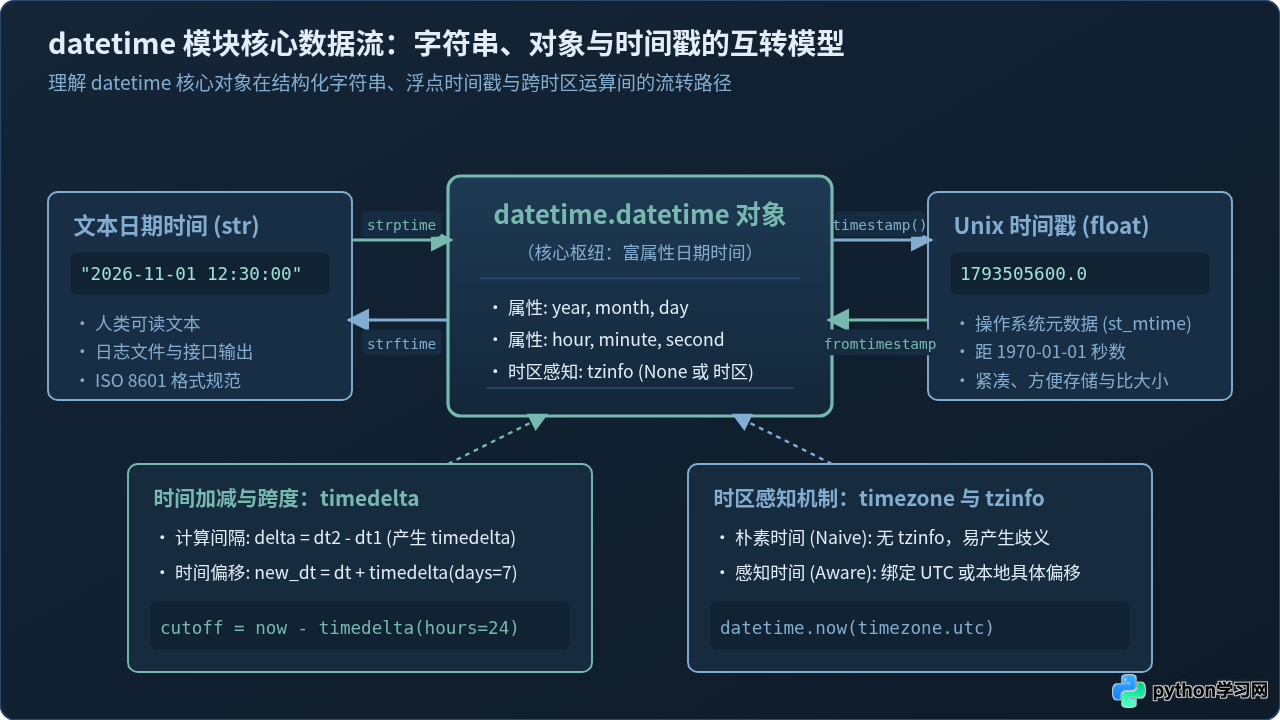
在实际项目中,时间数据常常以字符串形式在配置文件或日志文件中传输,必须熟练掌握双向转换方法:
- 解析字符串为对象(strptime - String Parse Time):
dt = datetime.strptime("2026-11-01 12:30:00", "%Y-%m-%d %H:%M:%S")
记忆技巧:p代表 Parse(解析)。 - 格式化对象为字符串(strftime - String Format Time):
str_val = dt.strftime("%Y%m%d_%H%M%S")
记忆技巧:f代表 Format(格式化)。
| 格式化代码 | 含义说明 | 常见输出示例 |
|---|---|---|
%Y |
四位数年份 | 2026 |
%m |
两位数月份(01-12)注意小写 | 11 |
%d |
两位数日(01-31) | 01 |
%H |
24小时制小时(00-23) | 14 |
%M |
两位数分钟(00-59)注意大写 | 30 |
%S |
两位数秒(00-59) | 45 |
%m 表示月份(Month),大写的 %M 表示分钟(Minute)。若在日期字符串中将月份误写为 %M,会导致格式解析彻底混乱或报 ValueError。
3. 时间戳换算与时间间隔运算
结合 os.stat().st_mtime 获取的文件修改时间是浮点型 Unix 时间戳(秒数)。利用 datetime.fromtimestamp() 可以将其还原为 datetime 对象;反之,调用 dt.timestamp() 可以导出时间戳。
from datetime import datetime, timedelta, timezone

# 1. 获取当前时间(推荐直接显式传入 UTC 时区,避免隐式本地时间带来的歧义)
now_utc = datetime.now(timezone.utc)
print(f"当前UTC时间: {now_utc.isoformat()}")

# 2. 利用 timedelta 进行时间偏移计算(如计算7天前的截止时间点)
seven_days_ago = now_utc - timedelta(days=7)
print(f"7天前时间点: {seven_days_ago.strftime('%Y-%m-%d %H:%M:%S %Z')}")

# 3. 模拟文件时间戳比对
fake_file_mtime = 1761964800.0  # 假设的底层时间戳
file_dt = datetime.fromtimestamp(fake_file_mtime, tz=timezone.utc)

is_expired = file_dt < seven_days_ago
print(f"文件生成时间: {file_dt}, 是否过期需清理: {is_expired}")
7天前时间点: 2026-10-25 04:19:45 UTC
文件生成时间: 2025-10-31 02:40:00+00:00, 是否过期需清理: True
tzinfo 的 datetime 对象被称为 Naive 时间。如果尝试将一个 Naive 对象和一个 Aware 对象直接比大小(例如 dt_naive < dt_aware),Python 会直接抛出 TypeError: can't compare offset-naive and offset-aware datetimes。最佳实践是:在脚本内部的计算逻辑中,统一使用 timezone.utc 处理时间。
五、综合实战:多模块协同的日志清理与归档脚本
为了让读者直观理解 os、sys 与 datetime 在真实开发中的结合方式,我们实现一个典型的运维需求:编写一个命令行脚本,接收指定日志目录与保留天数,扫描目录下的所有 .log 文件,判断其最后修改时间是否超过指定天数。若已过期则安全移动至按月命名的归档目录,最后打印处理统计并返回退出状态码。
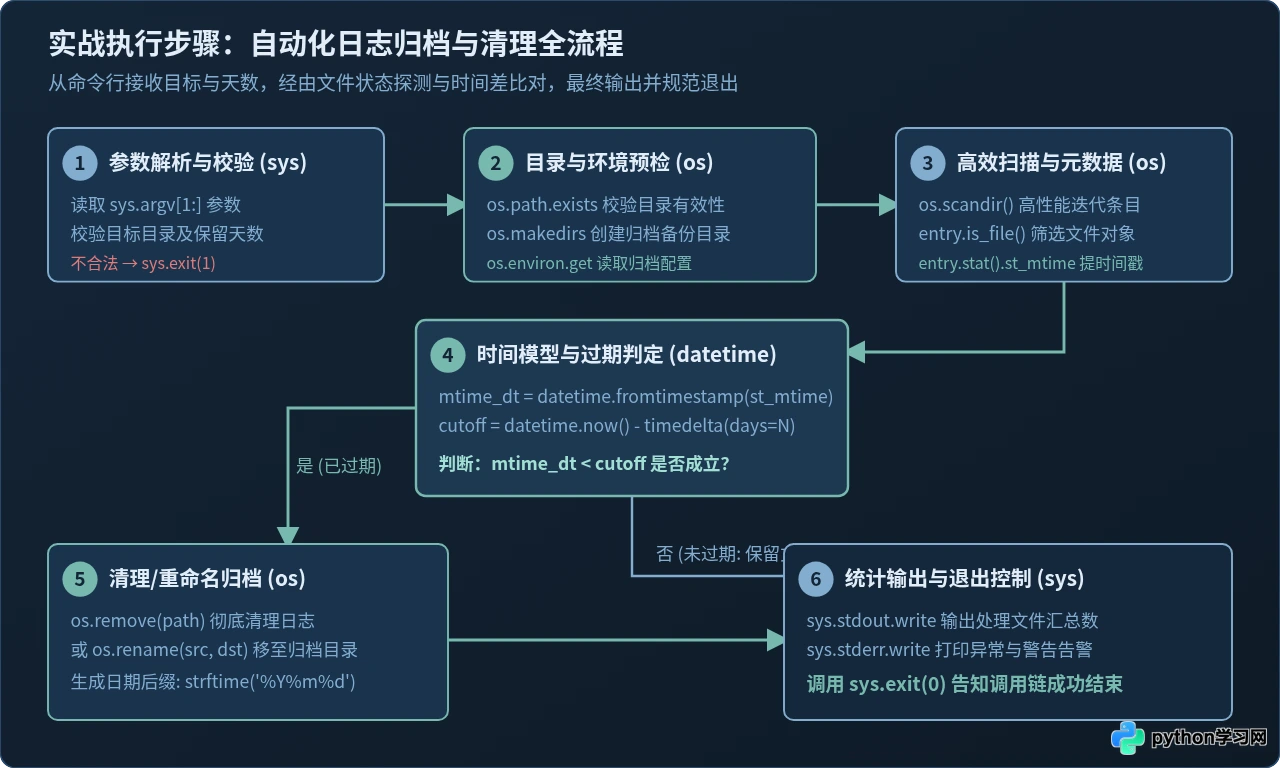
完整脚本实现代码
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
自动化日志检查与归档处理工具
协同使用 os、sys 与 datetime 标准库完成生产运维任务
"""

import os
import sys
from datetime import datetime, timedelta, timezone

def archive_expired_logs(target_dir, retention_days):
    """
    扫描目标目录,归档修改时间超过 retention_days 的日志文件
    """
    # 步骤 1: 使用 os.path 验证目录有效性
    if not os.path.exists(target_dir):
        sys.stderr.write(f"错误: 目标路径不存在 '{target_dir}'\n")
        return False
    if not os.path.isdir(target_dir):
        sys.stderr.write(f"错误: 指定路径不是有效目录 '{target_dir}'\n")
        return False

    # 步骤 2: 计算过期时间阈值(统一采用 UTC 时区比对)
    now = datetime.now(timezone.utc)
    cutoff_time = now - timedelta(days=retention_days)
    sys.stdout.write(f"当前时间(UTC): {now.strftime('%Y-%m-%d %H:%M:%S')}\n")
    sys.stdout.write(f"过期判定阈值: {cutoff_time.strftime('%Y-%m-%d %H:%M:%S')} (早于此时间将被归档)\n")

    archived_count = 0
    scanned_count = 0

    # 步骤 3: 使用 os.scandir 高效扫描目标目录
    with os.scandir(target_dir) as entries:
        for entry in entries:
            # 过滤只处理以 .log 结尾的文件,忽略子目录与已归档文件
            if entry.is_file() and entry.name.endswith(".log"):
                scanned_count += 1
                stat_result = entry.stat()
                # 从文件最后修改时间戳构建带 UTC 时区的 datetime 对象
                file_mtime = datetime.fromtimestamp(stat_result.st_mtime, tz=timezone.utc)

                if file_mtime < cutoff_time:
                    # 步骤 4: 构造基于文件修改年月的归档目标目录
                    month_dir_name = file_mtime.strftime("archive_%Y%m")
                    dest_folder = os.path.join(target_dir, month_dir_name)
                    os.makedirs(dest_folder, exist_ok=True)

                    dest_path = os.path.join(dest_folder, entry.name)
                    # 执行安全重命名/移动
                    os.rename(entry.path, dest_path)
                    sys.stdout.write(f"  [已归档] {entry.name} -> {month_dir_name}/\n")
                    archived_count += 1

    sys.stdout.write(f"扫描完毕: 共检查 {scanned_count} 个日志文件,成功归档 {archived_count} 个。\n")
    return True

def main():
    # 步骤 0: 解析与校验 sys.argv 命令行入参
    if len(sys.argv) < 3:
        sys.stderr.write(f"用法: python {sys.argv[0]} <日志目录> <保留天数>\n")
        sys.stderr.write("示例: python log_cleaner.py /var/log/app 30\n")
        sys.exit(1)

    log_directory = sys.argv[1]
    try:
        days = int(sys.argv[2])
        if days < 0:
            raise ValueError("保留天数不能为负数")
    except ValueError as e:
        sys.stderr.write(f"参数类型无效: {e}\n")
        sys.exit(2)

    # 执行核心逻辑
    success = archive_expired_logs(log_directory, days)
    if success:
        sys.exit(0)
    else:
        sys.exit(3)

if __name__ == "__main__":
    main()
当前时间(UTC): 2026-11-01 12:00:00
过期判定阈值: 2026-10-18 12:00:00 (早于此时间将被归档)
[已归档] error_20261010.log -> archive_202610/
[已归档] access_20260930.log -> archive_202609/
扫描完毕: 共检查 12 个日志文件,成功归档 2 个。
$ echo $?
0
六、核心函数速查矩阵与避坑总结
为了便于在日常编写代码时快速查阅与选型,下表和总结图汇总了三个模块最关键函数的职责、返回值形态以及实际使用时的避坑要点。
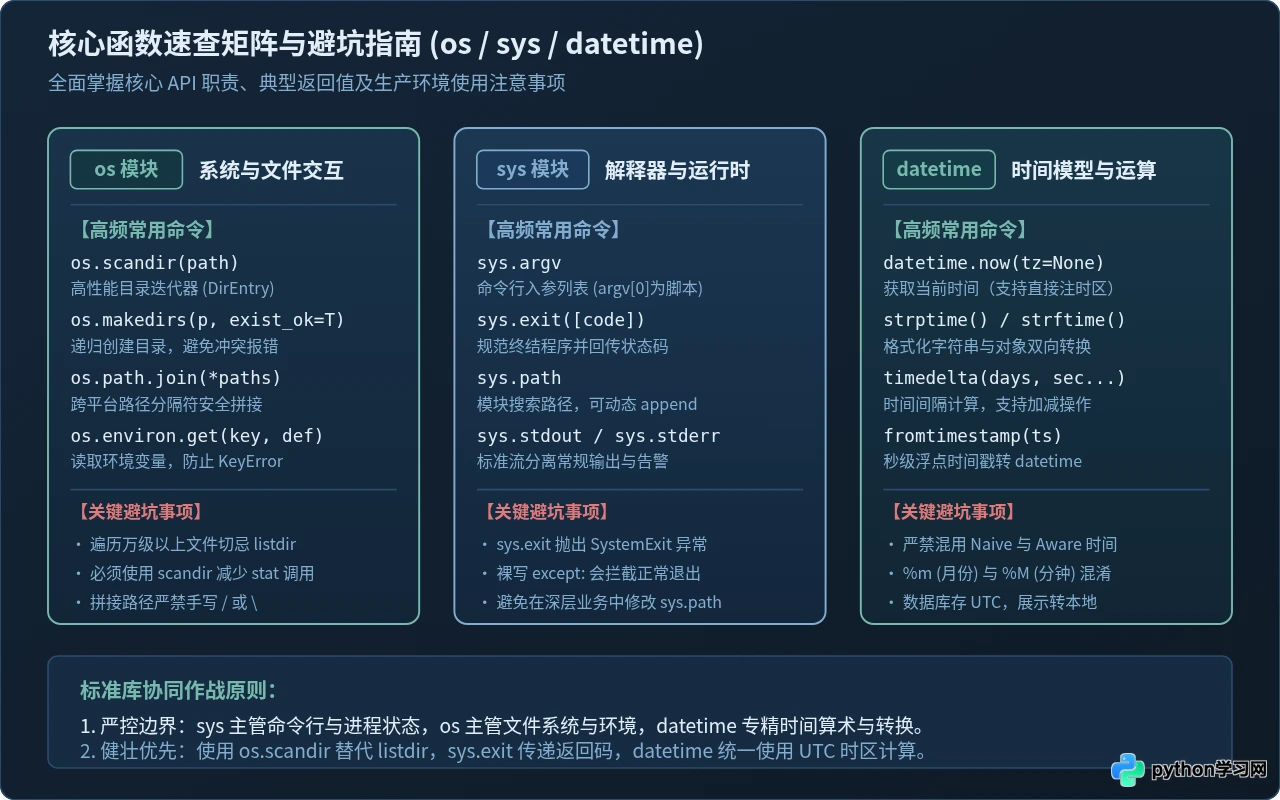
| 模块 | 核心函数 / 属性 | 典型返回值 | 适用典型场景 | 关键避坑事项 |
|---|---|---|---|---|
| os | os.scandir(path) |
迭代器 (DirEntry) | 高效遍历大量文件与子目录 | 建议配合 with 语句使用,避免文件句柄泄露 |
os.makedirs(p, exist_ok=True) |
None | 递归创建多层目录 | 必须指定 exist_ok=True 避免已存在时抛出异常 |
|
os.path.join(*paths) |
str(路径) | 拼接跨平台路径 | 切勿手写硬编码 / 或 \ 分隔符 |
|
os.environ.get(key, def) |
str 或 None | 安全读取系统环境变量 | 切忌用 os.environ[key] 直接取未确认的变量 |
|
| sys | sys.argv |
list[str] | 获取终端传递的调用参数 | 元素全为字符串;务必校验 len(sys.argv) |
sys.exit([code]) |
引发 SystemExit | 规范终结程序并通知外部调用链 | 抛出的是 SystemExit 异常,裸写 except: 会阻断退出 |
|
sys.stdout / sys.stderr |
TextIOWrapper | 分离标准业务输出与错误日志输出 | 管道流传递数据时,应将调试信息输出到 stderr |
|
| datetime | datetime.now(tz) |
datetime 对象 | 获取当前时间点 | 生产环境建议显式指定 timezone.utc |
strptime() / strftime() |
datetime / str | 字符串与时间对象双向转换 | 谨防 %m(月份)与 %M(分钟)的大小写混淆 |
|
timedelta(days, seconds...) |
timedelta 对象 | 时间跨度加减(超时、过期判定) | 只能与 datetime 或 date 对象运算,不能与字符串运算 |
熟练掌握 os、sys 与 datetime 的这套核心命令组合,是编写轻量、高效且鲁棒的 Python 系统工具的基石。在不依赖任何外部轮子的情况下,合理运用解释器状态传递、系统文件操作与时间跨度运算,就能稳定支撑绝大部分日常自动化与工程服务脚本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









