

为什么不建议用Python开发大型商业iOS应用?
深入剖析为什么在大型商业项目中不建议使用Python开发iOS应用,从底层执行架构、构建打包流水线、运行时性能与JIT限制、内存与崩溃排障断层,到团队工程化与苹果审核生态进行全景对比分析。
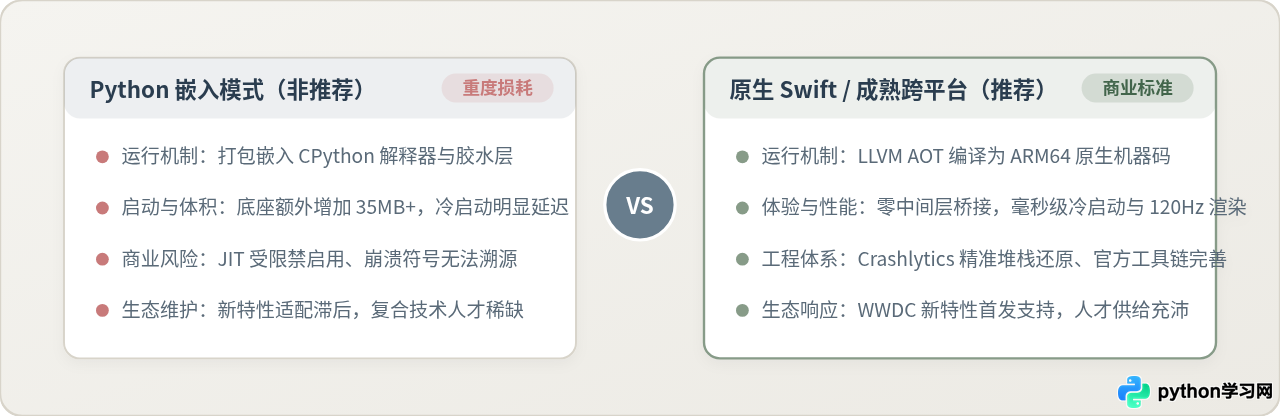
一、底层架构差异:原生直接执行 vs 解释器桥接包装
决定一门技术能否支撑大型商业应用的核心,在于其运行期指令分发与底层操作系统的贴合程度。iOS 作为对交互能效、首屏响应和动画帧率要求极严苛的移动操作系统,其硬件与软件架构是高度为编译型语言量身打造的。
在一致的真机运行条件下,将原生 Swift 架构与 Python 移动端打包方案进行对比,两者的指令执行路径存在根本差异:
- 原生 Swift 架构:源码通过 Clang/LLVM 编译器进行 AOT(Ahead-Of-Time)静态编译,直接生成针对 Apple Silicon 芯片(arm64 架构)优化的机器码。系统内核直接加载执行机器指令,与 UIKit、SwiftUI、Metal 等底层系统库在同一二进制空间直接调用,没有任何中间转发层。内存管理完全由编译器在编译期插入引用计数指令(ARC),运行时无需启动全局垃圾收集线程。
- Python 打包架构:iOS 并不内置 Python 运行环境。为了在 iOS 上运行 Python,必须将预先编译好的 CPython 动态库或静态库(如
libpython3.x.a)随安装包一同内嵌到 App Bundle 中。当应用启动时,由原生 Objective-C/C 入口函数初始化 Python 虚拟机,动态读取打包在沙盒资源中的.py或.pyc文件,在解释器循环中逐行解释执行字节码,并通过 PyObjC 或 C-FFI 胶水层反射调用系统 API。
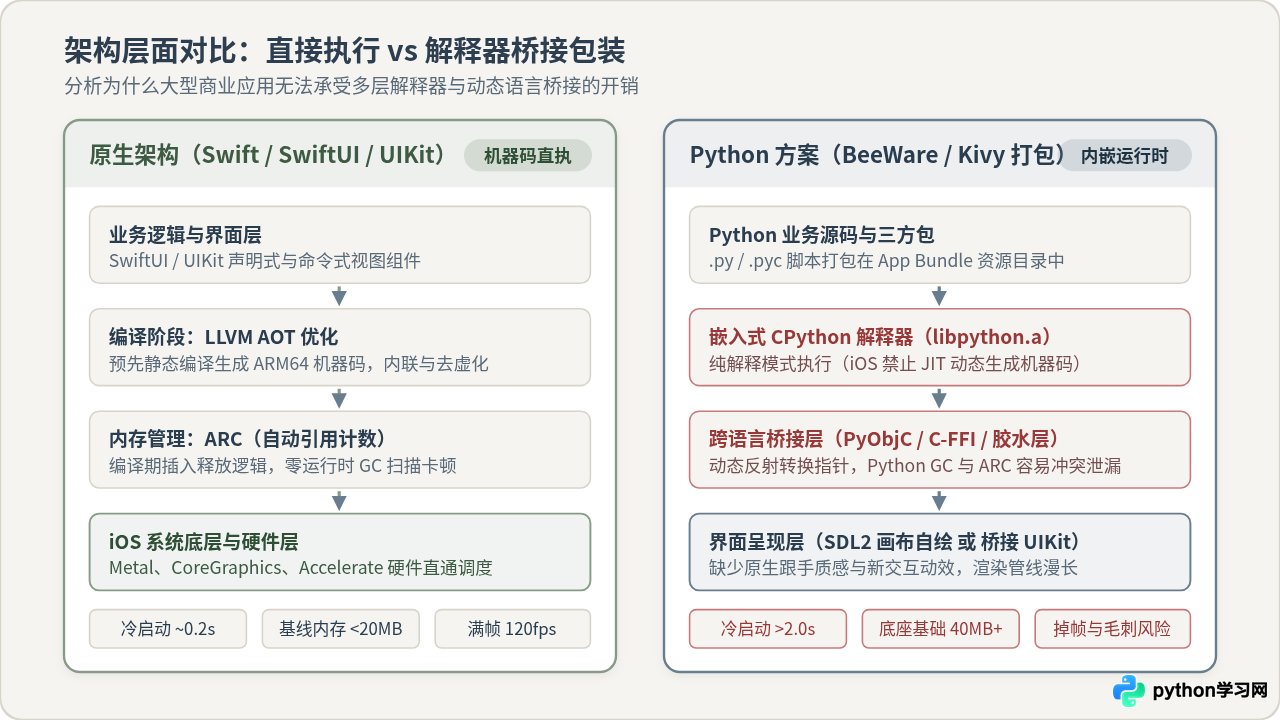
这种底层链路的差异,在大型商业场景中会直接转化为关键指标的差距:
| 评估维度 | 原生 Swift / SwiftUI | Python 移动端方案(BeeWare / Kivy) | 大型商业场景下的影响 |
|---|---|---|---|
| 应用冷启动耗时 | 约 150ms ~ 300ms | 常在 1800ms ~ 3500ms 以上 | 容易超过 iOS 看门狗(Watchdog)阈值,导致启动强杀 |
| 空载基础内存占用 | 约 12MB ~ 20MB | 约 35MB ~ 60MB(内嵌 CPython 解释器底座) | 大型业务叠加后易触碰 Jetsam 内存水位,遭系统后台斩杀 |
| 运行时编译优化 | LLVM 全模块优化、函数内联、去虚化 | 解释器逐行解析字节码,无 JIT 机器码优化 | 复杂数据模型序列化、列表刷新时易出现主线程掉帧 |
| 系统渲染管线 | CoreAnimation 硬件直通加速,稳定 120Hz | SDL2 画布仿真自绘,或经桥接层反射创建视图 | 无法还原 iOS 原生弹性滚动、动效曲线与暗黑模式适配 |
二、构建发布流水线:多级转化与高危脆弱环节
中小型脚本或个人项目只需要打包少量纯 Python 代码,而大型商业 iOS 项目往往依赖庞大的第三方库生态,例如数据加密、网络通信协议、本地数据库、音视频处理与生物识别等。在这一环节,Python 方案的工程化链条极为脆弱。
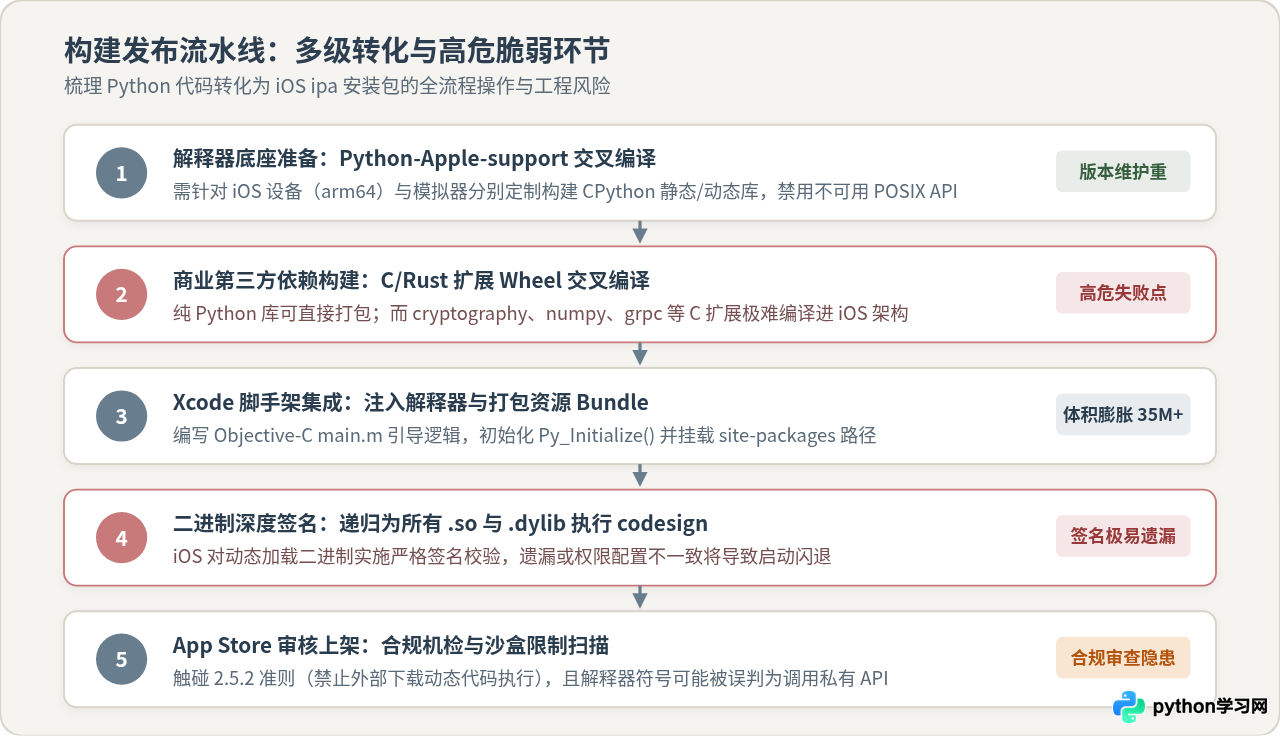
将 Python 代码构建为可上架的 iOS 应用,必须经历以下繁琐的编译与组装流水线:
1. 交叉编译底座依赖
开发者不能直接使用桌面端安装的 Python。必须依赖开源的 Python-Apple-support 针对真机(iphoneos.arm64)和模拟器(iphonesimulator.arm64 / x86_64)分别交叉编译静态库。由于 iOS 沙盒完全移除了部分桌面 POSIX 系统调用(例如 fork()、system()、waitpid() 等),编译阶段必须通过打补丁的方式强行剔除这些标准库模块,否则二进制无法通过链接。
2. 第三方 C/Rust 扩展 Wheel 的编译壁垒
纯 Python 编写的库可以直接以源码或字节码形式打包,但商业应用不可避免需要使用具备 C/Rust 扩展的高性能库(例如 cryptography、numpy、orjson 等)。iOS 的安全机制禁止在运行时编译或直接加载未经 Apple SDK 交叉编译的 .so 文件。为每个带 C 扩展的依赖库手工配置 iOS 交叉编译工具链极其耗时,且随着依赖项小版本升级,很容易因头文件缺失或指令集不兼容导致持续集成(CI/CD)流程频繁瘫痪。
3. 二进制递归签名与代码瘦身难度
iOS 对可执行文件施加了严密的签名与沙盒验证。打包工具必须遍历 Python 包目录中的每一个 .dylib 和 .so 动态共享对象,逐一应用 Apple 开发者证书与 Provisioning Profile 进行 codesign 深度签名。任何遗漏都会导致 App 在真机安装或启动时直接崩溃。此外,由于 Python 解释器及其标准库无法像 Swift 一样进行符号级死代码剔除(Dead Code Stripping),导致即便是一个极简的空壳应用,初始包体积也会多出 35MB 以上。
三、运行时机制陷阱:JIT 禁令、内存割裂与崩溃堆栈断层
当应用进入线上长线运营阶段后,业务的稳定性和异常可排查性是商业团队的生命线。然而,Python 的动态特性与 iOS 系统的安全规范之间存在多处天然冲突。
1. 苹果 App Store 2.5.2 准则与 JIT 限制
根据《App Store 审核指南》第 2.5.2 条规定,应用在 iOS 沙盒中不得下载、安装或执行会引入新功能或特性的可执行代码。同时,iOS 系统对用户态进程严格启用了 W^X(Write XOR Execute) 内存保护机制——任何内存页不能同时具备“可写入”和“可执行”权限。这意味着像 PyPy 这样依赖动态 JIT 编译生成机器指令的高性能 Python 虚拟机在非越狱 iOS 设备上根本无法启动。Python 在 iOS 上只能被迫以纯解释器模式运行,密集的业务运算性能损耗高达数倍至数十倍。
2. 跨语言内存模型冲突与野指针陷阱
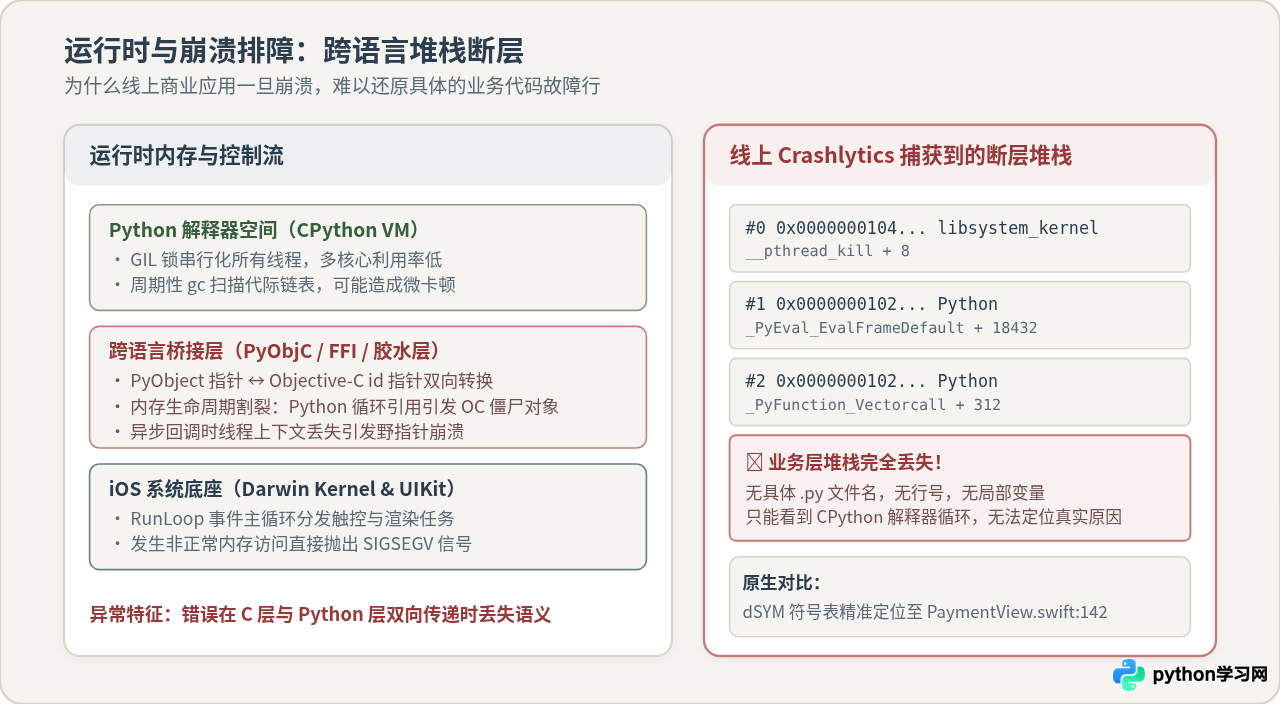
原生 iOS 使用 ARC(自动引用计数),在编译期精准决定对象的析构时机;而 CPython 解释器使用“引用计数 + 周期性代际垃圾收集(GC)”机制。当通过桥接层调用系统控件时,两种截然不同的内存生命周期管理机制交织在一起,极易引发难以察觉的内存灾难:
# 示例:Python 跨语言注册原生回调时典型的生命周期悬空陷阱
from rubicon.objc import ObjCClass, objc_method
from Foundation import NSObject

class PaymentDelegate(NSObject):
    @objc_method
    def onPaymentSuccess_(self, result) -> None:
        # 当原生支付 SDK 异步触发此回调时:
        # 若外层 Python 闭包已被 gc 回收,桥接层代理将指向已释放的内存
        # 此时调用业务数据,直接引发 EXC_BAD_ACCESS (SIGSEGV)
        self.user_session.mark_paid(result)
在原生 Swift 中,通过 [weak self] 可以清晰直观地避免循环引用和悬垂指针;但在 Python 桥接体系中,Python 垃圾收集器无法感知 Objective-C 堆内存的压力,而 Objective-C 的弱引用代理也无法跨越 FFI 边界维护 Python 对象的生命周期,极易在异步回调(如支付结果、网络监听、地理位置变动)中触发随机的内存崩溃。
3. 线上 Crashlytics 符号化彻底断层
对于商业应用而言,一旦线上用户发生崩溃,团队依赖 Sentry、Firebase Crashlytics 或 Bugly 快速定位到具体的代码行号。然而,由于所有业务代码都在 CPython 解释器内部执行,系统崩溃捕获组件只能记录到 Mach 异常和操作系统级别的调用堆栈:
# 线上监控工具收集到的典型 Python iOS 崩溃堆栈(无业务语义):
Thread 0 Crashed:
0   libsystem_kernel.dylib         0x000000018f23a414 __pthread_kill + 8
1   libsystem_c.dylib              0x000000018f1abbb0 abort + 128
2   Python                         0x000000010214ac30 _PyEval_EvalFrameDefault + 18432
3   Python                         0x0000000102138a44 _PyFunction_Vectorcall + 312
4   Python                         0x00000001021510e0 _PyEval_Vector + 120
...
# 结果:没有任何业务代码的 .py 文件名,没有行号,调试排查犹如盲人摸象
因为 dSYM 符号表只能还原 CPython C 源码内部的解释循环符号,无法还原被解释执行的 Python 脚本上下文。大型项目中数以百计的业务模块在发生异常时,排查耗时往往是原生项目的数倍以上。
四、苹果生态迭代与商业团队维护成本
除了纯技术维度的指标外,商业项目的成功更取决于团队协作的持久性和对平台创新的响应速度。
1. 平台新特性的适配时滞
苹果每年在 WWDC 都会推出全新的硬件联动与系统级能力,例如灵动岛实时活动(Live Activities)、小组件体系(WidgetKit)、快捷指令(App Intents)以及与 Neural Engine 深度集成的 CoreML 架构。原生 Swift 开发者可以在发布首日直接调用官方 SDK,在秋季系统正式推送时同步上线商业新特性。
然而,Python 移动端生态没有苹果官方背书,完全依赖民间开源社区的义务维护。面对以 Swift 专属特性(如 @resultBuilder、SwiftUI 宏、Actor 并发模型)构建的新系统能力,Python 桥接工具往往需要经历数月甚至数年的逆向探索与胶水代码开发,导致商业产品无法跟进苹果官方的推荐规范,丧失商业竞争力。
2. 人才招聘与团队协作壁垒
软件工程的长期维护依赖于成熟的人才市场:
- 熟练掌握 Swift、UIKit 和 iOS 原生架构的工程师储备充足,工具链(Instruments、Xcode Test、TestFlight)标准统一;
- 熟悉 Python 的工程师通常深耕于后端 API、分布式架构、大数据与机器学习领域,对移动端事件循环(RunLoop)、视图重绘机制和证书签名几乎没有经验;
- 既精通 iOS 平台底层、又深刻理解 CPython 虚拟机内核并能手动修复跨语言 C-FFI 桥接 Bug 的复合人才极度稀缺。一旦核心搭建者离职,技术选型就会沦为整个团队无法承受的沉重负债。
五、总结:大型商业应用的技术选型决策树
Python 是一门语法优雅、生产力卓越的通用语言,但技术的价值在于将其放置在正确的场景中。对于移动端开发,技术选型必须严谨考量商业目标与工程边界。
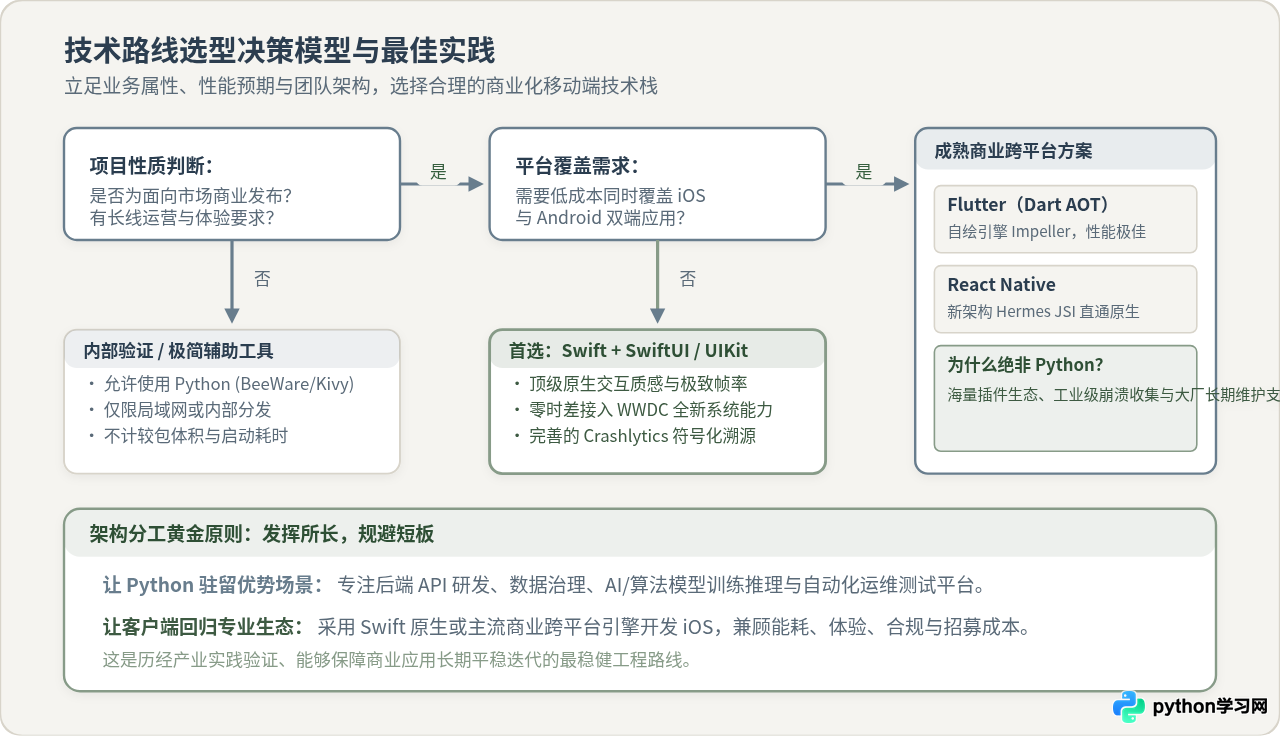
为了帮助技术决策者建立清晰的判断标准,我们归纳出以下选型路径:
- 必须坚决放弃 Python 客户端方案的场景:面向大众用户的商业发布项目、要求 120Hz 细腻动效的高频交互应用、需要调用大量底层系统 API 的复杂应用、长线商业运营的团队协同项目。
- 允许尝试 Python 移动端打包的边界场景:极简的数据展示工具、实验室算法的内部真机原型验证、不需要上架 App Store 的企业内部分发测试脚本。
- 多端跨平台商业需求:若需兼顾 iOS 与 Android 双端开发效率,应优先选择生态成熟、大厂背书且经过千万级商业验证的 Flutter(Dart AOT 编译配合自绘引擎 Impeller)或 React Native(Hermes 引擎与原生通信),这两者拥有完善的崩溃监控与海量成熟插件。
- 追求顶级 iOS 体验的标准路径:采用 Swift + SwiftUI / UIKit 进行原生开发,获得最轻量的内存占用、瞬时的冷启动速度、零时差的系统特性支持与精准的符号化诊断体验。
大型商业项目的健康运转,依赖于“在合适的层级做正确的事”。将 Python 留在服务端的计算引擎、数据治理平台与算法模型中,让客户端回归到遵循苹果平台规则的原生或工业级跨平台体系,是经受住无数商业实践检验的稳健法则。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









