

Python怎么根据另一个日期列表筛选DataFrame中的匹配行

在数据处理任务中,根据一个给定的目标日期列表筛选 Pandas DataFrame 中对应日期的记录,最常用且标准的方法是结合 isin() 方法进行布尔索引。然而在实际业务中,筛选常常因为“数据类型不一致”(例如一侧是字符串另一侧是 Timestamp)或“时间戳中含有时分秒”而导致匹配结果为空。本文将通过清晰的操作步骤、原理剖析和具体示例,系统讲解如何规范且高效地完成这一匹配任务。
一、核心筛选流程与准备工作
无论数据来源是 CSV 文件、数据库还是接口数据,标准化的筛选路径都遵循四个环节:检查源数据类型、对齐目标日期列表类型、按需规范化日期精度,最后执行 isin() 向量化匹配。
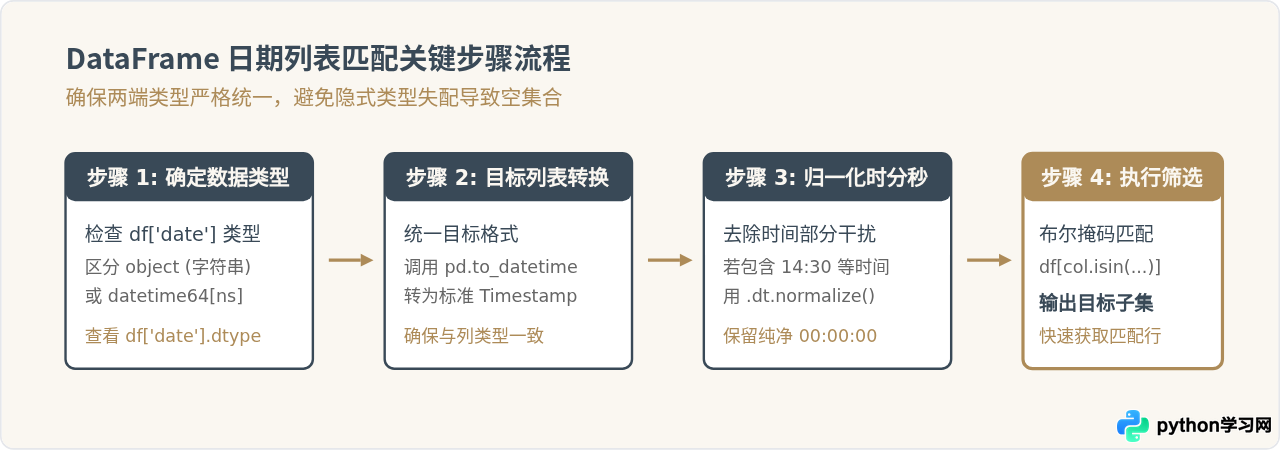
我们首先构建一个包含交易流水与日期的示例 DataFrame,以及一个需要筛选的目标日期列表:
import pandas as pd

# 创建示例 DataFrame
data = {
    'order_id': [101, 102, 103, 104, 105],
    'trans_date': ['2026-03-01', '2026-03-02', '2026-03-03', '2026-03-04', '2026-03-05'],
    'amount': [250, 180, 430, 310, 520]
}
df = pd.DataFrame(data)

# 目标筛选日期列表
target_dates = ['2026-03-02', '2026-03-04', '2026-03-10']
二、场景一:当两端均为标准字符串
如果 DataFrame 的日期列是纯文本格式(形如 YYYY-MM-DD),且传入的目标列表也是同种格式的字符串,可以直接使用 isin():
# 直接进行字符串包含匹配
matched_df = df[df['trans_date'].isin(target_dates)]
print(matched_df)
示例输出:
   order_id  trans_date  amount
1       102  2026-03-02     180
3       104  2026-03-04     310
2026-3-2 或 2026/03/02,而列表给出 2026-03-02,字符串比对将完全判定为不匹配。因此,在生产环境中,强烈建议将所有日期解析为标准时间戳类型再做比对。
三、场景二:标准 Datetime64 类型的对齐与匹配原理
在 Pandas 中,规范的日期列数据类型通常为 datetime64[ns]。当 DataFrame 中的列是时间戳,或者外部日期列表是各种混杂格式(如包含 datetime.date、datetime.datetime 或不同格式的字符串)时,必须先进行类型对齐。
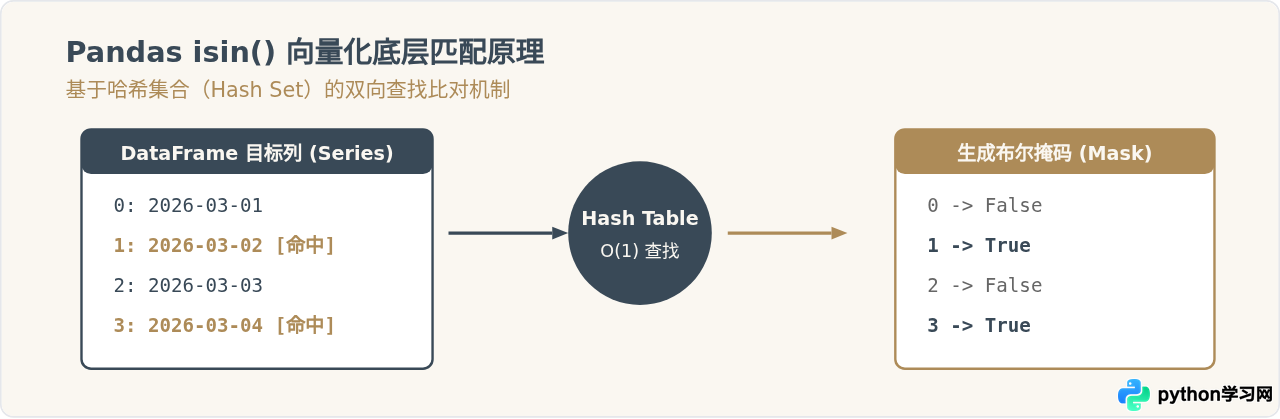
完整的类型转换与匹配代码如下:
# 1. 确保 DataFrame 列转为 datetime64
df['trans_date'] = pd.to_datetime(df['trans_date'])

# 2. 将目标日期列表也转换为 DatetimeIndex 或 Timestamp 列表
target_dates = ['2026-03-02', '2026-03-04', '2026-03-10']
target_datetime_list = pd.to_datetime(target_dates)

# 3. 筛选匹配行
matched_df = df[df['trans_date'].isin(target_datetime_list)]
print(matched_df)
四、关键细节:当数据含有“时分秒”时的截断与归一化
在工程实践中,导致“明明日期在列表中,筛选出来却是空 DataFrame”的最主要原因,就是数据列中附带了具体时间戳(例如 2026-03-02 14:30:15),而目标日期列表只提供了 2026-03-02(隐式对应 00:00:00)。
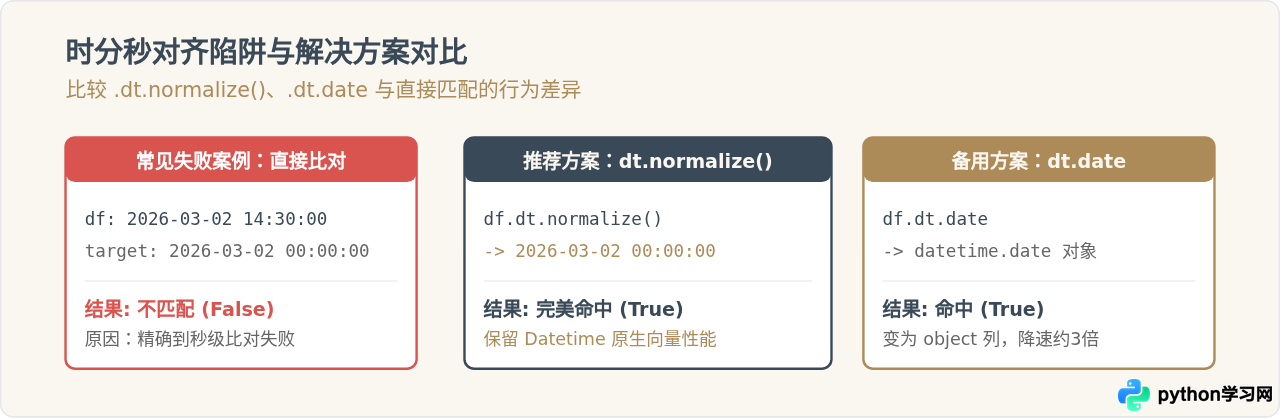
应对时分秒干扰有两种处理方式:
推荐做法(保留高性能 Datetime64): 使用 .dt.normalize() 将具体时间戳重置为当天的 00:00:00:
# 带有具体时分秒的列
df['created_at'] = pd.to_datetime(['2026-03-02 09:15:00', '2026-03-02 18:22:10', '2026-03-03 11:00:00'])

# 目标仅给出日期
target_dates = pd.to_datetime(['2026-03-02'])

# 使用 normalize() 将时间统一归零后再比对
matched_df = df[df['created_at'].dt.normalize().isin(target_dates)]
print(matched_df)
纯日期对象比对(适用于少量数据): 使用 .dt.date 属性提取出 Python 原生的 datetime.date 对象:
import datetime

# 目标为 datetime.date 列表
target_dates = [datetime.date(2026, 3, 2)]

# 提取 df 的日期对象比对
matched_df = df[df['created_at'].dt.date.isin(target_dates)]
五、性能对比与选型建议
在不同的数据量级下,筛选策略的选择会对耗时产生明显影响。下表总结了常见场景下的实现差异与推荐策略:
| 场景分类 | 推荐代码方式 | 时间复杂度 | 适用场景与建议 |
|---|---|---|---|
| 纯日期时间戳 (无时分秒) | df[df['col'].isin(pd.to_datetime(dates))] |
O(N) | 最理想格式,原生 C 级矢量化查找,性能最高 |
| 包含时分秒 (需按天匹配) | df[df['col'].dt.normalize().isin(pd.to_datetime(dates))] |
O(N) | 避免产生 Python object,维持 datetime64 底层数组 |
| 索引即为 DatetimeIndex | df[df.index.normalize().isin(pd.to_datetime(dates))] |
O(N) | 直接针对索引筛选,无需额外扫描列 |
| 海量目标日期 (超10万个) | 使用 merge(right_df, on='date') |
O(N log M) | 当目标集合极庞大时,哈希关联比逐行掩码吞吐更强 |
六、总结
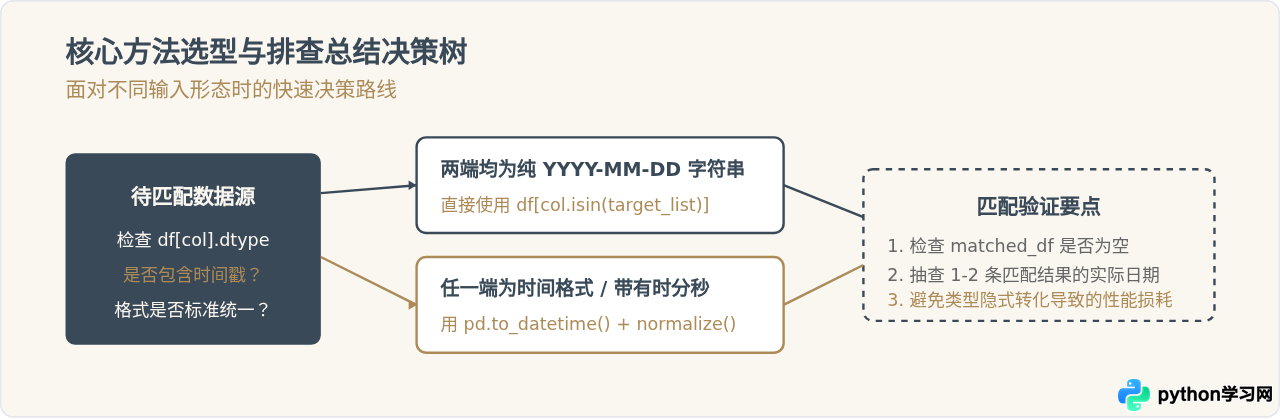
在 Python 中利用另一个日期列表筛选 DataFrame 匹配行,核心是先对齐两端的底层数据类型,再调用 isin() 向量化方法。只要牢记排查时分秒(使用 .dt.normalize() 归一化)和保持 pd.to_datetime() 标准化,便能彻底避免空匹配与低效率问题,编写出健壮、高效的数据筛选脚本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









