

怎么用Python切片反转字符串?负数步长使用技巧
深入解析如何在Python中利用切片负数步长反转字符串,从s[::-1]的底层缺省边界推导,到显式start与stop区间的方向匹配规则及常见陷阱。
在 Python 中,反转字符串最经典且高效的写法是 s[::-1]。它的原理在于利用序列切片的第三个参数——步长(step)。当步长指定为负整数时,Python 切片机制会改变默认的索引遍历方向,从序列末尾向起始端逆序提取元素。本文将系统拆解负数步长的运作模型、缺省边界补全规则、显式区间的匹配原则以及实际编码中的关键避坑细节。
一、切片基本模型与负数步长原理
Python 序列切片的标准完整语法为 sequence[start:stop:step],其中包含三个控制参数:
- start:切片起始位置的索引(闭区间,包含该位置对应的元素)。
- stop:切片终止位置的索引(开区间,不包含该位置对应的元素)。
- step:步长值,决定遍历的方向与每次移动的元素跨度。
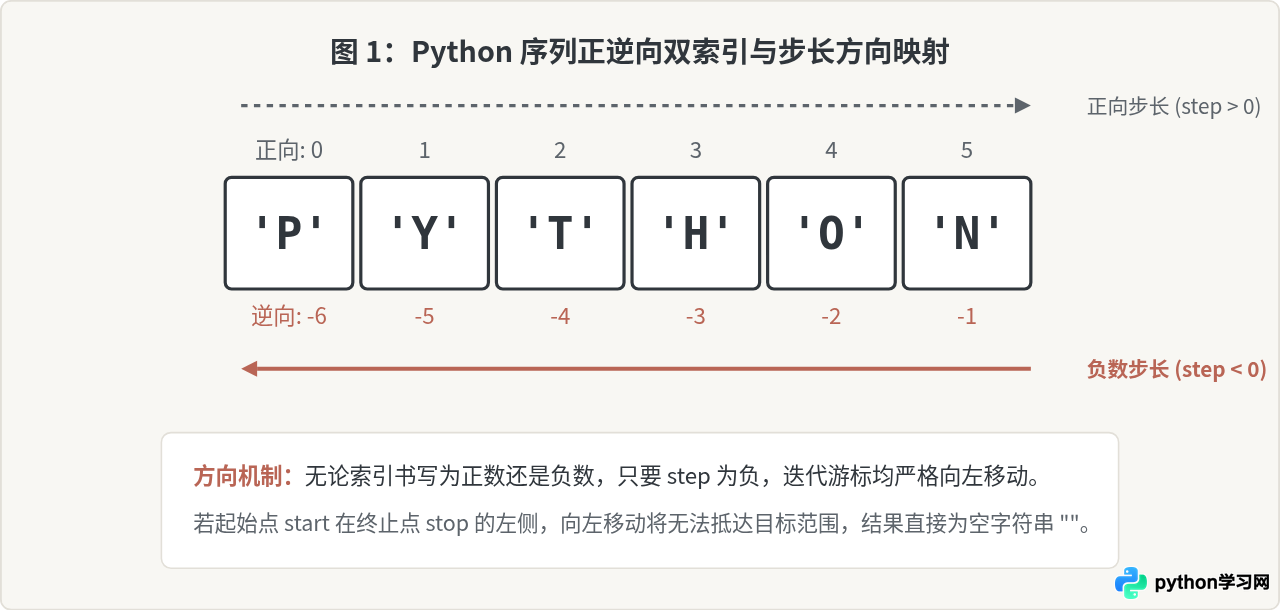
在常规切片中,若 step > 0,遍历方向为从左至右,索引递增;而当 step < 0 时,遍历方向被翻转为从右至左,索引递减。此时,不仅移动方向发生了变化,系统在未显式传递 start 和 stop 时所采用的缺省边界值也会同步翻转。
二、为什么 s[::-1] 能反转整个字符串?缺省边界推导
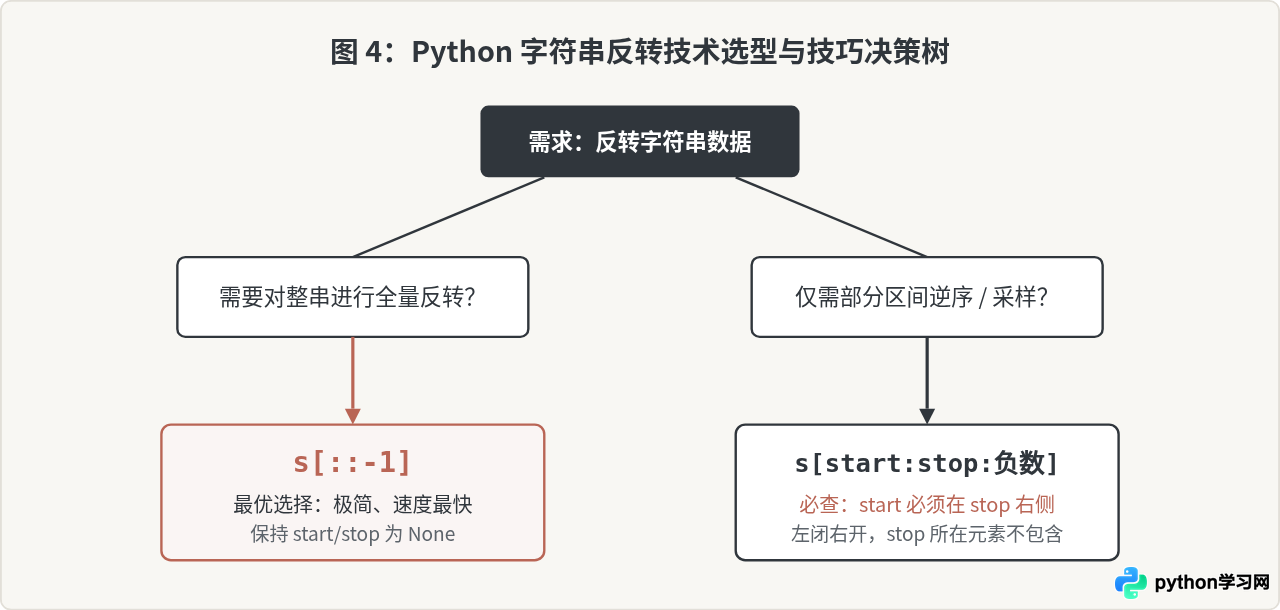
当编写 s[::-1] 时,前两个冒号之间的 start 和 stop 均被省略(值为 None)。许多初学者误以为 s[::-1] 等价于 s[-1:0:-1],这是一种非常典型的认知偏差。
在 Python 的切片协议中,None 是具有特殊语义的占位符。切片机制会根据 step 的正负号动态指派边界:
- 当
step > 0且参数为None时:start默认为序列开头(索引0),stop默认为序列末尾之后(索引len(s))。 - 当
step < 0且参数为None时:start默认为最后一个元素的位置(正向索引len(s) - 1),而stop默认为第一个元素之前的位置(在数学概念上相当于索引 -1 的左侧,涵盖索引 0)。
如果错误地显式写为 s[-1:0:-1],根据切片“左闭右开”(在反向时为“包含 start,排除 stop”)的原则,索引为 0 的首字符会被排除在外:
text = "PYTHON"

# 错误写法:索引 0 的字符 'P' 会被排除
wrong_res = text[-1:0:-1]
print("text[-1:0:-1] 结果:", repr(wrong_res))  # 示例输出: 'NOHTY'

# 正确全反转写法:保留 None 自动包含全部字符
correct_res = text[::-1]
print("text[::-1] 结果:", repr(correct_res))   # 示例输出: 'NOHTYP'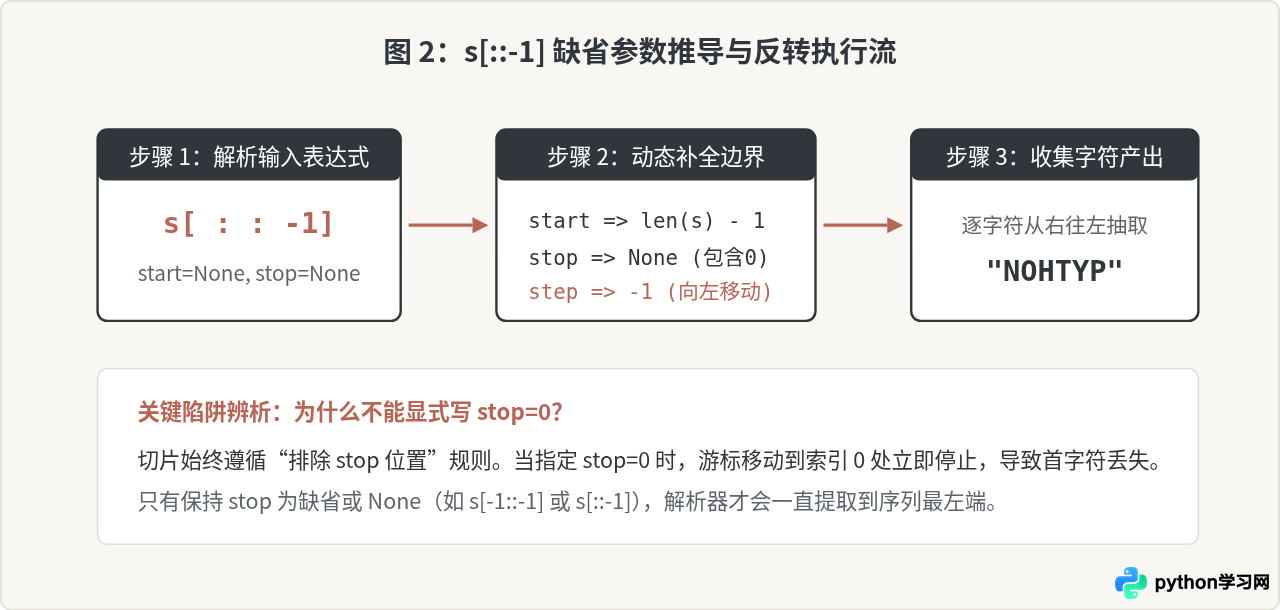
三、显式指定 start 与 stop 的技巧与边界陷阱
在实际业务中,我们有时只需要反转字符串中的某一部分子串。此时需要显式指定 start 与 stop。使用负数步长进行局部截取时,必须遵守“方向一致性原则”。
1. 正确写法:start 在 stop 的右侧
因为负数步长要求向左移动,所以 start 所代表的物理位置必须在 stop 所代表的物理位置右边(即对应元素序号满足 start > stop)。
s = "ABCDEF"

# 截取从索引 4 ('E') 开始,向左到索引 1 ('B') 之前停止
# 提取的索引依次为: 4, 3, 2 (排除 stop=1)
sub_rev = s[4:1:-1]
print("s[4:1:-1] 结果:", repr(sub_rev))  # 示例输出: 'EDC'
2. 常见错误:区间方向与步长方向冲突
若依然按照正向思维编写 s[1:4:-1],Python 不会报语法错误或抛出异常,而是直接返回空字符串 ""。因为从索引 1 出发向左递减(变为 0, -1...),永远无法到达右侧的目标索引 4。
# 错误示例:起始位置在终止位置左侧,但步长为负
empty_res = s[1:4:-1]
print("s[1:4:-1] 结果:", repr(empty_res))  # 示例输出: ''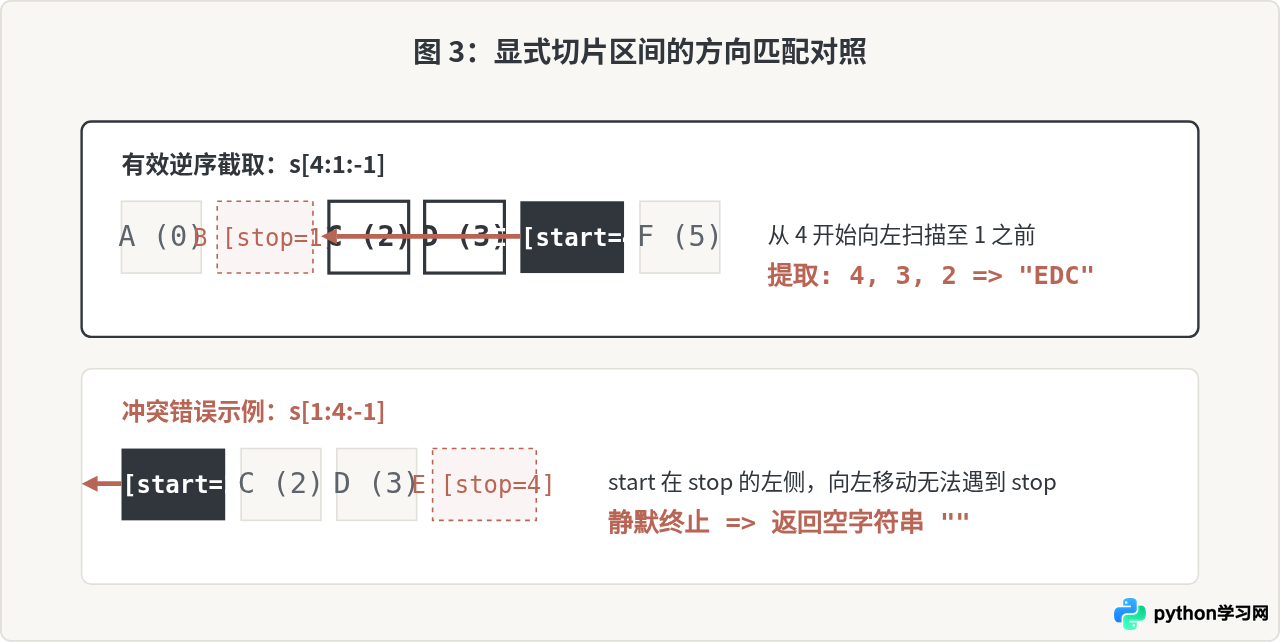
四、步长绝对值大于 1 的高级技巧
负数步长除了 -1 之外,还可以使用 -2、-3 等整数。此时步长绝对值 |step| 代表每次跨越的字符步长,实现“逆序跳跃提取”或“倒序采样”。
numbers = "0123456789"

# 逆序且每隔 1 个字符提取 1 次
rev_even = numbers[::-2]
print("numbers[::-2]:", repr(rev_even))  # 示例输出: '97531'

# 逆序且每隔 2 个字符提取 1 次
rev_stride3 = numbers[::-3]
print("numbers[::-3]:", repr(rev_stride3))  # 示例输出: '9630'
此类技巧在处理固定格式序列(如逆向解析带校验位的编码、按周期提取信号数据)时非常简洁,避免了先反转全串再二次取切片的繁琐步骤。
五、性能表现与方案对比:切片 vs reversed()
在 Python 中,实现字符串反转的常见替代方案是使用内置函数 reversed() 与 str.join() 配合。我们可以从时间性能与语义适用性进行客观对比:
| 对比维度 | 切片语法 s[::-1] |
''.join(reversed(s)) |
|---|---|---|
| 执行效率 | 极高。在 CPython 层面由底层 C 语言直接计算指针与步长,避免了 Python 字节码层面的多次循环开销。 | 较低。需要创建 reversed 迭代器对象,并在 Python 解释器循环中逐项迭代,开销通常是切片的 2~4 倍。 |
| 代码可读性 | 对熟悉 Python 切片的开发者极其简洁;对初学者而言略显抽象。 | 语义直白明确,reversed 单词本身清楚表达反转意图。 |
| 内存开销 | 即时分配反转后新字符串的内存空间。 | reversed() 生成迭代器(O(1) 空间),但最终 join() 仍会构建完整的反转字符串。 |
| 适用对象 | 仅支持支持切片协议(实现了 __getitem__)的序列类型(如 str, list, tuple)。 |
支持任意可反向迭代的序列类型。 |
最佳实践建议:在普通的字符串反转场景下,优先使用 s[::-1]。它不仅是 Python 社区公认的惯用写法(Pythonic),而且凭借 C 语言底层的内存块复制优化,在大规模文本处理时拥有极大的性能优势。
六、注意事项与易混淆细节
-
Unicode 与组合字符:
切片反转是针对 Python 字符串代码点(Code Points)进行的物理反转。如果字符串中包含带有组合标记的字符(如变音符号
é,即'e\u0301')或复杂的 Emoji 族字(包含零宽连接符 ZWJ),反转后会导致组合标记附着到错误的字符上或 Emoji 分裂。如果处理复杂的自然语言文本,应使用专门的 Unicode 文本库(如regex模块的\X匹配集族)处理。 -
不可变性:
Python 字符串属于不可变类型(immutable),
s[::-1]操作不会修改原有字符串变量s本身,而是构建并返回一个全新的字符串对象。 -
负数索引不等于负数步长:
s[-5:-1]中的-5和-1是索引,其隐含的步长依然是默认的+1(正向切片);而s[::-1]中的-1是步长,决定扫描方向。初学者切勿将二者混淆。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









