

怎么在Python遍历字典时按条件筛选数据?
详细讲解在Python遍历字典时按条件筛选数据的标准方法与最佳实践,深入剖析字典推导式(Dictionary Comprehension)、items()键值解构、原地删除字典的运行时陷阱与副本安全机制,助你写出高效、优雅且安全的Pythonic代码。
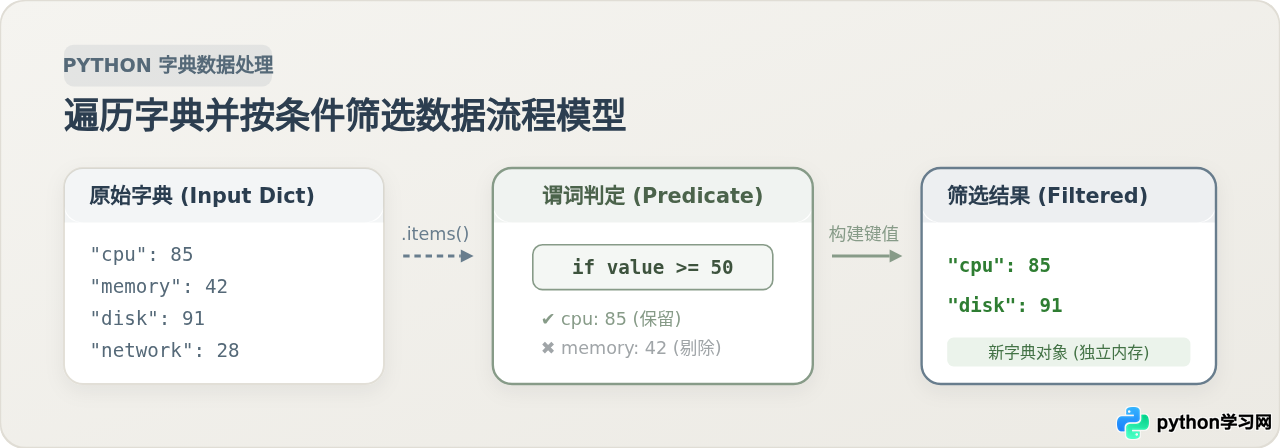
在 Python 中,遍历字典并按条件筛选数据的最推荐做法是使用字典推导式(Dictionary Comprehension),语法结构为 {k: v for k, v in d.items() if 条件}。该语法通过 C 语言底层优化一次性扫描键值对,筛选并返回一个崭新的字典对象,既简洁优雅又无副作用。如果程序因外部引用依赖必须原地修改原始字典,则切忌在直接遍历时执行删除,而必须借助 list(d.keys()) 复制键列表副本后再调用 del。本文将系统梳理这两种核心方案的具体代码、边界细节与底层机制差异。
一、首选解法:使用字典推导式构造新字典
Pythonic 编程哲学的核心之一是“纯函数式变换优于破坏性修改”。对于绝大多数数据处理场景,我们希望从一个原始字典中过滤出符合业务逻辑的子集,此时字典推导式是绝对的首选。
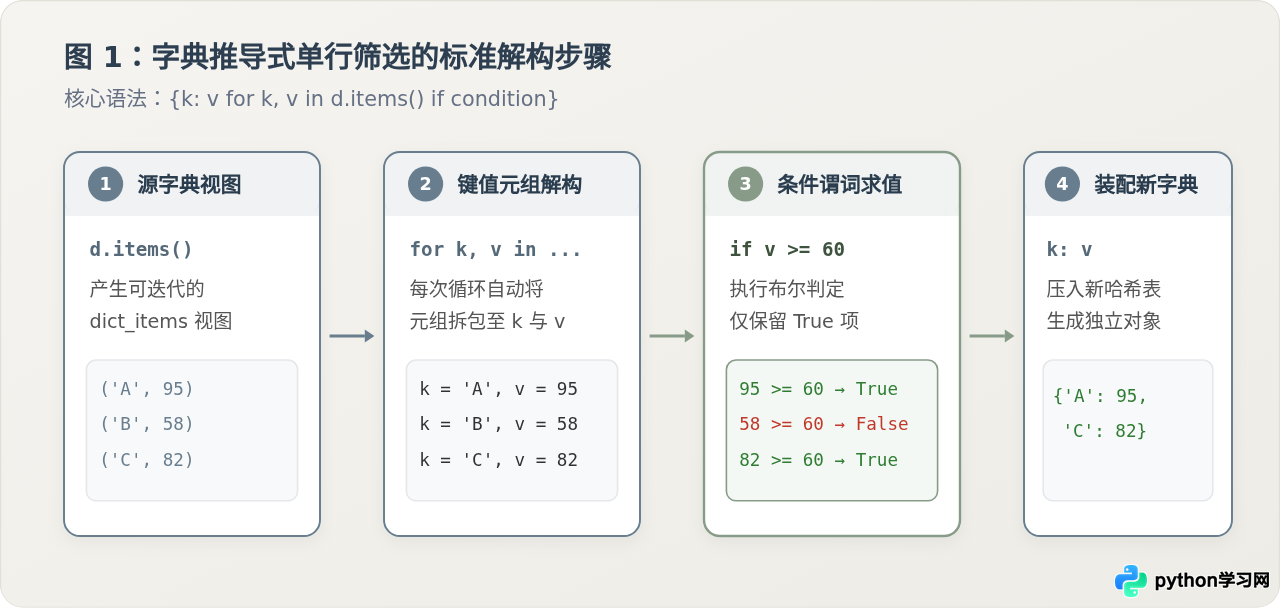
1. 字典推导式的核心语法解构
字典推导式的基本结构如下:
# 字典推导式通用模板
new_dict = {k: v for k, v in original_dict.items() if condition}
其中,original_dict.items() 返回一个包含所有 (key, value) 元组的动态视图;for k, v in ... 将每个元组依次解包至变量 k 和 v;尾部的 if condition 则对每对键值进行布尔判定。只有判定结果为 True 的键值对,才会被装配至新字典中。
2. 常见维度的筛选完整示例
场景 A:根据值(Value)进行阈值或状态筛选
例如,在监控系统中过滤出 CPU 使用率高于或等于 80% 的高负载服务:
server_loads = {
    "auth_service": 45,
    "payment_gateway": 88,
    "order_worker": 92,
    "search_node": 76
}

# 仅保留负载 >= 80 的服务
high_load_servers = {k: v for k, v in server_loads.items() if v >= 80}

print(high_load_servers)场景 B:根据键(Key)的命名规则进行过滤
例如,提取出配置字典中所有以 app_ 开头的生产环境变量:
config_params = {
    "app_port": 8080,
    "debug_mode": False,
    "app_timeout": 30,
    "log_level": "INFO"
}

# 筛选键名前缀为 'app_' 的项
app_configs = {k: v for k, v in config_params.items() if k.startswith("app_")}

print(app_configs)场景 C:键与值的复合条件筛选
我们可以在 if 子句中通过 and 或 or 组合多个逻辑条件,同时对键与值进行约束:
metrics = {
    "latency_us": 120,
    "latency_eu": 450,
    "qps_us": 12000,
    "latency_ap": 80
}

# 复合条件:键包含 'latency' 且 延迟数值大于 100
high_latencies = {
    k: v for k, v in metrics.items()
    if "latency" in k and v > 100
}

print(high_latencies)二、深入底层:原地修改字典与遍历删除的陷阱
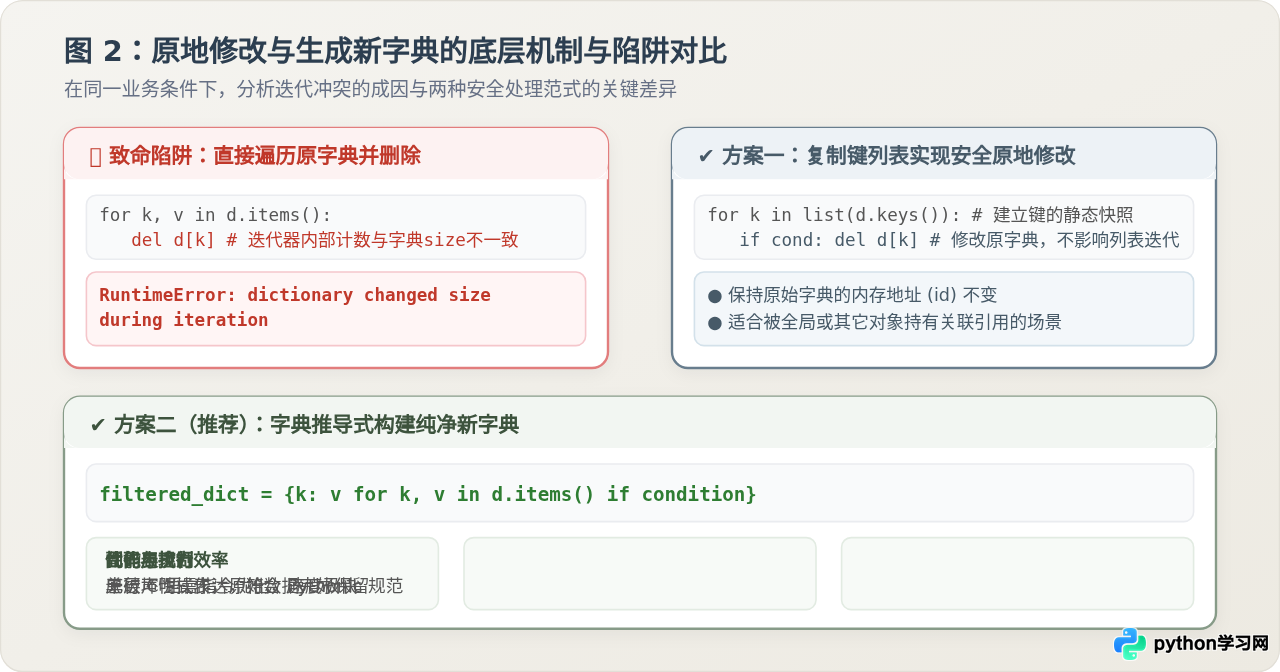
初学者在尝试筛选字典时,常有一种直觉:通过 for 循环直接遍历原始字典,若发现某个键值不满足条件,就立刻使用 del dict[k] 将其从字典中剔除。这种做法会直接引发 Python 解释器的严重报错。
RuntimeError: dictionary changed size during iteration。
1. 为什么直接遍历删除会引发 RuntimeError?
Python 字典底层基于哈希表(Hash Table)实现。当你调用 for k, v in d.items(): 或 for k in d: 时,Python 会创建一个内部字典迭代器。为了保证数据遍历的确定性与避免哈希槽重排导致的死循环或漏读,迭代器内部维护着字典的修改计数器(Version Tag)以及哈希槽索引。
如果在迭代执行中调用了 del d[k],字典的实际长度发生了变化,迭代器在下一次取值时检测到哈希表尺寸被破坏,便会主动触发 RuntimeError 终止程序,以保护底层内存安全。
2. 原地修改的安全解法:基于键列表快照
如果因为架构设计或外部模块强引用,必须就地修改(In-Place Mutation)原字典对象(即要求修改后 id(d) 保持不变),正确的做法是:先将字典的全部键提取为一个独立的列表快照,再遍历该快照列表来删除原字典中的键。
完整代码如下:
device_status = {
    "router_1": "offline",
    "switch_1": "online",
    "ap_north": "offline",
    "ap_south": "online"
}

original_id = id(device_status)

# list(device_status.keys()) 生成独立的内存列表,切断了遍历与字典哈希表的关联
for device in list(device_status.keys()):
    if device_status[device] == "offline":
        del device_status[device]

print("筛选后的原字典:", device_status)
print("内存地址未改变:", id(device_status) == original_id)内存地址未改变: True
3. 两种做法的关键机制差异对比
为什么推导式是日常首选,而列表副本仅用于特殊场合?我们在相同测试条件下分析两者的核心差异:
| 对比维度 | 字典推导式 (生成新字典) | list(keys) 副本遍历 (原地删除) |
|---|---|---|
| 目标与结果 | 生成一个全新的字典对象 | 在原字典内存地址上直接修改 |
| 外部引用安全性 | 不会对外部持有该字典的其它变量产生附带影响(纯函数) | 所有持有该字典引用的地方都会同步感知变化(有副作用) |
| 时间复杂度与性能 | 高:一次线性遍历完成构建,受 CPython 底层循环优化 | 较低:除构建 keys 列表开销外,每次 del 均需二次执行哈希寻址 |
| 内存占用特征 | 短时间内需要容纳新旧两个字典的内容 | 仅额外占用一个仅含键引用的扁平列表,释放被删键值对 |
| 代码简洁性 | 单行表达,声明式语法,可读性极佳 | 多行过程式循环,略显冗长 |
三、复杂业务场景下的实用筛选模式
在实际工程开发中,数据往往不会只是简单的扁平键值对。面对嵌套数据、特定键集合匹配等复杂场景,可以采用以下专业模式。
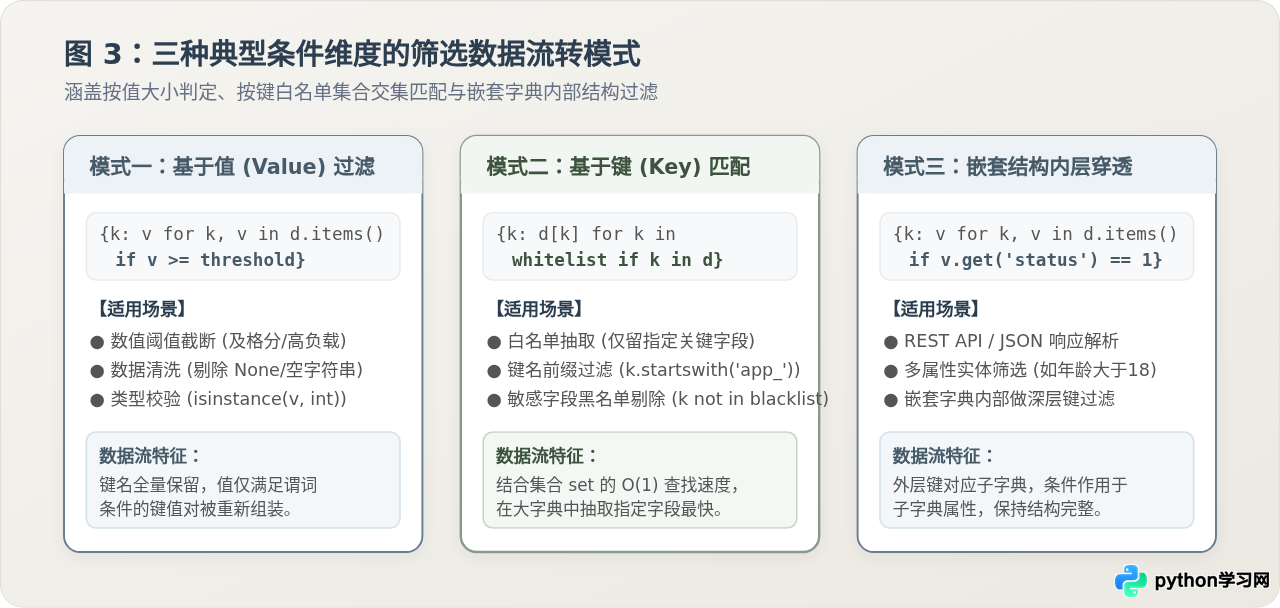
1. 嵌套字典(Nested Dictionaries)的深层条件筛选
处理来自 Web 接口或 JSON 格式的字典时,字典的值往往又是子字典。此时通常需要根据子字典的某一个属性来决定外层项的留存:
users = {
    "u101": {"name": "Alice", "role": "admin", "active": True},
    "u102": {"name": "Bob", "role": "guest", "active": False},
    "u103": {"name": "Charlie", "role": "admin", "active": False},
    "u104": {"name": "Diana", "role": "member", "active": True}
}

# 筛选出所有角色为 admin 且 状态为 active 的用户
active_admins = {
    uid: info for uid, info in users.items()
    if info.get("role") == "admin" and info.get("active") is True
}

print(active_admins)info.get("field") 而不是 info["field"],这样即使部分记录缺少某个字段,也不会引发 KeyError 异常。
2. 提取指定白名单字段(高频超大数据集优化)
如果你有一个拥有成千上万个字段的超级大字典,而业务只需要从中抽取 3 个已知的白名单字段,直接遍历全量字典的 items() 会浪费大量的迭代检查时间。此时更高效的做法是直接遍历白名单集合:
huge_record = {f"col_{i}": i for i in range(100000)}
target_whitelist = {"col_5", "col_99", "col_9999", "non_existent"}

# 高效解法:遍历 target_whitelist 而非 huge_record
extracted = {
    k: huge_record[k]
    for k in target_whitelist
    if k in huge_record
}

print(extracted)3. 函数式替代方式:使用 filter() 与 dict()
Python 还提供了内置函数 filter()。虽然在现代 Python 中字典推导式更为流行,但在配合高阶函数或现成的谓词函数时,filter() 同样具备很高的表达力:
scores = {"math": 95, "history": 58, "physics": 84}

# lambda 参数接收 (key, value) 元组,item[1] 表示值
passing_scores = dict(filter(lambda item: item[1] >= 60, scores.items()))

print(passing_scores)四、方案选型总结与决策指南
面对不同的工程需求,应当选择哪种筛选方式?我们可以通过下方的选型决策流程来快速判定:
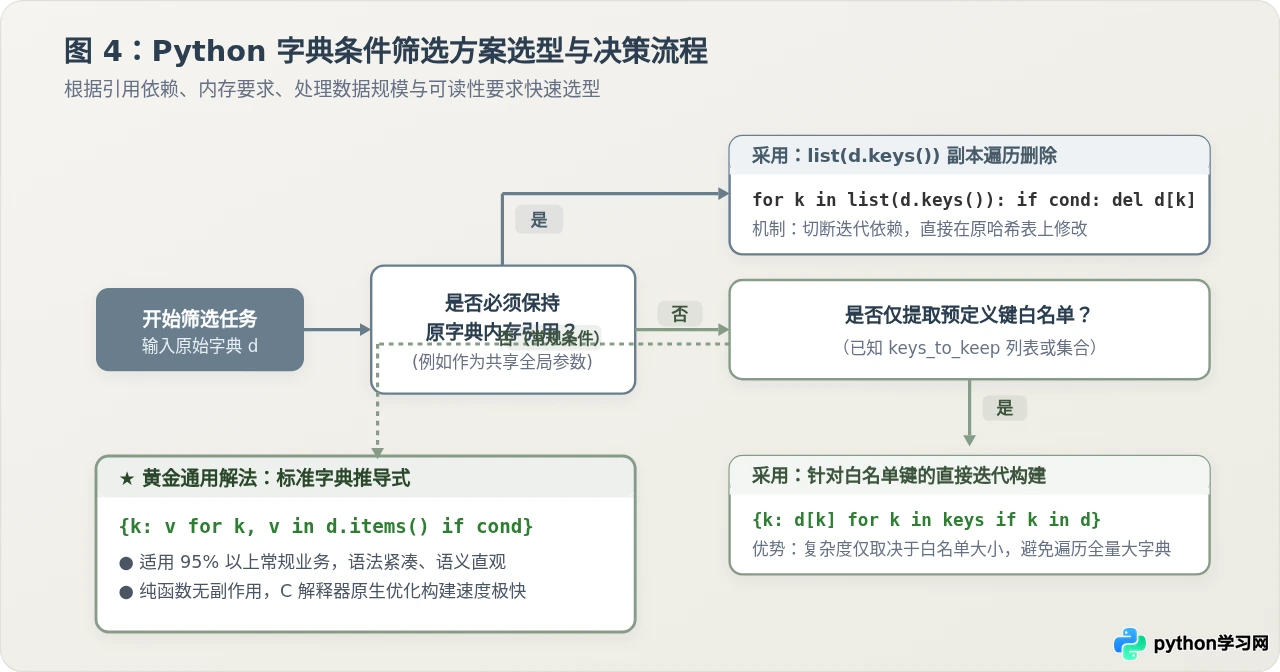
- 绝大多数常规场景(90% 以上):首选标准字典推导式
{k: v for k, v in d.items() if condition}。逻辑紧凑、阅读心智负担低,原生 C 优化执行速度最快。 - 内存敏感或跨组件共享实例:如果字典体积极大且必须避免新分配内存,或者原字典已被其他组件以传参引用绑定,采用
for k in list(d.keys()): if condition: del d[k]实施原地删除。 - 超大字典中提取少数固定字段:颠倒迭代主体,直接对白名单集合进行循环提取
{k: d[k] for k in whitelist if k in d},将复杂度从大字典的规模降至白名单集合的规模。
遵循以上原则,不仅能够规避运行时迭代尺寸变更的致命异常,更能写出兼具可读性与高执行效能的优质 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









