

Python pandas读取CSV数据转换为list的方法
详细讲解使用Python pandas读取CSV文件并将其转换为不同形态列表(一维列表、二维嵌套列表、字典列表)的具体操作方法、代码示例与缺失值处理技巧。
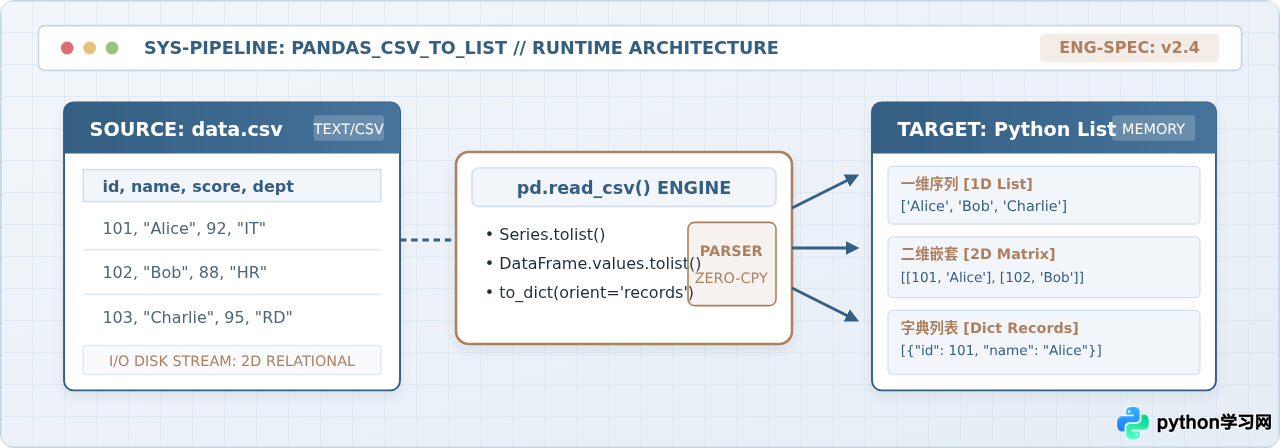
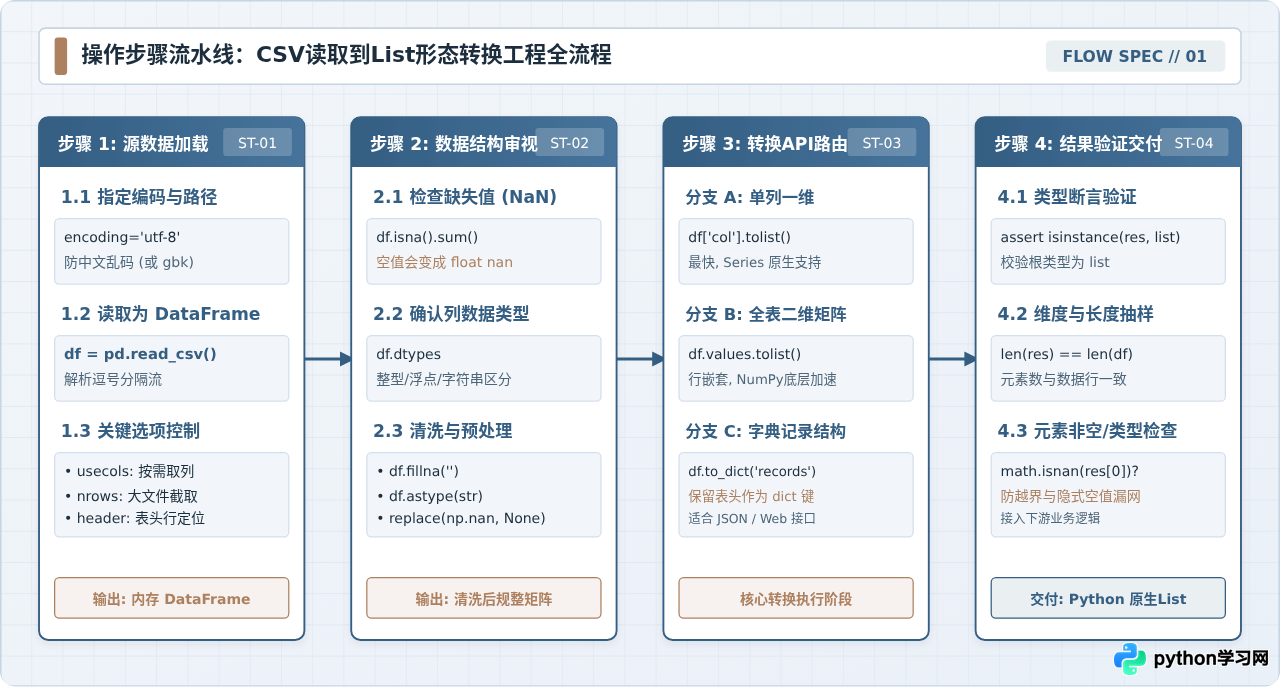
list(列表)的核心路径取决于期望的数据维度与下游用途:提取单列数据为一维列表使用 df['列名'].tolist();将整张表格转换为按行嵌套的二维列表使用 df.values.tolist();若需要保留列名作为键、生成字典列表以对接 JSON 或 Web API,则使用 df.to_dict(orient='records')。本文按实际操作顺序,完整讲解从 CSV 文件读取、数据结构核验、不同维度列表转换到缺失值(NaN)与类型规整的具体实现方法与注意事项。
一、基础准备与示例数据读取
在进行数据转换前,先确认 Python 运行环境中已经安装了 pandas 库。如未安装,可在终端运行 pip install pandas。在 Python 脚本开头导入库:
import pandas as pd
import numpy as np
为了保证全文代码可直接复现且前后变量一致,我们以一个员工信息文件 employees.csv 为例。该 CSV 文件内容包含工号、姓名、部门与薪资,其中包含少量空单元格:
id,name,department,salary
101,张伟,技术部,15000
102,李芳,运营部,12000
103,王强,,13500
104,赵敏,市场部,
使用 pd.read_csv() 读取本地 CSV 文件至内存,生成一个 DataFrame 对象:
# 统一读取数据,指定编码避免中文乱码
df = pd.read_csv('employees.csv', encoding='utf-8')
print(df)0 101 张伟 技术部 15000.0
1 102 李芳 运营部 12000.0
2 103 王强 NaN 13500.0
3 104 赵敏 市场部 NaN
在这一阶段,关键选项包括:若文件较大仅需提取部分列,可传入 usecols=['id', 'name'] 减少内存开销;若中文文件名或内容在 Windows 系统下报错,可尝试指定 encoding='gbk'。读取完成后,即可根据具体业务需求进入不同的转换步骤。
二、提取单列数据为一维列表(1D List)
当只需要 CSV 中的某一列特征(例如用户 ID 列表、姓名名单或标签序列)时,应提取该列对应的 Series 并调用 .tolist() 方法。
1. 标准做法:Series.tolist()
# 提取 name 列并转为原生 Python 列表
name_list = df['name'].tolist()
print(name_list)
print("类型:", type(name_list))类型: <class 'list'>
2. 备选写法与原理说明
在 Python 中,还可以通过内置函数 list(df['name']) 或 NumPy 属性 df['name'].values.tolist() 达到相同目的。但在生产代码中推荐首选 df['name'].tolist()。原因是 Pandas 的 Series.tolist() 是官方直接封装的 C/Cython 级导出接口,无需经过 Python 解释器层面的迭代器包装,内存占用和耗时表现最稳定。
3. 去重与过滤后再转列表
如果该列存在重复项,可在转换前直接调用 drop_duplicates() 或 dropna() 链式调用:
# 提取非空且去重后的部门列表
unique_dept_list = df['department'].dropna().drop_duplicates().tolist()
print(unique_dept_list)三、全表数据转换为二维嵌套列表(2D Nested List)
在需要将整个表格传递给纯算法模型、批量数据库插入语句(如 cursor.executemany)或进行按行遍历时,通常需要将整表转为外层代表行、内层代表单元格的二维嵌套列表结构。
1. 核心方法:df.values.tolist()
# 转换为二维行嵌套列表
matrix_list = df.values.tolist()
print(matrix_list)
在较新的 pandas 版本中,也可以使用 df.to_numpy().tolist(),两者底层行为完全一致。该方法直接将底层连续的二维 NumPy 数组转换为 Python 原生嵌套列表,执行速度极快。
2. 包含表头(列名)的完整二维报表列表
默认情况下,df.values.tolist() 仅导出数据行,不包含表头列名。如果需要将列名作为第一行(例如用于写入新的文件或传递给前端表格组件),可将 df.columns.tolist() 与数据列表进行拼接:
# 获取表头与数据的合并列表
header = df.columns.tolist()
data = df.values.tolist()
full_table_list = [header] + data
print(full_table_list)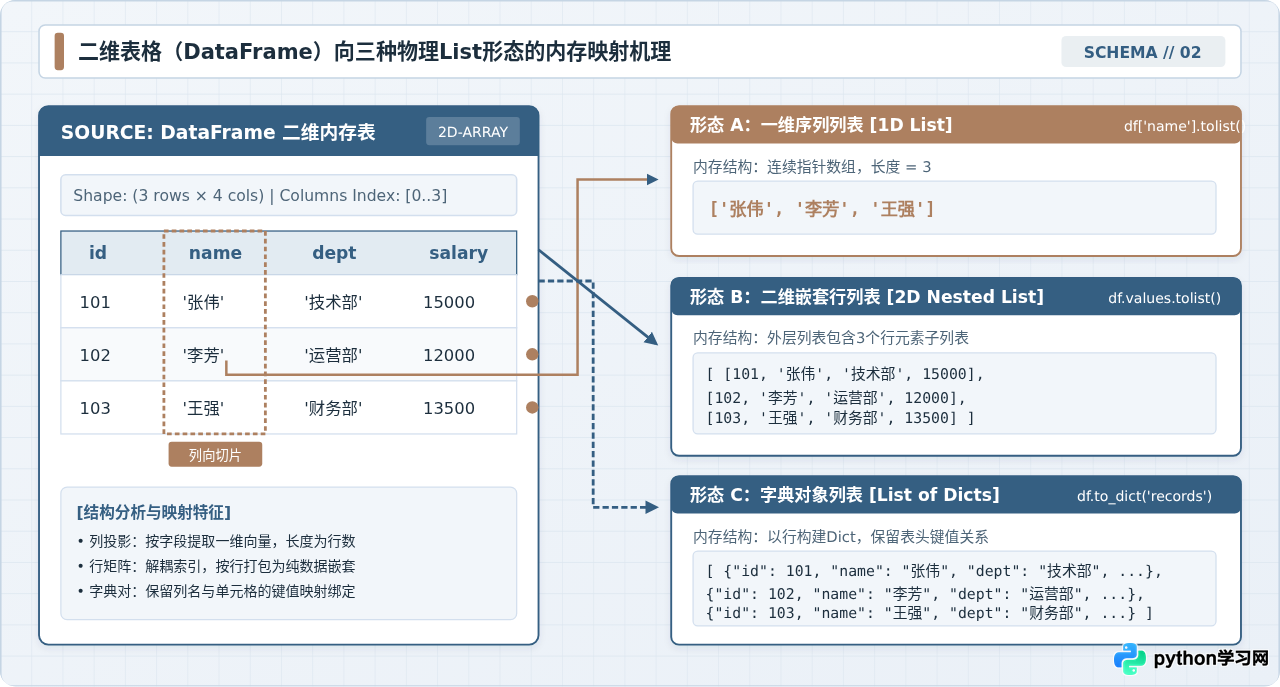
四、按行转换为字典对象列表(List of Dictionaries)
在 Web 后端开发、RESTful API 序列化或向 NoSQL 数据库(如 MongoDB)写入数据时,二维扁平数字列表往往丢失了列名语义。此时最适宜的结构是“字典列表”(每一行为一个字典,列名为键,单元格值为对应的值)。
1. 核心方法:df.to_dict(orient='records')
# 按行转换为字典列表
records_list = df.to_dict(orient='records')
print(records_list){'id': 102, 'name': '李芳', 'department': '运营部', 'salary': 12000.0},
{'id': 103, 'name': '王强', 'department': nan, 'salary': 13500.0},
{'id': 104, 'name': '赵敏', 'department': '市场部', 'salary': nan}]
orient='records' 参数明确指定了转换方向为“按记录聚合”。如果不加该参数,df.to_dict() 默认以列名为外层键构建嵌套字典(即 dict of dicts),而非包含字典的列表。
五、其他特殊维度转换场景
1. 提取指定单行数据为列表
若需要提取某一行(例如测试首行数据或根据条件筛选出的某条记录),可使用 .iloc[] 位置索引结合 .tolist():
# 提取第 0 行数据转为列表
first_row = df.iloc[0].tolist()
print(first_row)2. 全表或多列扁平化为一维列表(Flatten)
若需要将整个二维表或选定的多列打平为单一的长一维列表,可借助 NumPy 的 flatten() 或 Python 原生链式操作:
# 提取姓名与部门并打平成一维池
flatten_list = df[['name', 'department']].values.flatten().tolist()
print(flatten_list)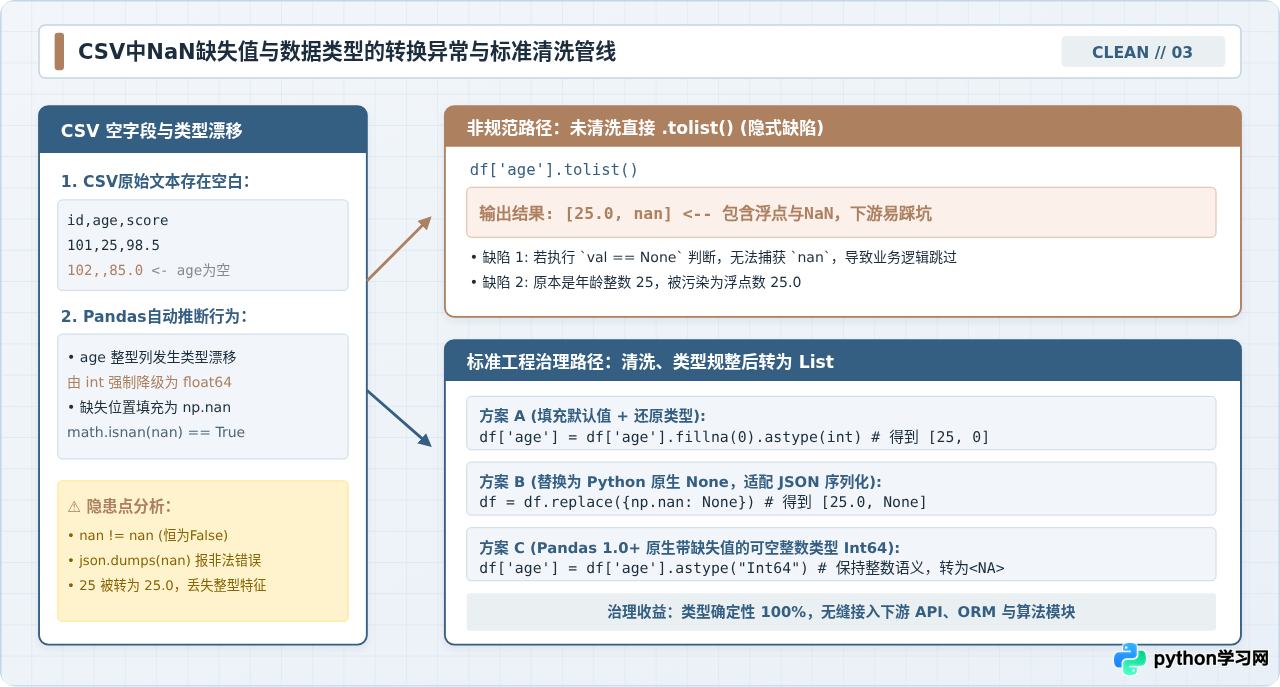
六、关键细节与避坑:NaN 缺失值与数据类型治理
在将 pandas 读取的 CSV 转为列表时,最容易引发运行时隐患的是缺失值(NaN)和隐式类型提升问题。
np.nan。这会导致两个严重后果:一是原本应为整型的列(例如本例中的 salary 或带空值的 id)会被自动强制提升为 float64(导致出现 15000.0 这样的浮点数);二是生成的列表中包含 float('nan'),它无法通过 val == None 准确判断,且直接用于 json.dumps() 序列化时会在标准 JSON 校验中引发异常。
治理方案 1:填充默认值并恢复整型
若业务逻辑允许默认值,可在转 list 前对数值列执行 fillna() 并强制转换类型:
# 将 salary 的空值填充为 0,并恢复为 int
df['salary'] = df['salary'].fillna(0).astype(int)
print(df['salary'].tolist())治理方案 2:将 NaN 规范替换为 Python 原生 None
若转为字典列表用于 Web 接口或 ORM 入库,通常要求缺失值在 JSON 中体现为 null(对应 Python 中的 None)。可在转 list 前全局替换:
# 将整表的 nan 替换为原生 None
df_clean = df.replace({np.nan: None})
clean_records = df_clean.to_dict(orient='records')
print(clean_records[2])  # 查看原先 department 缺失的第 3 条记录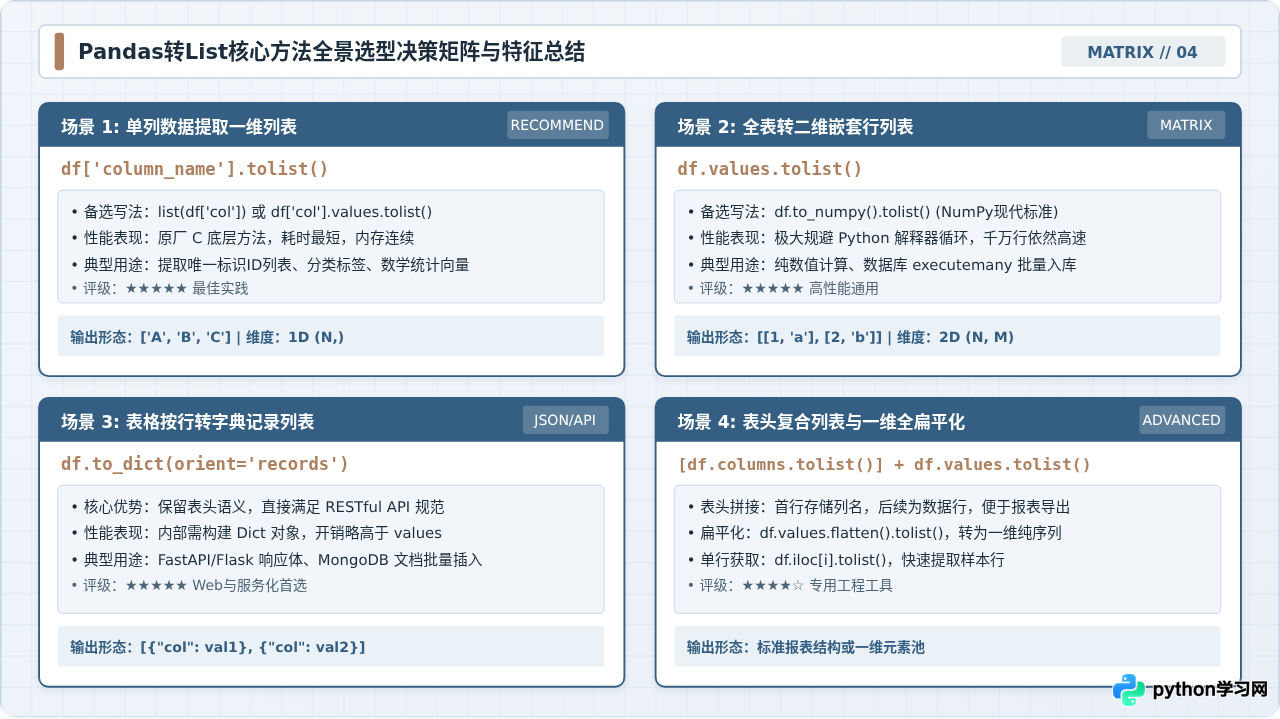
七、方法对比与选型总结
为了方便在实际项目中根据输出需求做出准确选择,下表对本文涉及的核心方法进行了对比:
| 转换目标 | 推荐方法 | 典型输出形态 | 是否保留表头 | 适用场景 |
|---|---|---|---|---|
| 单列一维列表 | df['col'].tolist() |
['张伟', '李芳', ...] |
否 | 提取唯一标识序列、分类字段、单指标向量 |
| 全表二维嵌套 | df.values.tolist() |
[[101, '张伟'], ...] |
否 | 算法模型特征矩阵、数据库批量插入(executemany) |
| 字典记录列表 | df.to_dict('records') |
[{'id': 101, 'name': '张伟'}] |
是(作为键) | Web API 响应序列化、MongoDB 插入、JSON 交换 |
| 复合表头报表 | [df.columns.tolist()] + df.values.tolist() |
[['id', 'name'], [101, '张伟']] |
是(作为第一行) | 前端轻量表格渲染、文件导出中转 |
| 指定单行列表 | df.iloc[idx].tolist() |
[101, '张伟', '技术部', ...] |
否 | 单条样本抽样、首行验证 |
在代码交付与上线前,建议读者通过简单的断言对结果进行校验:首先断言 isinstance(result, list) 确保根对象为列表;其次校验 len(result) == len(df) 保证行数无丢失;对于包含空值的字段,提前通过 fillna() 或 replace() 规整为明确的默认值或 None,即可确保数据平稳接入下游业务流程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









