

Python数据分析处理缺失值的8种方法详解

本文详细解析Python中处理数据缺失值的8种核心方法,涵盖使用dropna删除含缺失值的行列、基于阈值过滤,以及利用fillna进行常数、聚合值、前后值填充及多数据源替换。通过具体参数如how、thresh、limit和subset的讲解,帮助开发者根据数据特征选择最优策略,确保数据分析的准确性与完整性。
在数据分析过程中,缺失值是常见挑战。本文将深入探讨8种不同的缺失值处理策略。具体选择哪种方法,需结合数据分布特征与业务目标综合判断。建议收藏本文以备查阅,欢迎点赞支持,技术交流可加入文末群组深入讨论。
首先,构建一个示例数据框并人为引入缺失值,以便后续演示处理流程。
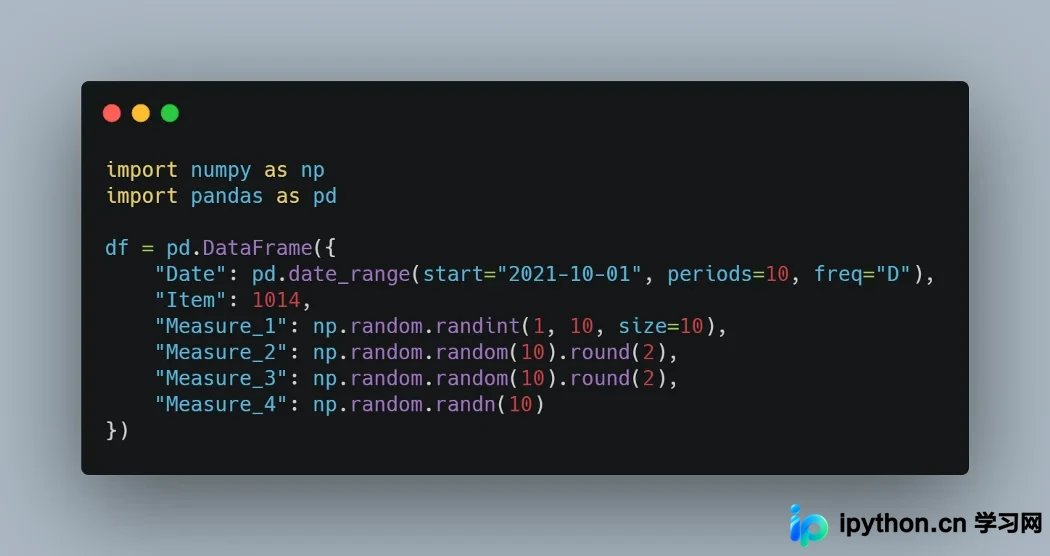
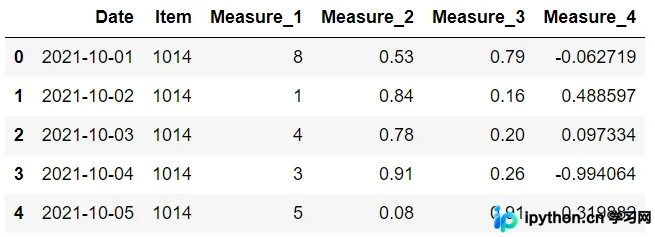
该示例数据框包含10行6列。
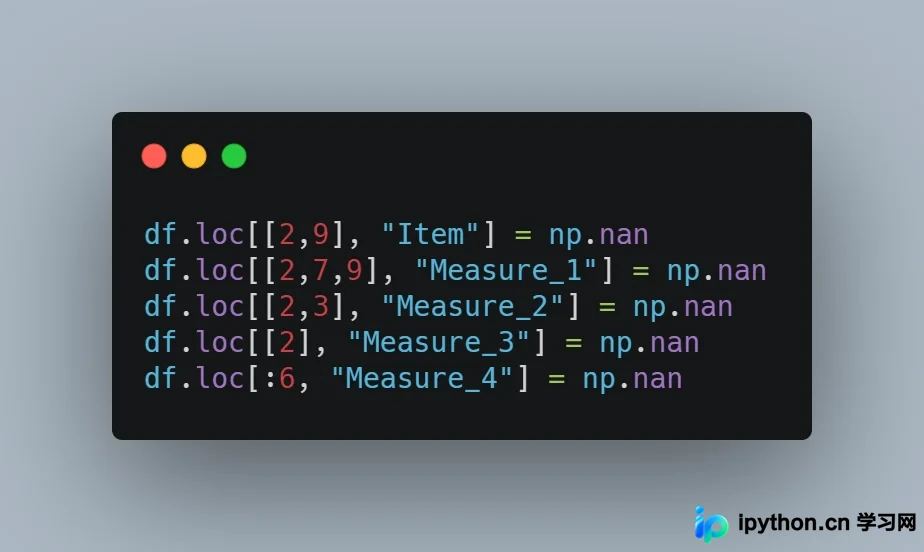
接下来引入缺失值。利用loc方法选定特定的行与列组合,将其赋值为“np.nan”,这是Python中标准的缺失值表示方式。
处理后的数据框状态如下所示:
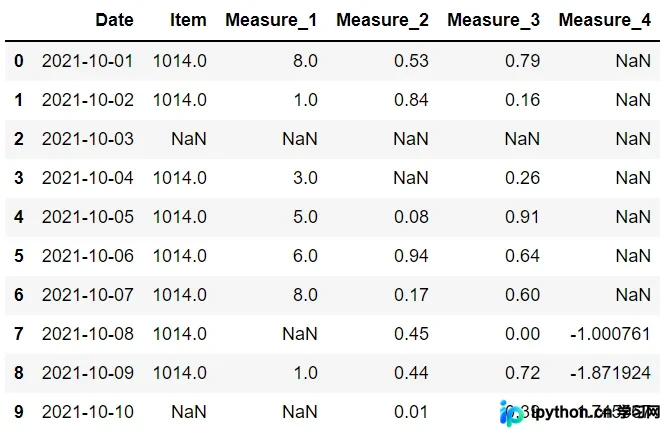
注意,item和measure 1列原为整型,因引入缺失值后自动转换为浮点型。
自Pandas 1.0版本起,引入了专门的整数类型缺失值表示机制,允许在整型列中直接存储缺失值。但使用时需显式指定数据类型。
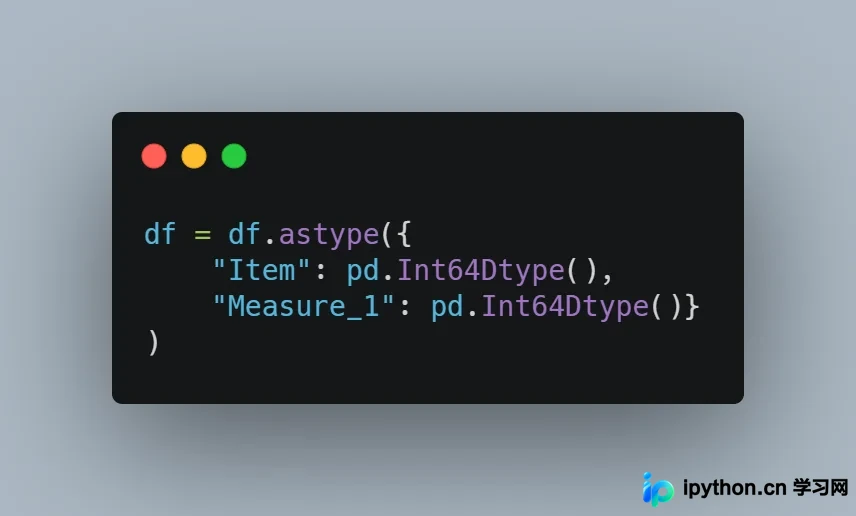
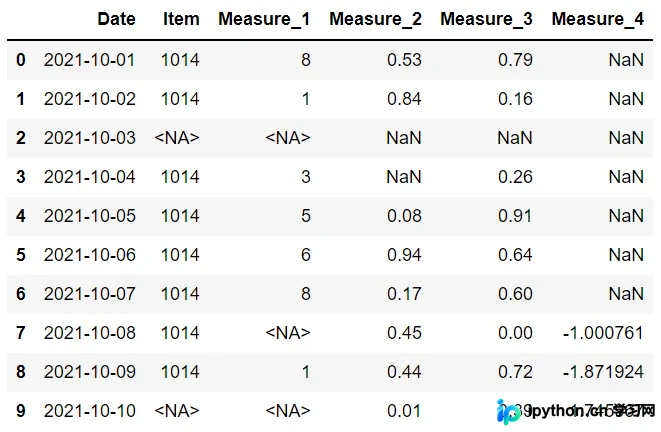
通过上述设置,即便存在缺失值,我们仍可将相关列保持为整数类型。
至此,我们构建了一个包含特定缺失值的数据框,接下来将逐一介绍处理这些缺失值的具体方法。
1. 删除包含缺失值的行或列
一种直观的处理方式是直接删除含有缺失值的行或列。
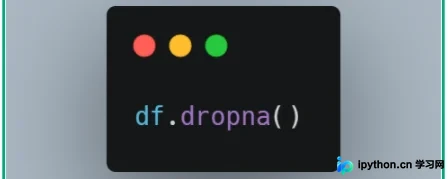
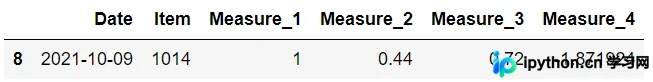
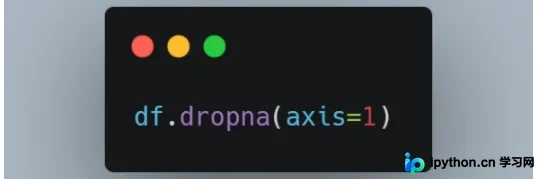
调用dropna函数并使用默认参数,系统将删除任何包含缺失值的行。在当前数据框中,仅有一行完全无缺失值。此外,通过指定axis参数,还可以删除至少包含一个缺失值的列。
2. 删除全为缺失值的行或列
另一种极端情况是某一行或某一列完全由缺失值构成。此类数据通常无分析价值,可直接移除。
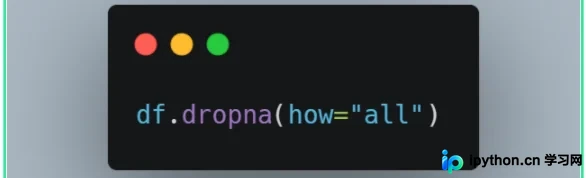
dropna函数同样适用于此场景,只需调整how参数的取值即可实现。
3. 基于阈值删除行或列
仅依据“any”或“all”进行删除并不总是最优解。有时我们需要移除缺失值“较多”或“较少”的行或列。
虽然how参数无法直接表达这种逻辑,但Pandas提供了更精确的thresh参数。
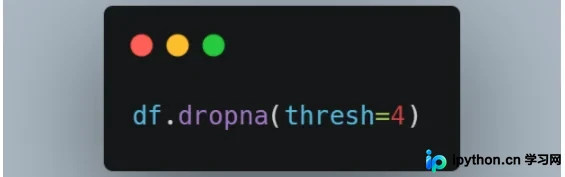
例如,设置“thresh=4”表示仅保留至少有4个非缺失值的行,其余行将被丢弃。
鉴于数据框共有6列,此设置将剔除拥有3个或更多缺失值的行。
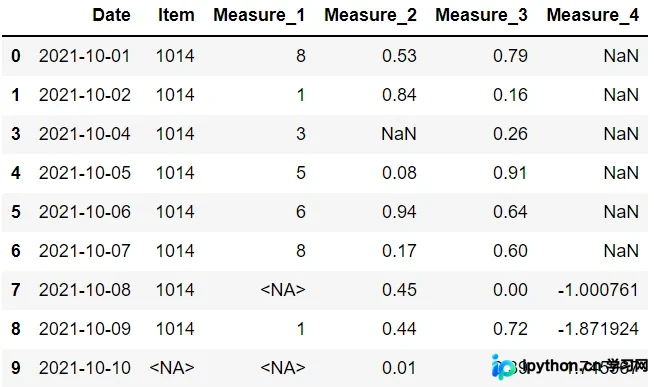
观察数据可知,仅第三行拥有超过2个缺失值,因此它是唯一被剔除的行。
4. 基于特定列子集进行删除
在决定删除列时,我们可能只需关注部分关键列。
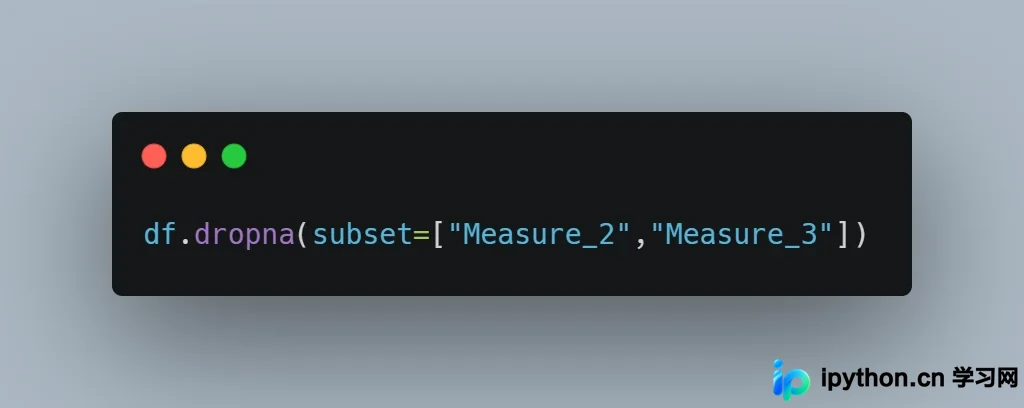
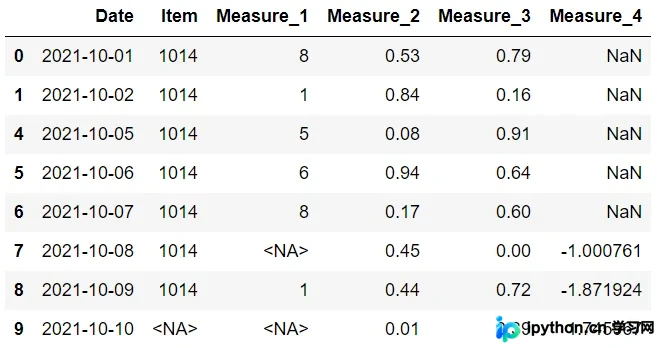
dropna函数的subset参数专为此设计。例如,可以指定仅当measure 1或measure 2列存在缺失值时才删除该行,具体操作如下:
上述方法均涉及通过删除行或列来处理缺失值。然而,删除并非唯一途径。在某些场景下,填充缺失值可能是更优选择。
事实上,填充往往能保留更多数据信息。具体填充策略取决于数据结构及分析任务的需求。
Pandas中的fillna函数专门用于执行缺失值填充操作。
5. 填充固定常数值
可以选择一个固定常数来替代缺失值。若仅向fillna函数传入单一常数值,该值将替换数据框内所有位置的缺失值。
更为合理的做法是为不同列指定独立的常数。可通过字典形式将这些值传递给values参数。
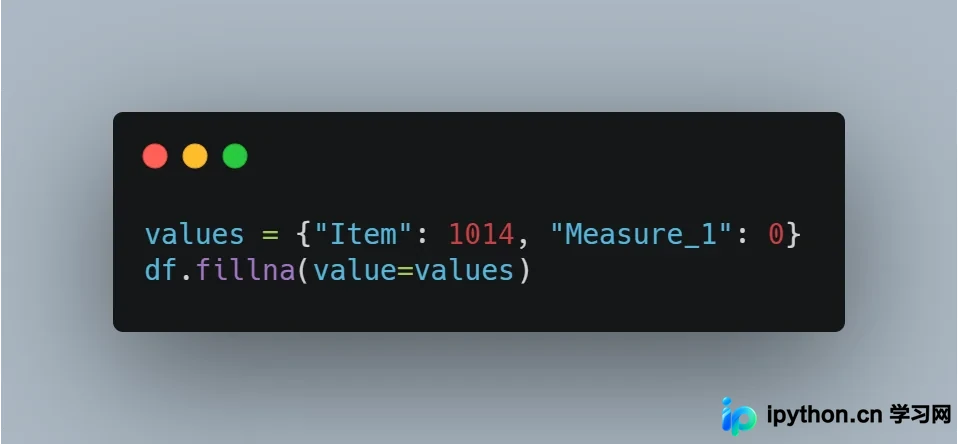
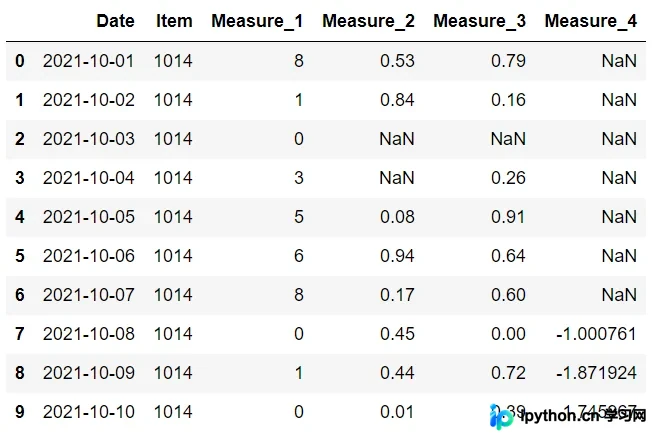
在此示例中,item列的缺失值被替换为1014,而measure 1列的缺失值被替换为0。
6. 填充聚合统计值
另一种常见策略是使用聚合统计量,如均值、中位数或众数进行填充。
下方代码展示了利用列均值替换第2列中缺失值的具体实现。
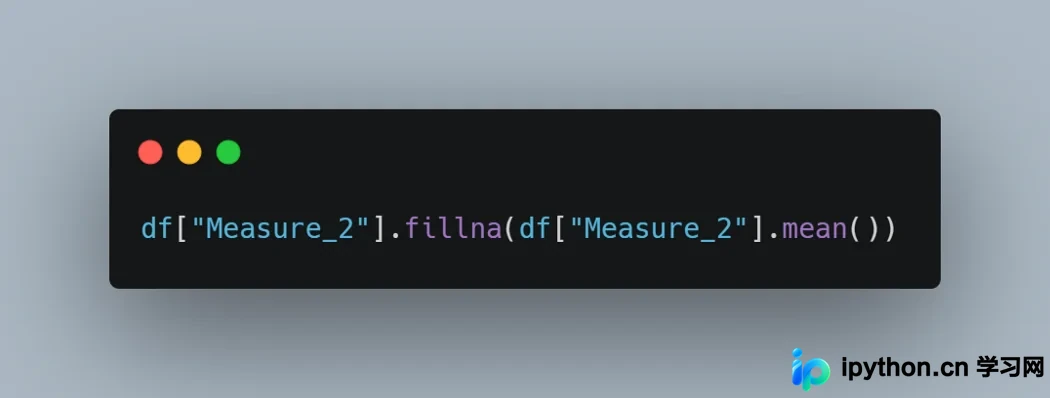
7. 使用前向或后向填充值
可以使用同一列中的前一个或后一个值来填补缺失值。在处理时间序列数据时,此方法尤为实用。例如,若数据框包含每日温度测量值但缺失某一天的温带数据,使用次日或前一日温度往往是最佳解决方案。
fillna函数的method参数用于执行此类填充。
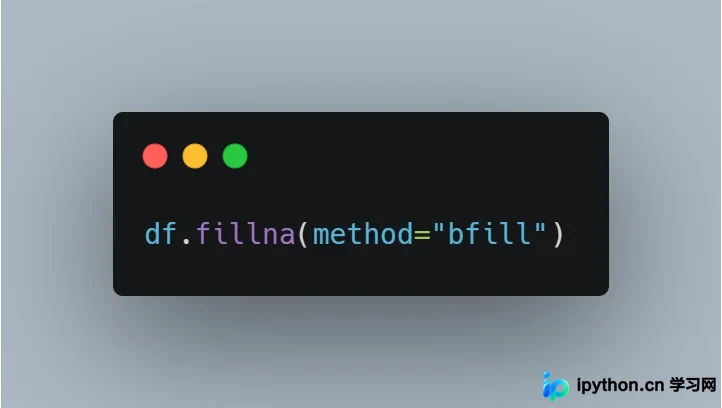
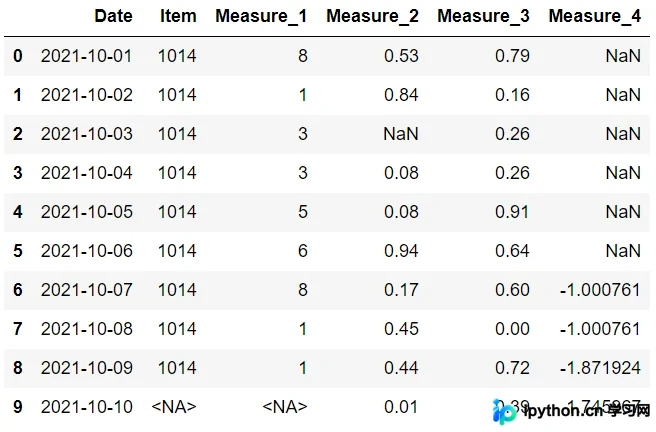
“bfill”代表向后填充,即用后续值替换当前缺失值。观察最后一列可见,首行的缺失值被替换为第二行的值。需注意,这并不适用于所有业务场景。
值得庆幸的是,我们可以限制此类填充操作的次数。若将limit参数设为1,则每个缺失值仅能由其后续一个值替换,后续的第2个或第3个值将不参与替换。
8. 使用另一个数据框进行填充
我们还可以向fillna函数传入另一个数据框。新数据框中的值将用于替换当前数据框中的缺失值。
系统将根据行索引和列名匹配并选取值。例如,若item列的第二行存在缺失值,系统将自动使用新数据框中相同索引和列名位置的值进行替换。
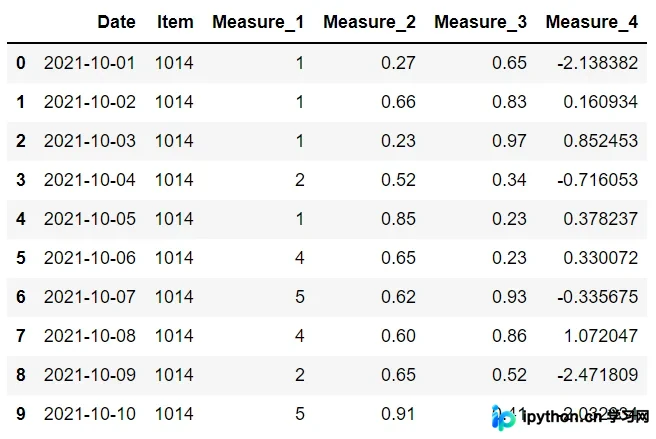
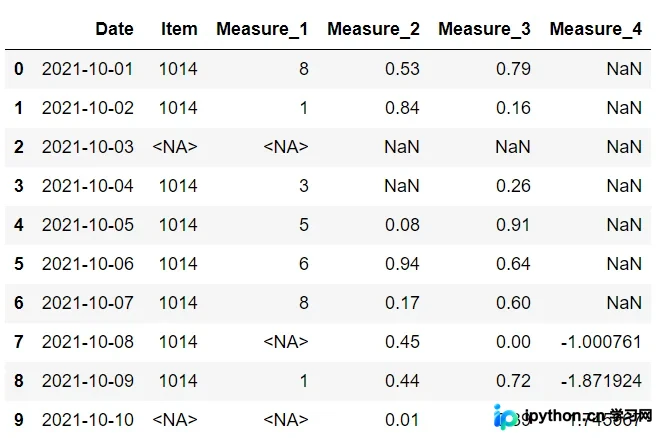
此处示例涉及两个具有相同列结构的数据框,其中第一个数据框不含缺失值。
具体调用fillna函数的代码如下:
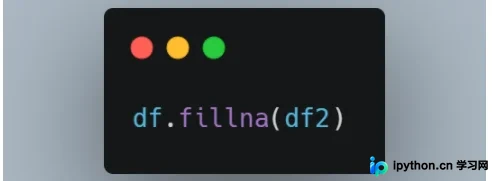
执行后,df中的缺失值将被df2中对应列名和行索引位置的值所替代。
总结
缺失值在数据世界中不可避免。虽然不存在通用的最佳处理方案,但通过应用精准且合理的策略,可有效降低其负面影响。本文介绍的8种方法各有适用场景,具体选用需依据数据特征与分析任务而定。
技术交流
欢迎转载、收藏,若对您有帮助请点赞支持!
至此,关于Python数据分析中处理缺失值的8种方法详解已介绍完毕。更多Python数据分析相关内容,敬请搜索本站往期文章或浏览后续系列。感谢大家的支持与关注!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









