

Python切片中省略起止位置仅留双冒号代表什么
详细解析Python切片语法中省略start和stop仅保留双冒号(如a[::]、a[::2]、a[::-1])的底层机制、边界推导规则、内存行为及常见避坑场景。
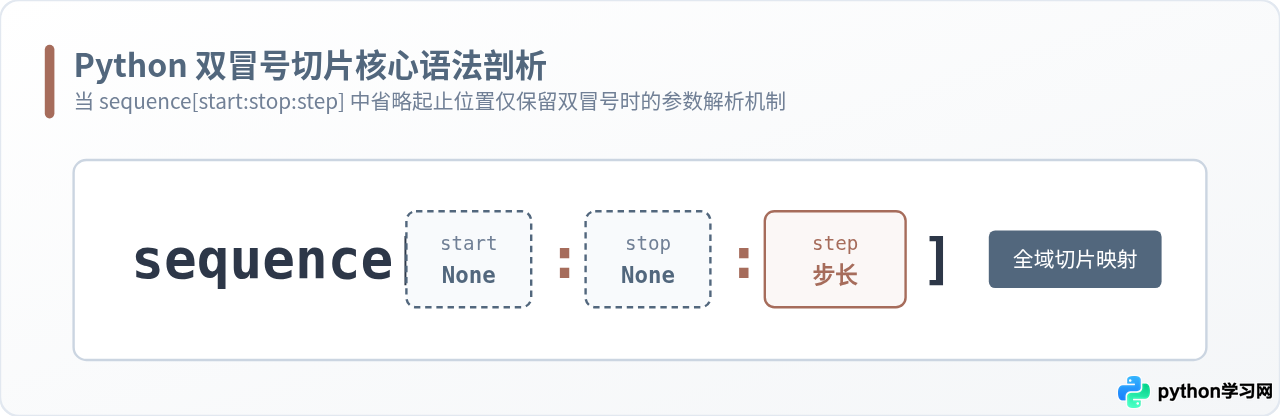
sequence[::step] 结构全景start)与终止索引(stop)而只保留连续的双冒号时(如 a[::]、a[::2] 或 a[::-1]),代表起止边界均采用默认缺省值 None,遍历范围覆盖整个序列;此时切片的提取范围与方向完全由第二个冒号后面的步长(step)决定。若未提供步长,则默认步长为 1,等价于对整个序列进行完整的正向浅拷贝;若指定了非 1 步长,则在全序列范围内按指定跨度抽样或反转元素。
一、切片语法结构与双冒号的由来
Python 中对序列(列表、元组、字符串等)进行切片的标准语法格式包含三个位置参数:
sequence[start:stop:step]这三个参数通过冒号隔开,分别代表起始索引(包含)、终止索引(不包含)和步长(每次递进的元素跨度)。在实际编码中,很多开发者习惯了单冒号的普通切片形式(例如 a[1:5] 或 a[:])。当引入第三个参数 step 时,就必须使用第二个冒号来进行语法分隔。
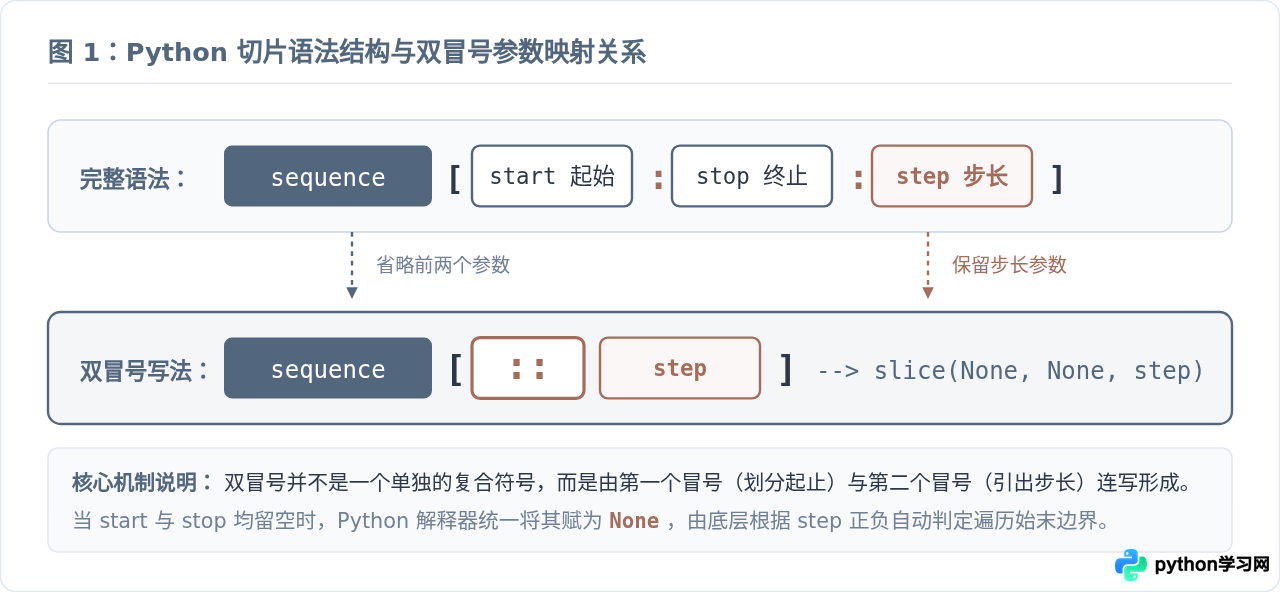
很多初学者容易将连续的“::”误解为一个单独的、特殊的 Python 操作符。事实上,“::”仅仅是两个普通冒号紧邻书写的结果:第一个冒号负责分隔 start 与 stop,第二个冒号负责引入 step。当起止位置都不填写时,两个冒号之间没有任何字符,就呈现出了双冒号的形态。
在 Python 语法解析层面,中括号内的表达式会被直接转化为一个内置的 slice 切片对象。省略参数并不等于“参数不存在”,而是表示该参数显式缺省为 None:
sequence[::]完全等价于sequence[slice(None, None, None)];sequence[::step]完全等价于sequence[slice(None, None, step)]。
二、缺省边界的推导机制:Python 如何处理 None
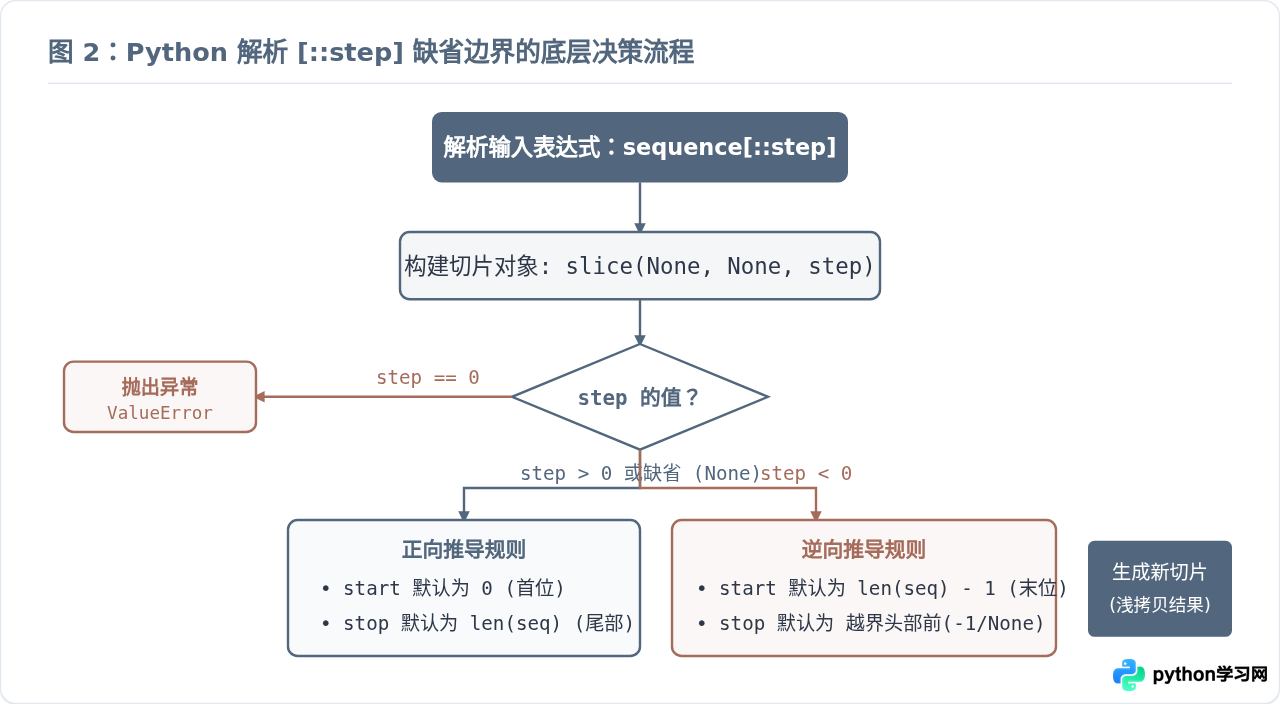
当切片对象接收到 start=None 与 stop=None 时,底层并不会草率地将它们固定为数字 0 和序列长度。Python C 核心实现中通过 slice.indices(length) 函数动态计算实际的起止边界。该算法的核心依据是:步长 step 的正负符号决定了序列扫描的始发方向与边界落点。
1. 步长为正数或缺省时(step > 0 或 step is None)
当步长为正数(或者没有指定步长,默认为 1)时,遍历的方向是从序列左侧(低索引)向右侧(高索引)推进:
start缺省值被推导为0(即序列的第一个元素);stop缺省值被推导为len(sequence)(即序列的右开区间边界)。
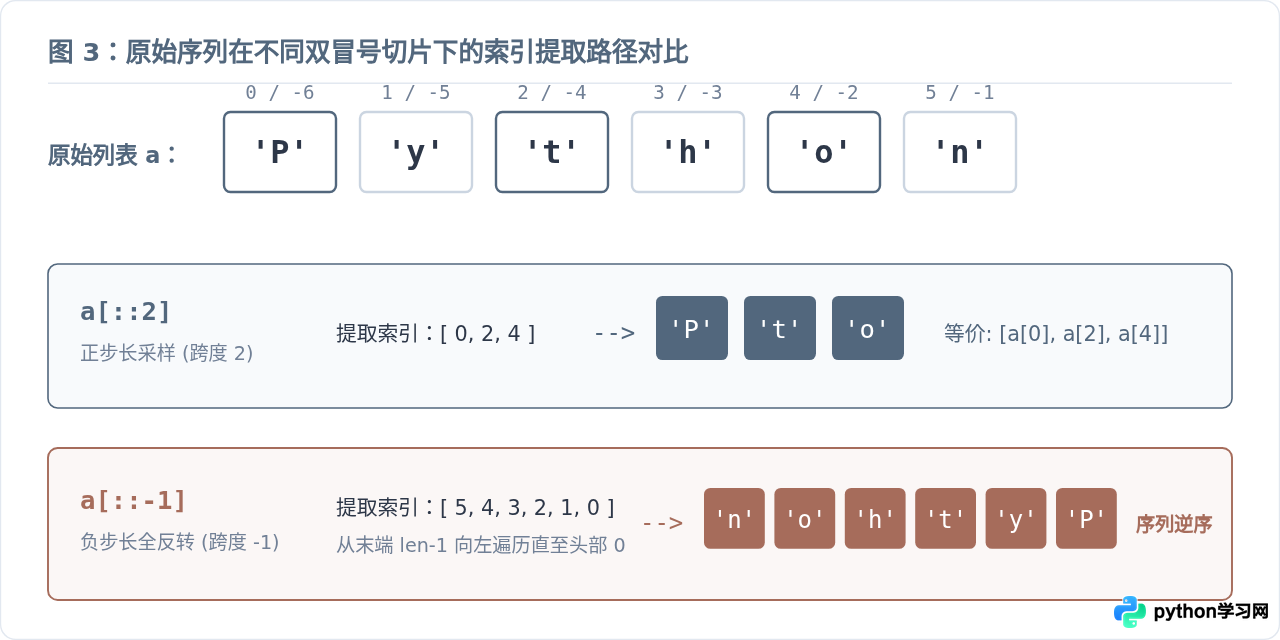
例如对一个长度为 6 的列表执行 a[::2],内部推导出的实际切片区间为从 0 到 6、步长为 2,依次命中索引 0、2、4。
2. 步长为负数时(step < 0)
当步长为负数时,遍历方向彻底反转,从序列右侧向左侧推进:
start缺省值被自动推导为len(sequence) - 1(即末尾元素的正向索引);stop缺省值被自动推导为能够覆盖至索引0的虚拟左边界(在 C 内部处理为 -1 或延续至首项之前)。
这意味着 a[::-1] 会从最后一个元素出发,以 -1 的跨度一步一步向前取值,完整保留包括首位(索引 0)在内的所有元素,最终达成整个序列的原样反转。
3. 步长为零时(step == 0)
步长绝对不能为 0。如果试图运行 a[::0],Python 解释器在初始化切片步长时会立即抛出 ValueError: slice step cannot be zero 异常,因为零步长无法确定下一个元素的推进方向。
三、双冒号切片的典型使用场景与代码示例
在日常开发中,利用双冒号省略起止位置主要有三类非常高频的实际应用场景。
场景一:全序列浅拷贝(a[::] 与 a[:])
当双冒号之后没有填写任何步长时,即 a[::],此时步长缺省为 1。它的执行效果与单冒号的 a[:] 完全一致,都是对原序列进行完整范围的正向切片提取。
# 示例 1:创建全量副本
original_list = [10, 20, 30, 40]
copy_list = original_list[::]

print("拷贝内容:", copy_list)
print("是否为同一对象:", copy_list is original_list)
print("数值是否相等:", copy_list == original_list)是否为同一对象: False
数值是否相等: True
可以看到,copy_list 是一个全新分配的列表容器对象(两者内存地址不同),修改 copy_list 本身的增删元素操作不会影响 original_list。但需要注意的是,切片产生的是浅拷贝(shallow copy),如果列表中包含可变嵌套对象(例如子列表或字典),嵌套内部的引用依然是指向相同内存块的。
场景二:固定步长下采样与隔位筛选(a[::2])
当需要从序列中按固定周期抽取元素(例如音频降采样、奇偶位拆分、隔行数据提取)时,双冒号能提供最直观的写法:
# 示例 2:固定步长采样
letters = ['P', 'y', 't', 'h', 'o', 'n']

# 从 0 开始,每隔 2 项提取一个(提取偶数索引元素)
even_indexed = letters[::2]

# 提取奇数索引元素(需配合 start=1)
odd_indexed = letters[1::2]

print("偶数位元素 (letters[::2]):", even_indexed)
print("奇数位元素 (letters[1::2]):", odd_indexed)奇数位元素 (letters[1::2]): ['y', 'h', 'n']
场景三:序列完整逆序反转(a[::-1])
a[::-1] 是 Python 中最富特色的惯用写法之一。它通过 step=-1 搭配省略的起止位置,以 C 语言底层的紧凑循环直接逆序生成新序列:
# 示例 3:全序列高效反转
text = "stressed"
reversed_text = text[::-1]
print("反转后的字符串:", reversed_text)

nums = [1, 2, 3, 4, 5]
reversed_nums = nums[::-1]
print("反转后的列表:", reversed_nums)反转后的列表: [5, 4, 3, 2, 1]
stop 位置的元素永远是不包含在内的。若显式写为 a[-1:0:-1],位于索引 0 的首个元素将无法被读取;若写为 a[-1:-1:-1] 则起止相同返回空列表。正是因为 Python 允许省略起止并将其置为 None,解释器才能知道“这次反转需要一直提取到序列最边缘的索引 0 为止”。
四、双冒号切片的进阶规则与注意事项
掌握了双冒号切片的基本语法后,还需要关注在扩展切片赋值、不同数据类型以及第三方库环境下的细节差异。
1. 扩展切片赋值时的“长度严格匹配”限制
普通单冒号切片支持在赋值时替换不同长度的内容,例如 a[1:3] = [99],Python 会自动压缩或扩张原列表。但如果在切片赋值中使用了带有步长的扩展切片(例如双冒号切片 a[::2]),右侧被赋序列的元素个数必须与切片选中的槽位数严格相等:
# 示例 4:双冒号切片赋值
data = [1, 2, 3, 4, 5, 6]

# data[::2] 选中的位置是索引 0, 2, 4(共 3 个元素)
data[::2] = [10, 30, 50]  # 正确:长度精确匹配
print("切片赋值后:", data)

# 若右侧长度不为 3,将抛出 ValueError:
# data[::2] = [10, 30]
# ValueError: attempt to assign sequence of size 2 to extended slice of size 32. 与 reversed() 和 list.reverse() 的选型对比
面对反转需求时,Python 提供了三种常见方式,它们的行为特性各有侧重:
a[::-1]:适用于列表、元组、字符串。其优点是写法紧凑且生成全新的对应类型对象;缺点是对超大序列会瞬间消耗与原序列相当的内存。reversed(a):返回一个惰性反向迭代器。不一次性生成新列表,适合在for循环中逐项处理,内存占用极小。a.reverse():仅适用于列表(list)。在原列表内部就地调换元素顺序,无返回值(返回None),不会产生新对象。
3. Python 原生序列与 NumPy 数组的切片差异
在 Python 内置的 list 或 tuple 上执行 a[::2] 或 a[::-1],得到的一定是一个全新的独立序列容器。但在科学计算库 NumPy 中,对 ndarray 进行双冒号切片(如 arr[::2])默认返回的是原数组的一份视图(View),两者共享同一底层数据缓冲区。修改视图中的数值会直接导致原数组中的对应数据发生改变。在混合使用纯 Python 与科学计算库时需要加以区分。
五、全景总结速查
双冒号切片不是神秘的语法黑魔法,而是 Python 切片模型在处理缺省参数时的自然延伸。通过将起止位置留空,我们将“界定范围”的工作全权托付给 Python 底层的边界推导逻辑,自己只需精确控制“步长”与“方向”。
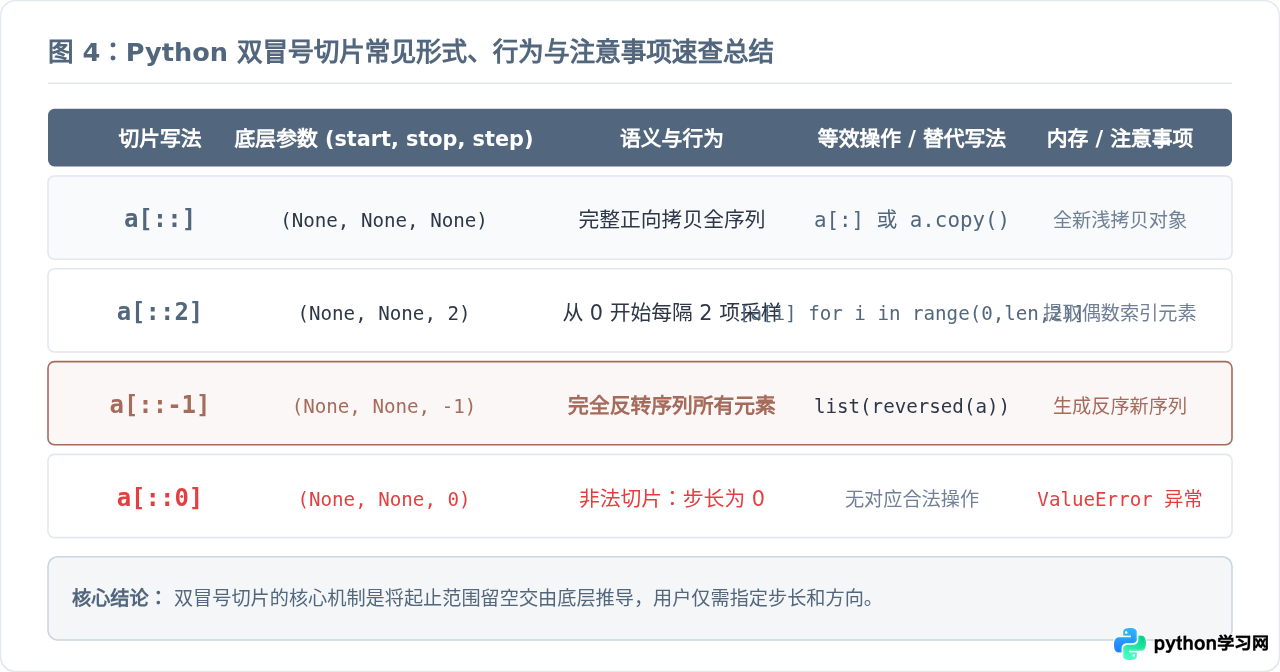
在日常编写代码时,可以遵循如下简洁的判断经验:
- 如果要快速得到字符串或列表的倒序副本,优先选择
[::-1]; - 如果要对列表进行显式且具有表达力的浅拷贝,虽然
[::]完全可用,但在团队协作中推荐书写a.copy()或list(a),意图表达会更直观; - 在处理周期采样或奇偶项提取时,使用
[::2]或[1::2]是最标准、高效的 Pythonic 写法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









