

Python矩阵输入报错怎么处理非法格式
针对Python中矩阵输入时常见的非法格式与报错问题,详细解析非数字字符、锯齿维度、分隔符混乱等成因,提供从数据清洗、安全类型转换到形状对齐的完整防御性解决方案与代码实现。
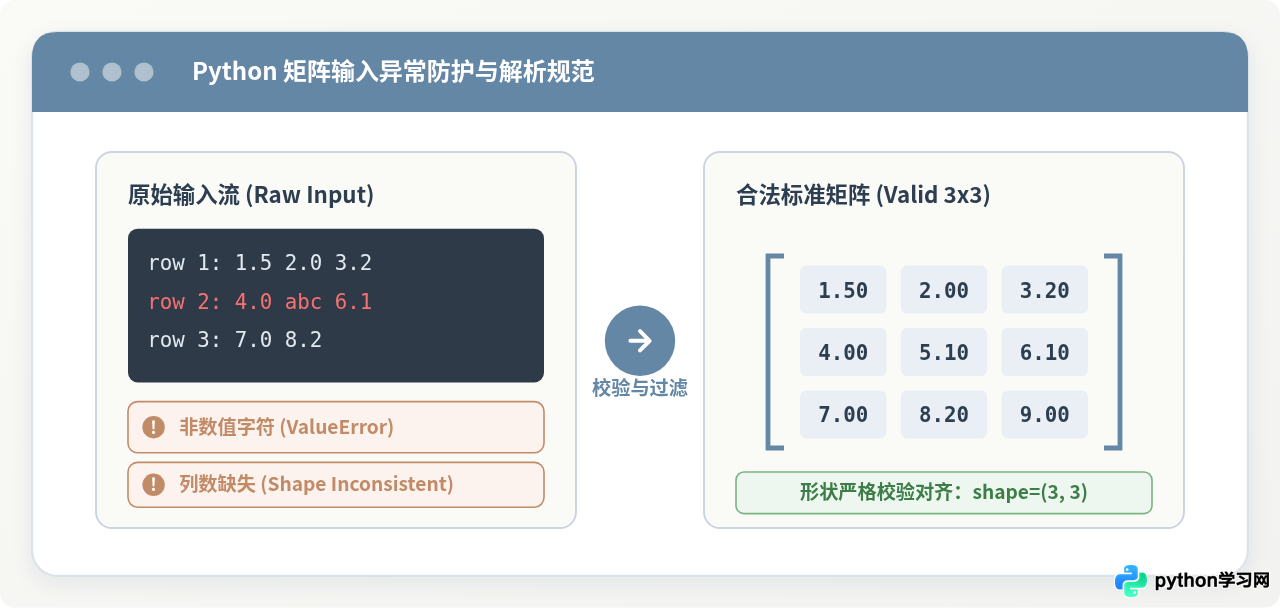
try-except ValueError 隔离脏数据,并在输入收集过程中逐行比对列数,既能精准指出输入第几行第几列存在非法字符,又能在交互场景下实现“哪行出错重输哪行”,避免整个程序单点崩溃。
一、矩阵输入常见非法格式与报错成因排查
初学者在编写矩阵输入逻辑时,最常用的写法往往是 matrix = [list(map(int, input().split())) for _ in range(n)]。这行代码虽然简短,但它建立在“输入源完全可信且格式绝对严谨”的理想假设之上。在实际终端交互、文件读取或算法评测中,输入数据极易出现偏差,从而引发几类典型错误:
-
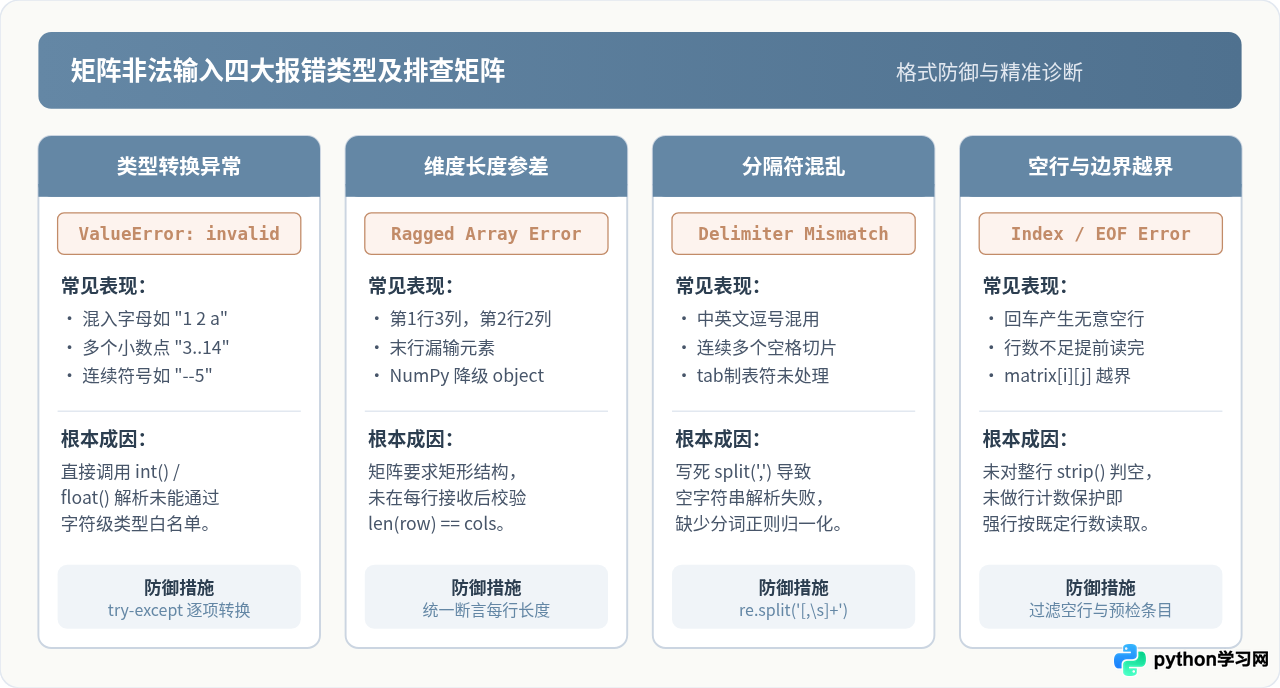
非数值字符与脏数据(
ValueError: invalid literal for int()):用户误输入了字母、全角符号、多余的符号(如1.5 a 3或2..3),或者在期望整数矩阵时传入了浮点数。Python 的int()无法解析这些字符,导致程序立即中止。 -
列数不一致导致的锯齿结构(Ragged Array):矩阵要求每一行的列数完全相等。若第一行输入了 3 个数,第二行漏输变成 2 个数,原生列表虽然能存下,但在后续进行矩阵乘法、转置或传递给 NumPy(抛出
ValueError: setting an array element with a sequence)时会引发严重的结构性崩溃。 -
分隔符混乱与多余空行:用户可能混用了中英文逗号、制表符(Tab)或连续多个空格。直接使用
split(',')时,连续逗号会切出空字符串"",引发转换报错;多余的回车空行也会直接导致索引越界或提早读入空列表。
二、矩阵输入防御性解析的四个关键步骤
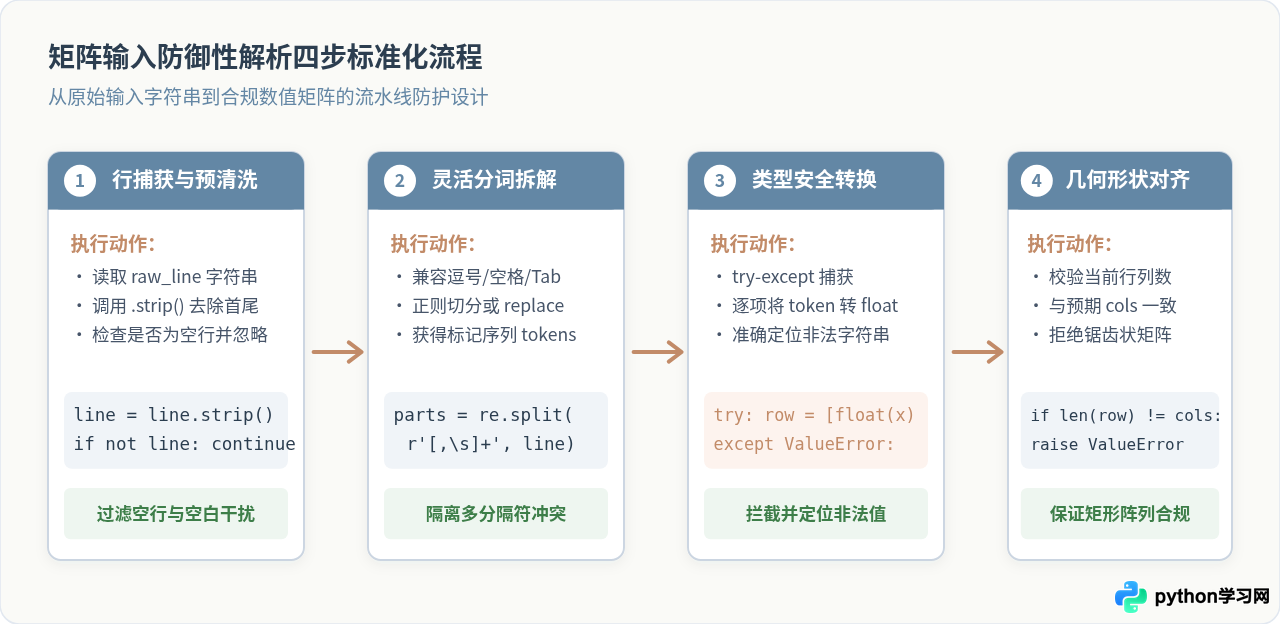
要彻底杜绝非法格式引发的崩溃,需要将输入流程构建为一条具备自愈与检验能力的流水线。具体分为以下四个规范步骤:
1. 行捕获与预清洗
读取原始行后,首要任务是调用 .strip() 清除行首、行尾的换行符和多余空格。若清洗后的字符串长度为 0,说明该行为无意按下的空行,应直接跳过或提醒重新输入,而不是强行送入转换器。
2. 灵活分词与分隔符规范化
不要写死单一字符切分。推荐使用正则表达式模块 re.split(r'[,\s]+', line),它能够自动把连续空格、单个制表符或逗号统一视为元素间的分隔符,自动忽略连续分隔产生的空片段。
3. 单元格安全类型转换
对切分出来的每一个字符单元进行单独转换,并在局部的 try-except 块中拦截异常。如果发生异常,能够明确获知是哪一个具体的 token 无法转换,为用户提供精确的纠错信息。
4. 形状一致性硬性检查
对于第一行,确定其列数作为基准矩阵列宽 cols;后续输入的每一行在完成数值转换后,立即比对 len(current_row) == cols。一旦列宽参差,立即触发拦截,拒绝将不合规行追加进矩阵。
三、核心代码实现:从终端交互到文件读取
1. 交互式控制台输入(支持单行容错重试)
在终端交互场景下,最友好的体验并非“报错退出”,而是“保留前面合规的行,仅要求重新输入出错的那一行”。以下是标准实现:
import re

def input_matrix_interactive(rows: int, cols: int):
    """
    安全交互式输入矩阵:具备脏数据过滤与单行重输机制
    """
    matrix = []
    current_row_idx = 1

    print(f"=== 请输入 {rows} 行 {cols} 列矩阵(空格或逗号分隔)===")

    while current_row_idx <= rows:
        raw_text = input(f"请输入第 [{current_row_idx}/{rows}] 行: ").strip()

        # 步骤 1:空行检查
        if not raw_text:
            print("  [警告] 输入内容为空,请重新输入本行。")
            continue

        # 步骤 2:正则分词,兼容空格、制表符、中英逗号
        tokens = re.split(r'[,,\s]+', raw_text)
        tokens = [t for t in tokens if t]  # 去除空片段

        # 步骤 3:列数一致性预检
        if len(tokens) != cols:
            print(f"  [格式错误] 元素数量不符!预期 {cols} 个,实际收到 {len(tokens)} 个。")
            continue

        # 步骤 4:安全逐项类型转换
        row_numbers = []
        parse_success = True
        for pos, token in enumerate(tokens, start=1):
            try:
                # 按需转换为 float 或 int
                num = float(token)
                row_numbers.append(num)
            except ValueError:
                print(f"  [类型错误] 第 {pos} 个元素 '{token}' 不是合法数字!")
                parse_success = False
                break

        if parse_success:
            matrix.append(row_numbers)
            current_row_idx += 1  # 校验通过,推进到下一行

    return matrix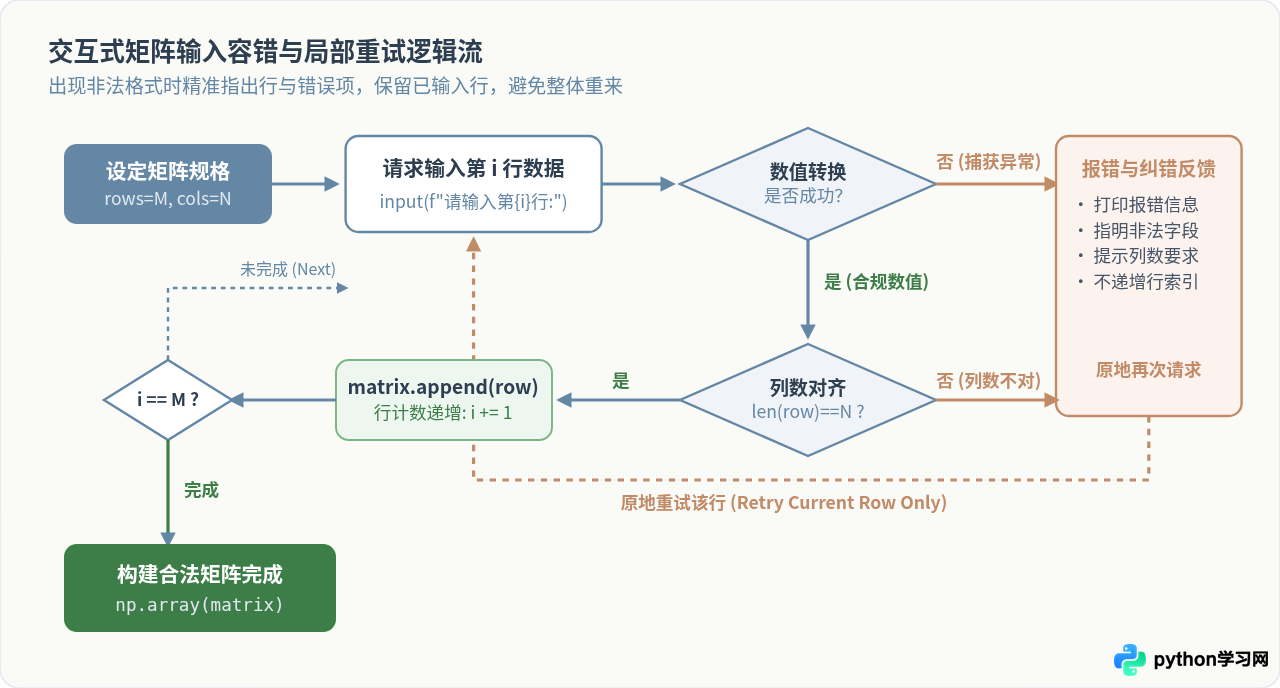
2. 静态文本/文件批量输入的解析与错误回溯
如果矩阵数据来自外部文件或大段粘贴文本,无法进行实时人机交互,则需要在发现非法格式时抛出具备明确行号、列号与上下文的自定义异常,便于调用方快速排查源文件。
class MatrixFormatError(ValueError):
    """矩阵输入格式专用异常"""
    pass

def parse_matrix_from_text(text_block: str, expected_cols: int = None):
    lines = [line.strip() for line in text_block.strip().splitlines()]
    valid_lines = [l for l in lines if l]  # 过滤纯空行

    if not valid_lines:
        raise MatrixFormatError("输入文本为空,无法提取矩阵。")

    matrix = []
    determined_cols = expected_cols

    for line_no, raw_line in enumerate(valid_lines, start=1):
        parts = re.split(r'[,,\s]+', raw_line)
        parts = [p for p in parts if p]

        # 确定第一行作为基准列宽
        if determined_cols is None:
            determined_cols = len(parts)

        if len(parts) != determined_cols:
            raise MatrixFormatError(
                f"文本第 {line_no} 行列数不一致:预期 {determined_cols} 列,实际 {len(parts)} 列(内容: '{raw_line}')"
            )

        row = []
        for col_idx, item in enumerate(parts, start=1):
            try:
                row.append(float(item))
            except ValueError:
                raise MatrixFormatError(
                    f"文本第 {line_no} 行第 {col_idx} 列非法数值 '{item}'"
                )
        matrix.append(row)

    return matrix
四、常见边界陷阱与处理细节
eval() 或直接 json.loads() 解析矩阵文本部分开发者为了省事,直接将用户输入的嵌套列表字符串用
eval() 执行。这不仅存在严重的任意代码执行安全隐患,而且一旦用户少写一个方括号或误输入中文标点,会抛出晦涩的 SyntaxError,极难向普通用户解释。
在工程实践中,还需注意以下三个边界情况:
-
整数与浮点数兼容转换:如果矩阵允许整数或小数混合,应统一先通过
float()解析。若业务严格要求整型,但在输入中出现了"3.0",直接int("3.0")会抛出ValueError。正确的做法是先转换为浮点数,再判断其小数部分是否为 0(例如val = float(token); if val.is_integer(): int(val))。 -
NumPy 转换前置验证:若后续需要将列表转为
numpy.ndarray,切勿在数据尚未验证长度前直接np.array(ragged_list)。在较新版本 NumPy 中,这会触发VisibleDeprecationWarning并退化为低效的object类型数组。 -
Unicode 隐形空格干扰:从网页复制粘贴矩阵数据时,常夹带全角空格(
)。正则分词时使用r'[\s ,,]+'能有效防范此类隐性字符导致的转换失败。
五、总结
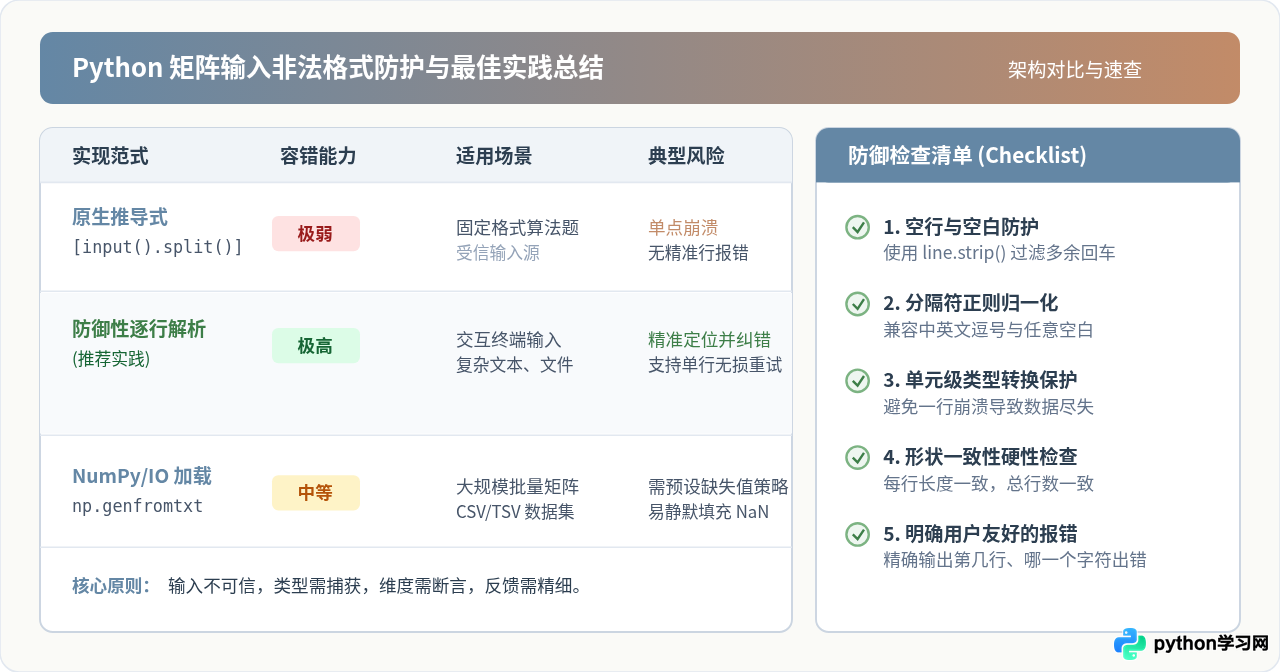
处理 Python 矩阵输入报错的根本不在于“事后补救”,而在于建立前置的防御性解析机制。记住以下四个操作口诀:
- 行首行尾先清理:
strip()过滤空行,避免空字符串污染; - 正则分词容多样:兼容逗号与空白,不把分隔符写死;
- 逐项捕获明指错:局部分流转换,准确定位非法字符位置;
- 行宽列宽硬校验:拒绝参差矩形,确保形状严格对齐。
遵循这一规范,不仅能消除 ValueError 和 IndexError,更能让你的 Python 数据输入模块在各种脏数据和复杂交互场景下保持健壮稳定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









